Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
Zijn OCR en documentverwerking geen opgelost probleem?
Hoewel velen geloven dat OCR en documentverwerking opgeloste technologieën zijn, kost handmatige gegevensinvoer Amerikaanse bedrijven ongeveer $ 15.000 tot $ 30.000 per werknemer per jaar. Bron: De operationele en tijdsbelasting door handmatige documentverwerking is nog steeds aanzienlijk omdat:
Traditionele OCR: Breekbaar en ondermaats presterend
Traditionele OCR-methoden (Computer Vision + Regels + NLP) vertonen een lage aanpasbaarheid aan verschillende schrijfstijlen en lay-outs, en houden vaak geen rekening met context en vereisten voor datastructuren.
Lage aanpasbaarheid: Zelfs de beste traditionele OCR-systemen blijven steken op 85-90% nauwkeurigheid voor complexe documenten, waarbij handgeschreven inhoud daalt tot een nauwkeurigheid van slechts 64%. Bron
Slechte beeldkwaliteit of belichting: 300 DPI is de standaard minimumwaarde voor optimale OCR-resultaten
Ruis
Scheefstand en oriëntatie
Afhankelijkheid van templates en lay-outs: Fijn afgesteld om te werken op een specifiek template, heeft aangepaste downstream-verwerkingspijplijnen of een wijziging in de template nodig voor elke nieuwe documenttype/template-update. Bv. Nieuw factuurformaat van een leverancier, een licht verschoven kolom in een rapport
Contextblindheid: OCR op karakterniveau slaagt er niet in om onderscheid te maken tussen vergelijkbare karakterniveaus, waardoor het begrip van de documentbrede context verloren gaat. Bv. "50mg Metformin" kan worden gelezen als "5Omg Metformin", wat onjuist is voor elke downstream medische taak.
OCR/LLM-nauwkeurigheid per documenttype
Documenttype
Traditionele OCR
SmolDocling (2B)
Qwen-VL-Max (18B)
GPT-4o
Gemini 2.5 Pro
Claude 3.7 Sonnet
Menselijke baseline
Schone gedrukte tekst
97–98%
92–95%
97–98%
99–99.5%
99–99.5%
99–99.5%
99.8%
Tabellen & Formulieren
80–85%
83–87%
91–94%
96–98%
95–97%
95–97%
98–99%
Handschrift (Blokletters)
70–80%
65–75%
80–85%
86–90%
88–92%
89–93%
96–98%
Handschrift (Aaneengeschreven)
50–70%
60–70%
75–80%
82–90%
80–89%
81–90%
95–97%
Lage kwaliteit scans
60–75%
80–85%
90–93%
93–96%
92–95%
93–95%
95–97%
Wiskundige annotatie
70–80%
75–80%
88–93%
92–96%
94–97%
94–96%
97–99%
Op LLM gebaseerde OCR: Onvoorspelbaar en kostbaar
Op LLM gebaseerde OCR's lossen enkele uitdagingen van traditionele methoden op, maar introduceren nieuwe complexiteiten:
Niet opgelost voor handgeschreven tekst: Ondanks dat GPT-4V en Claude 3.5 Sonnet een nauwkeurigheid van 82-90% bereiken op handgeschreven tekst, wat een aanzienlijke verbetering is, schiet dit nog steeds tekort voor bedrijfskritische drempels. Bv. In de gezondheidszorg kan een foutpercentage van 10-18% op handgeschreven recepten letterlijk levensbedreigend zijn.
Moeilijk te schalen:
Onbetaalbaar duur: Voor organisaties die jaarlijks miljoenen documenten verwerken.
Tragere reacties:
Moeilijk om SLA's te handhaven bij self-hosted oplossingen
Downtime en latentiepieken bij externe leveranciers
Inconsistente uitvoer:
Hallucinaties - bv. een volledig verzonnen waarde voor een clausule in een juridisch document
Moeilijk te laten voldoen aan gestructureerde uitvoer
Zelfde prompt, verschillende reacties
In sectoren zoals financiële dienstverlening en gezondheidszorg, die jaarlijks miljoenen kritieke documenten verwerken, is een systeem dat betrouwbaar kan schalen en tegen lage kosten hoogwaardige uitvoer genereert essentieel
Hoe goed is uw documentverwerkingspijplijn? (Praktische metrieken)
Operationele metrieken & World-class benchmarks
Metriek
Definitie (Kort)
World-Class Benchmark
Straight-Through Processing (STP)
% documenten dat end-to-end verwerkt wordt zonder menselijke tussenkomst
85–95% voor gestructureerde documenten
Veldextractienauwkeurigheid
Correctheid van geëxtraheerde sleutelvelden (namen, bedragen, datums)
99%+ voor kritieke velden
Time to Value
Tijd van documentontvangst tot beschikbaarheid van gestructureerde data
<2 min (eenvoudige docs), <10 min (complexe formulieren)
Menselijke aanpassingsfrequentie
% data dat handmatige correctie vereist
<5% met behoud van 99%+ nauwkeurigheid
Verwerkingskosten per document
Totale kosten (compute, arbeid, infra) per verwerkte pagina
$0.02–$0.15 per pagina (afhankelijk van complexiteit)
Introductie van TrueFoundry’s Intelligent Document Processing Accelerator
TrueFoundry’s Intelligent Document Processing (IDP) is een op Generatieve AI gebaseerde Accelerator die productieklare best practices combineert met een zeer aanpasbare en nauwkeurige OCR-pijplijn om end-to-end documentverwerkingsworkflows te bouwen en op te leveren.
Hoe het werkt: Uw toepassingen binnen enkele minuten voorzien van gestructureerde data!
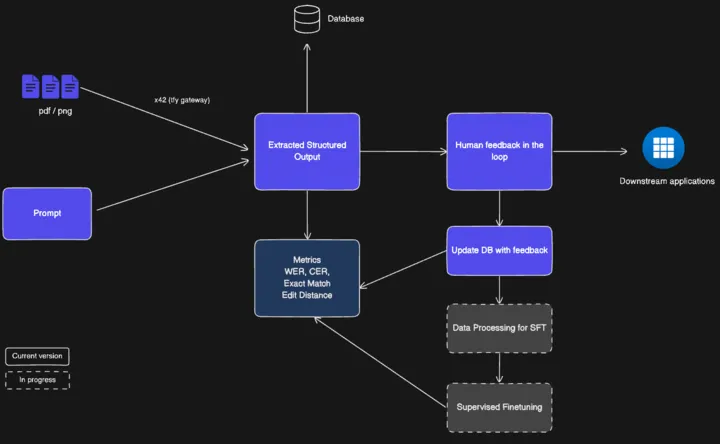
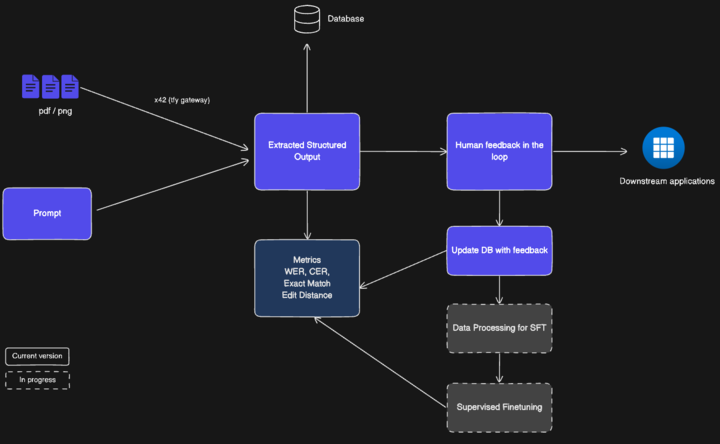
De accelerator verwerkt uw PDF's, afbeeldingen of faxen en opschoont ze: ruisonderdrukking, rechttrekken en upscaling. Modellen starten zo vanaf een scherp beeld. Vervolgens categoriseert het elk document (factuur, recept, handgeschreven notitie) en koppelt het de juiste schema's, prompts en domeinregels. Het extractiemodel haalt gestructureerde velden en betrouwbaarheidsscores op; een regelengine valideert en verrijkt deze met controles en lookups. Items worden via een eenvoudige UI doorgestuurd naar een beoordelaar, en elke correctie helpt het systeem continu te verbeteren.
Aanpasbare en modulaire componenten
De Accelerator bestaat uit pluggbare modulaire componenten die samen zowel een prototype voor dag 1 als een volledige productieklare toepassing kunnen bouwen.
Basiscomponenten
Ondersteuning voor meerdere modellen (OSS & Closed-Source)
Human-in-the-Loop (HITL) & Feedback
Geïntegreerde Fine-Tuning Infrastructuur
Monitoring & Observability
Knowledge Base Integratie (RAG + Knowledge Graph)
Geavanceerde componenten
Geautomatiseerde classificatie & routing
Regio-bewuste OCR & Bounding Boxes
Schema Auto-Discovery (Zero-Shot)
Validatie & Post-Processing
Compliance & Auditeerbaarheid
Ons ontwerp is gevalideerd in meerdere Enterprise-implementaties
Gebouwd voor keuzevrijheid en controle
De accelerator is model-agnostisch, OSS of closed-source, en kan tussen providers routen voor prijs/prestatie en failover. Experts blijven in de loop met een op het domein afgestemde review-UI waarvan de aanpassingen trainingsdata worden.
Operationeel vanaf dag één.
U krijgt realtime observability (latentie, doorvoer, kosten per document) plus zakelijke KPI's—STP, veldnauwkeurigheid en aanpassingsfrequentie. Validatie en verrijking dwingen regels over meerdere velden af en normaliseren formaten voordat de data downstream-toepassingen bereikt.
Aanpasbaar, vooral voor complexe Enterprise Use Cases
Schema discovery, regio-bewuste OCR en grounding op basis van een knowledge base verwerken complexe lay-outs; auditlogs bewaren elke actie, score en override voor gereguleerde omgevingen.Hoe zorgen we ervoor dat dit systeem schaalt?
Onze architectuur is een cloud-agnostische, op microservices gebaseerde blauwdruk die is ontworpen voor betrouwbaarheid, schaalbaarheid en kostenefficiëntie op enterprise-niveau. Door kerncomponenten te ontkoppelen met asynchrone message queues, verwerkt het systeem wisselende werkbelastingen en onderdelenstoringen zonder dataverlies, waardoor vendor lock-in wordt vermeden.
Ingestielaag
Stateless LLM-gateway: Enkel toegangspunt (authenticatie/rate-limit) dat elk document op een message topic plaatst.
Duurzame buffering: Ruwe uploads worden naar object storage geschreven voor replay, audit en herstel.
Verwerkingspijplijn
Isolatie van diensten: Afzonderlijke workers voor classificatie, extractie en validatie; elk kan onafhankelijk worden bijgewerkt en geschaald.
Onafhankelijke automatische schaling: CPU/GPU-intensieve extractors schalen op tijdens pieken zonder lichtere fasen te beïnvloeden.
Idempotente taken: Herhaalbare taken met ontdubbeling zorgen voor veilige retries en exact-één-keer uitvoer.
Data- & Statusbeheer
Overdraagbare opslag: S3-compatibele buckets bewaren documenten en artefacten met versiebeheer.
Relationele ruggengraat: PostgreSQL-compatibele database volgt metadata, workflowstatus en HITL-wachtrijen.
Schemacontracten: Duidelijke interfaces tussen diensten maaken veilige, backward-compatible wijzigingen mogelijk.
Feedback- & MLOps-laag
Menselijke lus: Geverifieerde correcties worden vastgelegd met herkomst voor trainingsdata.
Gesloten lus: Geautomatiseerde her-train/evalueer/deploy-pijplijnen pushen betere modellen terug naar productie.
Beheerde releases: Model-registry, A/B-controles en rollbacks houden verbeteringen veilig en auditeerbaar.
Conclusie
Punctuele OCR is niet "opgelost", vooral wanneer nauwkeurigheid, schaal en kosten van belang zijn. TrueFoundry’s IDP Accelerator biedt een pragmatische, productieklare aanpak met multi-model extractie, geautomatiseerde validatie en een human-in-the-loop die het systeem continu verbetert. Het resultaat is snellere straight-through processing, hogere nauwkeurigheid op veldniveau voor de documenten die uw bedrijf daadwerkelijk draaiende houden, en een platform dat uw teams kunnen beheren, niet alleen een demo om te bewonderen.
Deze accelerator helpt u om meer documenten efficiënt en kosteneffectief te verwerken, terwijl de dataintegriteit voor auditors, experts en operators behouden blijft, wat onmiddellijke implementatie mogelijk maakt zonder de noodzaak van omvangrijke maatwerkontwikkeling.
Pilot in productie: Neem contact met ons op via deze link. We kunnen een werkend prototype maken voor uw eigen use case en u helpen om binnen 1/10e van de normale ontwikkeltijd een productieklare toepassing op te leveren!
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting