



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het TrueFoundry-team heeft de afgelopen maand erg hard gewerkt aan het toevoegen van functionaliteiten aan ons ML Deployment platform. Ons doel is hier om een deployment platform te bouwen dat het absoluut eenvoudig maakt om ML-modellen en services te deployen, terwijl de beste engineering- en beveiligingsprincipes worden gehandhaafd. Om een geweldig ML-platform te bouwen, hebben we een solide engineering platform nodig en daarom was een groot deel van de initiële focus gericht op het leveren van een solide platform om code te deployen.

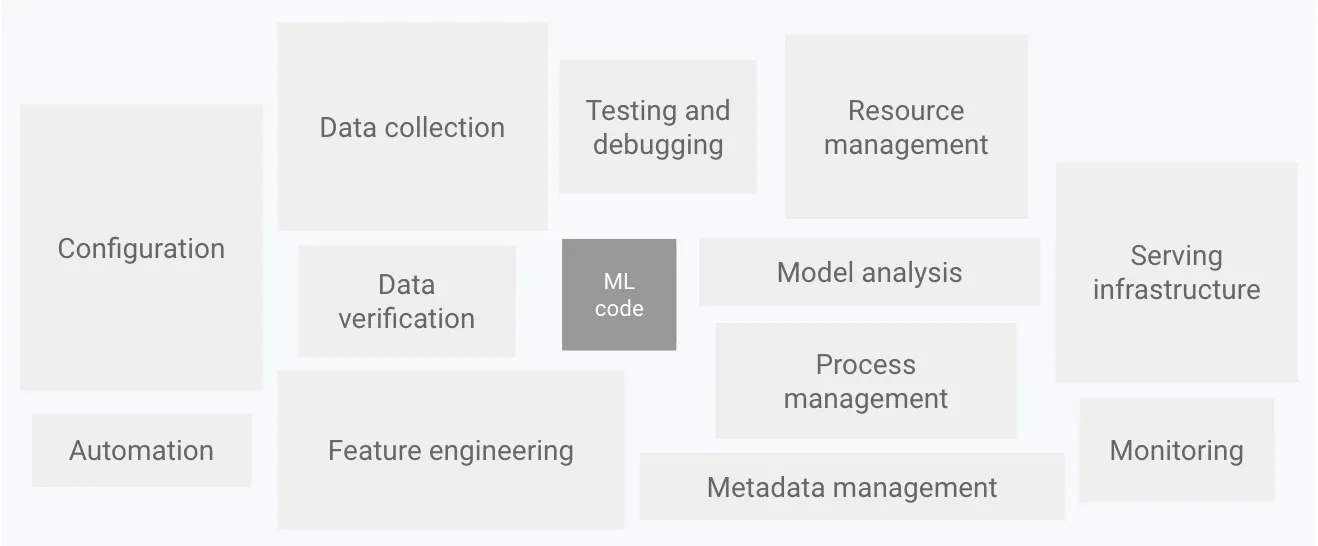
Van alle onderdelen van het hierboven beschreven ML-platform richten wij ons op de serving infrastructure, monitoring en alle automatisering daaromheen.
Er is veel werk gestoken in het bouwen van ons deployment platform bovenop Kubernetes. Het doel was om het absoluut eenvoudig te maken om binnen 5 minuten te deployen, waarbij het platform zorgt voor het bouwen van de image vanuit de broncode, het opslaan daarvan in een Docker registry en tenslotte het deployen van de applicatie op Kubernetes. Enkele updates van de afgelopen maand zijn onder andere:
Machine learning-modellen kunnen een heel verschillende inference latency of prestatie hebben, afhankelijk van het type instance. Bij het testen van de inference latency van een Hugging Face-model op Intel- versus AMD-processoren vonden we Intel-processoren bijvoorbeeld zo'n 30% sneller. Daarom hebben we nu een optie waarmee gebruikers het instance type kunnen kiezen tijdens het deployen van hun workloads. Als het instance type niet is geselecteerd, kan de workload worden gedeployed op elk beschikbaar instance type.

We hadden eerder een Grafana-link voor het tonen van logs en metrics. Hoewel Grafana zeer aanpasbaar was, waren permissies en toegangsbeheer niet echt mogelijk in Grafana. Bovendien bleek het wat traag en lastig te begrijpen voor gebruikers die niet aan Grafana gewend waren. Daarom hebben we onze eigen UI geïmplementeerd voor het tonen van logs en metrics, wat in de meeste gevallen volstaat. We bieden nog steeds de Grafana-integratie in de public cloud aan voor meer geavanceerde gebruikers.


We kunnen nu gebruikers toevoegen als editor, viewer of admin op secret groups.

We kunnen nu rechtstreeks deployen naar TrueFoundry vanuit elke GitHub- of Bitbucket-repository. Gebruikers kunnen integreren met hun eigen private repositories via de OAuth-flow en de juiste parameters selecteren om de applicatie te deployen.

Voor de komende maand werken we aan een paar spannende functies, zoals:
Blijf op de hoogte en laat ons uw feedback weten!
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























