August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Fine-tuning is een techniek binnen machine learning, met name deep learning, waarbij een pre-trained model verder wordt getraind of "afgestemd" op een kleinere, specifieke dataset die is afgestemd op een bepaalde taak.
Stel dat je een model ontwikkelt dat technische handleidingen voor elektronica genereert met behulp van GPT-3 (een groot taalmodel met 175 miljard parameters), maar de generieke output van GPT-3 voldoet niet aan de vereiste technische nauwkeurigheid en toon.
In dit geval kun je erover nadenken om het model opnieuw te trainen voor jouw specifieke use case. Maar een model zoals GPT-3 direct vanaf nul trainen om deze niche-taak aan te pakken is onpraktisch vanwege de benodigde rekenkracht en gespecialiseerde data.
Dit is waar fine-tuning om de hoek komt kijken.
Fine-tuning is zoals het aanleren van een nieuw kunstje aan GPT-3. Het weet al heel veel over talen dankzij de training op talloze teksten, van boeken tot websites. Het is jouw taak om het verder te trainen op een doelgerichte dataset—in dit geval een corpus van bestaande technische handleidingen en documentatie specifiek voor elektronica.
Enkele basismethoden voor fine-tuning:
Parameter Efficient Fine-tuning (PEFT) is een techniek die erop gericht is het aantal extra parameters dat nodig is tijdens het fine-tunen van pre-trained neurale netwerkmodellen te minimaliseren.
Dit helpt de berekeningskosten en het geheugengebruik terug te dringen, terwijl de prestaties behouden blijven of zelfs verbeteren. PEFT bereikt dit door prompt embeddings toe te voegen als extra modelparameters en slechts een klein aantal extra parameters te tunen.
PEFT vereist ook een veel kleinere dataset in vergelijking met traditionele fine-tuning.
Laad het door jou gekozen model met behulp van een machine learning framework zoals TensorFlow, PyTorch of Hugging Face's Transformers-bibliotheek. Deze frameworks bieden API's om pre-trained modellen eenvoudig te downloaden en te laden.
Hier is een voorbeeldcode:
Vóór het fine-tunen moet je experimenteren met verschillende prompts om de reacties van het model te sturen. Test verschillende prompts met het pre-trained model om te zien hoe ze de output beïnvloeden en kies de meest geschikte. Je kunt ook verschillende parameters aanpassen, zoals max_length, temperature, enz.
Het is te vergelijken met het zoeken naar de beste manier om je vraag te stellen, zodat het model begrijpt wat je wilt.
In een dataset voor fine-tuning zijn er doorgaans twee onderdelen: Prompt (Input) en Answer (Output). De Prompt is als een vraag of een startpunt, en de Answer is wat je wilt dat het model genereert als antwoord op die vraag. Dit kan de vorm hebben van kolommen of een reeks tekstinvoer (wat vaker voorkomt).
De beste prompt die in de vorige stap is geïdentificeerd, wordt hier gebruikt en de Answer zal precies zijn wat we willen dat het model produceert wanneer het die Prompt krijgt.
Dit is waar je het model leert om beter te worden in jouw taak. Je gebruikt de dataset om de "kennis" van het model lichtjes aan te passen.
Hier is een vereenvoudigd overzicht van het opzetten en uitvoeren van het fine-tuning process met PyTorch:
from transformers import AdamW
optimizer = AdamW(model.parameters(), lr=5e-5) # lr is de learning rate
Bij het verkennen van tools voor prompt engineering is het handig om ze in te delen in twee hoofddomeinen: Code Platforms en No-Code Platforms. Deze indeling vereenvoudigt het selectieproces.
Code Platforms verwijzen naar platforms die virtuele machines bieden die kunnen worden gebruikt om je eigen aangepaste Python-script voor fine-tuning uit te voeren, zoals de eerder genoemde. No-Code Platforms verwijzen daarentegen naar tools die minimale of geen Python-scripts vereisen om te draaien. Ze beschikken over een dedicated UI waar je de training met een paar kliks kunt starten.
No-code platforms zijn daarentegen afgestemd op eenvoud en gebruiksgemak. Ze nemen de noodzaak weg om Python-scripts te schrijven en bieden een intuïtieve UI waar de training met slechts enkele kliks kan worden gestart. Dit domein is geschikt voor gebruikers zonder programmeerkennis of voor degenen die de voorkeur geven aan een eenvoudige benadering van prompt engineering.
TrueFoundry is een tool die ML-teams helpt hun modellen soepel te laten draaien. Het is gebouwd op Kubernetes, wat betekent dat het kan draaien op verschillende clouds of zelfs op je eigen servers. Dit is belangrijk voor bedrijven die zich zorgen maken over databeveiliging en kostenbeheersing.
Voor Fine-tuning is het een van de beste tools die er zijn, geschikt voor zowel beginners als experts. Hier heb je twee opties: het deployen van een fine-tuning notebook voor experimenten of het starten van een dedicated fine-tuning job.
Notebooks bieden een ideale omgeving voor verkennende en iteratieve fine-tuning. Je kunt experimenteren op een kleine subset van data en verschillende hyperparameters uitproberen om de ideale configuratie voor de beste prestaties te bepalen.
Zodra je de optimale hyperparameters en configuratie via experimenten hebt geïdentificeerd, helpt de overstap naar een deployment job je bij het fine-tunen op de volledige dataset en vergemakkelijkt het snelle en betrouwbare training.
Daarom worden notebooks sterk aanbevolen voor verkenning in een vroeg stadium en hyperparameter tuning, terwijl deployment jobs de voorkeur genieten voor grootschalige LLM finetuning, vooral wanneer de optimale configuratie is vastgesteld via eerdere experimenten.
Hier is een stapsgewijze handleiding om te fine-tunen met zowel Notebooks als Jobs:
Truefoundry ondersteunt twee verschillende dataformaten:
Elke regel bevat een key genaamd messages. Elke message key bevat een lijst met berichten, waarbij elk bericht een dictionary is met role- en content-keys. De role-key kan user, assistant of system zijn en de content-key bevat de inhoud van het bericht.
2. Fine-Tuning
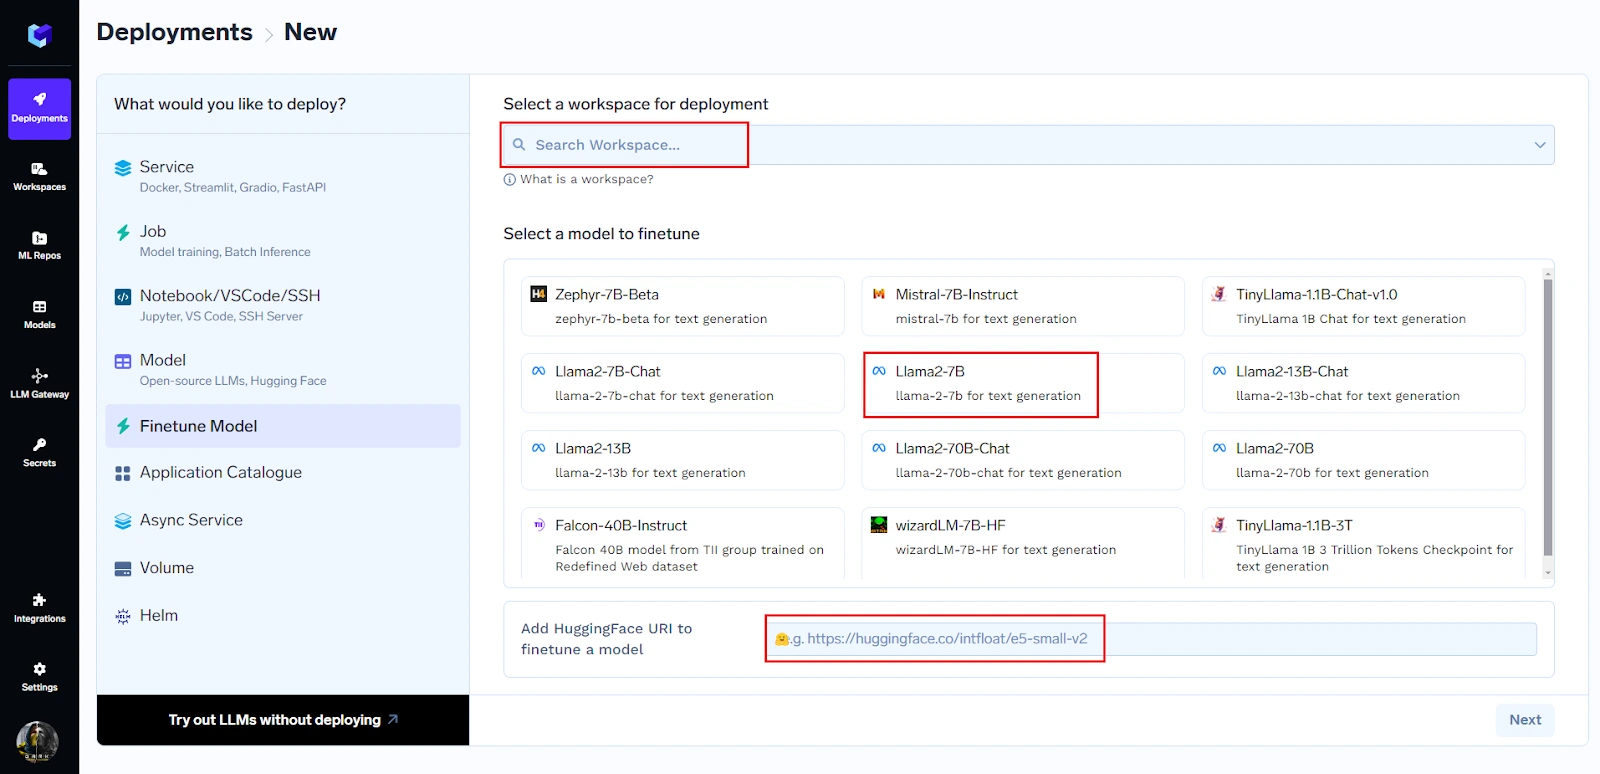
Je kunt beginnen met fine-tunen met slechts drie kliks:
Je kunt een model kiezen uit de uitgebreide lijst die aanwezig is of simpelweg de Hugging Face URL plakken om te beginnen met fine-tunen.
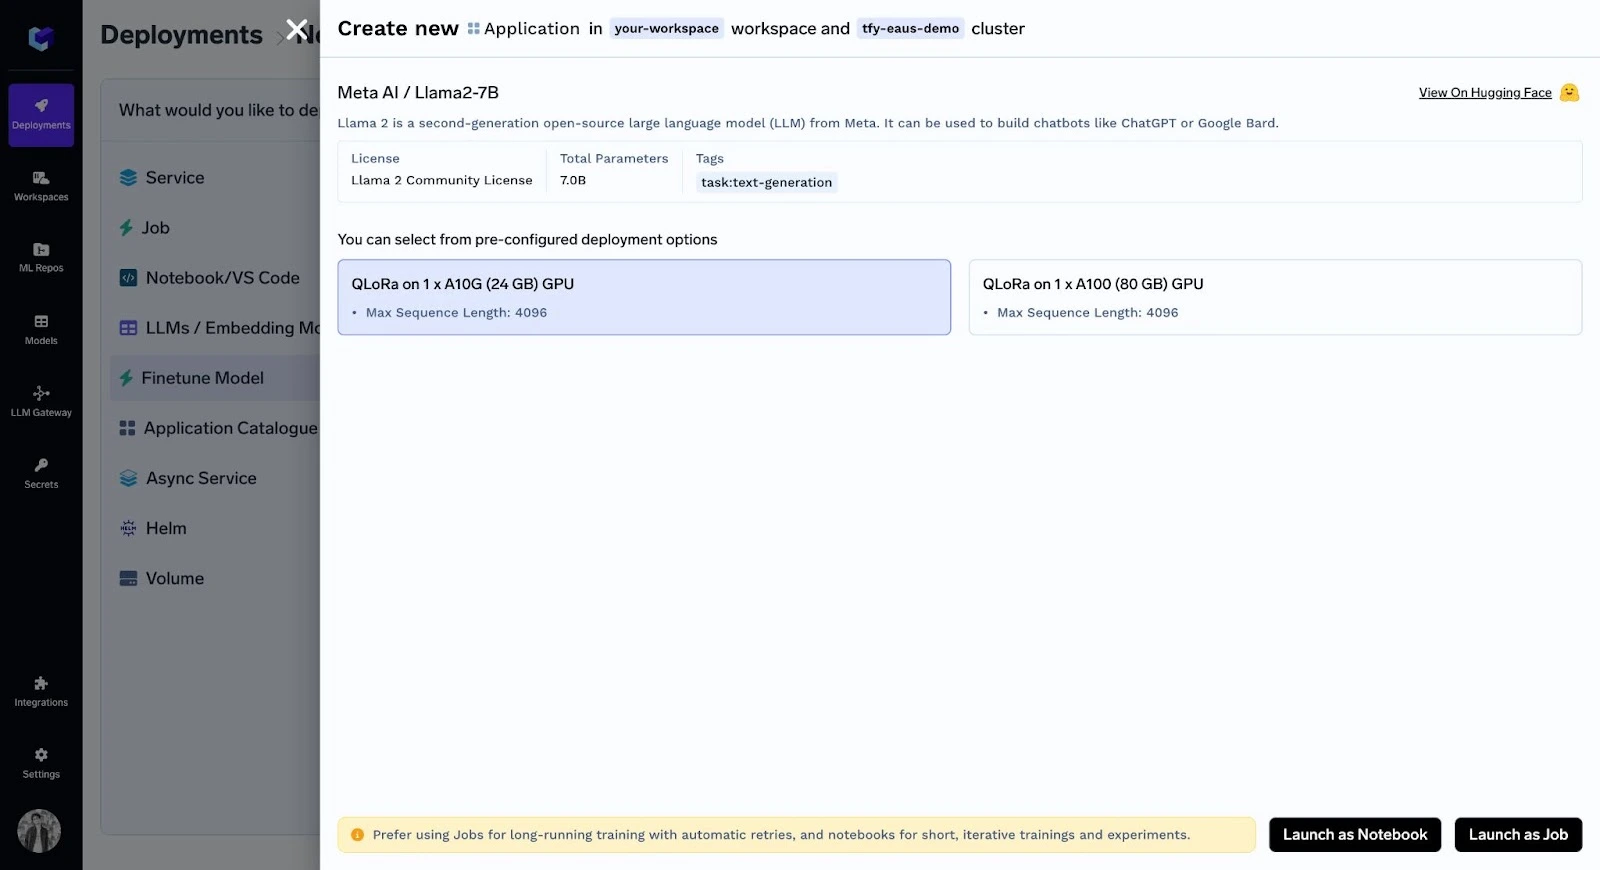
Nadat je de gewenste GPU hebt geselecteerd, heb je twee opties: Run as notebook of Job.
3. Fine-Tuning met een Notebook
Na het kiezen van ‘Launch as Notebook’ en het selecteren van standaardwaarden voor hyperparameters, kun je je notebook bekijken:

4. Fine-Tuning als Job:
Voordat je begint, moet je eerst een ML Repo aanmaken (dit wordt gebruikt om je trainingsstatistieken en artifacts op te slaan, zoals je checkpoints en modellen) en je workspace toegang geven tot de ML Repo. Je kunt meer lezen over ML Repo's in de documentatie van TrueFoundry.
Nu kies je ‘Launch as Job’ en selecteer je de standaardwaarden voor hyperparameters om het fine-tunen te starten.
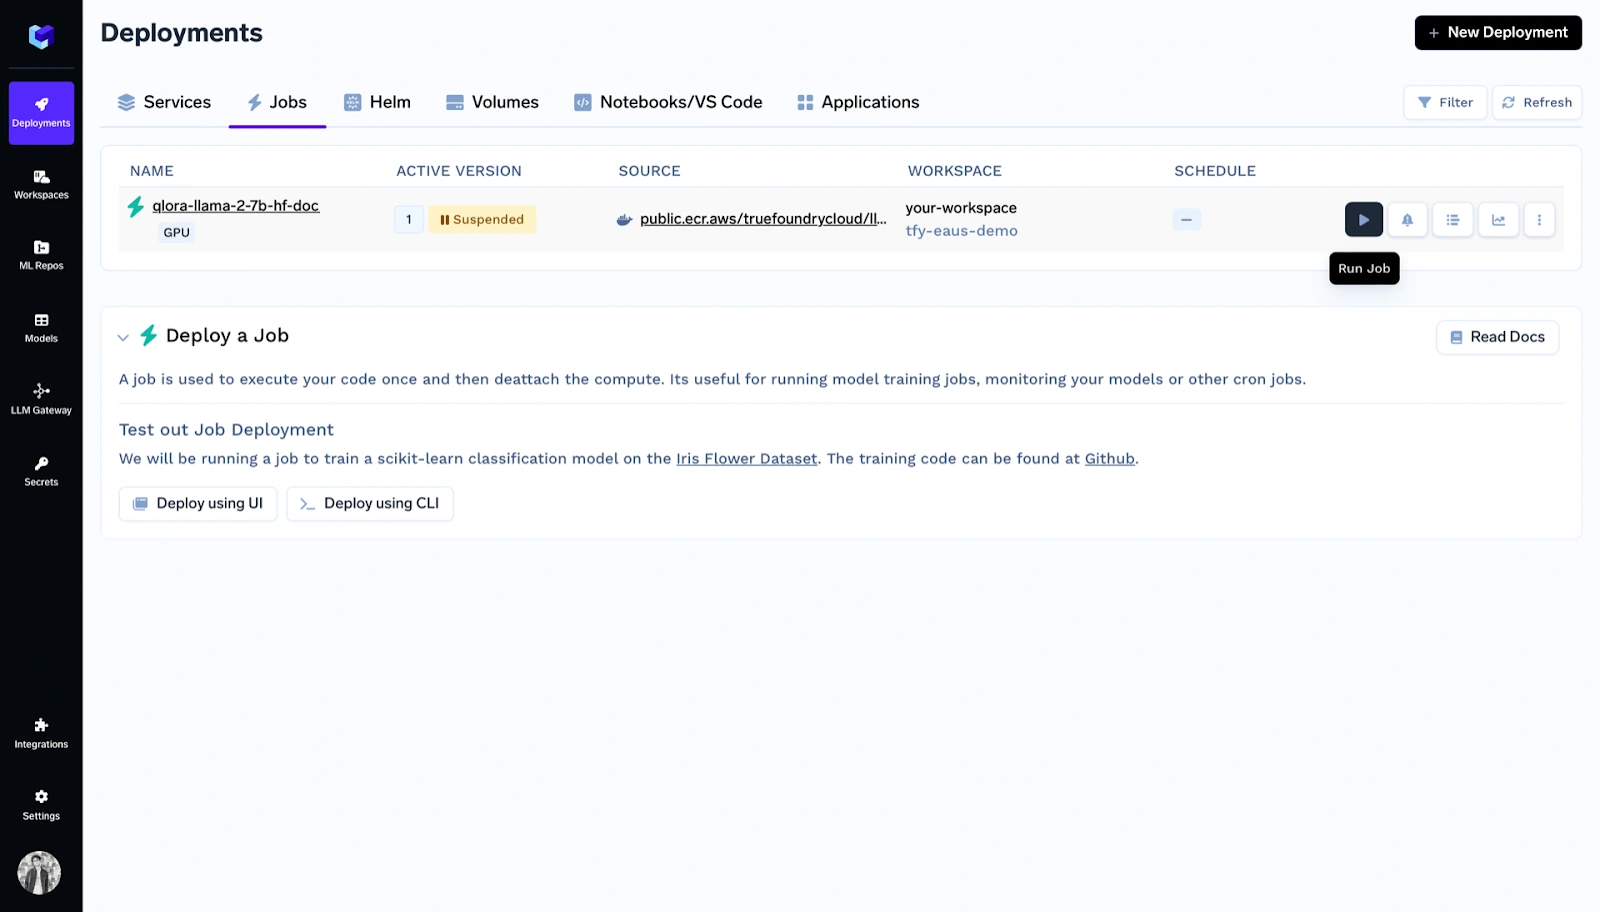
Onder deployments zie je de job vermeld staan en kun je op run job klikken.
Belangrijkste functies:
De OpenAI API biedt toegang tot geavanceerde kunstmatige intelligentiemodellen ontwikkeld door OpenAI, waaronder de nieuwste versies van GPT (Generative Pre-trained Transformer). Een van de opvallendste functies van de OpenAI API is de mogelijkheid om modellen te fine-tunen op aangepaste datasets.
Zo kun je het gedrag van modellen zoals GPT-3 of nieuwere versies afstemmen op specifieke toepassingen of laten voldoen aan specifieke inhoudsstijlen en -voorkeuren.
Omdat ik verwijs naar de API, is het niet helemaal ‘No-Code’, maar men kan het nog steeds eenvoudig instellen voor training in vergelijking met andere tools uit de vorige sectie.
Voorbeeldcode voor Fine-Tuning:
Om een model te fine-tunen, moet je eerst je dataset voorbereiden in een formaat dat de OpenAI API begrijpt. In de regel moet je een JSON-bestand maken dat er als volgt uitziet:
Je kunt de dataset eenvoudig uploaden met behulp van de OpenAI CLI (Command Line Interface).
openai tools fine_tunes.prepare_data -f your_dataset.jsonl
Zodra je dataset is voorbereid en geüpload, kun je een fine-tuningproces starten. Het volgende is een voorbeeld met behulp van de Python-bibliotheek van OpenAI:
Nadat het fine-tuningproces is voltooid, kun je je gefine-tunede model gebruiken voor het genereren van tekst of andere taken door het ID van het gefine-tunede model op te geven:
Je kunt je gefine-tunede model ook deployen.
Belangrijkste functies:
Microsoft Azure is een cloud computing-platform dat een breed scala aan diensten biedt, waaronder computing, opslag, analytics en meer. Het biedt gebruikers de tools om toepassingen efficiënt te bouwen, deployen en beheren.
Een opmerkelijke functie is de intuïtieve interface, waardoor beginners er gemakkelijk doorheen kunnen navigeren zonder diepgaande kennis van coderen. Met eenvoudige kliks in plaats van complexe code kunnen gebruikers hun toepassingen fine-tunen, wat Azure een toegankelijke tool maakt voor zorgeloze ontwikkeling.
Hier is een eenvoudige handleiding voor het instellen van een fine-tuning ‘job’ in Azure:
Uiteraard is dit de basisvereiste voor alle tools. De trainingsdata kan de indeling JSON Lines (JSONL), CSV of TSV hebben. De vereisten voor je data variëren afhankelijk van de specifieke taak waarvoor je het model wilt fine-tunen.
Voor tekstclassificatie:
Twee kolommen: Sentence (string) en Label (integer/string)
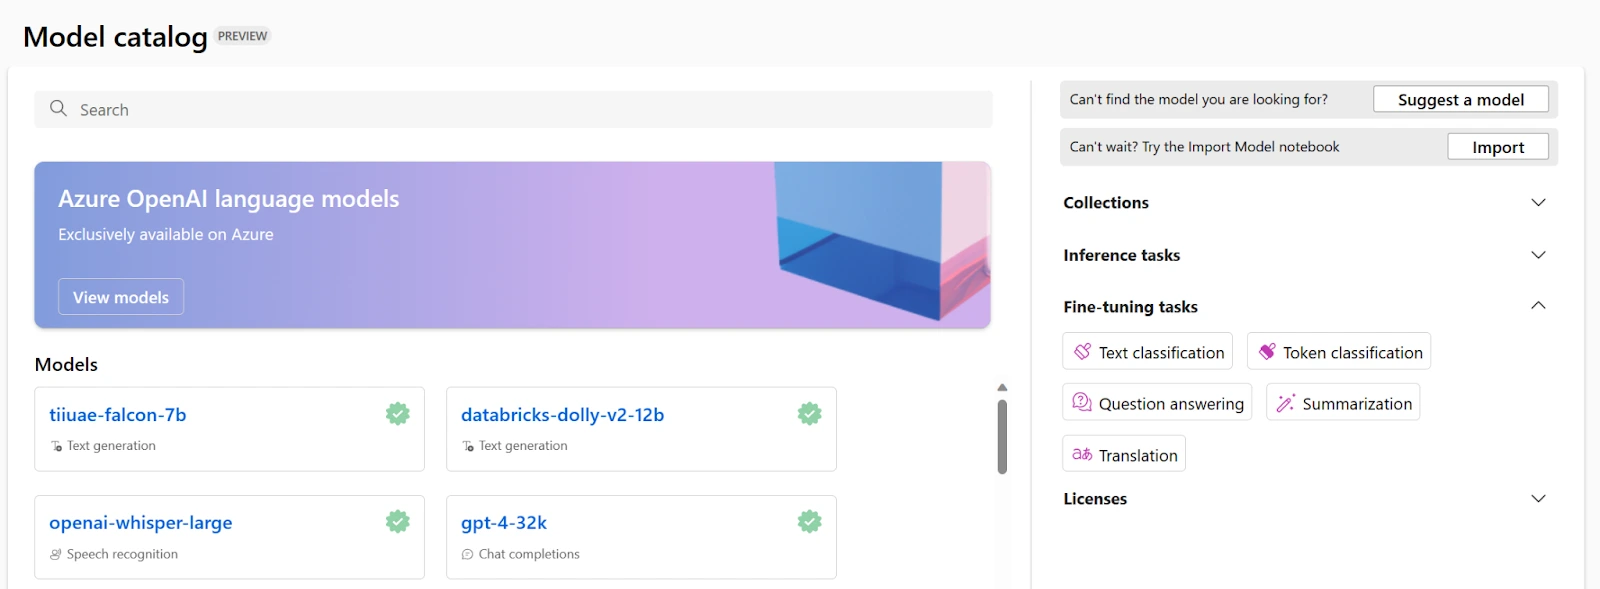
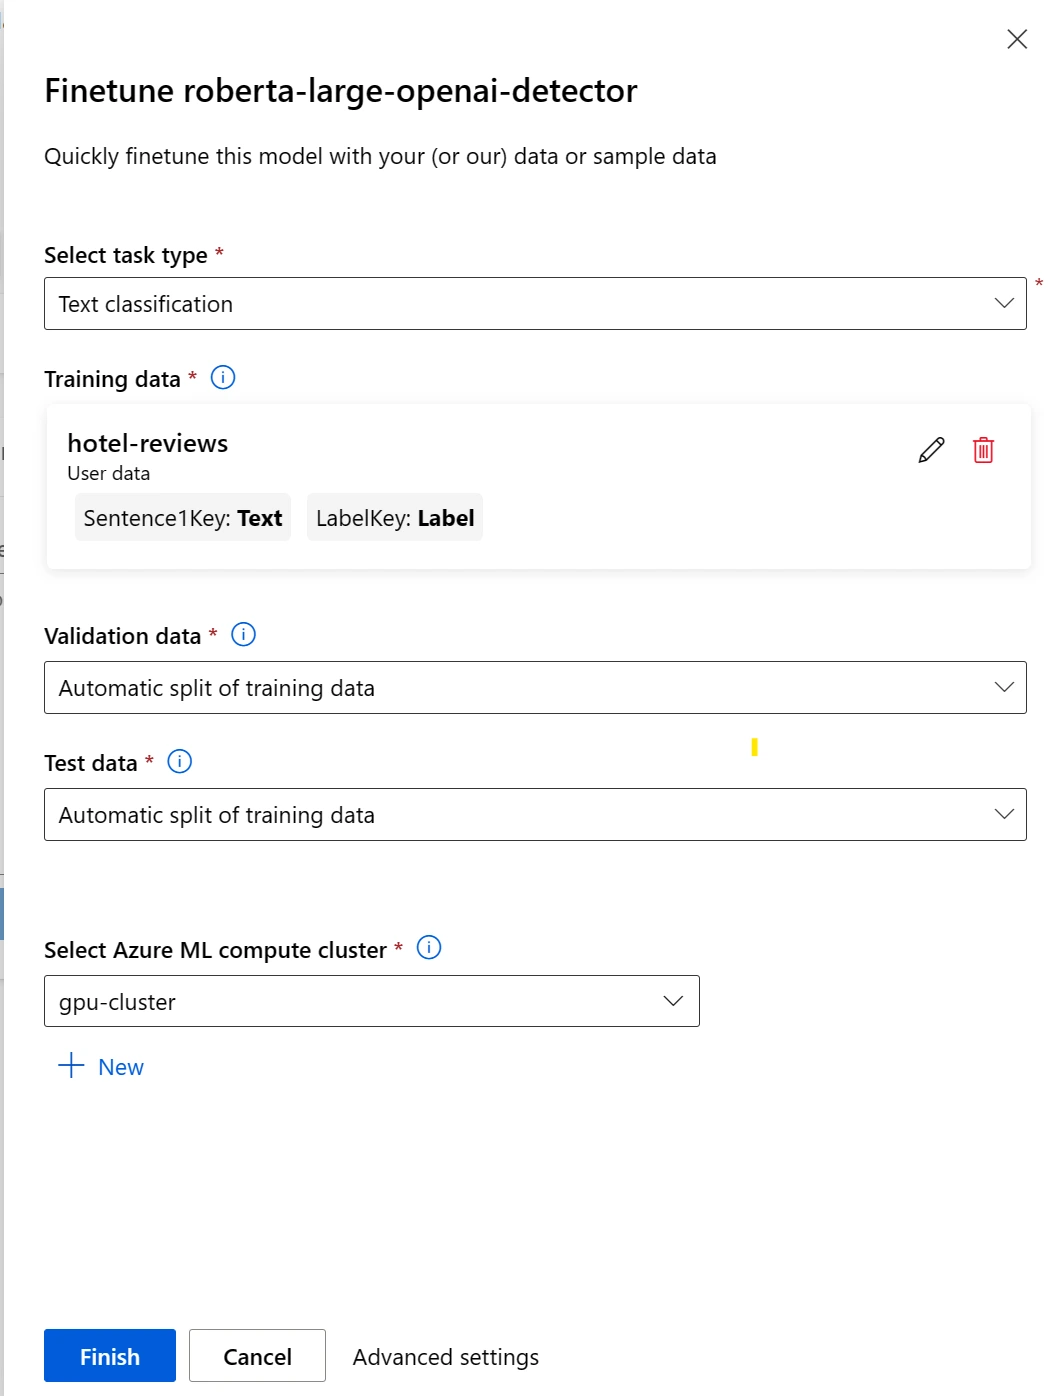
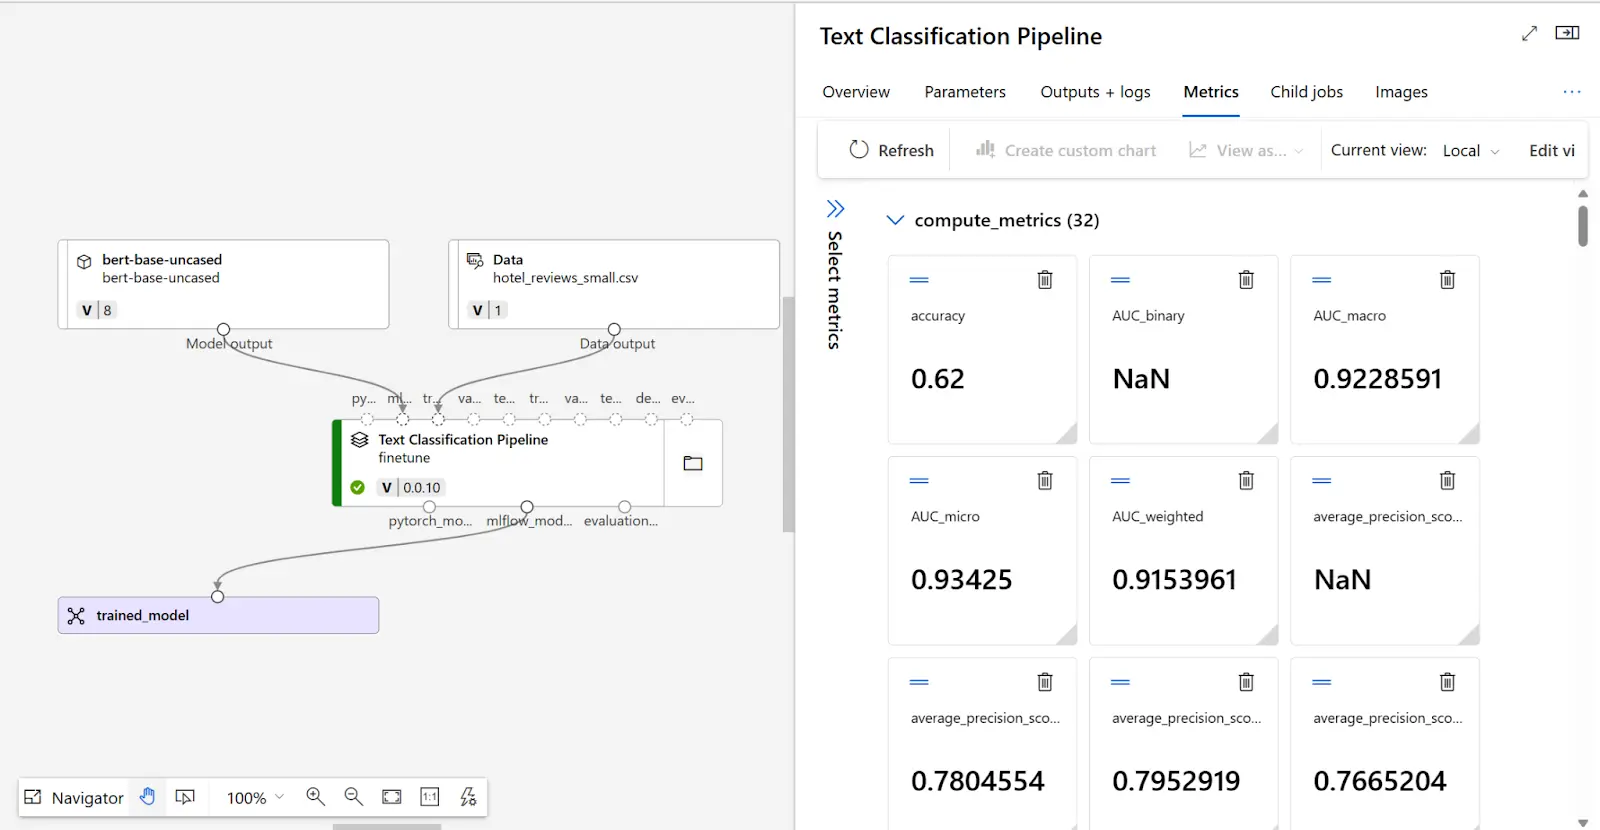
Nadat je de fine-tuning job hebt ingediend, wordt er een pipeline job aangemaakt om je model te trainen. Je kunt alle inputs controleren en het model ophalen uit de job-outputs.
Om te bepalen of je gefine-tunede model naar behoren presteert, kun je de trainings- en evaluatiestatistieken bekijken.
Belangrijkste functies:
Replicate is een veelzijdige tool ontworpen voor het fine-tunen van verschillende aspecten van softwaretoepassingen. De toepassingen van Replicate als fine-tuning tool omvatten het optimaliseren van prestaties, het aanpassen van configuraties en het verbeteren van functionaliteit met minimale inspanning. Het vereenvoudigt het proces door de GPU-setup af te handelen. Net als bij de OpenAI API is het niet precies ‘No-Code’ zoals andere tools in de lijst, maar toch kan men het gemakkelijk instellen voor training in vergelijking met andere tools in de vorige sectie.
Je trainingsdata moet in JSONL-formaat zijn. Hieronder staat een voorbeeld van hoe je dit bestand kunt structureren:
Je moet je Replicate API-token instellen als een omgevingsvariabele in je terminal:
export REPLICATE_API_TOKEN=<your-token-here>
Je kunt je data uploaden naar een S3 bucket of rechtstreeks bij Replicate met behulp van curl-opdrachten:
Je moet een leeg model aanmaken op Replicate voor je getrainde model. Wanneer je training is voltooid, wordt deze als een nieuwe versie naar dit model gepusht.
Je moet een training job aanmaken in je IDE, zoals hieronder weergegeven:
Om de voortgang programmatisch te monitoren, kun je het volgende gebruiken:
Nadat de training is voltooid, kun je je model uitvoeren met de API:
Belangrijkste functies:
Bij Gen AI Studio heb je beide opties voor het instellen van fine-tuning jobs: via de API of de website. Hier zal ik het alleen over de API-methode hebben. Het heeft het meest gestroomlijnde proces in vergelijking met de hierboven besproken tools.
Je dataset moet in JSONL-formaat zijn, waarbij elke regel een JSON-object is met de keys "input_text" en "output_text". De training kan al beginnen met slechts 10 voorbeelden, maar minstens 100 voorbeelden worden aanbevolen.
Je moet je dataset uploaden naar een Google Cloud Storage (GCS) bucket; als je er geen hebt, kun je er een aanmaken in Google Drive.
Nu moet je je credentials opgeven om de verbinding tot stand te brengen:
Je moet een functie voor tuning definiëren met de benodigde parameters.
Roep de eerder opgegeven tuning-functie aan met jouw specifieke parameters. De parameter training_data kan een GCS URI of een pandas DataFrame zijn.
Belangrijkste functies:
Predibase is een gespecialiseerd platform ontworpen om het fine-tunen van grote taalmodellen (LLM's), zoals GPT-4, te vergemakkelijken voor specifieke taken of toepassingen. Het biedt toegang tot de geavanceerde mogelijkheden van LLM's door een gestroomlijnde, gebruikersvriendelijke omgeving te bieden voor het aanpassen van deze modellen aan individuele behoeften.
Predibase geeft je de optie van zowel de Python SDK als een UI voor het uitvoeren van fine-tuning jobs.
Hier is een stapsgewijze handleiding om mistral-7b-instruct te fine-tunen:
Meld je eerst aan voor een account op Predibase en stort geld om credits toe te voegen. Genereer vervolgens je API Key.
Ga naar Models en klik vervolgens op “New Model Repository” zoals hieronder weergegeven:
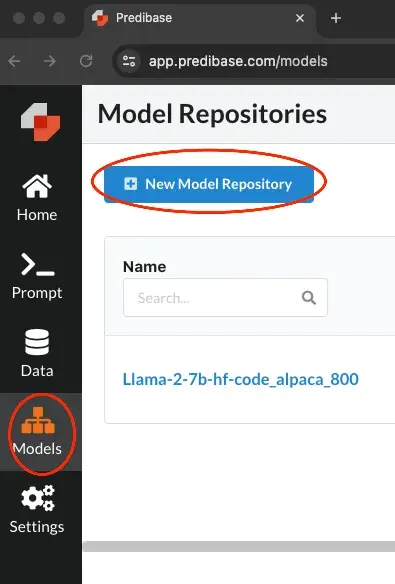
Geef je repository nu een naam en voeg een beschrijving toe.
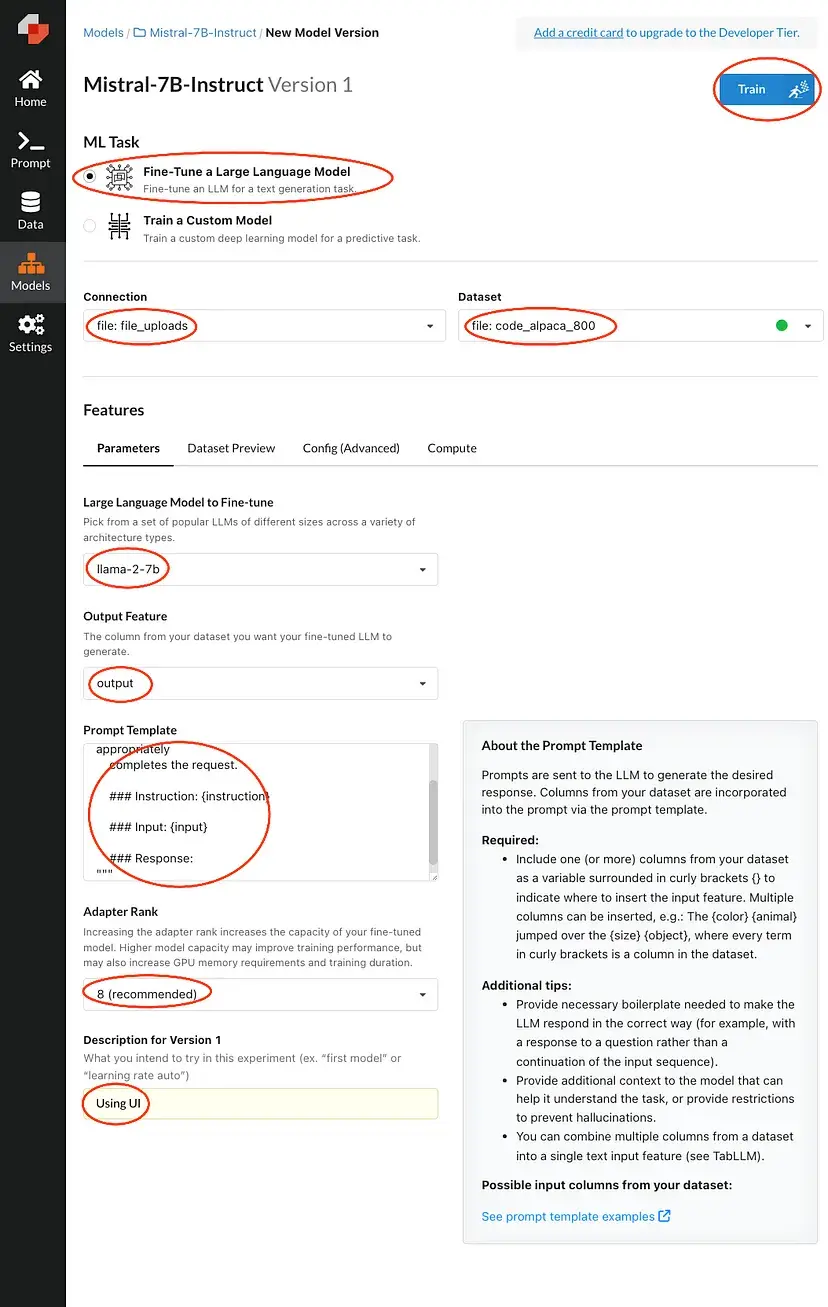
Vul de gemarkeerde gebieden in en druk vervolgens op train. Dit zet je verzoek in de wachtrij totdat er rekenkracht beschikbaar is.
Code Platforms zijn ontworpen voor gebruikers met een solide achtergrond in programmeren. Deze platforms bieden virtuele machines waarmee aangepaste Python-scripts kunnen worden uitgevoerd voor taken zoals fine-tuning. Deze platforms zijn perfect voor projecten die hoge mate van maatwerk en ingewikkelde controle over de trainings- en deploymentfasen vereisen.
Amazon SageMaker is een volledig beheerde dienst die ontwikkelaars en data scientists de mogelijkheid biedt om snel machine learning-modellen te bouwen, trainen en deployen.
Amazon SageMaker heeft geen dedicated, ingebouwde "fine-tuning" functie die specifiek zo is gelabeld voor grote taalmodellen. In plaats daarvan biedt het een krachtig en flexibel platform waarmee je aangepaste Python-scripts kunt uitvoeren om fine-tuning taken te volbrengen.
Hier is een eenvoudig voorbeeld van hoe je een fine-tuning job voor een taalmodel zou kunnen starten met Hugging Face op SageMaker. Dit gaat ervan uit dat je al een AWS-account hebt ingesteld en de AWS CLI hebt geconfigureerd. (je kunt TensorFlow of PyTorch rechtstreeks op Amazon SageMaker gebruiken voor fine-tuning taken)
Normaal gesproken schrijf je een fine-tuning script (train.py) dat je doorgeeft aan de estimator. Dit script moet de logica bevatten voor het laden van je model, fine-tuning en opslaan.
Belangrijkste functies:
Google Colab is een populaire cloud-based Jupyter notebook-dienst die gratis toegang biedt tot rekenresources, waaronder GPU's en TPU's, waardoor het een uitstekend platform is voor het fine-tunen van grote taalmodellen (LLM's).
Het is bijzonder beginnersvriendelijk. Colab-notebooks draaien in de cloud, rechtstreeks vanuit je browser, zonder dat er een lokale installatie vereist is.
Hier is het eenvoudige codefragment voor het fine-tunen van een Transformer Model met Hugging Face Transformers en PyTorch in Google Colab
!pip install torch torchvision transformers
model.save_pretrained("/content/drive/My Drive/Colab Models/my_finetuned_model")
Belangrijkste functies:
Paperspace Gradient is een reeks tools die is ontworpen om het proces van het ontwikkelen, trainen en implementeren van machine learning-modellen in de cloud te vereenvoudigen.
Gradient is bijzonder effectief voor taken zoals het fine-tunen van large language models (LLMs) vanwege de schaalbare infrastructuur en ondersteuning voor containers, wat het een sterke keuze maakt voor data scientists en ML-professionals.
Hier is een voorbeeld van het fine-tunen van een Transformer Model met PyTorch op Paperspace Gradient.
model.save_pretrained("./my_finetuned_model")
Belangrijkste kenmerken:
Run.AI is een platform dat is ontworpen om GPU-resources te optimaliseren voor machine learning-workloads, waardoor het voor data scientists en AI-onderzoekers eenvoudiger wordt om complexe AI-modellen uit te voeren en te beheren, inclusief het fine-tunen van large language models (LLMs).
Het is gebaseerd op Kubernetes, een tool die computerresources efficiënt organiseert. Zo maakt het het uitvoeren van complexe AI-projecten eenvoudiger en kunnen teams hun projecten soepel laten groeien.
U kunt de documentatie van Run.AI raadplegen voor gedetailleerde inzichten; hier is een vereenvoudigd voorbeeld gebaseerd op de algemene workflow voor het fine-tunen van een model zoals LLaMA-2 op het Run.AI-platform.
runai submit my-fine-tuning-job -p my-project --gpu 2 --image my-llama2-fine-tuning-image train.py
Uw train.py-script moet de logica bevatten voor het laden van LLaMA-2 (of het door u gekozen model), uw dataset, en het uitvoeren van het fine-tuningproces. Dit kan het gebruik omvatten van bibliotheken zoals Hugging Face Transformers voor het laden van het model en TensorFlow of PyTorch voor de trainingsloop.
from transformers import LlamaForConditionalGeneration, LlamaTokenizer
Run.AI biedt tools om het GPU-gebruik en de voortgang van uw trainingsjobs te monitoren en computationele resources effectief te beheren. Gebruik het Run.AI-dashboard of de CLI om de status en prestaties van uw job bij te houden.
runai list jobs
Dit commando geeft een overzicht van alle huidige jobs, zodat u de voortgang en het resourcegebruik van uw fine-tuningtaak kunt monitoren.
Belangrijkste kenmerken:
De juiste tool voor u kiezen:
Gebruiksgemak: Kies tools die eenvoudig zijn, vooral als u niet veel ervaring hebt met coderen. Voor sommige tools hoeft u niet eens code te schrijven!
Schaalbaarheid: Zorg ervoor dat de tool kan meegroeien met uw project en grotere datasets en complexere modellen soepel kan verwerken.
Ondersteuning voor modellen en datasets: Kies tools die goed werken met de specifieke typen data en modellen die u gebruikt.
Computationele resources: Zoek naar toegang tot GPUs of TPUs als uw project zware rekenkracht nodig heeft.
Kosten: Bedenk hoeveel u bereid bent uit te geven. Sommige tools zijn gratis; andere rekenen kosten op basis van de resources die u gebruikt.
Aanpasbaarheid en controle: Als u goed de weg weet in code, geeft u misschien de voorkeur aan tools waarmee u alles kunt aanpassen.
Integratie: Het is eenvoudiger als de tool naadloos past in uw bestaande workflow en tools.
Community en ondersteuning: Een ondersteunende community en goede documentatie kunnen u veel hoofdpijn besparen.
Führende fine-tuning tools zijn onder meer Hugging Face voor modeltoegang, SiliconFlow voor cloudgebaseerde training en TrueFoundry voor orchestratie op enterprise-niveau. Open-source bibliotheken zoals Axolotl en LLaMA-Factory ondersteunen ook geavanceerde technieken zoals LoRA. TrueFoundry verenigt op unieke wijze modeltoegang, experiment tracking en deployment governance in één enkel beveiligd platform.
Cloud fine-tuningkosten zijn afhankelijk van GPU-rekenuren, modelgrootte en opslagvereisten. Het trainen van een model met 7B parameters kost doorgaans tussen $ 100 en $ 400, terwijl 70B-modellen de $ 10.000 kunnen overschrijden. Het gebruik van parameter-efficiënte methoden zoals QLoRA verlaagt deze kosten aanzienlijk tot ongeveer $ 50–$ 300 per trainingsrun.
PEFT fine-tuning tools maken gebruik van technieken zoals LoRA om slechts een minuscuul fractie van de parameters van een model aan te passen. Dit vermindert de GPU-geheugenvereisten, waardoor teams enorme modellen kunnen trainen op consumentenhardware of een enkele GPU. Deze tools versnellen de trainingssnelheid en leveren tegelijkertijd een nauwkeurigheid die vergelijkbaar is met het volledig hertrainen van het model.
Fine-tuning tools hertrainen modellen op gespecialiseerde datasets, waarbij parameters worden aangepast om de prestaties op domeinspecifieke taken te verbeteren. Prompt engineering past invoertekst aan om de uitvoer te sturen zonder de interne modelgewichten te wijzigen. Hoewel prompt engineering sneller is, biedt fine-tuning diepere controle en superieure nauwkeurigheid voor complexe enterprise use cases.
TrueFoundry vereenvoudigt fine-tuning door een geünificeerde interface te bieden voor dataintegratie, experiment tracking en modelimplementatie. Gebruikers uploaden eigen data en starten fine-tuningjobs op geoptimaliseerde infrastructuur met behulp van hoogwaardige backends. Zodra de training is voltooid, kunnen teams bijgewerkte checkpoints met één klik direct naar productie implementeren.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox