



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Tokenmaxxing /ˈtoʊkənˌmæksɪŋ/ — de praktijk van het optimaliseren van AI-workflows voor tokenconsumptie in plaats van voor bedrijfsresultaten.
Het is wat er gebeurt als teams aantallen tokens behandelen als een productiviteitsmetric: agents roepen zichzelf recursief aan, prompts zwellen op om "context" mee te sturen die nooit gelezen wordt, en routinglogica bevoordeelt dure modellen omdat niemand ooit is ontslagen voor het kiezen van Opus boven Haiku. Slimme engineers doen wat slimme engineers altijd doen — ze optimaliseren het zichtbare getal.
In 2026 toont elk intern AI-dashboard, elke ROI-deck van leveranciers en elke kwartaalherziening dezelfde headline: geconsumeerde tokens. Deze post behandelt de vier enterprise failure modes die schuilgaan achter dat enkele getal — overmatig gebruik van premiummodellen, context stuffing, agent loops en tokenizer drift — en de specifieke gateway controls die voorkomen dat elk daarvan uitgroeit tot een factuurpost van zes cijfers.
TL;DR Tokens zijn een kostenpost (input), geen uitkomstwaarde (output). Bouw de controls waarmee u beide kunt meten en beheren.
In 1976 merkte de Britse econoom Charles Goodhart op: 'Wanneer een maatstaf een doel wordt, ophoudt het een goede maatstaf te zijn.' Software engineering herontdekte dit in de jaren 80 met productiviteitsmetrics op basis van lines-of-code, wat leidde tot langere programma's, niet tot betere. De industrie ging verder. Toch toont in 2026 elk intern AI-dashboard, elke ROI-deck van leveranciers en elke kwartaalherziening dezelfde metric in een iets nieuwere verpakking: geconsumeerde tokens.
Tokens zijn niet slecht. Tokenvolume is niet slecht. Wat wél slecht is, is de tokencounter behandelen als het klassement. Het moment dat 'meeste tokens deze week' sociaal zichtbaar is, doen slimme engineers wat slimme engineers altijd doen: het zichtbare getal optimaliseren. Ze plakken grotere contexten in. Ze routen naar premiummodellen wanneer een kleiner model zou volstaan. Ze bouwen agents die zichzelf recursief aanroepen. Ze manipuleren de metric. We hebben hier nu een naam voor: tokenmaxxing.
Tokenmaxxing is wat er gebeurt als 'AI-gebruik' een proxy wordt voor 'AI-waarde' — en die proxy wordt gemanipuleerd. De enige duurzame oplossing is om de proxy in de eerste plaats nooit het doel te laten worden.
Voordat we de failure modes bespreken, verdient de onderliggende kostenstructuur een heldere blik. Vanaf april 2026 ziet de frontier-tier API-pricing van Anthropic er als volgt uit:
Twee structurele feiten vallen meteen op. Ten eerste kosten outputtokens over de gehele frontier-line-up vijf keer zoveel als inputtokens. Een workflow die een lange generatie teruggeeft, is fundamenteel duurder dan een workflow die een JSON-classificatie teruggeeft, zelfs met een identieke input. Ten tweede is de verhouding tussen Opus en Haiku 5x op input en 5x op output. Het routen van een classify-intent-taak naar Opus in plaats van Haiku is geen marginale optimalisatie — het is het betalen van 5x het tarief voor functionaliteit die u niet gebruikt.
Er is een derde feit, dat gemakkelijker over het hoofd wordt gezien: dezelfde prompt levert niet hetzelfde aantal tokens op over verschillende modelversies. Anthropic's Opus 4.7 wordt geleverd met een nieuwe tokenizer die tot 35% meer tokens kan genereren dan Opus 4.6 voor dezelfde inputtekst — het meest uitgesproken bij code, gestructureerde data en niet-Engelse tekst. De tarieven per token blijven ongewijzigd, maar de effectieve kosten per verzoek kunnen bij een stille migratie met wel 35% stijgen. Prijzen stabiel, facturen niet.
Als uw enige kostenregistratie het overzicht is op de leveranciersfactuur die aan het einde van de maand binnenkomt, kan een tokenizer-wijziging in stilte dubbele cijfers in procenten aan uw rekening toevoegen voordat u de kans krijgt om te reageren. Dit is precies wat governance bij de gateway dient te voorkomen.
In enterprise AI-implementaties zien we steeds dezelfde vier patronen van tokenverspilling terugkeren. Elk patroon is een workflow-ontwerpkeuze die op schaal cumuleert, en elk patroon ziet er op zichzelf economisch uit — wat precies de reden is waarom ze overleven.
De kostenelement met de hoogste hefboomwerking in elk AI-systeem is ook het meest onzichtbare: welk model verwerkt welke taak. De meeste organisaties routen standaard naar het meest geavanceerde model dat hun inkoopafdeling toestaat, omdat niemand wordt ontslagen voor het kiezen van Opus boven Haiku, maar genoeg mensen hun baan verliezen door een regressie uit te rollen. De som:
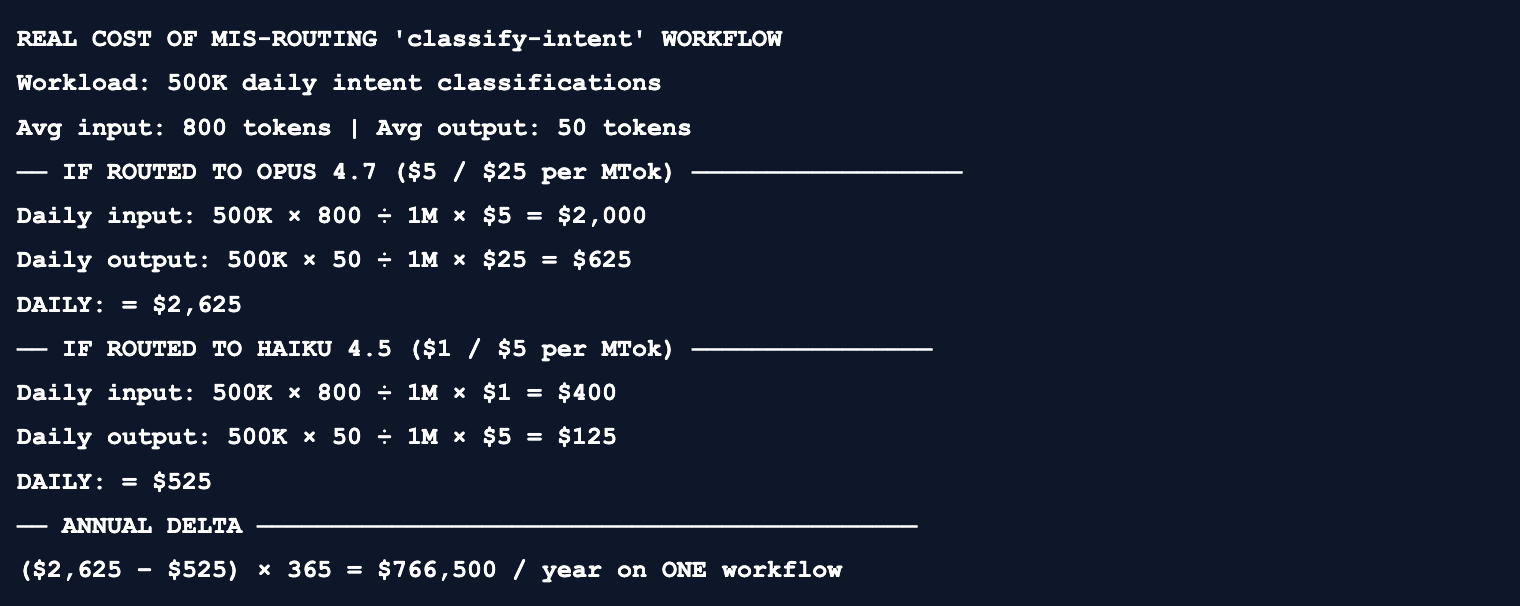
$766.500 per jaar aan pure routing-verspilling op één enkele workflow. Het verschil in classificatienauwkeurigheid tussen Haiku en Opus op een domeinspecifieke intent-taak is na een kleine fine-tuning of few-shot prompt doorgaans minder dan 2 procentpunt. De capability-premium is reëel voor moeilijke taken; voor routineuze taken is deze decoratief.
De tweede failure mode is het gebruiken van het context window als zoekindex. Een engineer die een code-review agent bouwt, dumpt de gehele repository (500K tokens) in de prompt 'voor de zekerheid'. Een supportbot stuurt bij elke beurt 50K tokens aan historische tickets mee 'voor context'. Dit werkt — het model geeft een aannemelijk antwoord — en de factuur schaalt mee met de omvang van de dump, niet met wat daadwerkelijk relevant was.
Het architecturale alternatief is actief toolgebruik via het Model Context Protocol (MCP). In plaats van alle mogelijke context vooraf toe te voegen, roept het model retrieval-tools aan die alleen de relevante fragmenten retourneren. TrueFoundry meldt dat dit tot 99% besparing op inferentie-tokens oplevert ten opzichte van context stuffing, waarbij de overhead van tool-calls wordt gemeten op ongeveer 10 ms.

De duurste nieuwe failure mode in agentic systemen is ook de meest onzichtbare: de loop. Er wordt nooit voldaan aan de exit-voorwaarde van een agent, of de tool blijft fouten retourneren, waardoor de agent oneindig blijft proberen. Eén enkele herhalende agent kan het dagbudget van een heel team in minder dan een uur verbruiken:

Dit is de failure mode die geen enkele engineer ooit heeft veroorzaakt. Anthropic's Opus 4.7 wordt geleverd met een nieuwe tokenizer die dezelfde input afbeeldt op 1,0x tot 1,35x meer tokens dan 4.6, met de bovengrens bij code en gestructureerde data. Dezelfde prompt. Dezelfde taak. Hetzelfde basistarief. Tot 35% hogere factuur.
Zonder telemetrie van het aantal tokens per verzoek, opgesplitst per modelversie, is dit verschil onzichtbaar totdat het als een post op de volgende factuur verschijnt. Zonder een handhavingslaag die rate-limits kan toepassen of kan terugvallen wanneer anomalieën in het aantal tokens per verzoek een drempel overschrijden, is er geen automatische reactie. De oplossing is niet 'voorzichtiger migreren'. De oplossing is om de gateway de 'source of truth' te maken voor wat elk verzoek daadwerkelijk heeft verbruikt, in real time.
Elke failure mode hierboven komt overeen met een specifieke gateway-primitive. Het doel van de onderstaande tabel is niet om te beweren dat de gateway magisch is; het is om de controls concreet genoeg te maken, zodat u de ontbrekende control kunt benoemen wanneer u het symptoom ziet.
Als de bovenstaande controls daadwerkelijk moeten worden geactiveerd, moeten ze worden uitgevoerd in het request path, en niet in een stroomafwaarts analytics warehouse. De end-to-end structuur van een beheerd verzoek via de TrueFoundry AI Gateway:

Drie eigenschappen van deze levenscyclus zijn van belang voor de bovenstaande failure modes. De gateway bevindt zich in het request path, zodat de policies daadwerkelijk worden geactiveerd — een circuit breaker die pas een uur later logs kan inzien, kan een ontspoorde loop niet stoppen. De overhead is minder dan 5 milliseconden, wat betekent dat de gateway productieverkeer kan verwerken zonder het bezwaar 'ik voeg liever geen extra hop toe'. En elke checkpoint zendt OpenTelemetry uit, zodat dezelfde trace die bewijst dat een verzoek is beheerd, ook de analytics voedt waarmee governance kan worden afgestemd.
→ Overzicht TrueFoundry AI Gateway
Elk verzoek dat een model bereikt, moet voldoende metadata bevatten om toegewezen, beheerd en geauditeerd te kunnen worden. Zonder dit is elke andere primitive aan het gissen. TrueFoundry dwingt dit af via X-TFY-METADATA-velden; een verzoek zonder metadata is een configuratiefout, geen verzoek.
Let op de modelnaam: intent-fast. Dat is een virtueel model dat in de gateway is gedefinieerd, geen fysiek eindpunt. De gateway zet dit om naar een concrete provider-call (haiku-4-5, sonnet-4-6, een zelfgehoste Llama, of wat het routingbeleid ook voorschrijft). Applicatiecode noemt nooit een provider. Het herrouten van de ene naar de andere provider is een YAML-diff, geen codewijziging.
→ Virtuele Modellen en Routing
Rate limits maximeren de consumptiesnelheid. Budgetten maximeren het totaal. Beide zijn noodzakelijk; geen van beide is op zichzelf voldoende. Een enkele agent met een rate limit kan over een lang weekend nog steeds $ 40.000 verbruiken als het tarief $ 12/uur is en niets anders het lopende totaal bewaakt. Een enkel budget zonder rate limits bereikt eenmalig het plafond en vervolgens wordt er niets meer geactiveerd tot volgende maand.
Het gedrag bij on_breach is de onbezongen held. Een 429-foutmelding is prima voor batch-workloads; voor een klantgerichte applicatie is fallback_to_haiku wat de zaak draaiende houdt terwijl de uitgaven toch binnen de perken blijven. Dezelfde primitive geeft uiting aan beide.
→ Rate Limiting — windows, scopes, breach-gedrag
→ Budget Limiting — plafonds, waarschuwingen en geleidelijke achteruitgang
De kostenelement met de hoogste hefboomwerking in elk AI-systeem is het kiezen van het juiste model voor de juiste taak. De juiste plek voor die beslissing is de configuratie, niet de applicatiecode. Virtuele modellen bieden u een logische naam (intent-fast, code-review-strong, support-cheap) die op de gateway wordt omgezet naar een concrete provider-call op basis van gewicht, prioriteit, latency of fallback-regels.
Drie dingen die deze YAML u oplevert. Kostenoptimalisatie: 90% van het intent-fast-verkeer stroomt naar Haiku tegen $ 1/$ 5 per MTok in plaats van welke standaardwaarde een ontwikkelaar ook hardcoded heeft ingevoerd. Veerkracht: wanneer Anthropic een storing heeft, schakelt het verkeer automatisch over naar OpenAI of Vertex; gebruikers zien een vertraging van 200 ms, geen storing. Provider-portabiliteit: wanneer er een nieuw model uitkomt, wijzigt u één regel en wordt deze uitgerold naar productie. De applicatiecode blijft ongewijzigd.
→ Overzicht Routing / Load Balancing
→ Lijst met providers (1000+ modellen ondersteund)
Een eenvoudig prototype van een gateway dat u in een middag schrijft, kan rate-limits en budgetten beheren. Een productie-gateway moet die dingen doen en tegelijkertijd voldoen aan een langere lijst met voorwaarden die van belang zijn wanneer AI zich in het kritieke pad van de omzet bevindt.
De meeste interne voorstellen om een gateway in te voeren, pitten het verkeerde punt. De zwakke pitch verkoopt een dashboard. De sterke pitch verkoopt de architectuur die een nuttig dashboard überhaupt mogelijk maakt.
Deel 1 heeft het diagnostische werk verricht: tokenmaxxing is de nieuwe lines-of-code metric, het heeft vier kenmerkende failure modes en elk daarvan komt overeen met een specifieke gateway-primitive. We hebben de drie dragende onderdelen geïntroduceerd: de identity envelope, circuit breakers en virtuele model-routing.
Deel 2 neemt die primitives en zoomt uit naar de architectuur: de vier envelopes (identiteit, policy, veiligheid, observability) die elk beheerd verzoek omhullen, en hoe ze samen een systeem vormen dat tegelijkertijd een beveiligingsgrens, een kostenbeheersingssysteem en een bron van operationele telemetrie is. Deel 3 vertaalt de architectuur vervolgens naar het operationele ritme — dashboards, scorecards, waarschuwingen en de rituelen die voorkomen dat beheerd AI-gebruik weer wegglijdt in tokenmaxxing op het moment dat uw aandacht verslapt.
De juiste metric is niet de hoeveelheid geconsumeerde tokens. Het is de uitkomst per dollar, met aantoonbare grenzen aan hoe die dollar is uitgegeven. Alles wat volgt, bouwt voort op het meetbaar, verdedigbaar en uitvoerbaar maken van die metric.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















