



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De inference engine bepaalt hoe efficiënt uw GPU tokens serveert. Hetzelfde model op dezelfde hardware kan heel verschillende throughput, latency en kosten opleveren, afhankelijk van de engine en de manier waarop batching en caching zijn afgesteld.
Er is geen universele winnaar. vLLM, SGLang en TensorRT-LLM worden allemaal actief ontwikkeld en komen samen op veel technieken, waaronder continuous batching, paged KV cache, prefix caching en quantisatie. De juiste keuze hangt af van uw model, GPU, sequentielengtes, batchgrootte en concurrency.
vLLM is gebouwd rond PagedAttention, dat de attention key-value cache beheert in niet-aaneengesloten pagina's op dezelfde manier waarop een besturingssysteem virtueel geheugen beheert. Dat vermindert geheugenfragmentatie en stelt de server in staat om meer gelijktijdige sequenties op een enkele GPU te plaatsen.
Het is een sterke, algemene keuze voor uitrol met een hoge throughput dankzij continuous batching, brede modeldekking en een eenvoudige OpenAI-compatibele server. Kies ervoor wanneer u een brede ondersteuning voor modellen en een solide throughput wilt zonder een compilatiestap. Voor een diepgaandere blik bekijkt u onze vLLM explainer.
SGLang is gebouwd rond RadixAttention, dat de KV cache hergebruikt voor requests die een prefix delen met behulp van een radix tree. Dat is voordelig voor workloads met veel gedeelde prompts, zoals few-shot prompts, lange gedeelde systeemprompts, agentic multi-turn gesprekken en tree of thought.
Het levert ook snelle, betrouwbare gestructureerde outputs, waaronder JSON, regex en grammar-constrained decoding, wat helpt bij complexe prompting- en tool calling-pipelines. Kies voor SGLang wanneer prefix-hergebruik en beperkte generatie uw verkeer domineren.
TensorRT-LLM is de bibliotheek van NVIDIA die modellen compileert tot geoptimaliseerde engines voor een specifiek GPU-doel, met gebruikmaking van gefuseerde kernels, geoptimaliseerde attention, quantisatie op ondersteunde hardware en in-flight batching via Triton.
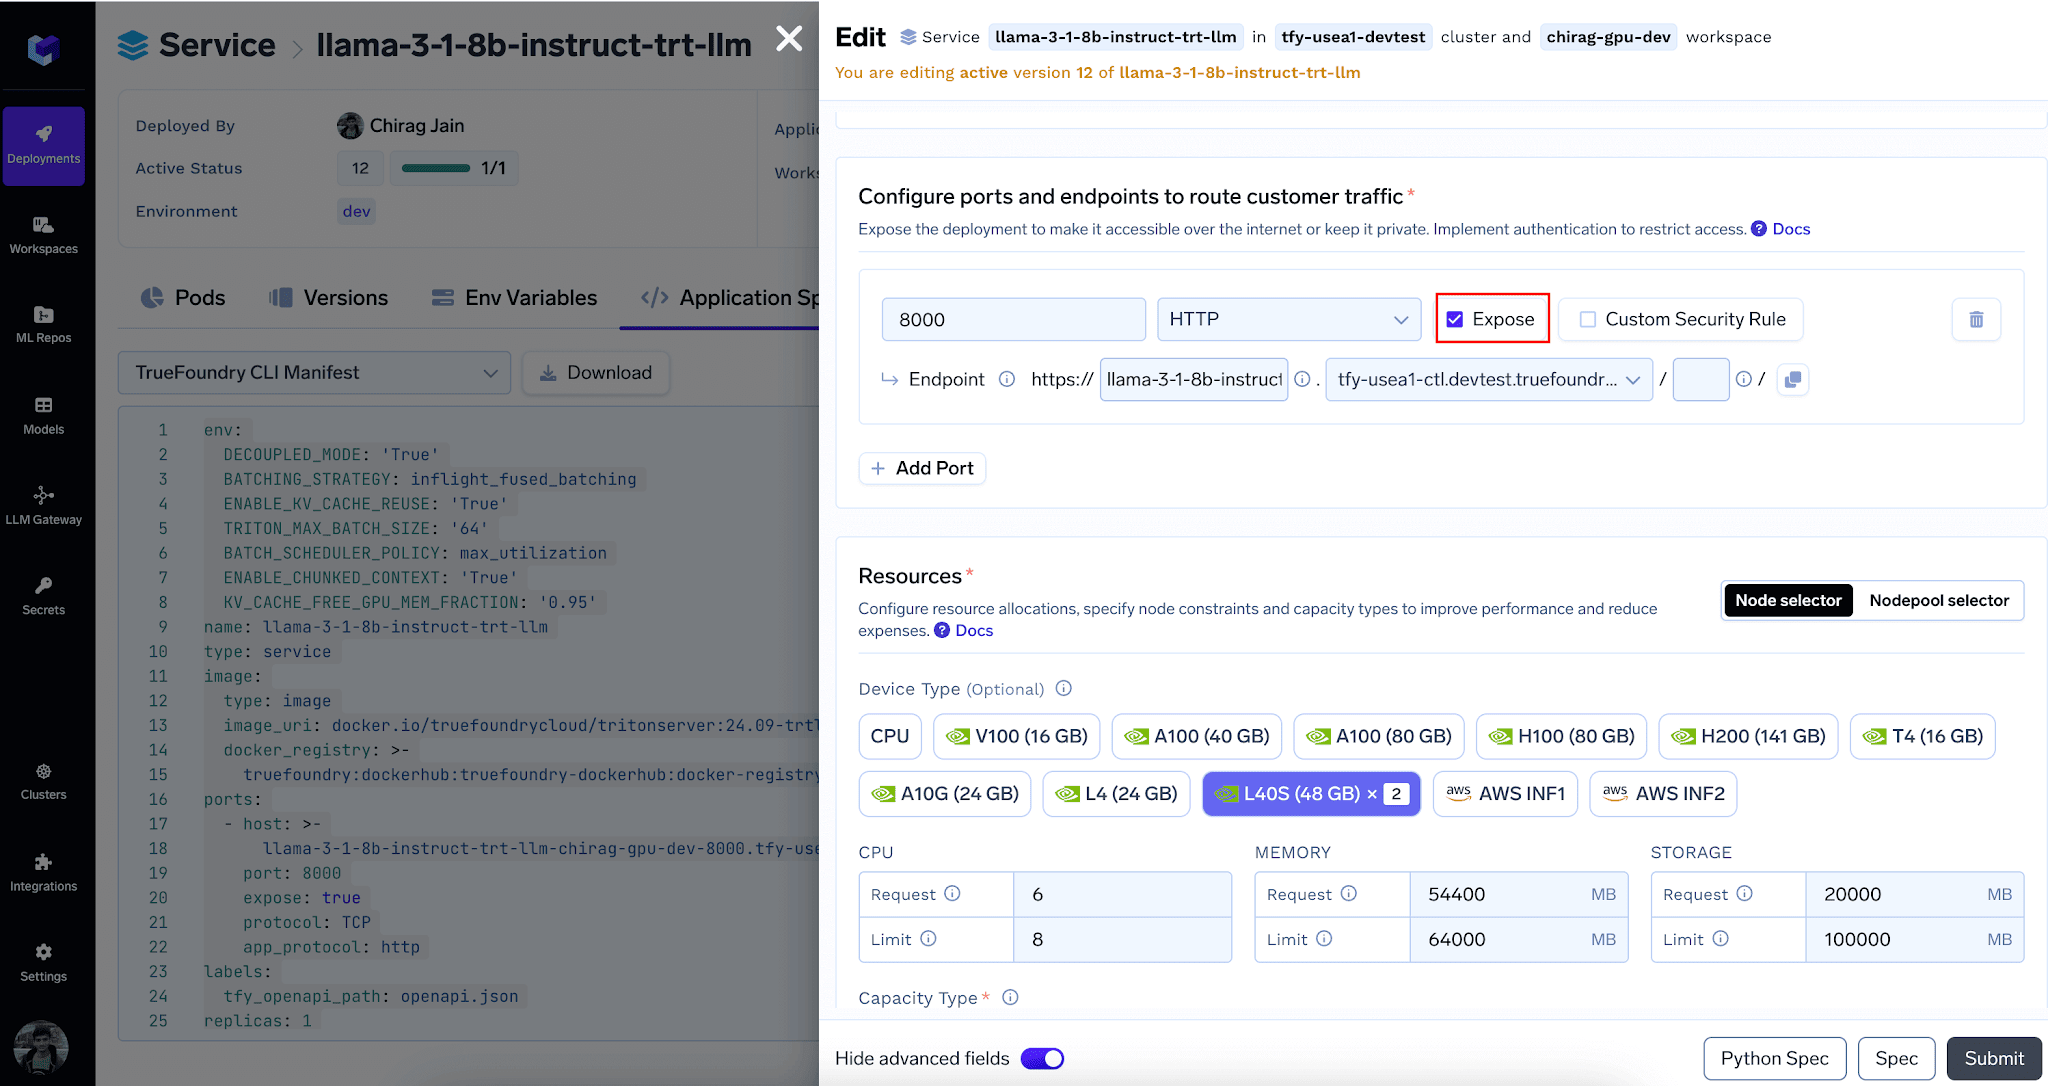
Het streeft doorgaans naar de laagste latency en de beste efficiëntie per GPU op NVIDIA GPU's, ten koste van een expliciete buildstap en engines die gekoppeld zijn aan het exacte GPU-type en het aantal waarvoor ze zijn gebouwd. Zoals de documentatie opmerkt: aangezien TRT-LLM het model optimaliseert voor het GPU-doeltype en de aantallen, is het belangrijk dat het GPU-type en het aantal overeenkomen tijdens de implementatie.
| Engine | Kernconcept | Het beste voor | Trade-off |
| --- | --- | --- | --- |
| vLLM | PagedAttention KV cache | Algemene hoge throughput, brede modelondersteuning | Geweldige standaard, niet altijd de laagste latency |
| SGLang | RadixAttention prefix-hergebruik | Gedeelde prompts, agentic, gestructureerde outputs | Grootste winst vereist prefix-hergebruik |
| TensorRT-LLM | Gecompileerde NVIDIA-engines | Laagste latency op NVIDIA GPU's | Buildstap, engine gekoppeld aan GPU |
Prestatiecijfers zijn afhankelijk van de specifieke workload. Voer een benchmark uit op uw eigen verkeer voordat u een definitieve keuze maakt. TrueFoundry ondersteunt ze alle drie, zodat de engine kan worden afgestemd op de workload.
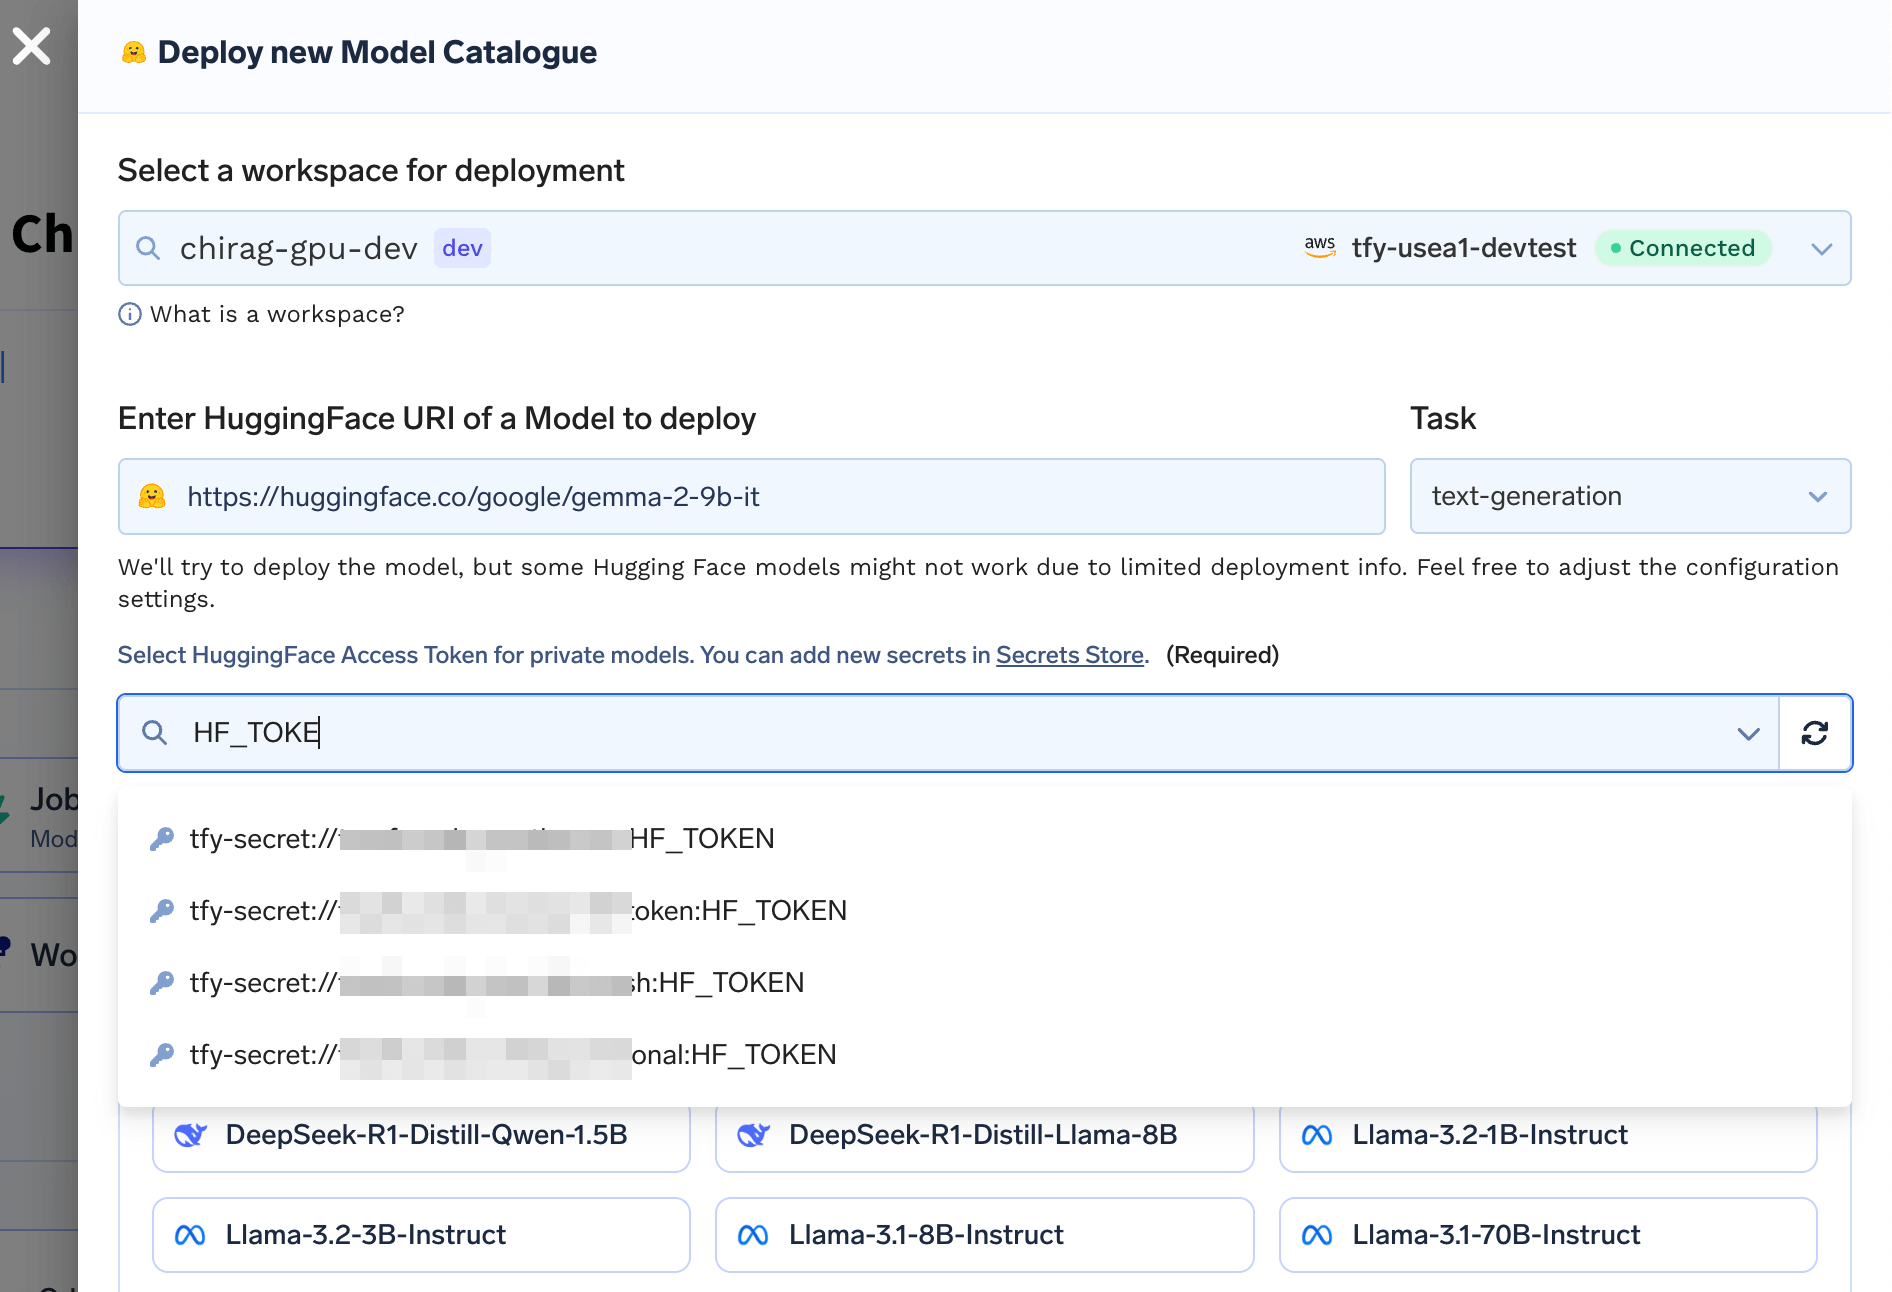
Voor vLLM en SGLang is de modelcatalogus de route. Zoals de documentatie vermeldt, vereenvoudigt TrueFoundry het proces van het implementeren van een LLM door automatisch de meest optimale manier van implementatie te bepalen en de juiste set GPU's te configureren.
U kunt een van de modellen in de LLM-catalogus kiezen of een Hugging Face model-URL plakken. TrueFoundry analyseert de modeltags en -bestanden om het deployment-framework te begrijpen en genereert de deployment-manifesten. U behoudt volledige flexibiliteit bij het kiezen van de meest optimale modelserver, wat zorgt voor snellere inference. Het platform maakt ook gebruik van image streaming en caching, wat zorgt voor 3X snellere downloadtijden voor vLLM- en SGLang-images.
TensorRT-LLM is geen simpele knop met één klik, omdat engines moeten worden gecompileerd voor de GPU waarop wordt gemikt. De specifieke handleiding maakt gebruik van een build-en-serve workflow.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



It depends on the model, GPU, and workload. TensorRT-LLM often reaches lower latency on NVIDIA GPUs because it compiles a model specific engine, while vLLM offers excellent throughput and broader model coverage with no build step. Benchmark both on your own traffic.
Choose SGLang when your prompts share long prefixes, such as shared system prompts or agentic multi turn flows, or when you need fast, reliable structured outputs like JSON or grammar constrained decoding. Its RadixAttention is designed for prefix reuse.
Yes. TrueFoundry supports vLLM, SGLang, and TRT-LLM as model servers. vLLM and SGLang are selectable in the catalogue flow, and TensorRT-LLM has a dedicated build and serve guide. Any OpenAI compatible endpoint can be added to the AI Gateway.
Because TensorRT-LLM compiles the engine for a specific GPU type and count, the serving deployment must use the same GPU type and count as the builder job. This is what lets it reach its latency and efficiency targets.



Het laatste nieuws, artikelen en bronnen in je inbox



















