



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De meeste ondernemingen bewaren hun informatie in één data warehouse, terwijl de betekenis ervan op meerdere plaatsen wordt gedefinieerd. Omzetlogica kan bestaan in een BI-dashboard, een financieel spreadsheet, een dbt-model en een Python-notebook. Elke kopie kan licht afwijken naarmate verschillende afdelingen hun eigen bedrijfslogica bijwerken.
Analisten leren in de loop van de tijd vaak welk getal ze moeten vertrouwen. Zakelijke gebruikers en AI-agents hebben behoefte aan meer consistentie. Een agent kan tijdens het uitvoeren van een query een definitie selecteren en deze met vertrouwen retourneren. Tegenstrijdige datadefinities veroorzaken daardoor een groter probleem wanneer geautomatiseerde systemen deze gebruiken.
Semantische laag architectuur herstelt deze afwijking dichter bij de bron. Een semantische laag bevindt zich tussen enterprise-systemen en hun consumenten. Het zet fysieke tabellen, kolommen en joins om in begrijpelijke zakelijke concepten. Omzet, verloop (churn), productmarge en de status van actieve klanten kunnen zo één consistente betekenis krijgen.
Dashboards, copiloten en agents kunnen die beheerde definities binnen de gehele organisatie delen. De omliggende AI-infrastructuur controleert nog steeds welke modellen toegang krijgen tot de context. Het regelt ook hoe verzoeken worden uitgevoerd en wat er wordt vastgelegd. Deze scheiding creëert een betrouwbaardere basis voor AI-gestuurde analytics.
De oplossing voor afwijkende metrieken begint met een heldere definitie. Wat is semantische laag architectuur in praktische termen? Het is een beheerde abstractielaag die technische datastructuren vertaalt naar herbruikbare zakelijke definities. Het houdt metrieken, dimensies, relaties, machtigingen en queryregels bij elkaar.
Verschillende consumenten kunnen zo hetzelfde antwoord op dezelfde vraag ontvangen. De laag creëert één bron van waarheid (single source of truth) voor belangrijke zakelijke begrippen. Een verzoek zoals "omzet per regio van vorige maand" maakt gebruik van goedgekeurde metriekdefinities in plaats van de berekening in elke toepassing opnieuw op te bouwen.
De architectuur combineert versiebeheerde definities met een engine die verzoeken afhandelt. Die engine vertaalt bekende vragen naar uitvoerbare queries op de onderliggende data. Het voegt zakelijke context toe boven opslag en transformatie, zonder een van beide lagen te vervangen. Het warehouse blijft informatie opslaan en de uiteindelijke query uitvoeren.
dbt gebruikt MetricFlow om metrieken te definiëren via semantische model-metadata en queries te genereren op basis van die definities. De huidige specificatie sluit semantische annotaties in naast bestaande dbt-modellen. Dit stelt downstream consumenten in staat om beheerde metrieken op te vragen zonder onafhankelijk joins opnieuw te hoeven bouwen.
Eén praktisch gevolg krijgt minder aandacht dan de technologie zelf. Elke belangrijke definitie heeft een toegewezen eigenaar nodig. Datateams wijzen routinematig eigenaarschap toe aan pipelines en tabellen. Definities zoals actieve klant of klantwaarde (customer lifetime value) kunnen zonder eigenaar blijven totdat twee rapporten tegenstrijdige resultaten laten zien.
De positie bepaalt wat de laag consistent kan afdwingen binnen de gehele stack. Een typische semantische laag data-architectuur scheidt opslag, transformatie, betekenis en consumptie. Dit creëert duidelijkere grenzen tussen ruwe data, gemodelleerde informatie, gedeelde definities en de tools die resultaten presenteren.
Deze scheiding houdt metriekregels buiten individuele dashboards en applicatiecode. Wanneer finance de omzetherkenning wijzigt, kan één beheerde definitie centraal worden aangepast. Elke consument ontvangt vervolgens de nieuwe berekening. Teams voorkomen zo dat ze tientallen rapporten, notebooks en applicatie-queries onafhankelijk moeten bijwerken.
De architectuur kan zich boven data warehouses of data lakes bevinden, afhankelijk van de bredere data-architectuur. Het geeft consumenten ook een consistent beeld van data over verschillende omgevingen heen. Een Power BI-rapport en een andere analytics-toepassing kunnen daardoor op dezelfde beheerde berekeningen vertrouwen.
Moderne warehouse-platformen bieden steeds vaker native functionaliteiten voor deze laag. Snowflake Semantic Views slaan metrieken, entiteiten, relaties en andere zakelijke betekenissen op als database-objecten. Ze kunnen ook analytics in natuurlijke taal ondersteunen via Cortex Agents.
Databricks biedt Unity Catalog metric views voor gecentraliseerd metriekbeheer. Metric views scheiden metingen (measures) van dimensies en genereren berekeningen op het moment van de query. Dit geeft verschillende teams consistente berekeningen terwijl de query flexibel blijft.
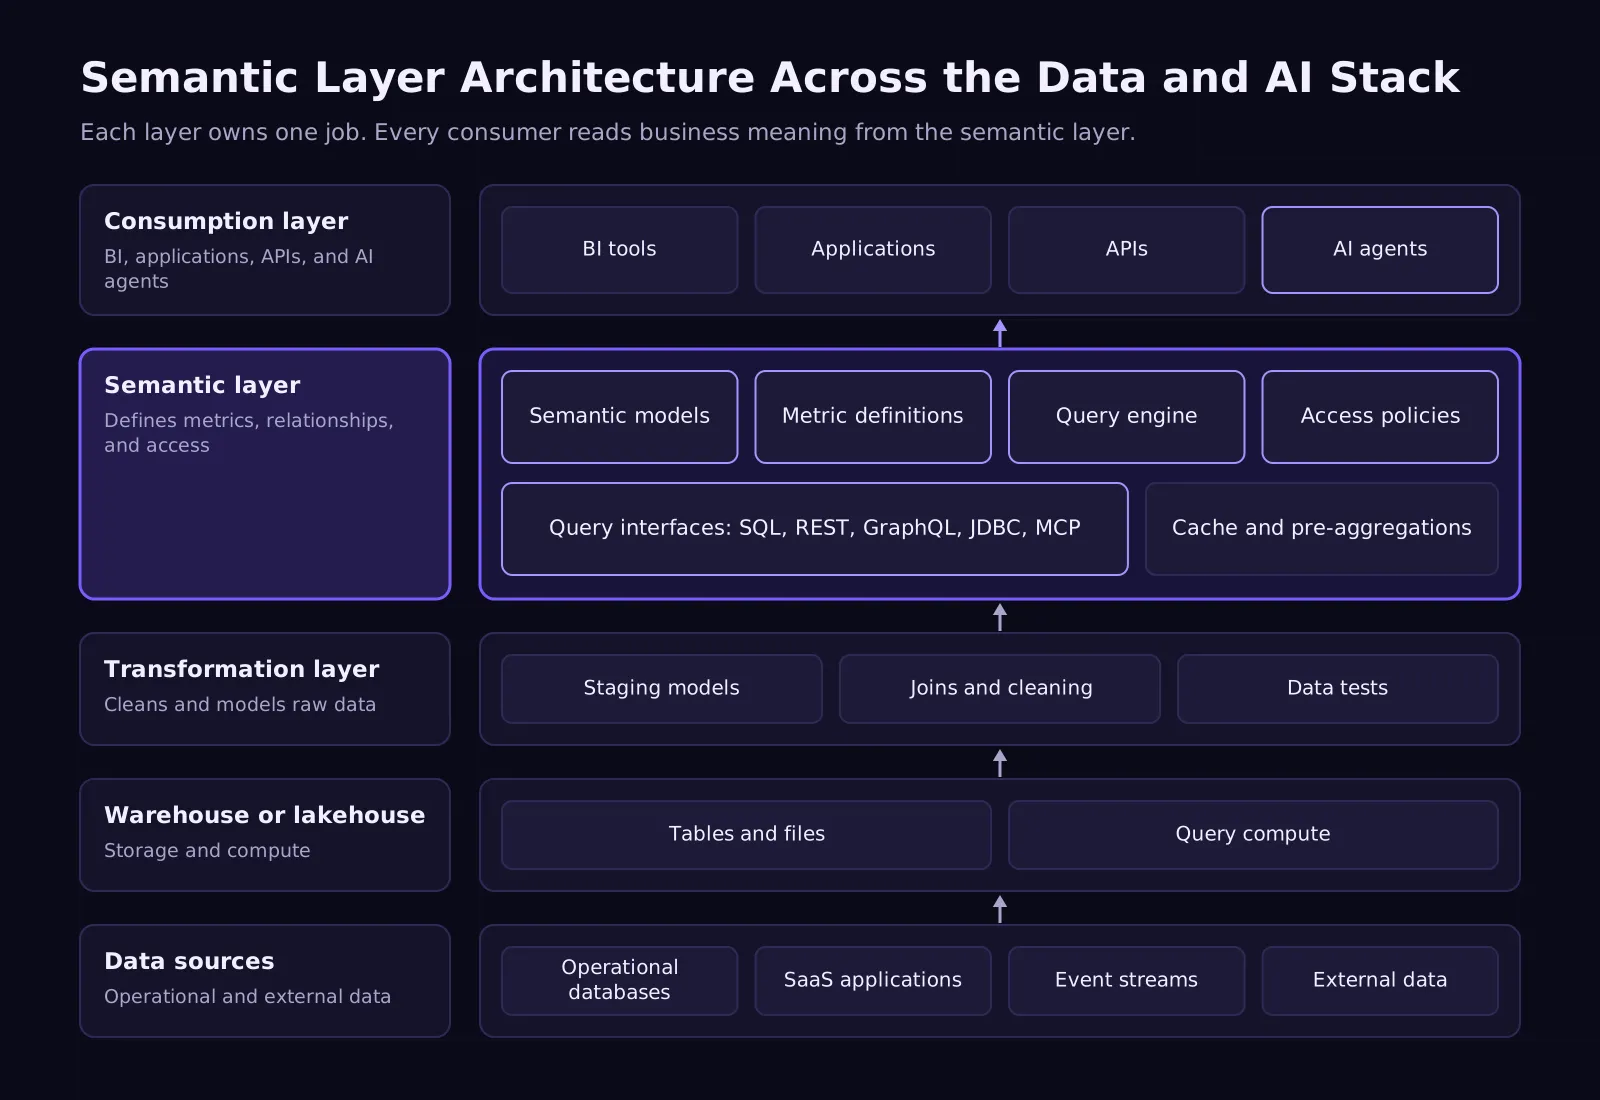
Weten waar de laag zich bevindt, leidt direct tot de kerncomponenten ervan. Een productie-implementatie heeft meer nodig dan alleen een begrippenlijst met goedgekeurde terminologie. Vijf functionaliteiten werken samen om technische opslag om te zetten in een beheerde analytische interface voor mensen, toepassingen en AI.
De query engine voert een groot deel van het werk uit. MetricFlow leest semantische modellen, ontrafelt entiteitsrelaties en genereert de vereiste SQL. De consument specificeert de gewenste metriek en dimensie. De engine bepaalt hoe de relevante modellen moeten worden verbonden.
Serving interfaces variëren per implementatie en per tool. Sommige producten bieden SQL-compatibele API's naast REST of GraphQL. Andere bieden MCP-interfaces waarmee agents goedgekeurde metrieken en dimensies kunnen ontdekken. Deze interfaces maken semantisch modelleren beschikbaar buiten traditionele analytics-toepassingen.
De meeste productie-implementaties voegen caching of pre-aggregatie toe naarmate het volume van verzoeken toeneemt. Herhaalde analytische verzoeken kunnen anders onnodig veel warehouse-bronnen verbruiken. Deze extra laag kan queryprestaties verbeteren terwijl de beheerde definitie ongewijzigd blijft.
De onderliggende functionaliteiten blijven vergelijkbaar, maar teams richten het eigenaarschap anders in. Het juiste patroon hangt af van de teamstructuur, platformen en consumenten. Het hangt er ook vanaf hoeveel onafhankelijkheid individuele domeinen nodig hebben bij het beheren van hun eigen datamodellen.
Een gecentraliseerd model is meestal het eenvoudigste vertrekpunt. Eén team en één repository produceren snel consistente definities. Het nadeel verschijnt naarmate de adoptie groeit. Een centraal team kan een knelpunt worden wanneer veel domeinen tegelijkertijd nieuwe metrieken aanvragen.
Domeineigenaarschap brengt die werklast dichter bij elke bedrijfstak. Sales, finance en product kunnen hun eigen definities beheren. Een platformteam kan eigenaar zijn van gedeelde conventies en entiteiten. Domeinoverschrijdende metingen, zoals netto-omzet, vereisen nog steeds expliciet eigenaarschap en testen.
Headless-ontwerpen werken goed wanneer organisaties verschillende analytics-platformen gebruiken. Definities bestaan buiten elk afzonderlijk visualisatieproduct. Dit voorkomt dat een platformmigratie vereist dat het bedrijf elke berekening opnieuw opbouwt. Het verplaatst de bedrijfslogicalaag ook dichter naar de gedeelde infrastructuur.
Een universele semantische laag wordt waardevol wanneer consistente definities behouden moeten blijven bij platformwijzigingen. Het AI-ready patroon voegt gedetailleerde beschrijvingen, synoniemen, introspectie en agent-vriendelijke interfaces toe. Het vereist niet het vervangen van gecentraliseerde of domeingerichte eigenaarschapsmodellen.
Apache Ossie trad in juni 2026 toe tot Apache incubation, nadat het ontstond als Open Semantic Interchange. Het definieert een leveranciersneutraal formaat voor metrieken, dimensies en relaties. Dit ondersteunt portabiliteit wanneer definities tussen platformen moeten worden verplaatst.
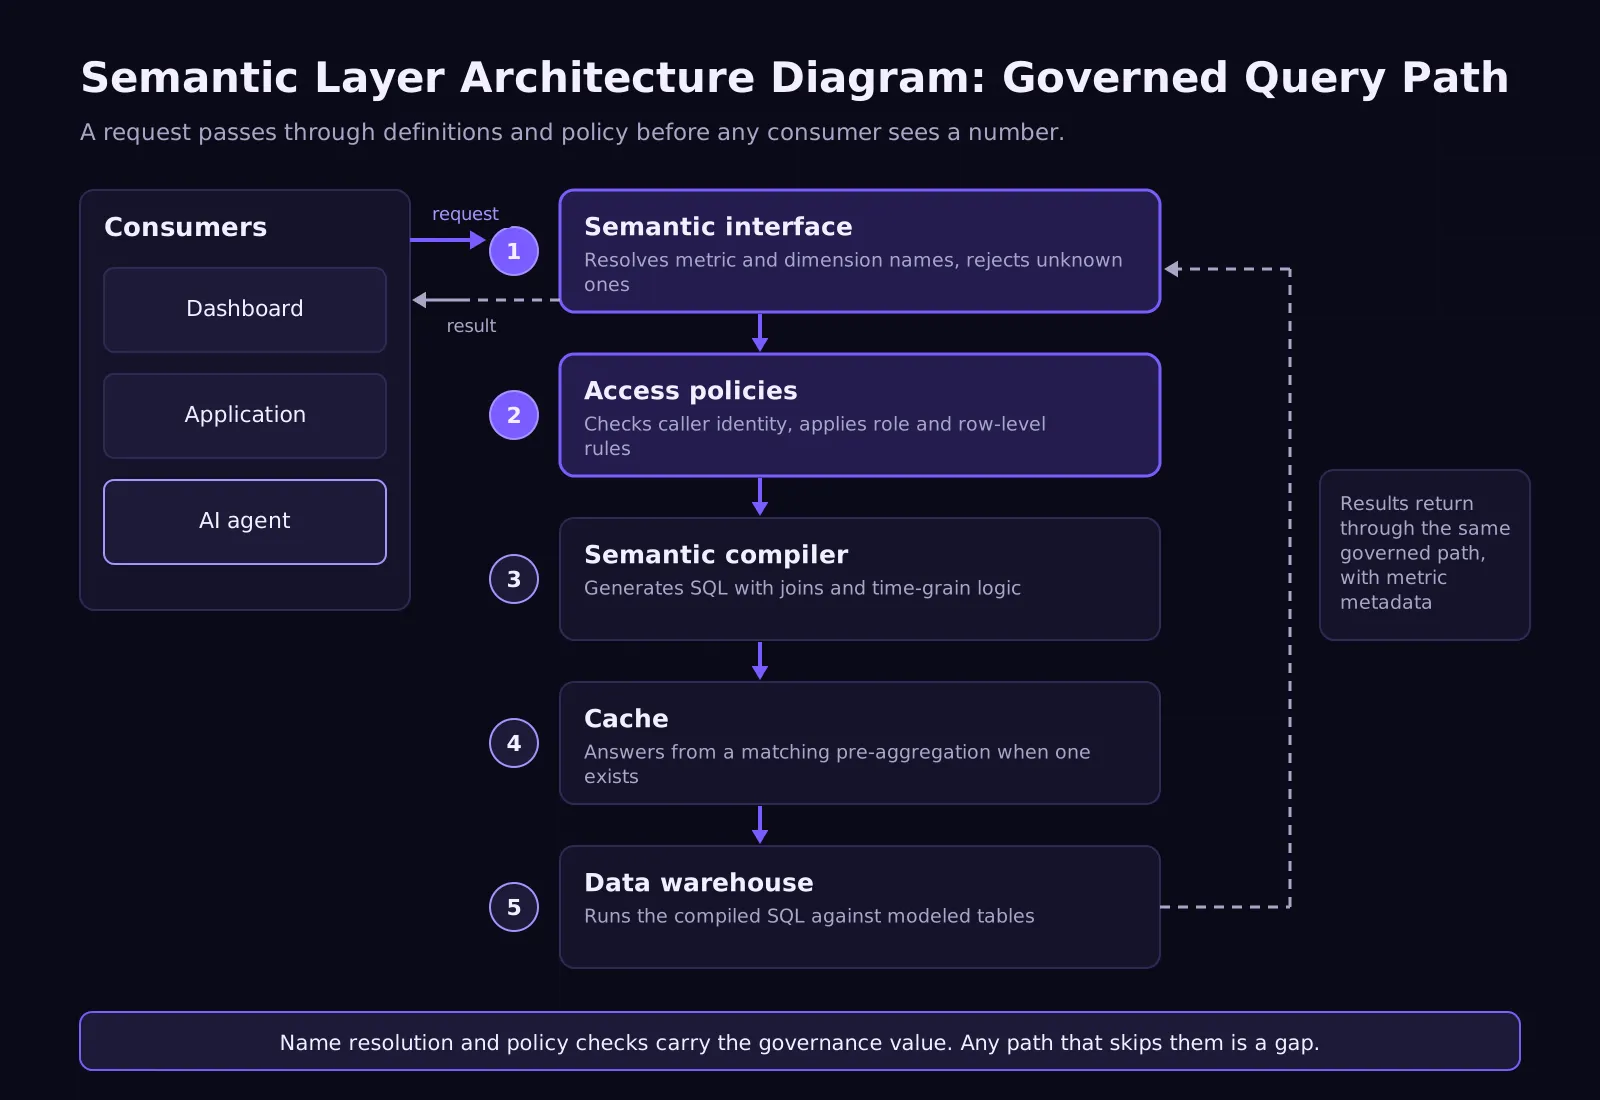
Een ontwerp wordt eenvoudiger te evalueren wanneer het verzoekpad (request path) zichtbaar is. Een goed architectuurdiagram van een semantische laag volgt één verzoek van een consument naar beheerde informatie. Het moet vervolgens tonen hoe resultaten via hetzelfde gecontroleerde pad terugkeren.
Het verzoek moet de volgende fasen volgen:
Deze volgorde maakt één principe in data governance bijzonder duidelijk. Zakelijke betekenis en toegangsregels worden toegepast voordat de consument het resultaat interpreteert. Het overslaan van die controles creëert een SQL-generatielaag in plaats van een volledige semantische governance-laag.
Het diagram kan ook architectuurbeoordelingen en data-exploratie ondersteunen. Elke consument met directe toegang tot het warehouse vormt een potentieel risico voor governance. Dit is vooral van belang wanneer agents uit gemak brede inloggegevens krijgen. Directe verbindingen kunnen goedgekeurde definities en machtigingen omzeilen.
Agents volgen hetzelfde verzoekpad, hoewel ze grotere druk uitoefenen op definities. Tabellen en kolomnamen bieden op zichzelf zelden voldoende betekenis. Een agent heeft context nodig over bedrijfsregels, relaties, eenheden en goedgekeurde berekeningen om analytische vragen betrouwbaar te beantwoorden.
Dit probleem wordt moeilijker bij complexe data en grote enterprise-schema's. Spider 2.0 evalueerde 632 echte enterprise text-to-SQL workflowproblemen. De op o1-preview gebaseerde code-agent opgelost 21,3% van de taken. Hetzelfde framework scoorde 91,2% op Spider 1.0 en 73,0% op BIRD.
Deze resultaten illustreren waarom directe toegang tot ruwe schema's een risico vormt voor AI-systemen. Enterprise-schema's bevatten veel kolommen, dialecten en projectspecifieke relaties. Een agent die alleen technische data ontvangt, kan aannemelijke SQL genereren zonder de onderliggende betekenis te begrijpen.
De zakelijke impact reikt verder dan query-nauwkeurigheid. Gartner stelde vast dat 63% van de organisaties niet beschikte over geschikte AI-datapraktijken of hierover twijfelde. Gartner voorspelde ook dat organisaties 60% van de AI-projecten die niet worden ondersteund door AI-ready data, tegen 2026 zouden staken.
Een beheerde laag biedt agents consistente metrieken, dimensies, entiteiten en relaties voordat ze iets bevragen. Het toont ook bekende zakelijke termen in plaats van een agent te dwingen betekenis af te leiden uit fysieke namen. Dit verbetert de toegang tot vertrouwde enterprise data.
dbt publiceerde in 2026 een benchmark waarin het bevragen van een semantische laag werd vergeleken met directe text-to-SQL. Voor vragen binnen het gemodelleerde bereik behaalden Sonnet 4.6 en GPT-5.3 Codex een nauwkeurigheid van 100% via de semantische laag. Hun directe text-to-SQL-resultaten waren respectievelijk 62,5% en 51,2%.
De benchmark gebruikte 11 vragen, die elk 20 keer werden herhaald. Vragen buiten het gemodelleerde bereik retourneerden foutmeldingen in plaats van niet-ondersteunde getallen. Dat onderscheid is van belang wanneer zakelijke metrieken worden gebruikt voor directierapportages, compliance-workflows of beslissingen in de financiële dienstverlening.
Agents kunnen goedgekeurde definities bereiken via API's of MCP-interfaces. De resulterende architectuur ondersteunt analytics in natuurlijke taal zonder dat elk model onbeperkte toegang tot de database krijgt. Een agent kan beschikbare metrieken ontdekken voordat hij een verzoek genereert of uitvoert.
Dit model vormt ook een aanvulling op RAG-architectuur in plaats van deze te vervangen. Semantische modellen beheren gestructureerde analytische berekeningen en retourneren exacte getallen. RAG haalt ongestructureerde kennis op, zoals beleidsregels, contracten en klantenservicetickets. Veel enterprise use-cases hebben beide functionaliteiten nodig.
Zodra agents afhankelijk zijn van de laag, worden de controles ervan productiecontroles. Governance, beveiliging en prestaties vereisen elk weloverwogen beslissingen vóór de uitrol. Die beslissingen moeten consistent blijven over data-omgevingen, toepassingen en consumenten heen.
Governance hoort thuis in het querypad dat door elke tool en agent wordt gebruikt. Teams moeten definities in Git bewaren en beoordeling door de eigenaar vereisen. Testen moet plaatsvinden voordat een gewijzigde definitie productie bereikt. Lineage, eigenaarschap en versiebeheer moeten consistent blijven, ongeacht de consument.
Beveiliging bepaalt welke gebruikers, toepassingen en agents afzonderlijke entiteiten en records kunnen bereiken. Controles op rij- en rolniveau worden belangrijk wanneer meerdere bedrijfsonderdelen dezelfde laag delen. Deze controles beschermen gevoelige informatie terwijl passende analytische toegang mogelijk blijft.
Identiteitsdoorgifte verdient speciale aandacht wanneer agents beheerde analytische diensten aanroepen. Gedeelde service-accounts kunnen bredere machtigingen erven dan een individuele gebruiker nodig heeft. Het doorgeven van de identiteit van de eindgebruiker helpt de goedgekeurde autorisatiegrens te behouden.
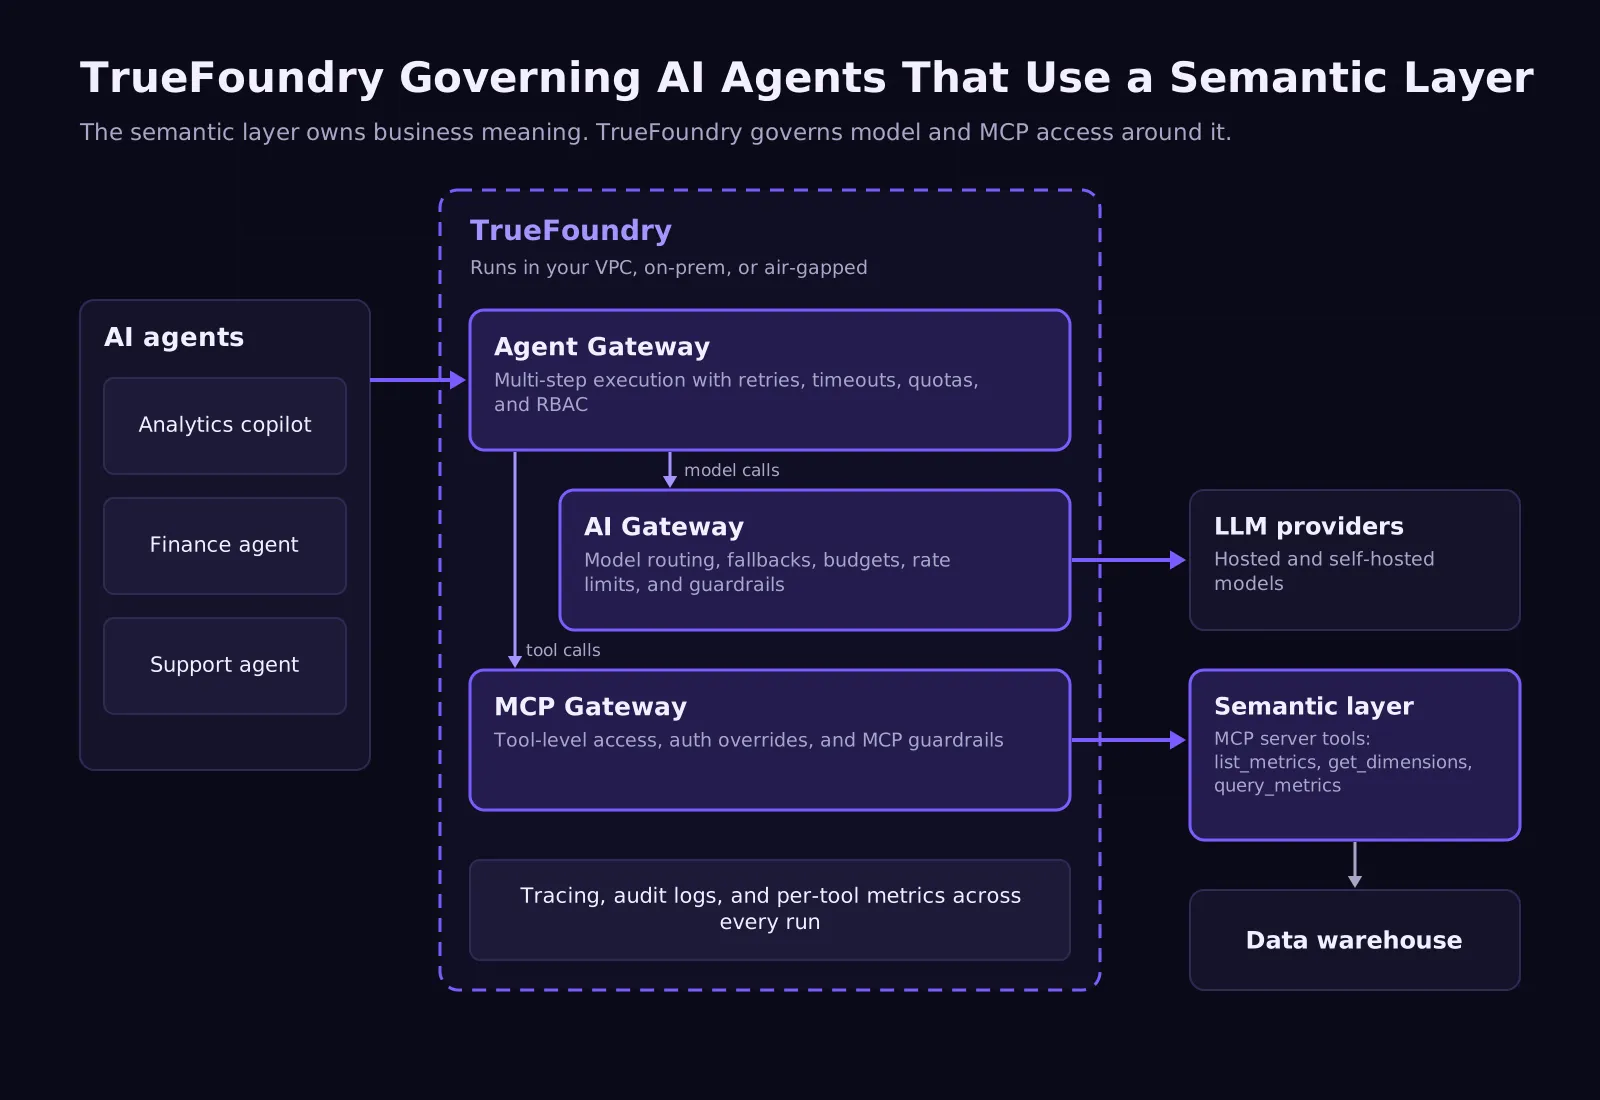
Een gateway kan die grens versterken wanneer tools worden ontsloten via MCP. TrueFoundry's MCP-toegangscontrole kan agent- en serveridentiteiten en specifieke tool-toegang evalueren. Onbevoegde tools kunnen verborgen blijven voor aanroepers in plaats van te vertrouwen op beperkingen op prompt-niveau.
Prestaties vereisen ook een doordacht ontwerp naarmate datavolumes en agent-activiteit toenemen. Één agent-taak kan meerdere gerelateerde verzoeken genereren tijdens het verkennen van dimensies. Pre-aggregatie, caching, query-optimalisatie en werklastlimieten kunnen herhaalde verwerking verminderen.
Snelheidsbeperkingen (rate controls) moeten ook op de runtimelaag bestaan. Een agent die in een lus raakt, moet zijn eigen quota uitputten voordat hij gedeelde analytics-bronnen overbelast. TrueFoundry's Agent Gateway ondersteunt quota, retries, timeouts, RBAC en gecontroleerde uitvoeringspaden.
Goede controles helpen alleen wanneer het onderliggende model begrijpelijk blijft. Teams moeten beginnen met een gerichte set waardevolle metingen. Het direct modelleren van elke dataset creëert definities die niemand heeft gevalideerd of duidelijk beheert.
Een afgebakende eerste scope stelt teams in staat eigenaarschap, gedrag en adoptie te controleren. Het ondersteunt ook best practices voor gecontroleerde uitbreiding. Een salesmanager kan beginnen met omzet, klantaantal en conversiemetrieken. Een ander team kan later metingen per productcategorie toevoegen.
Een praktische volgorde is als volgt:
De huidige dbt-specificatie voor v1.12 en later plaatst semantische annotaties binnen modeldefinities. Entiteiten en dimensies kunnen op kolomniveau worden gedeclareerd. MetricFlow gebruikt deze metadata vervolgens bij het bouwen van de semantische grafiek.
Het onderstaande voorbeeld gebruikt dbt's specificatie voor semantische lagen voor dbt v1.12 en later, die entiteiten en dimensies declareert op kolomniveau. Het modelleert twee bestaande dbt-modellen: fct_orders, met één rij per bestelling, en dim_customers, met één rij per klant.
Dit is wat elk onderdeel doet:
Let op de beschrijvingen. Een agent leest deze wanneer hij een metriek kiest, dus "Gross order value in USD, before refunds" levert echt werk op. Een beschrijving die alleen "order total" vermeldt, nodigt de agent uit om te gissen.
Vraag vervolgens de laag om SQL zonder deze uit te voeren. Op het dbt-platform ziet het commando er zo uit:
De vlag --compile drukt de gegenereerde SQL af en slaat de uitvoering over. Zelfgehoste MetricFlow gebruikt mf query met dezelfde argumenten en --explain in plaats van --compile. Controleer of de uitvoer fct_orders samenvoegt met dim_customers op customer_id, ordered_at afkapt naar de maand en filtert op status voordat er wordt geaggregeerd.
Zet die controle vervolgens om in een test. Kies vijf vragen die het bedrijf al beantwoordt in een vertrouwd rapport, voer ze elk uit via de laag en vergelijk de getallen. Voer dezelfde vijf uit via uw BI-tool en uw agent. Alle drie de paden moeten tot op de cent nauwkeurig overeenkomen voordat iemand anders toegang krijgt.
Naarmate de adoptie groeit, kunnen teams via hetzelfde proces nieuwe domeinen toevoegen. Testen, eigenaarschap, lineage en monitoring voorkomen dat tegenstrijdige definities zich verspreiden. Deze gedisciplineerde aanpak houdt het dataplatform begrijpelijk naarmate het analytische bereik uitbreidt.
Een werkend semantisch model beantwoordt de vraag over analytische betekenis. De runtime-vraag blijft afzonderlijk. Ondernemingen moeten nog steeds beslissen welke agents die informatie mogen gebruiken. Ze hebben ook beleidsregels nodig voor modellen, tools, limieten, inloggegevens en uitvoering.
TrueFoundry verzorgt die runtime zonder de semantische laag te vervangen. De semantische laag behoudt het eigenaarschap van definities, metrieken, relaties en beheerde analytische toegang. TrueFoundry beheert hoe AI-workloads die functionaliteiten bereiken en gebruiken.
De MCP Gateway is het meest directe integratiepunt voor analytische diensten met MCP-functionaliteit. Teams kunnen beheren welke servers en tools agents bereiken. OAuth, gefedereerde identiteit, RBAC en tracing op verzoekniveau ondersteunen gecontroleerd toolgebruik.
Een analytics-agent kan goedgekeurde query- en discovery-tools ontvangen zonder bredere servermachtigingen. Identiteitsbewust beleid kan beperkingen rond de persoon die de agent gebruikt behouden. Dit houdt toegangsbeslissingen buiten individuele prompts.
De AI Gateway beheert modeltoegang, budgetten, routing, guardrails en traceerbaarheid (observability). Dit is van belang wanneer semantische resultaten worden gedeeld over meerdere modellen of providers. Centraal beleid houdt model-governance gescheiden van analytische bedrijfsregels.
Een modelbewuste LLM Gateway kan routing, fallback en provider-abstractie beheren. Dit is nuttig wanneer meerdere modellen dezelfde semantische resultaten gebruiken. Applicatieteams hoeven zo niet in elke analytics-ervaring opnieuw provider-integraties op te bouwen.
Autonome workflows voegen nog een laag toe, omdat agents meerdere analytische en operationele tools kunnen aanroepen. AI agent observability verbindt sessies, model-aanroepen en tool-aanroepen tot een traceerbaar traject. Dit helpt teams te begrijpen welke context een specifiek resultaat heeft opgeleverd.
De verdeling van verantwoordelijkheden blijft daardoor helder. De semantische laag architectuur zorgt ervoor dat analytische betekenis consistent is over alle consumenten heen. TrueFoundry beheert hoe modellen, tools en agents toegang krijgen tot die context en hierop reageren.
TrueFoundry ondersteunt ook VPC-, on-premises, hybride en air-gapped uitrolpatronen. Deze opties helpen ondernemingen inloggegevens en AI-verkeer onder governance te houden binnen goedgekeurde grenzen.
Als je de MCP-tools van je semantische laag wilt zien draaien achter toegangsregels per team en met volledige tracing, boek dan een demo met het TrueFoundry-team.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















