



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Configuration Management is een belangrijk aspect van software engineering. Dit artikel belicht het waarom en wat van het probleem en redeneert over de verschillende oplossingen die er bestaan.

De aanpak voor het beheren van configuratie verandert naarmate de app schaalt — zowel qua verkeer als qua omvang van het ontwikkelaarsteam. Om de reis te illustreren, beginnen we met een eenvoudige app.
Dit is een eenvoudige server-app die verbinding maakt met MongoDB en de lijst met gebruikers retourneert. De code is slechts pseudocode en is niet bedoeld om aan een specifieke taal te voldoen.

Hardcoderen van configuratie in de app: een GROTE NEE!

Het hardcoderen van de MongoDB-uri in de app maakt het erg moeilijk om de applicatie in een andere omgeving uit te voeren — zoals op laptops van teamgenoten of voor productie. We moeten hier de 12 factor app methodology volgen om configuratie van code te scheiden.
“ SCHEID CONFIGURATIE VAN CODE ”
Nu is de vraag: waaruit bestaat de configuratie van een app? Citerend van https://12factor.net/config
De configuratie van een app is alles wat waarschijnlijk varieert tussen deploys (staging, productie, ontwikkelomgevingen, enz.). Dit omvat:
1. Resource-handles naar de database, Memcached en andere backing services
2. Credentials voor externe services zoals Amazon S3 of Twitter
3. Per-deploy-waarden zoals de canonieke hostnaam voor de deploy
De eenvoudigste en meest gebruikelijke manier om configuratie van code te scheiden, is door de variabelen in een .env-bestand te plaatsen.

Zodra we dit doen, moeten we de variabelen in de code laden vanuit het .env-bestand. Er zijn verschillende packages om dit te doen, zoals dotenv en dotenv-expand. Het .env-bestand wordt in dit geval niet naar Git gepusht en elke ontwikkelaar overschrijft de variabele volgens zijn eigen omgeving. Om alle ontwikkelaars een idee te geven van welke omgevingsvariabelen moeten worden toegevoegd, committen we meestal een bestand zoals .env.example naar Git.

We moeten ook waarden voor deze variabelen opgeven in de staging- en productie-omgevingen. Vrijwel alle deployment-systemen bieden een manier om omgevingsvariabelen op te slaan en te verstrekken, zoals ConfigMap en Secrets in Kubernetes, of S3 voor Elastic Container Service.
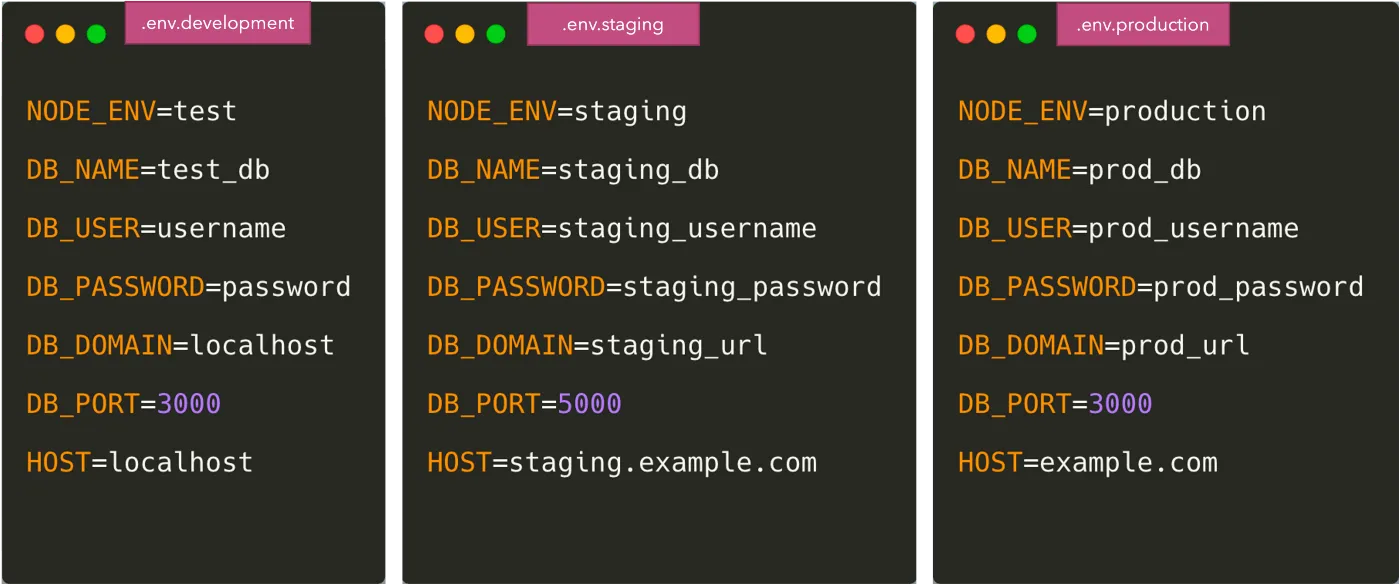
We moeten deze variabelen naar die omgevingen kopiëren en ze gesynchroniseerd houden wanneer ontwikkelaars omgevingsvariabelen toevoegen of verwijderen. Een mogelijke aanpak is om een afzonderlijk .env-bestand te hebben voor staging, productie, enzovoort.

Men zou kunnen voorstellen om deze bestanden in Git op te slaan, maar er is een groot beveiligingsprobleem in dat geval — vooral voor sommige gevoelige credentials in de env-bestanden.
Mensen gebruiken hier verschillende benaderingen — enkele bekende methoden zijn echter:

Hoewel we een van deze externe systemen gebruiken, hebben we de configuratie nu gesplitst tussen de .env-bestanden en de secretmanagers. Sommige van de niet-gevoelige parameters komen uit de .env-bestanden en sommige komen uit de externe opslag van credentials. We kunnen stellen dat we alle parameters in de externe opslag kunnen opslaan — maar dat kan soms overkill zijn. Dus waar we nu mee eindigen is:

Onze applicatie moet nu code bevatten om uit beide configuratiebronnen te lezen. Lezen uit de .env-bestanden kan worden gedaan met het dotenv-package, maar het ophalen van de omgevingsvariabelen uit de secretmanagers vereist dat we hun bijbehorende API's gebruiken om de waarden te verkrijgen.

Dit lost het probleem op van het veilig houden van onze configuratie en het volgen van de 12-factor-methodologie.
Het schrijven van applicatiecode om secrets op te halen wordt echter een repetitieve praktijk waarbij elke applicatie nu secretmanager-specifieke code moet toevoegen om de waarden uit de API te halen. Dit betekent ook dat als we ooit van secretsmanager-provider veranderen, de code in alle applicaties moet veranderen. Om dit probleem op te lossen, zijn er enkele benaderingen mogelijk:
Configuratiebeheer is complex en moet vanaf het begin goed worden aangepakt om ervoor te zorgen dat de ontwikkelsnelheid hoog blijft zonder in te boeten op beveiligingsaspecten. Kubernetes, dat tegenwoordig het meest wordt gebruikt om applicaties te deployen, wordt geleverd met een eigen configuratie- en secretbeheer, waar ik in een ander artikel dieper op in zal gaan. Als u een andere manier gebruikt voor configuratiebeheer, vermeld deze dan in de reacties — ik hoor er graag meer over en leer graag van u!
TrueFoundry is een AI-gateway op ondernemingsniveau die een LLM-, MCP- en agent-gateway omvat, waarmee ondernemingen vanuit één enkel controleplatform veilig toegang tot modellen, tools, guardrails en agents kunnen verbinden, observeren en beheren. De AI Gateway maakt agentic workloads mogelijk die:
a) Veilig zijn — een oplossing bieden voor sleutelbeheer, authenticatie en autorisatie
b) Efficiënt zijn — kosten, latency en multi-regio failovers optimaliseren
c) Toekomstbestendig zijn — uniforme en koppelbare verbindingen mogelijk maken over LLM's, MCP's en guardrails van elke provider
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























