



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Prompt engineering techniques helpen teams om betere instructies voor taalmodellen te schrijven, de outputkwaliteit te verbeteren en vermijdbare fouten te verminderen. OpenAI omschrijft prompt engineering als het schrijven van effectieve instructies zodat modellen content genereren die aan de vereisten voldoet. Anthropic merkt op dat prompt engineering het beste werkt wanneer de succescriteria stuurbaar zijn via prompting.
Voor enterprise teams is prompt engineering geen persoonlijke productiviteitsskill meer. Het heeft nu direct invloed op de modelkosten, latency, betrouwbaarheid, compliance en gebruikerservaring. Een prompt die drie zinnen aan redenering toevoegt, kan de tokenuitgaven verdubbelen bij een maandvolume van een miljoen requests. Een prompt die een agent onveilige toegang tot tools verleent, kan leiden tot een incident rond access control.
Deze gids legt de meest nuttige prompt engineering-methoden uit, wanneer je ze toepast en waar discipline op prompt-niveau moet aansluiten op AI gateway-governance. Ook wordt uitgelegd hoe TrueFoundry teams helpt bij het beheren van prompts, modellen, MCP-tools, budgetten en agents in productie.
Prompt engineering is de praktijk van het ontwerpen van LLM-prompts om betrouwbare, nauwkeurige en correct geformatteerde AI-outputs te genereren. Het is de primaire interface tussen menselijke intentie en het gedrag van het AI-model. De kwaliteit van die interface heeft directe invloed op de betrouwbaarheid van toepassingen, kosten, veiligheid en bruikbaarheid bij uiteenlopende taken.
Het vakgebied is geëvolueerd van het schrijven van beknopte instructies voor een eenvoudige vraag naar het bouwen van prompt-architecturen voor agentic workflows. Een moderne prompt kan inputvariabelen, regels voor gestructureerde output, aanvullende context, modelinstellingen, guardrails en policy-vereisten voor productiegebruik bevatten.
De praktische implicatie is helder. Teams die prompts behandelen als wegwerptekst, leveren vaak AI-toepassingen van lagere kwaliteit op. Teams die systematische prompt engineering techniques toepassen met versiebeheer, evaluatie en governance, beschikken over een sterkere route naar nauwkeurige antwoorden en betere resultaten.
Het Prompt Management van TrueFoundry weerspiegelt die verschuiving. Een opgeslagen prompt bewaart het system message, user message, inputvariabelen, guardrails en de configuratie voor gestructureerde output in één geversioneerd object. Toepassingen kunnen ernaar verwijzen via een fully qualified name in plaats van de prompttekst hardcoded in te bedden.
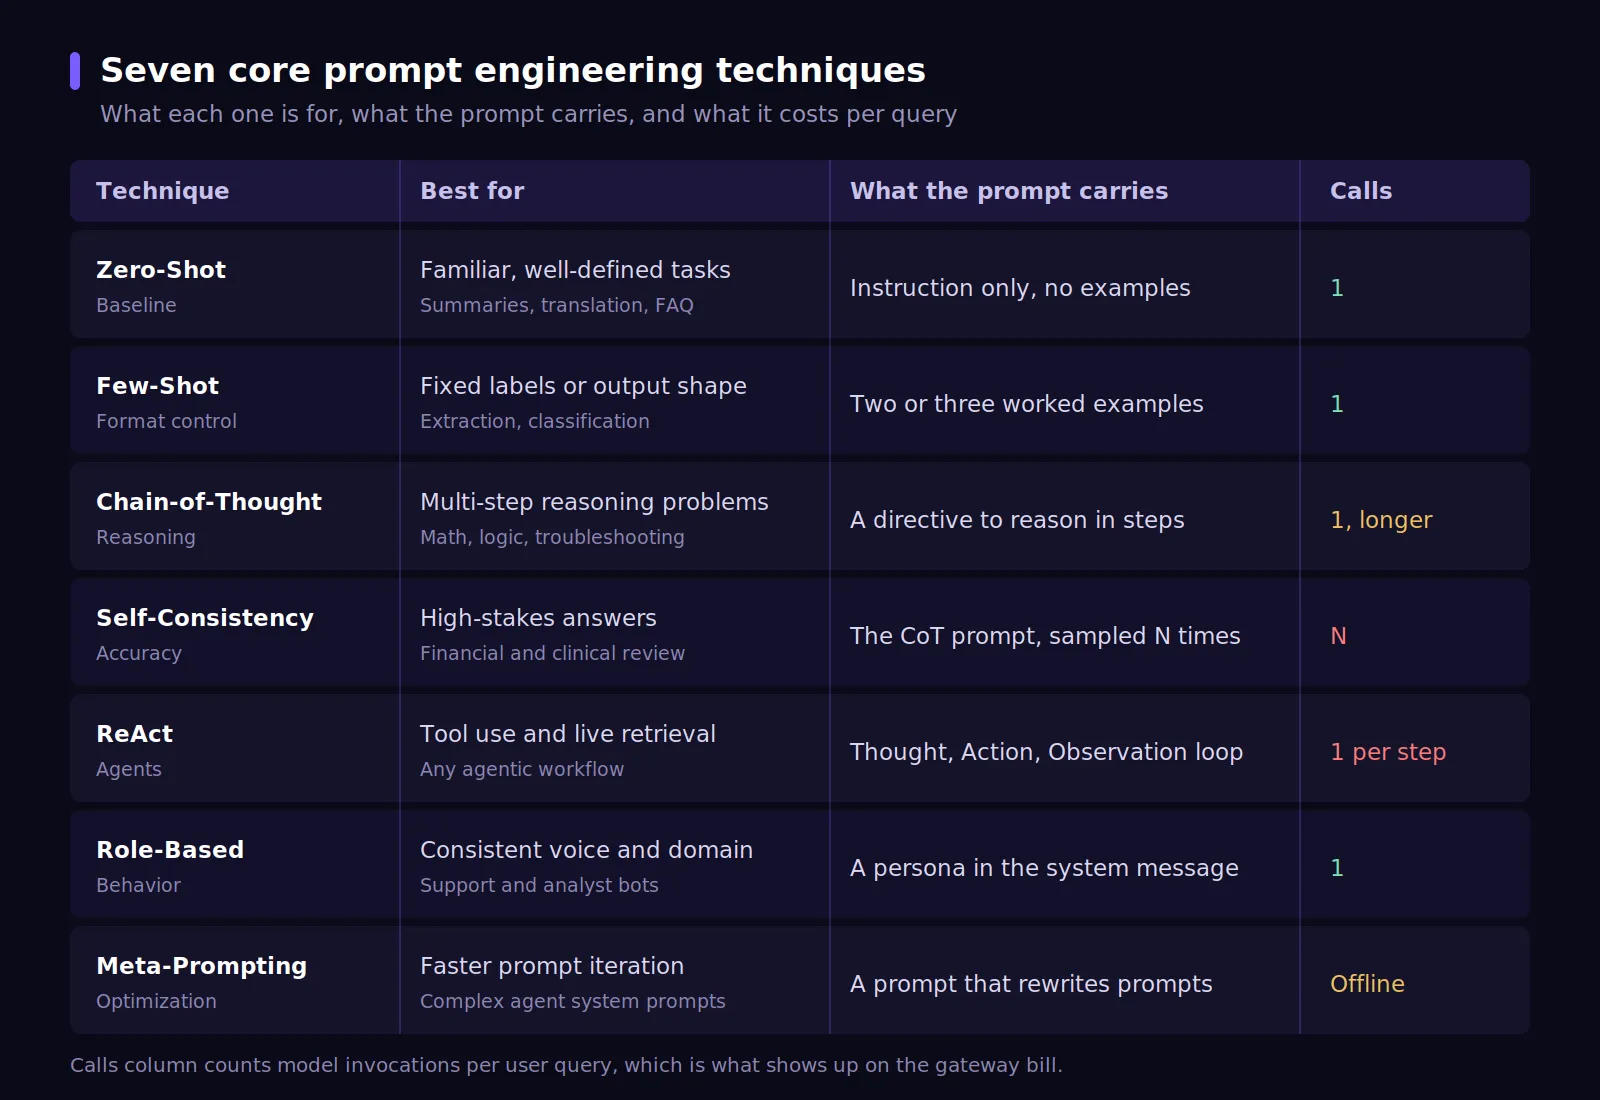
Zeven centrale prompt engineering techniques dekken het meeste productiewerk af. Bekijk ze als een opbouwende reeks. Elk van deze technieken levert winst op in nauwkeurigheid, structuur of controle. Tegelijkertijd brengt elke techniek kosten met zich mee in de vorm van tokens, latency, onderhoudsinspanning of governance-complexiteit.
Bij zero-shot prompting wordt het large language model gevraagd om een specifieke taak uit te voeren zonder voorbeelden te geven. Het model vertrouwt op de trainingsdata en het gezond verstand om het juiste outputformaat, de inhoud en de toon uitsluitend uit de instructie af te leiden.
Het beste voor: Goed gedefinieerde taken waarvan het model het patroon al begrijpt. Voorbeelden zijn samenvatten, vertalen, eenvoudige classificatie, het beantwoorden van FAQ's en het verifiëren van feiten uit korte inputs.
Beperking: De betrouwbaarheid van zero-shot neemt af wanneer de gewenste taak strikte opmaak of domeinspecifiek gedrag vereist. Dit falen gebeurt vaak ongemerkt. Een zero-shot classifier geeft eerder een aannemelijk label terug dan een foutmelding, waardoor het defect pas later zichtbaar wordt in gebrekkige analyses of een lagere tevredenheid bij de gebruiker.
Few-shot prompting geeft een of meer input-outputvoorbeelden voorafgaand aan het werkelijke verzoek. Deze gedetailleerde voorbeelden bieden het model een concreet patroon om te volgen, vooral wanneer de gewenste output een specifieke toon, een vast schema, een vooraf gedefinieerde set labels of een specifieke schrijfstructuur vereist.
Het beste voor: Taken waarbij de vorm van de output van belang is. Gebruik het voor classificatie met vaste labels, gestructureerde data-extractie, stijl-matching, domeinspecifieke toon en herhaalbare opmaakvereisten.
Hoeveel voorbeelden: Twee of drie voorbeelden presteren voor veel productietaken al erg goed. Meer voorbeelden kunnen de promptkwaliteit verhogen, al betaalt elk verzoek voor al die extra tokens. Teams moeten deze afweging analyseren voordat ze langere prompts inzetten op endpoints met een hoog volume.
Chain-of-thought prompting vraagt het model om tussenstappen te doorredeneren voordat het tot het definitieve antwoord komt. Dit kan de prestaties verbeteren bij een wiskundig probleem, een logische taak, een troubleshooting-workflow of een programmeerprobleem waarbij de tussenliggende redenering het resultaat beïnvloedt.
Het beste voor: Complexe redeneringen, beslissingsbomen, technische diagnoses, financiële analyses en ingewikkelde denktaken. Het werkt het beste wanneer de prompt vraagt om doelgerichte probleemoplossing in plaats van een kort antwoord.
Zero-shot CoT: Het toevoegen van een instructie om stap-voor-stap te redeneren kan chain-of-thought-gedrag activeren zonder dat je voorbeeld-redeneerketens hoeft aan te reiken. Dit blijft een laagdrempelige manier om de redenering bij complexe taken te verbeteren.
Combineren met few-shot: Few-shot voorbeelden die redeneerstappen bevatten, kunnen de prestaties voor domeinspecifieke workflows verhogen. Teams moeten het getoonde antwoord beknopt houden wanneer gebruikers alleen het uiteindelijke resultaat nodig hebben.
Een operationele waarschuwing is hier van belang. De output van een chain-of-thought is lang, en lange output is precies wat teams streamen om de ervaren latency laag te houden. De guardrails documentatie van TrueFoundry geeft aan dat output guardrails worden overgeslagen wanneer bij een verzoek `stream: true` ingesteld is, omdat er dan geen volledige respons is om te evalueren. Redeneringen die je streamt, worden door geen enkel output-beleid gecontroleerd.
Self-consistency breidt chain-of-thought prompting uit door meerdere onafhankelijke redeneerketens te genereren voor dezelfde vraag. Het systeem kiest vervolgens het meest consistente eindantwoord uit de gegenereerde samples.
Het beste voor: Redeneertaken met een hoog afbreukrisico waarbij de nauwkeurigheid van het antwoord zwaarder weegt dan de inference-kosten. Voorbeelden zijn risicobeoordelingen, juridische ondersteuning, financiële analyses, casestudies en veiligheidskritische aanbevelingen.
Kosten-afweging: Self-consistency vereist meerdere model calls per query. Vijf gesampelde ketens veranderen één factureerbaar verzoek in vijf verzoeken. Handhaving van het budget per team via een AI Gateway is essentieel wanneer teams deze methode op grote schaal toepassen.
ReAct prompting combineert redeneren (reasoning) en handelen (acting). Het model wisselt af tussen een Thought-stap, een Action-stap en een Observation-stap. Dit patroon stelt het model in staat om te redeneren, externe tools aan te roepen, het resultaat te lezen en door te gaan totdat de taak is voltooid.
Het beste voor: Agentic workflows die informatievergaring, tool-executie, realtime context of het uitvoeren van meerstappen-taken vereisen. ReAct is nuttig wanneer een AI-assistent moet communiceren met databases, API's, SaaS-tools of interne systemen.
ReAct veranderd de beveiligingsvraagstukken. De prompt vormt niet langer alleen de tekst. Het beïnvloedt ook de selectie van tools en de volgorde van acties. Wanneer tools interactie hebben met bedrijfssystemen, fungeert de MCP Gateway als de handhavingslaag voor permissies, validatie en audit logging.
Role-based prompting kent het model op het niveau van de system prompt een specifieke persona, een domeinexpertise of een gedragscontext toe. "Je bent een senior financieel analist die een klantportfolio beoordeelt" leidt tot andere redeneerpatronen en outputstijlen dan dezelfde vraag zonder roltoewijzing.
Het beste voor: Domeinspecifieke toepassingen, klantenservice-agents met een gedefinieerde persona, technische support-bots en elke toepassing waarbij een consistente toon en gedragscontext belangrijk zijn in alle interacties.
Enterprise-toepassing: Role-based system prompts vormen een primair mechanisme om gedragsguardrails op toepassingsniveau af te dwingen, voordat output-filtering op de infrastructuurlaag wordt toegepast.
Let op een grens die de meeste teams verrast. De guardrail-documentatie van TrueFoundry bevestigt dat system prompts standaard worden uitgesloten van guardrail-evaluatie, waardoor de roldefinitie zelf nooit wordt geïnspecteerd, geblokkeerd of gecensureerd. Persona-instructies sturen het gedrag aan, maar fungeren niet als een beleid dat de infrastructuur controleert.
Meta-prompting gebruikt de LLM om prompts te analyseren, te bekritiseren en te verbeteren, in plaats van rechtstreeks taken van eindgebruikers uit te voeren. Een prompt engineer kan dit gebruiken om opties te genereren, veelvoorkomende patronen te vergelijken en instructies sneller te verfijnen.
Het beste voor: Teams die frequent itereren op promptontwerp en de optimalisatie willen versnellen. Het is nuttig voor complexe activiteiten, strategische planning en agent system prompts met veel sleutelelementen.
Opmerking voor productie: Meta-prompting genereert concept-prompts die alsnog geëvalueerd moeten worden tegen een testset voordat ze naar productie worden overgezet. Het versnelt de stap van het genereren van opties, niet de validatiestap.
Een systematische workflow voor prompt-verbetering borgt dat onderscheid door concepten te beoordelen op basis van een vaste eval-set in plaats van de subjectieve indruk van een beoordelaar.
De onderstaande geavanceerde technieken vragen om meer rekenkracht of ontwerpinspanning, in ruil voor betere resultaten bij problemen waar eenvoudigere technieken tekortschieten. Gebruik ze wanneer een evaluatieset aantoont dat de eenvoudigere methode zijn grens heeft bereikt.
Tree-of-Thought breidt de lineaire chain-of-thought prompting uit naar een vertakte structuur. Het model verkent meerdere redeneerpaden, evalueert mogelijke oplossingen en kiest de meest veelbelovende tak om te vervolgen.
Het beste voor: Problemen waarbij het pad naar de oplossing niet meteen duidelijk is uit de eerste vraagstelling. Voorbeelden zijn onderzoeksynthese, creatief werk zoals een kort verhaal, strategieontwikkeling, ingewikkelde debugging en open-ended planning.
Tree-of-Thought kan de resultaten bij moeilijke redeneertaken verbeteren. Het schaalt de kosten echter ook op via de vertakkingsfactor en diepte. Dit maakt budgetlimieten belangrijk voordat de techniek wordt ingezet op endpoints voor klanten.
Constitutional prompting bedt een set principes in binnen de system prompt. Het model gebruikt die principes om de eigen respons zelf te evalueren en te herzien voordat het een antwoord teruggeeft.
Het beste voor: AI-toepassingen waarbij een consistente afstemming op organisatie-waarden, veiligheidsregels of compliance-normen cruciaal is. Het helpt het gedrag te sturen voordat de filtering na de generatie plaatsvindt.
Beschouw de constitution als kwaliteitscontrole, niet als auditcontrole. De principes bevinden zich in de system prompt. Bewijs van compliance moet komen van guardrails, traces, policy-uitkomsten en logs waar het model geen invloed op heeft.
Directional stimulus prompting voegt een korte hint, een trefwoord of een sturend signaal toe om het model richting de meest relevante informatie te leiden. Het helpt wanneer de basis-prompt weliswaar duidelijk is, maar het model een sterkere aanwijzing nodig heeft over wat het belangrijkst is.
Het beste voor: Classificatie-, samenvattings- en extractietaken waarbij een kleine sturende aanwijzing de focus verbetert. Een samenvatting over klimaatverandering kan bijvoorbeeld een stimulus zoals "impact op het beleid" gebruiken om de aandacht te sturen.
Dit is een geavanceerde techniek omdat kleine aanwijzingen het antwoord onverwacht kunnen doen verschuiven. Teams moeten de prestaties vergelijken met een nulmeting (baseline) en controleren of de stimulus de gewenste output verbetert zonder andere situaties negatief te beïnvloeden.
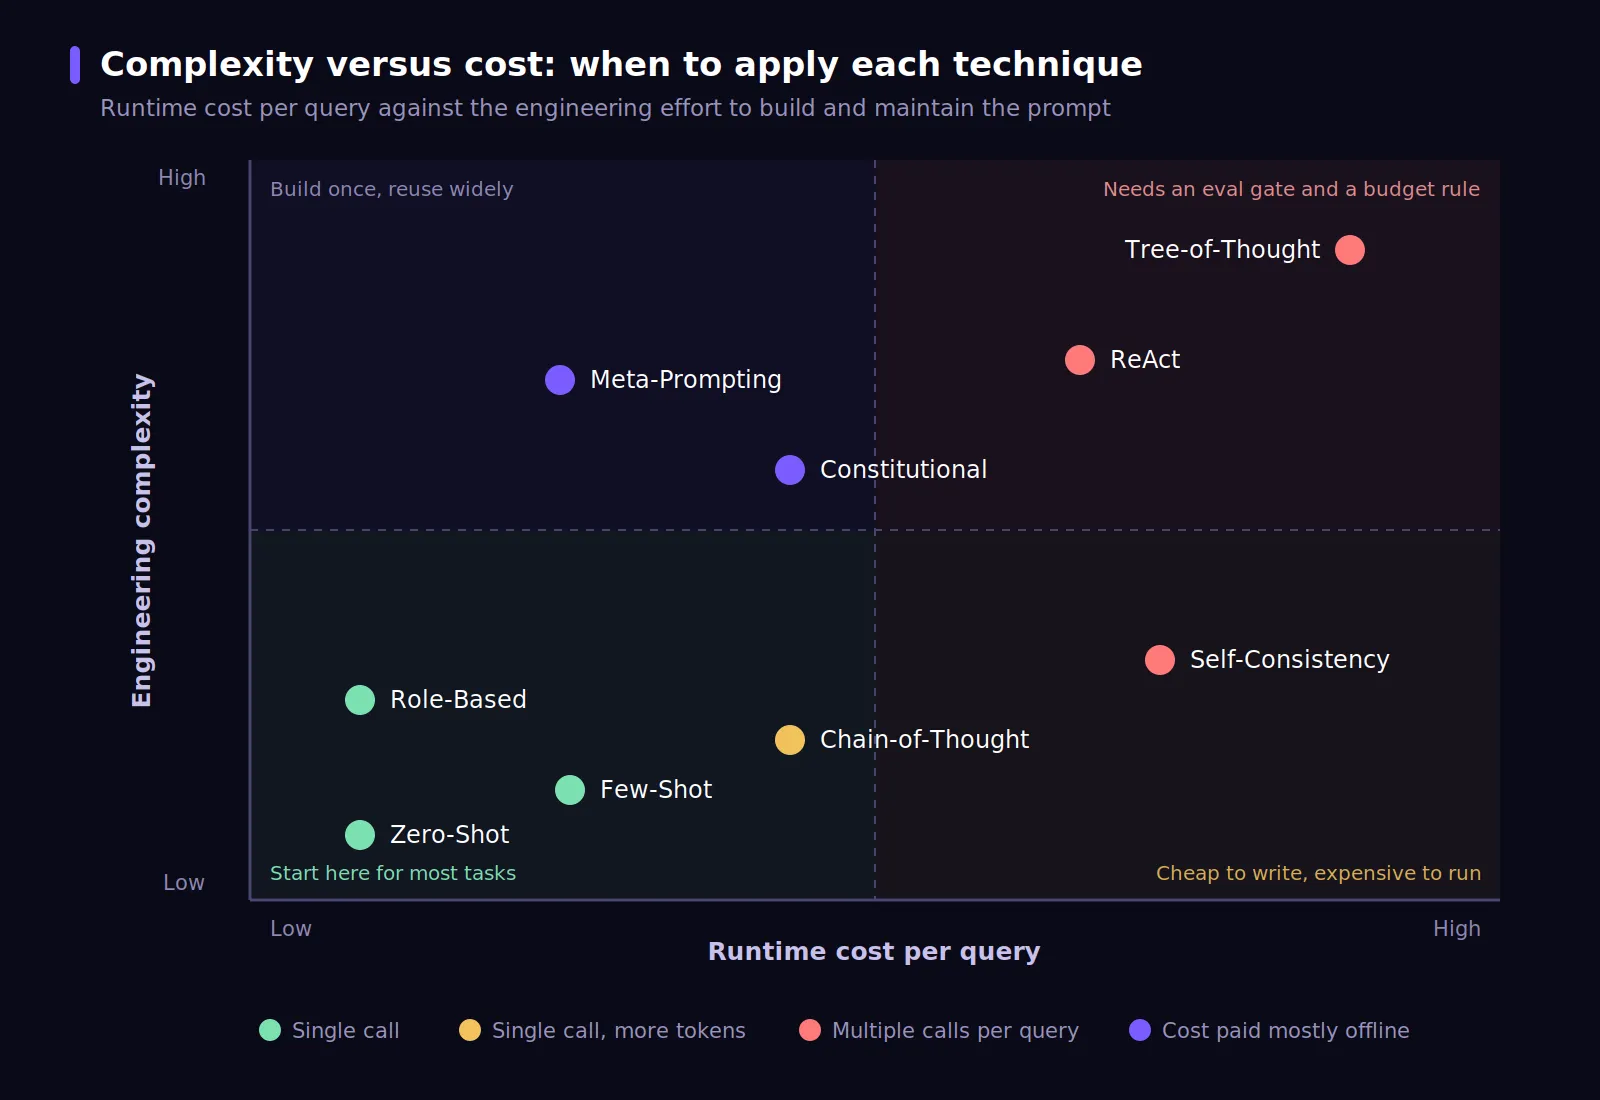
Individuele prompt engineering-methoden werken anders in gecontroleerde tests dan in productieomgevingen met echte gebruikers. Verschillende operationele realiteiten bepalen welke technieken haalbaar blijven zodra het dataverkeer, de kosten, het risico en de governance-eisen toenemen.
TrueFoundry's ingebouwde prompt injection guardrail draait uitsluitend in validate mode en analyseert de user prompt en alle document- of contextinhoud als twee gescheiden oppervlakken. Deze gescheiden analyse is belangrijk omdat indirecte injection plaatsvindt in opgehaalde documenten en niet in het eigen bericht van de gebruiker.
Prompt engineering techniques bepalen hoe goed een LLM een taak begrijpt en uitvoert. De governance-laag bepaalt of die uitvoering veilig verloopt, binnen de budgetgrenzen blijft en voldoet aan de eisen voor access control en audit-bewijsvoering die enterprise-productie vereist.
De AI Gateway van TrueFoundry past input-filtering toe voordat prompts een model bereiken. Pogingen tot prompt injection worden onderschept, ongeacht hoe geavanceerd de prompt-engineeringmethoden van het systeem zijn. Output guardrails passen het content-beleid toe voordat antwoorden terugkeren naar toepassingen. Dit is een aanvulling op constitutional prompting op modelniveau, geen vervanging ervan.
Het executiemodel verdient extra aandacht. Input validation guardrails draaien parallel met het modelverzoek. Als de validatie halverwege mislukt, annuleert de gateway het modelverzoek, zodat de geblokkeerde prompt niet gefactureerd wordt. Input mutation guardrails, zoals PII-anonimisering, draaien daarentegen voorafgaand aan het verzoek, omdat zij de payload herschrijven die het model ontvangt.
Elke guardrail verschijnt op de request trace als een eigen span met latency, oordeel, scope en de entiteit waarop deze van toepassing was. De uitrol volgt het bewijs: start regels in Audit, verhoog naar Enforce, But Ignore On Error, en stap over op Enforce zodra de bevindingen correct zijn.
Guardrails kunnen per verzoek worden gekoppeld via de header `X-TFY-GUARDRAILS`, of centraal als policies onder AI Gateway → Controls → Guardrails voor organisatiebrede handhaving.
Token-budgetten per team die worden afgedwongen via de LLM gateway voorkomen de kostenoverschrijdingen die self-consistency en tree-of-thought-technieken op schaal veroorzaken als kosten-governance ontbreekt. Rate limiting rules accepteren zowel token-eenheden als request-eenheden, en `rate_limit_applies_per` maakt een onafhankelijke teller aan per gebruiker, per model of per metadata-sleutel.
Budgetregels voegen financiële plafonds toe per gebruiker, team, model, virtueel account of metadata-sleutel. Mijlpaalnotificaties en de auditmodus helpen teams om drempels af te stellen voordat handhaving het verkeer blokkeert.
Toepassingen kunnen een beheerde prompt aanroepen via de versie-FQN in plaats van tekst mee te sturen met de applicatie. Dit houdt prompt-aanpassingen buiten de releasecyclus. De gateway rendert de template en voert de call uit.
Twee details bij die call zijn van belang. De vastgezette versie (version pin) betekent dat een prompt-rollback nooit een nieuwe deployment vereist. De header `X-TFY-METADATA` zorgt ervoor dat budgetten per dienst, rate limits en cost attribution naar een daadwerkelijke eigenaar herleid worden.
De Agent Gateway beheert elke tool call die op ReAct gebaseerde agents uitvoeren. Hierdoor blijven de redeneer- en executiestappen afzonderlijk beheerd, en bevat de log van elke tool-aanroep de identiteitscontext van de gebruiker.
De MCP Gateway levert de pre-execution en post-execution hooks die dit afdwingen. Guardrails evalueren elke tool call afzonderlijk in plaats van één keer per gesprek. Een agent die achtereenvolgens vijf tools aanroept, doorloopt vijf sets controles.
Pre-execution hooks stoppen de actie voordat deze wordt uitgevoerd, inclusief parametervalidatie, SQL-sanitisatie en permissiecontroles geschreven als Cedar- of OPA-policies. Post-execution hooks inspecteren de output van de tool en vangen indirecte injection en gelekte geheimen af voordat de Observation-stap deze terugvoert in de context van het model.
Bouw prompt-workflows die ook in productie beheerd blijven. Boek een demo om te zien hoe TrueFoundry het prompt registry, guardrails, budgetbeheer en audit logs verbindt binnen je AI Gateway.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















