



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het instrumenteren van een AI gateway die proxiet naar meer dan twintig providers is lastiger dan standaard OTel. We behandelen de gen_ai.* semantische conventies, de span-hiërarchie van de gateway (root, provider, guardrail), hoe fallback zichtbaar wordt in de trace-structuur, foutnormalisatie over Anthropic/OpenAI/Bedrock, kostentoewijzing per trace, propagatie vanuit applicatiecode, streaming en TTFT, en exporter-configuraties voor Datadog, Tempo en Jaeger.
Woensdag 14:14 uur bij Northwind. Cargo Copilot begint gelijktijdig foutmeldingen te retourneren aan twaalf ontwikkelaars. De dienstdoende engineer opent het gateway-dashboard. Binnen negentig seconden weten ze: 22% van de Anthropic Sonnet 4-verzoeken in de afgelopen vijf minuten retourneerde 529 overloaded_error; de gateway viel in 78% van die gevallen terug op Azure OpenAI gpt-5, voegde 1,8 seconden latentie toe op het fallback-pad en kostte het bedrijf $ 14 extra aan retries en fallbacks in die periode. De provider-A-spans zijn rood. De provider-B-spans ernaast zijn blauw. De root-spans zijn groen. De engineer sluit het dashboard. Er is niets anders nodig. Dat is hoe goede LLM observability eruitziet.
In dit artikel leggen we uit hoe je dit bouwt. We gaan ervan uit dat je al OpenTelemetry gebruikt voor je services; de vraag is hoe je dit uitbreidt naar de multi-provider AI gateway die ervoor staat.
De OpenTelemetry GenAI semantische conventies definiëren een standaard terminologie voor het instrumenteren van LLM calls onder de gen_ai.* namespace. De conventies hebben vanaf OTel semconv v1.36.0 nog steeds de status Development, wat operationeel van belang is: de attribuutnamen zijn onlangs gewijzigd en de meeste SDK's in de praktijk sturen nog steeds de oudere varianten uit.
Hier is de structuur van een echte provider-span attribuutset van een succesvolle Anthropic Sonnet 4-call:
JSON — de attribuutset van een provider-span bij een succesvolle call
Drie details zijn het vermelden waard. gen_ai.request.model is wat de client heeft aangevraagd; gen_ai.response.model is wat de provider daadwerkelijk heeft geleverd (wat kan verschillen — claude-sonnet-4 is een alias die verwijst naar een specifieke versie). Token-aantallen bevatten volgens de spec ook gecachte tokens: gen_ai.usage.input_tokens is het totaal, waarbij het gecachte deel afzonderlijk wordt uitgesplitst. En gen_ai.usage.cost_usd is een door TrueFoundry gegenereerd attribuut bovenop de standaard semconv — de spec behandelt wel tokens, maar de kostenberekening is de verantwoordelijkheid van de gateway (zie §5).
Elk inkomend verzoek naar de gateway levert één root-span op. Die root-span heeft children voor elk onderdeel van het werk dat de gateway uitvoert: input guardrails, de uitgaande provider call, output guardrails. Als er een fallback optreedt, krijg je een tweede provider-span onder dezelfde root (zie §3).
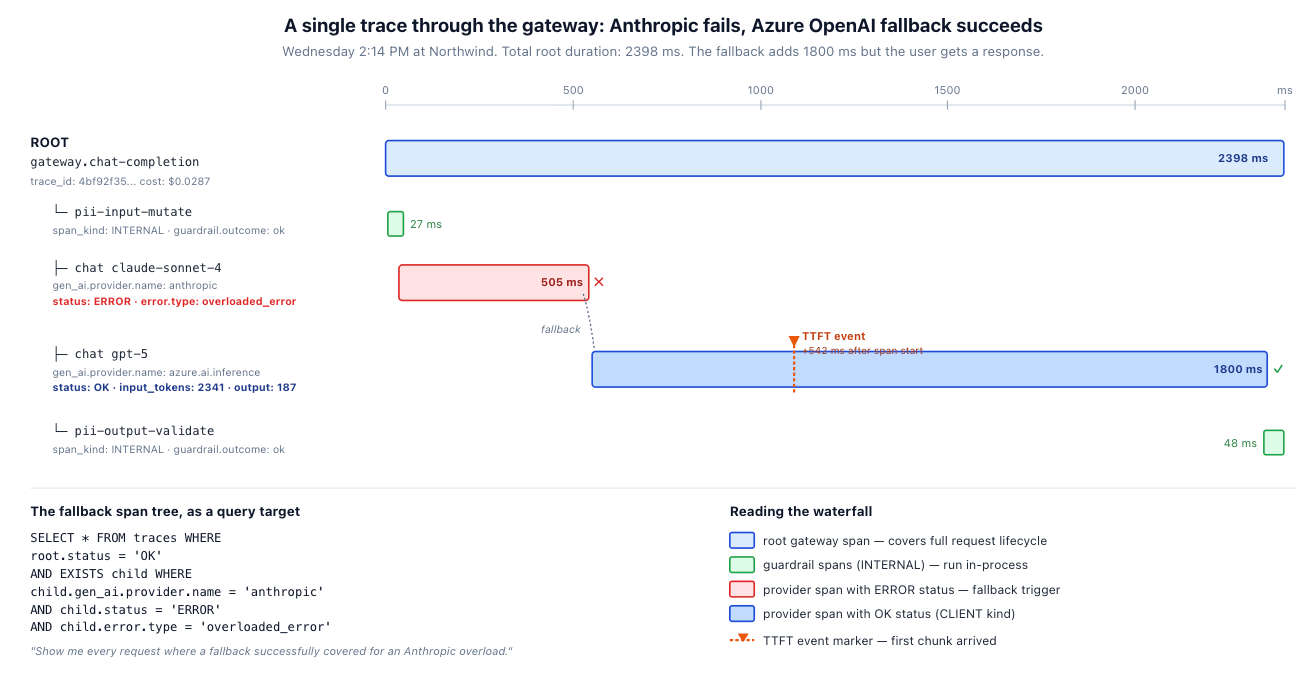
De conventies voor het span-type (span-kind) zijn belangrijk. Volgens de OpenTelemetry GenAI-specificatie zijn externe provider calls CLIENT-spans. Guardrail-spans — PII-redactie, schema-validatie, alles wat binnen het gateway-proces draait — zijn INTERNAL. De root-span zelf is SERVER (de gateway is de server vanuit het perspectief van de client).
Span-namen volgen het voorgeschreven formaat: {operation} {model} voor inference-spans (dus chat claude-sonnet-4, niet claude-sonnet-4-call of LLM call), en een vrije naam voor de root- en guardrail-spans. Consistentie op deze laag zorgt ervoor dat dashboards over meerdere teams heen bruikbaar zijn.
Een fallback is geen afzonderlijk concept in OTel; het is gewoon een tweede sibling-span. Wanneer Anthropic 529 retourneert en de gateway convergeert naar Azure OpenAI, toont de trace twee CLIENT provider-spans onder dezelfde SERVER root. De eerste heeft de status ERROR met het foutattribuut; de tweede heeft de status OK. De status van de root weerspiegelt wat de client heeft ontvangen, wat OK is als de fallback is geslaagd.
Deze opzet maakt fallbacks doorzoekbaar. In Tempo of Jaeger is "toon mij elk succesvol verzoek waarbij een fallback een overbelasting bij Anthropic heeft opgevangen" een query op de trace-tree:
Query's uitvoeren op het fallback-patroon in observability-backends
De query is operationeel waardevol: wanneer een upstream provider een slechte middag heeft, geeft dezelfde query je het percentage fallbacks, de extra latentie en de totale kostenimpact — gegroepeerd per team, model of tijdsbestek, wat zorgt voor diepere LLM observability. De trace-structuur doet het werk.
Elke LLM provider heeft zijn eigen foutformaat. Het is de taak van de gateway om deze te normaliseren naar een kleine, consistente terminologie waarop dashboards en alerts kunnen vertrouwen, terwijl de ruwe providerdetails behouden blijven voor analyse.
Het principe: een kleine set genormaliseerde error.type-waarden (RATE_LIMITED, QUOTA_EXCEEDED, OVERLOADED, PROVIDER_UNAVAILABLE, TIMEOUT, INVALID_REQUEST, CONTENT_FILTERED) stuurt de cross-provider dashboards en alerting-regels aan. Het provider-specifieke attribuut (gen_ai.anthropic.error_type, gen_ai.openai.error_code) blijft gekoppeld voor diepere analyse. Lage kardinaliteit op het genormaliseerde veld; hoge kardinaliteit op het ruwe veld. Beide zijn van belang.
Kosten zijn een afgeleid attribuut, niet iets wat door de provider wordt gegenereerd. De gateway berekent dit aan het einde van elke provider-span met behulp van de door de provider gerapporteerde gebruikstokens en een prijstabel die door de gateway wordt onderhouden.
Python — kostenformule opgeslagen als gen_ai.usage.cost_usd op elke provider-span
Twee subtiliteiten spelen een rol op grote schaal. Ten eerste geeft de spec aan dat gen_ai.usage.input_tokens al zowel cache_read.input_tokens als cache_creation.input_tokens bevat. Als je de volledige input_tokens factureert tegen het reguliere invoertarief en daar bovenop de regels per cache toevoegt, reken je te veel voor het cache-read gedeelte en tel je het cache-write gedeelte dubbel. Trek beide eraf voordat je het invoertarief toepast. Ten tweede tellen fallback-kosten op: wanneer Anthropic mislukt en de gateway Azure OpenAI aanroept, worden de kosten van het gedeeltelijke Anthropic-verzoek mogelijk nog steeds in rekening gebracht (invoertokens zijn verzonden, zelfs als er geen uitvoer is teruggekomen). Beide provider-spans moeten een cost_usd bevatten, en de root-span telt deze op. De som vormen de werkelijke trace-kosten.
Aggregaties volgen hieruit: kosten per team (tag spans met de identiteit van de aanroeper), kosten per model, kosten per functie (tag met een service.* attribuut ingesteld door de applicatie), kosten per trace-tag (bijv. "support-ticket" versus "code-generation"). Het OTel-gedeelte is rechttoe rechtaan; het werk zit in het up-to-date houden van de prijstabellen.
Om een gateway-trace nuttig te maken, moet deze worden gekoppeld aan de upstream applicatie-trace. OpenTelemetry maakt gebruik van de W3C Trace Context-specificatie: een traceparent HTTP-header die het trace ID en het parent span ID over servicegrenzen heen transporteert. De gateway leest deze header bij inkomende verzoeken en verzendt zijn eigen spans als children van de span van de applicatie.
In Python met de OpenAI SDK gericht op de gateway ziet de propagatie er zo uit:
Python — applicatie stelt traceparent in; gateway zet de trace voort
De applicatie-tags (northwind.team, northwind.feature) worden verder in de boom doorgegeven omdat de gateway baggage en eventuele aangepaste attributen op de parent-span behoudt. Op deze manier kan een enkel kostendashboard de vraag beantwoorden "hoeveel heeft het supportteam vorige maand uitgegeven aan concept-escalaties" zonder dat de gateway iets hoeft te weten over de teamstructuur van Northwind.
De LLM provider breidt de trace niet uit — OpenAI, Anthropic en Bedrock stellen hun interne trace ID's niet beschikbaar aan clients. Wat je krijgt is de gateway-weergave van de provider call: time-to-first-byte, totale duur, token-aantallen. Dat is meestal voldoende; wanneer dat niet zo is, relateer je gegevens op basis van het tijdstempel aan de eigen telemetry van de provider.
Streaming maakt de timing van spans ingewikkelder omdat de respons geen enkel moment in de tijd is — het is een reeks chunks die binnenkomt over een periode van honderden milliseconden of meer. De OTel GenAI spec vangt dit op met toegewezen metrics en een span-event-patroon.
De relevante metrics, die allemaal vereist zijn door de GenAI metrics-spec: gen_ai.client.operation.duration (volledig verzoek tot de laatste chunk), gen_ai.client.operation.time_to_first_chunk (de TTFT-waarde die het meest bepalend is voor de ervaren responsiviteit), en gen_ai.client.operation.time_per_output_chunk (de tijd tussen chunks). Leg op de span zelf TTFT vast als een span-event:
Python — leg TTFT vast als een span-event terwijl de stream nog open is
Twee patronen zijn operationeel belangrijk. De span blijft open gedurende de gehele stream — sluit deze niet bij TTFT, anders verlies je de rest van de timing. En token-aantallen worden pas geregistreerd wanneer de stream wordt gesloten, omdat de meeste providers het uiteindelijke gebruiksblok in de laatste chunk (Anthropic, OpenAI) of in een afsluitend message_stop-event sturen. Een span exporter die voortijdig flusht ziet nul output tokens, waardoor de kostentoewijzing mislukt.
TrueFoundry's gateway verzendt OTel-spans via OTLP/HTTP, losgekoppeld van het request-pad via NATS, zodat een storing in de backend de beschikbaarheid van de inference niet kan beïnvloeden. De gateway tracing-documentatie behandelt de integratiepaden. De exporter-configuratie is volgens de OTLP-standaard — elke compatibele backend werkt.
Datadog ondersteunt de GenAI semantische conventies al native sinds december 2025. Drie intake-paden: directe OTLP, Datadog Agent met OTLP-ingest ingeschakeld, of de OpenTelemetry Collector (Datadog Distribution).
Datadog OTLP-intake — omgevingsvariabelen
Grafana Tempo — gRPC OTLP exporter
Jaeger — OTLP gRPC
100% sampling is prima voor ontwikkeling en de eerste maand in productie. Als het volume groeit, is de vuistregel: head-based sampling (waarschijnlijkheid van bijvoorbeeld 0,1) voor de reguliere verzoeken met een hoog volume; tail-based sampling op de collector-laag om 100% van de error-traces en trage traces te bewaren, ongeacht de head-rate. Deze combinatie levert beheersbare opslagkosten op zonder gegevens te verliezen die er toe doen als er iets misgaat.
Gebruik voor attributen met een hoge kardinaliteit (identifiers per gebruiker, request ID's, volledige prompt-inhoud) liever events of logs in plaats van span-attributen — limieten voor de kardinaliteit van OTel-attributen zijn reëel, en een prompt van 10.000 tekens als span-attribuut is een route naar dure verrassingen.
Je kunt je eigen collector meebrengen. De gateway verzendt OTLP-standaardgegevens naar elke compatibele backend. TrueFoundry heeft gedocumenteerde integraties met Datadog, Honeycomb, Middleware, LangSmith en Grafana Tempo. De door TF gehoste collector is een gemak, geen lock-in.
Standaard niet. De huidige spec verklaart gen_ai.prompt en gen_ai.completion attributen als verouderd ten gunste van gen_ai.input.messages en gen_ai.output.messages, die worden vastgelegd als events (geen span-attributen) wanneer het vastleggen van inhoud is ingeschakeld. Zelfs dan is vastleggen opt-in: prompts kunnen PII bevatten en grote prompts maken spans extreem groot. Leg dit alleen vast voor geselecteerde traces, niet voor allemaal.
De GenAI-spec behandelt agent-spans afzonderlijk: create_agent, invoke_agent, execute_tool. MCP-tooluitvoeringen kunnen specifiek worden getracet via de MCP-instrumentatie. De gateway legt alles vast aan de rand; de applicatie legt alles vast binnen de eigen grenzen; de trace-context verbindt ze. Het resultaat is één waterfall die de agent-loop van begin tot eind dekt, met tool calls als INTERNAL-spans en provider calls als CLIENT-spans.
Tag de root-span met het attribuut dat de eigenaar identificeert: northwind.team, northwind.cost_center, gen_ai.agent.name, of alle drie. Kosten worden vervolgens in de backend geaggregeerd per tag. De applicatie is verantwoordelijk voor het instellen van de tag; de gateway behoudt en propagereert deze. Hetzelfde schema werkt voor toewijzingen per functie en per klant.
Grotendeels wel, mits je rekening houdt met versies. De spec bevindt zich in Development, wat betekent dat wijzigingen met backward-incompatibility nog steeds mogelijk zijn — de recente hernoeming van gen_ai.system naar gen_ai.provider.name is daar een voorbeeld van. De oplossing hiervoor is de omgevingsvariabele OTEL_SEMCONV_STABILITY_OPT_IN, waarmee instrumentatie-bibliotheken kunnen kiezen voor de nieuwste experimentele attributen zonder oudere toepassingen te verstoren. Stel dit bewust in bij een upgrade; vertrouw er niet op dat standaarden hetzelfde blijven.
De TrueFoundry AI Gateway verzendt OTel-compliant traces voor elk verzoek, met de hierboven beschreven span-hiërarchie en de gen_ai.* attributen ingesteld volgens de huidige spec. Trace-export is asynchroon (via NATS), zodat observability-backends de beschikbaarheid van inference niet kunnen beïnvloeden. De gateway voert ook de kostenberekening, foutnormalisatie en de opbouw van de fallback-span-tree uit, zoals beschreven in respectievelijk §§5, 4 en 3. De integraties voor eigen backends zijn volledig ondersteund: elke OTLP-compatibele bestemming werkt.
Als je LLM-workload momenteel zonder inzicht draait, is de meest effectieve eerste stap het exporteren van OTel vanuit de locatie waar je gateway draait naar een OTLP-compatibele backend. Dat is een klus voor een weekend; de dashboards zijn het eenvoudige gedeelte zodra de spans stromen.
Start hier: TrueFoundry tracing-documentatie. Of boek een observability architecture review met ons team.
Bronvermeldingen zijn in de tekst gelinkt. De onderstaande lijst verzamelt alle URL's voor overzicht en naslag.
Opmerking: Northwind Logistics is een fictief bedrijf dat wordt gebruikt om het ontwerp in een concrete implementatie te verduidelijken. De trace op woensdag om 14:14 uur in §2 is samengesteld om de span-tree te illustreren; echte productietraces variëren qua timing en beschikbare provider. De OTel GenAI semantische conventies hebben nog steeds de status Development vanaf OTel semconv v1.36.0 — attribuutnamen kunnen blijven veranderen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















