



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Onze testharness gaf aan dat OpenRouter prompt-caching werkte op Anthropic-modellen. Onze write-up een paar dagen later zei van niet. Beide klopten niet.
De test stuurde een lang blok referentietekst naar Claude Haiku 4.5 met cache_control erin, exact waar de documentatie van OpenRouter zegt dat het moet staan. De harness zag cache-velden in de response en markeerde de functie als werkend. Toen we later naar de cijfers keken, was cache_write_tokens nul, dus concludeerden we dat de functie was weggelaten. Het antwoord stond de hele tijd al in de documentatie: Haiku 4.5 cachet geen prompts onder de 4.096 tokens, en de onze telde er ongeveer 3.600.
De meeste prompt-cachingproblemen op OpenRouter verlopen op dezelfde manier. Het verzoek slaagt en de functie staat aan. De response laat u alleen niet duidelijk weten wanneer er niet werd gecachet, of wanneer er wel werd gecachet maar het meer kostte dan het opleverde.
OpenRouter gebruikt het woord voor twee functies die vrijwel niets gemeen hebben.
Provider prompt caching hoort bij de provider. Het slaat het verwerkte voorvoegsel van uw prompt op, zodat het volgende verzoek met hetzelfde voorvoegsel het opnieuw lezen overslaat en die tokens tegen een korting in rekening brengt. Het model draait nog steeds en genereert een nieuw antwoord. Response-caching hoort bij OpenRouter. Het slaat de gehele response op en retourneert deze bij een identiek verzoek; het model draait in dat geval helemaal niet.
De onderstaande prijzen, ondergrenzen en TTL's gaan over provider prompt-caching. Als u twijfelt tussen exact-match en semantische response-caching, legt onze gids over wanneer vergelijkbare vragen een antwoord moeten delen dat uit. OpenRouter's response-cache heeft een eigen sectie aan het einde.
OpenRouter geeft de cacheprijzen van elke provider door zonder toeslag per token. De kosten zitten in plaats daarvan op de aanschaf van credits, wat wordt behandeld in onze OpenRouter prijsanalyse. De onderstaande vermenigvuldigingsfactoren zijn relatief ten opzichte van de normale invoerprijs van het model.
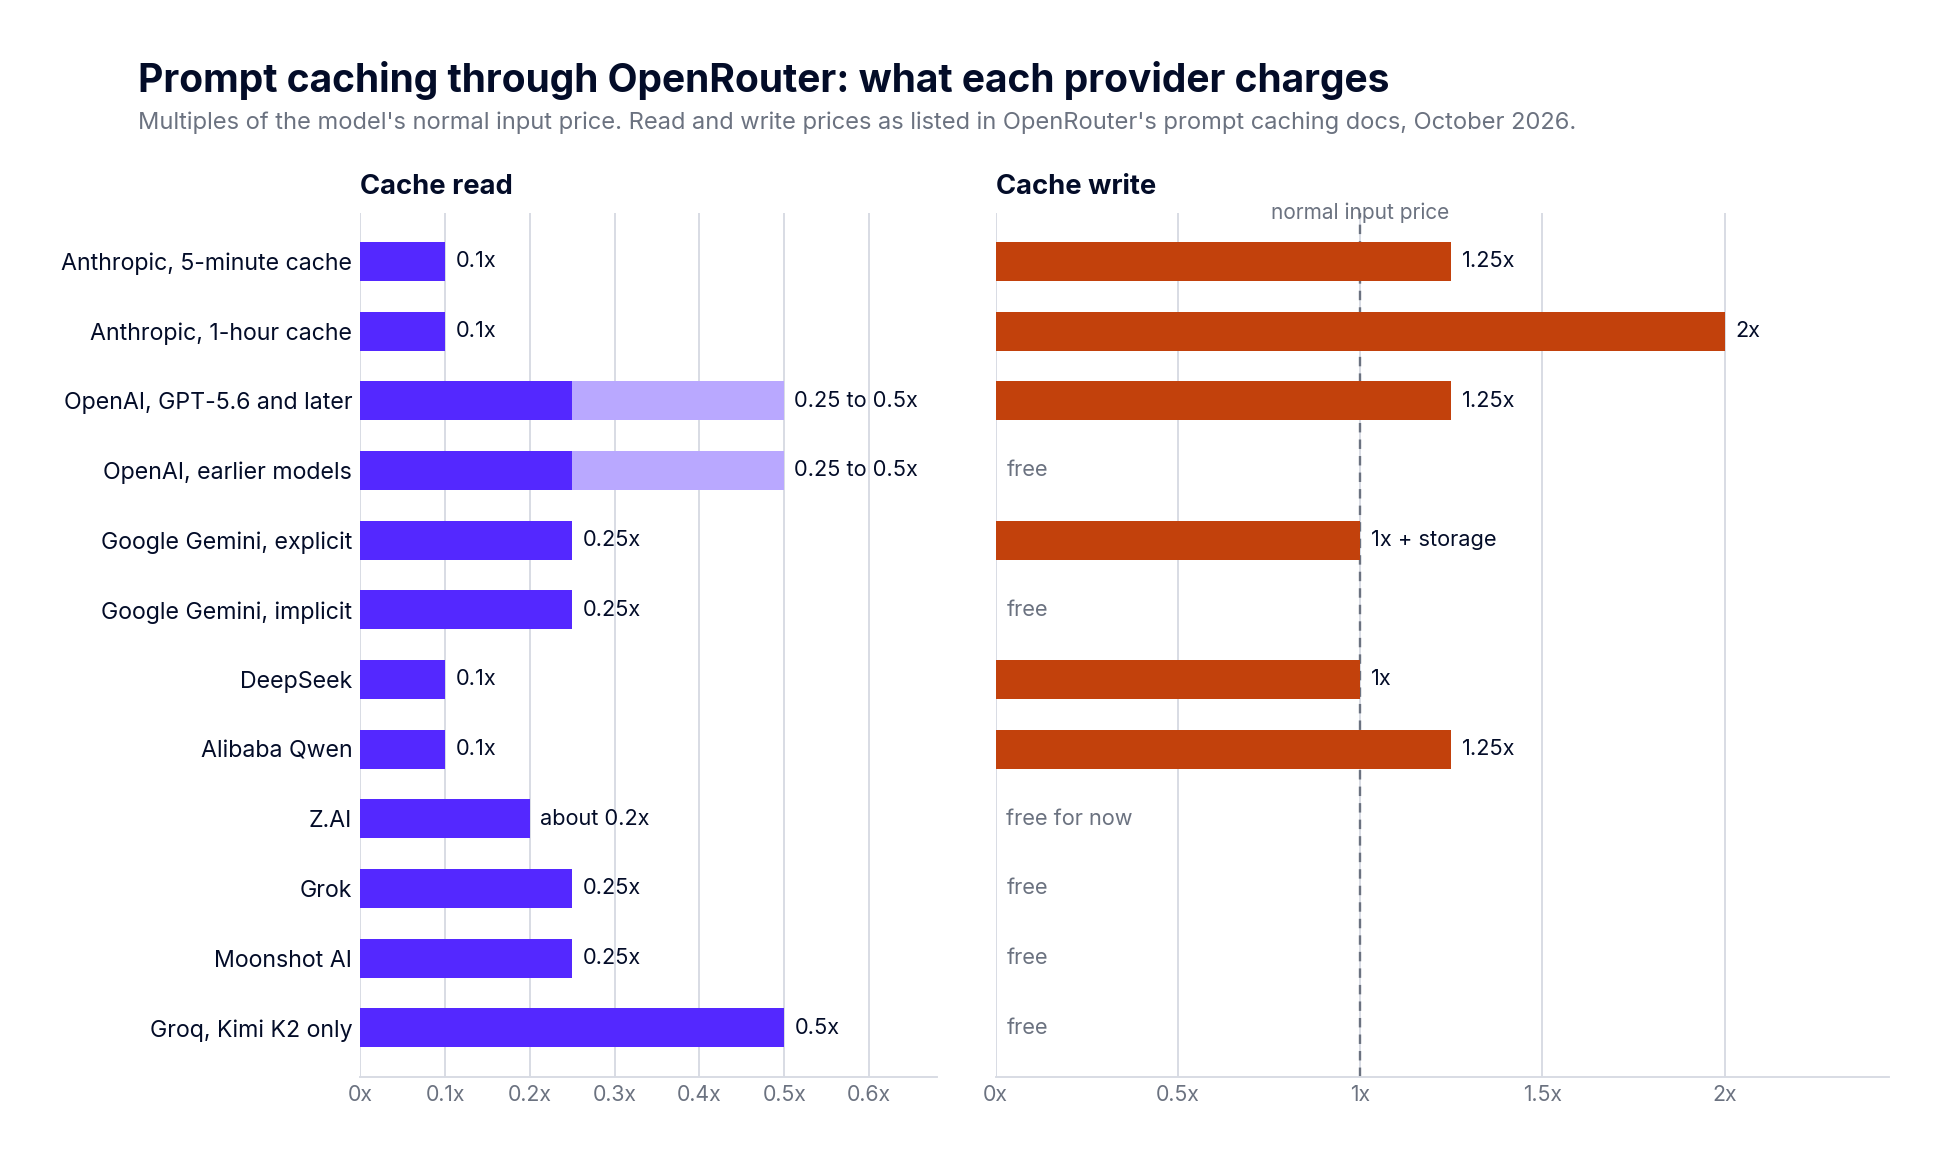
Reads variëren van een tiende tot de helft van de invoerprijs, en writes van gratis tot het dubbele. Vijf van de negen hebben geen minimale promptlengte in de documentatie van OpenRouter staan. En met model-fallbacks of de Auto Router kan het ene verzoek op een andere rij terechtkomen dan het vorige, met een koude cache.
Of caching geld bespaart, hangt af van hoe vaak hetzelfde voorvoegsel wordt verzonden terwijl de cache nog warm is. Uitgaande van bovenstaande vermenigvuldigingsfactoren en uitsluitend kijkend naar het gecachete deel van de prompt:
Het restant van elk verzoek, de vraag van de gebruiker en alles na het laatst gecachete blok, wordt op dezelfde manier gefactureerd, dus deze verhoudingen gelden alleen voor het voorvoegsel.
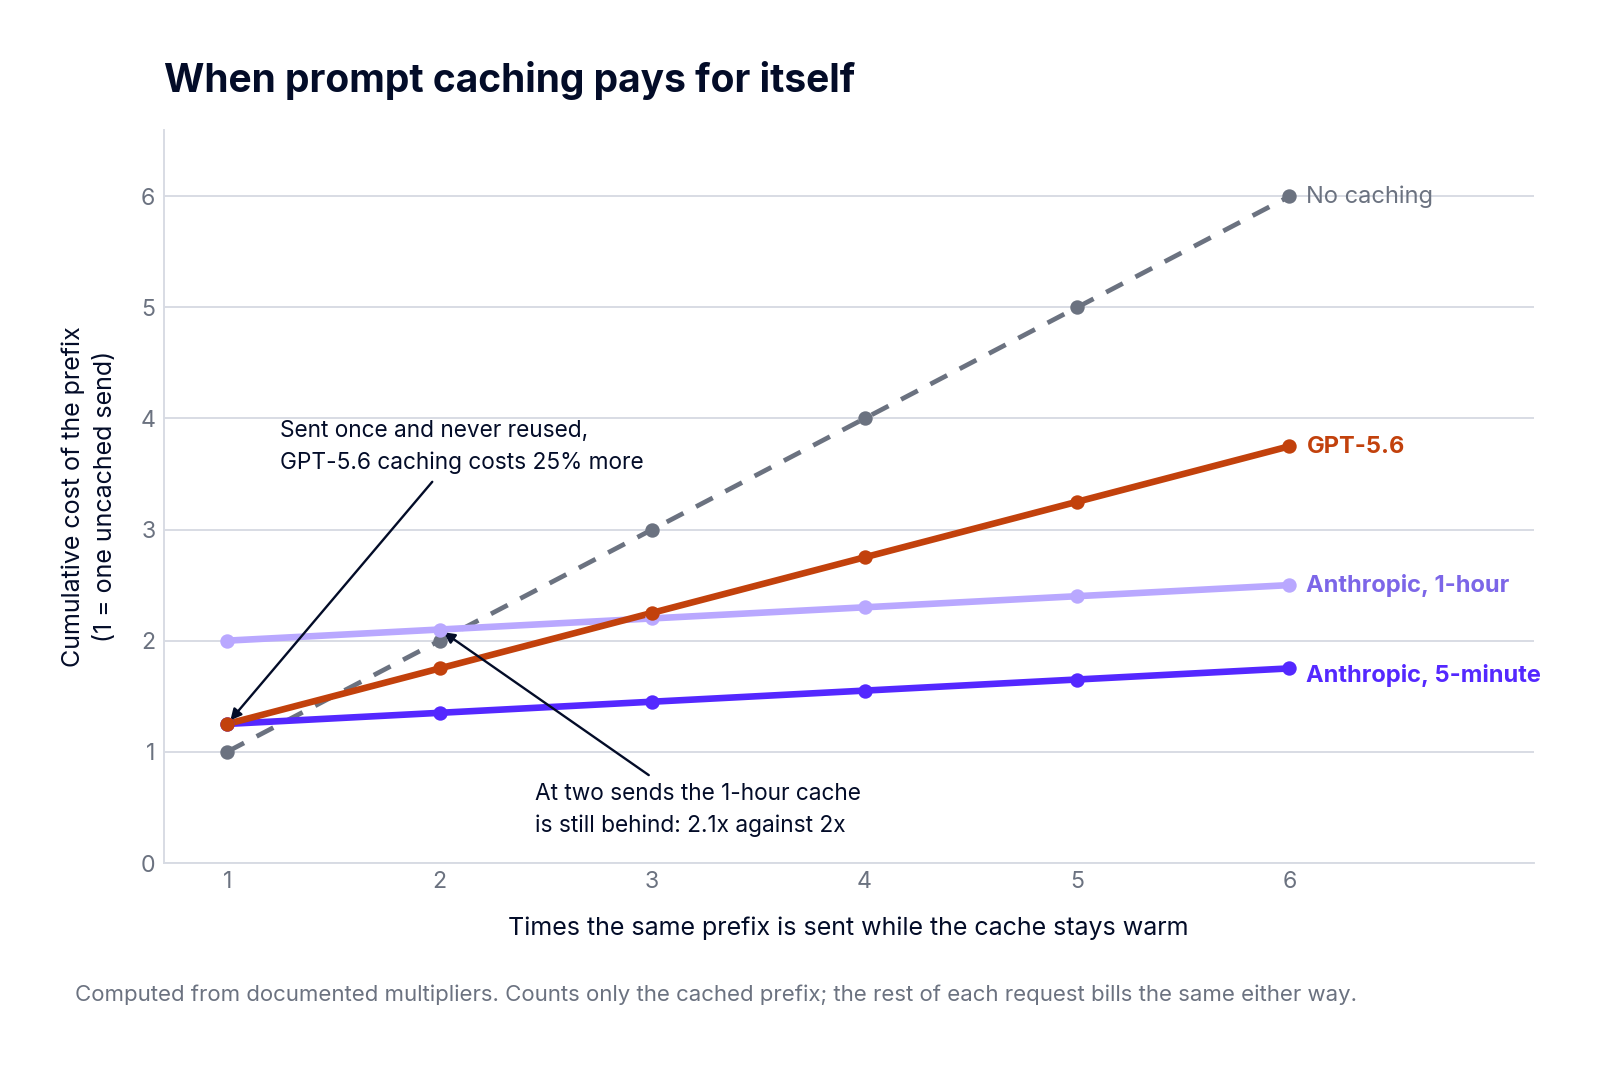
Voor het grootste deel van de tabel is een cache-write gratis of vrijwel gratis, waardoor cachen een kosteloze optie is. GPT-5.6 veranderde dat voor OpenAI. Vanaf die modelfamilie worden cache-writes gefactureerd tegen 1,25x de invoerprijs, ook bij automatische caching, en automatische caching staat aan ongeacht of u erom heeft gevraagd. Elke prompt van 1.024 tokens of meer die u één keer verstuurt, betaalt voor de write zonder ooit de besparing van de read te verzilveren.
Neem een prompt van 2.000 tokens die één keer wordt verzonden. Zonder caching wordt dit gefactureerd als 2.000 tokens aan invoer. Met caching aan betaalt u bijna wat een prompt van 2.500 tokens zou kosten. Bij een nachtelijke taak die een miljoen lange, unieke documenten samenvat, waarbij het document vooraan staat en niets aan het begin zich herhaalt, is dat een toeslag van 25% op het grootste deel van uw invoer.
De oplossing werkt omgekeerd. Zet prompt_cache_options.mode op "explicit" en markeer geen enkel inhoudsblok met prompt_cache_breakpoint. De expliciete modus schakelt de automatische breekpunten van OpenAI uit, en zonder expliciete breekpunten is er geen cachebaar voorvoegsel, dus wordt er niets geschreven. cache_write_tokens komt terug als nul, wat de enige plek in dit artikel is waar een nul betekent wat u wilt.
Nu de andere kant. Claude Sonnet 4.6 met een system-prompt van 5.000 tokens, 100 verzoeken gedurende een werkdag, binnenkomend in 20 pieken van vijf met tussenpozen van ongeveer 20 minuten. Alleen kijkend naar de system-prompt, uitgedrukt in tokens gefactureerd tegen de normale invoerprijs:
De 5-minuten-cache bespaart twee derde. De 1-uurs-cache bespaart 88%, omdat een onderbreking van 20 minuten de korte cache telkens doet verlopen, waardoor de lange cache nooit wordt bereikt. Anthropic vernieuwt de levensduur van de cache elke keer dat deze wordt gelezen, waardoor de 1-uurs-entry de hele dag warm blijft.
Verander het verkeer en de uitkomst verandert. Als die 100 verzoeken gelijkmatig zouden binnenkomen, bijvoorbeeld elke vier minuten één, zou de 5-minuten-cache ook nooit verlopen. In dat geval zou de 1-uurs-optie betekenen dat u 10.000 betaalt voor een write die de korte cache afhandelt voor 6.250. Kies de TTL op basis van de pauzes tussen uw verzoeken, niet op basis van het aantal verzoeken dat u verstuurt.
Elke provider hanteert een minimale promptlengte waaronder niets wordt gecachet. Voor Claude geldt volgens de documentatie van OpenRouter:
De ondergrens van OpenAI is 1.024. Die van Gemini is 1.024 op 2.5 Flash en 4.096 op 2.5 Pro. Onder de ondergrens slaagt het verzoek, wordt het tegen het volle tarief voor invoer gefactureerd en keert het terug met de cache-velden op nul gezet. Geen foutmelding, geen waarschuwing.
Twee gevolgen hiervan worden gemakkelijk over het hoofd gezien.
Nieuwere modellen hebben hogere ondergrenzen. Een system-prompt van 3.000 tokens wordt wel gecachet op Sonnet 4.6, maar stopt met cachen op de dag dat u overstapt naar Opus 4.7, zonder dat de code verandert en zonder dat er iets in de response staat om u dat te vertellen. Overstappen van Haiku 3.5 naar Haiku 4.5 doet hetzelfde voor alles tussen de 2.048 en 4.096 tokens. Een model-upgrade is een verandering in caching, dus controleer uw cache hit rate na een upgrade.
En u kunt caching niet verifiëren door te zoeken naar cache-velden. Dat was de valkuil bij onze eigen test. OpenRouter retourneert cached_tokens en cache_write_tokens bij responses van elke provider, inclusief providers waar caching niet native is; het feit dat de velden aanwezig zijn bewijst dus niets. Nullen bewijzen ook niet veel. Ze betekenen dat de marker is genegeerd of dat de prompt onder de ondergrens lag. Bij Haiku 4.5 op 3.600 tokens was het de ondergrens.
Een test die wel duidelijkheid geeft:
cache_write_tokens boven nul bij de eerste call. Verwacht een cached_tokens boven nul bij de tweede call.cache_discount in de response body. Deze is negatief bij een write van Anthropic en positief bij een read.OpenRouter vertaalt cache-markers tussen providers, wat handig is. Een tekstblok met een Anthropic-stijl cache_control wordt een prompt_cache_breakpoint wanneer het gerouteerd wordt naar een GPT-5.6-model, en een prompt_cache_breakpoint wordt een standaard cache_control op Anthropic of Google.
De TTL verhuist niet mee. Een ttl op cache_control wordt onderweg naar OpenAI verwijderd. prompt_cache_options, waar de TTL van OpenAI zich bevindt, is alleen van toepassing op OpenAI. prompt_cache_breakpoint heeft geen TTL-veld, dus wat het ook wordt aan de Anthropic-zijde, het krijgt de standaardwaarde van 5 minuten.
Levensduren gedragen zich ook anders zodra ze zijn ingesteld. Die van Anthropic wordt bij elke read vernieuwd. De expliciete cache van Gemini duurt vijf minuten vanaf de write en wordt niet vernieuwd. De impliciete cache van Gemini is gedocumenteerd als gemiddeld drie tot vijf minuten, variërend. Eén request body die om een uur vraagt, kan dus een uur krijgen, vijf vaste minuten, of wat OpenAI ook toepast, afhankelijk van waar het terechtkomt. De Responses API voegt nog een verschil toe: deze ondersteunt geen per-blok Anthropic cache_control, dus gebruik Chat Completions of het Messages-endpoint als u een TTL op een specifiek blok nodig heeft.
Een cache helpt alleen als uw volgende verzoek de provider bereikt die de cache vasthoudt. OpenRouter regelt dat met provider sticky routing: na een verzoek dat gebruikmaakt van caching, gaan vervolgverzoeken voor hetzelfde model naar hetzelfde provider-endpoint.
Sticky routing wordt bijgehouden per account, per model en per conversatie, waarbij een conversatie wordt geïdentificeerd door een hash te maken van uw eerste system message en eerste niet-system message. Het verloopt na 10 minuten zonder verzoek.
Agents breken die standaardwaarde vaak, omdat hun openingsberichten tussen opeenvolgende stappen veranderen. Geef een session_id mee in de body of een x-session-id header en OpenRouter gebruikt dat in plaats daarvan als de sticky sleutel, beginnend vanaf het eerste succesvolle verzoek in plaats van te wachten op een cache hit. OpenAI's prompt_cache_key werkt als een fallback-sleutel als u deze al meestuurt.
Het instellen van provider.order schakelt sticky routing uit en uw lijst krijgt prioriteit. Zolang uw eerste keuze beschikbaar is kost dat weinig, aangezien een pin u sowieso op één provider houdt. Het verschil wordt zichtbaar na een failover, wanneer sticky routing de provider zou volgen die u het laatst heeft bediend en een pin weer bovenaan uw lijst begint. Pinnen is nog steeds de juiste keuze wanneer u voorspelbare capaciteit nodig heeft, zoals we betoogden in ons artikel over OpenRouter rate limits. De Auto Router heeft een vergelijkbaar nadeel: als het gekozen model bij een latere stap buiten de kandidaten valt, gaat de cache verloren.
Loshand van al het bovenstaande zal OpenRouter volledige responses cachen als u X-OpenRouter-Cache: true meestuurt. Een hit retourneert de opgeslagen response zonder een provider aan te roepen, kost niets en telt niet mee voor de rate limits van de provider.
We hebben dit gemeten over drie tests van elk 100 identieke herhaalde verzoeken, op GPT-4o mini en Claude Haiku 4.5. Elk herhaald verzoek was een hit. De mediane latency was 2.867 ms bij een miss en 59 ms bij een hit, waarbij Haiku hits sneller waren met 39 ms tegenover 64 tot 69 ms voor GPT-4o mini. Bij de test gefactureerd op credits kosten 100 misses $ 0,0174 en 100 hits kostten niets.
Entries worden gekoppeld aan de API key plus het model, het endpoint-type, de streamingmodus en de volledige request body, dus services met gescheiden keys delen niets en elke parameterwijziging is een miss. Onze TTL-meting, met één steekproef per interval, liet zien dat entries na 120 seconden nog actief waren en na 300 seconden verdwenen. Er is geen gepubliceerde TTL, geen semantische matching en geen gedocumenteerde opschoning. Het vangt retries en dubbele inzendingen op. Een herhaling na een uur resulteert in een miss.
Onze gateway cachet op de response-laag in twee modi. Exact-match retourneert een opgeslagen response voor een identiek verzoek. De semantische modus embedt het laatste bericht en retourneert een opgeslagen response wanneer een eerder verzoek dicht genoeg in de buurt kwam, en bedient ook exact-match hits; u draait dus één modus, niet beide. Het wordt ingeschakeld met een request header, ondersteund door Redis, en werkt samen met provider prompt-caching: bij een miss op de gateway is de eigen prefix-cache van de provider nog steeds van toepassing.
Op SaaS is het embeddingmodel text-embedding-3-small op 1.536 dimensies en niet configureerbaar; on-premise kiest u dit voor de gehele gateway. Semantische matching kent een risico dat exact-match niet heeft. Onze gids voor semantische caching begint ermee: twee klanten vragen met een paar minuten tussenruimte naar hun levering, de vragen worden geëmbed naar vrijwel dezelfde vector, en de tweede klant krijgt een antwoord over de bestelling van de eerste. Dat is een scope-bug. Het aanpassen van de drempelwaarde voor overeenkomst veranderd hoe vaak dit voorkomt, maar het stopt een cache die tussen klanten wordt gedeeld niet.
De cache lookup voegt ongeveer 3 tot 4 ms toe, en de gateway verwerkt 350+ RPS op een enkele vCPU.
session_id mee voor agent-sessies, zodat de routing op de provider blijft die uw cache bevat.cached_tokens, nooit alleen met het aanwezig zijn van het veld.OpenRouter prompt-caching werkt, en de documentatie is hier duidelijker dan bij veel van de omliggende functies. Toch heeft u te maken met negen prijsmodellen, ondergrenzen die stijgen bij nieuwere modellen, levensduren die veranderen bij conversie, en een response die er hetzelfde uitziet ongeacht of er gecachet is of niet. Controleer de ondergrens, zet de vaste tekst vooraan en controleer met getallen in plaats van velden.
Om caching één keer te configureren voor elke provider, met semantische matching bovenop de eigen prefix-cache van de provider, bekijkt u hoe de TrueFoundry AI Gateway omgaat met caching.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



It's OpenRouter passing through each provider's prompt caching, where a repeated prompt prefix is stored and billed at a discount on later requests. Some providers cache automatically, while Anthropic and Alibaba need cache_control markers on the content you want cached. Prices differ by provider, from free writes and 0.1x reads to 2x writes on Anthropic's 1-hour cache.
Ja, zolang de prompt de minimale lengte van het model haalt. Claude Haiku 4.5 en Opus 4.5 en later hebben 4.096 tokens nodig, en Sonnet 4.x heeft 1.024 tokens nodig. Onder die ondergrens slaagt het verzoek tegen volle prijs met cachevelden op nul, wat er precies uitziet alsof de marker wordt genegeerd.
Most likely you're paying for cache writes on prompts that never get reused. GPT-5.6 and later bill writes at 1.25x even under automatic caching, and Anthropic's 1-hour cache bills writes at 2x. If the prefix doesn't repeat while the cache is warm, you pay for the write and never get the discount.
Roughly 3–4 ms of overhead, handling 350+ RPS on a single vCPU. That matters more as model calls get faster: a routing layer that adds hundreds of milliseconds would erase the advantage of a sub-second decision model.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.



Het laatste nieuws, artikelen en bronnen in je inbox



















