



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Dit bericht beschrijft een architectuurpatroon dat je kunt implementeren met TrueFoundry’s AI Gateway. Let op: online evaluatie is geen native ingebouwde functie — het is iets dat je bouwt bovenop de observability- en routingmogelijkheden van de gateway.
Je kunt routen op basis van kosten, uitvallen opvangen met failover en agressief cachen — en nog steeds een wijziging doorvoeren die je antwoorden stilzwijgend slechter maakt. Kosten, latentie en foutpercentage zijn de drie signalen die elk productiesysteem in de gaten houdt, en ze kunnen allemaal groen blijven terwijl het vierde signaal, antwoordkwaliteit, verslechtert. Dit bericht legt uit hoe je dat vierde signaal in productie meet: online evaluatie, scoren met LLM-as-judge en de eerlijke kanttekeningen daarbij, steekproefgewijze verzameling (sampling), regressiedetectie en het sluiten van de cirkel terug naar routing.
Leena, een ML-engineer, voerde een wijziging door die iedereen wilde. Een supportroute met een hoog volume draaide op het vlaggenschipmodel, en een goedkoper model leek in tests bijna net zo goed. Ze paste de route aan — een gemakkelijke kostenverlaging van 60% op een groot deel van het verkeer. Elk dashboard bevestigde dat het een succes was: de latentie bleef gelijk, het foutpercentage veranderde niet, de uitgaven daalden volgens planning. De wijziging werd live gezet, de besparingen waren binnen en het team ging door met andere zaken. Twee weken later begonnen de support-escalaties te stijgen. Uit een inhoudelijke controle bleek dat dit kwam door subtiel slechtere antwoorden op precies die route — vager, af en toe fout op manieren die geen enkele foutmelding veroorzaakten. De kwaliteit was gedaald op de dag dat ze de wijziging live zette. Niets mat het, dus niets merkte het twee weken lang op.
Dit is de blinde vlek in het centrum van LLM-operations. De signalen die gemakkelijk te meten zijn — kosten, latentie, fouten — zijn niet het signaal dat bepaalt of het product goed is. Kwaliteit is moeilijker te meten, dus gebeurt het vaak niet. Een wijziging die kwaliteit inruilt voor kosten lijkt een schot in de roos totdat de klachten binnenstromen. Online evaluatie is hoe je een getal plakt op het vierde signaal en dit net zo nauwlettend in de gaten houdt als de andere drie.
Drie productiesignalen zijn vrijwel gratis omdat de infrastructuur ze genereert: latentie is een timer, kosten zijn tokens maal een tarief, fouten zijn statuscodes. Kwaliteit is geen van deze dingen. Een respons kan snel en goedkoop zijn en een schone 200 retourneren terwijl hij vaag, subtiel onjuist, in strijd met het beleid of onbehulpzaam is — en geen enkele operationele metriek zal veranderen. Die asymmetrie is de reden waarom teams de drie gemakkelijke signalen meten en blind varen op het signaal dat het product daadwerkelijk definieert.
Kwaliteit waarneembaar maken betekent dat je een signaal moet genereren dat niet vanzelf komt: steekproefgewijs echte responsen verzamelen, ze scoren ten opzichte van wat "goed" betekent voor de toepassing, en die score in de loop van de tijd en over wijzigingen heen volgen, direct naast kosten en latentie. De rest van dit bericht legt uit hoe je dat signaal geloofwaardig genereert — inclusief eerlijkheid over hoe ruisgevoelig het is — en waar je het moet uitvoeren zodat het verbonden is met beslissingen, zoals routing, die invloed hebben op de kwaliteit.
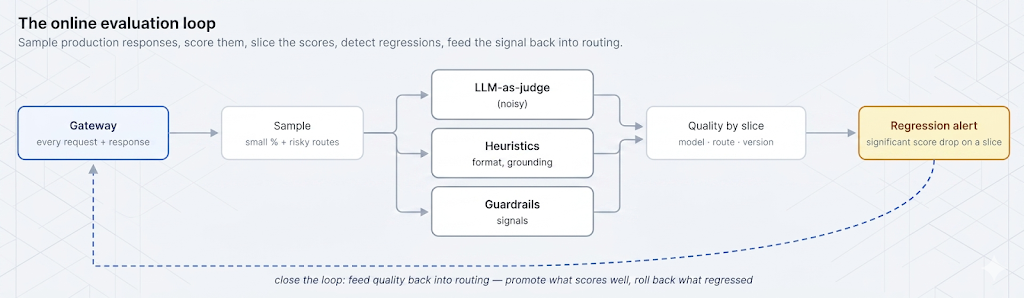
Offline evaluatie voert een vaste testset uit tegen een model of prompt voordat je deze live zet — een gecureerde set van invoeren met bekende goede antwoorden of rubrieken, gescoord in CI. Het is essentieel, maar niet voldoende. Een statische testset bevat alleen de gevallen waar je aan hebt gedacht; productieverkeer bevat de gevallen waar je niet aan dacht, plus distributiedrift naarmate het gebruikersgedrag en de wereld veranderen. Leena's goedkopere model slaagde voor de offline test juist omdat de testset niet leek op de rommelige 'long tail' van de live supportroute.
Online evaluatie scoort echt productieverkeer, achteraf, op basis van een steekproef. Het vangt op wat offline mist: de randgevallen buiten je testset, geleidelijke drift en regressies veroorzaakt door elke wijziging in het live systeem. De twee vullen elkaar aan — offline is je controle vóór de vlucht op bekende gevallen, online is je continue instrument op de werkelijkheid. Dit bericht richt zich op online, omdat dat het gat is waardoor een regressie van twee weken onopgemerkt kon blijven.
Er zijn drie praktische manieren om een getal aan een respons te koppelen, en meestal combineer je ze. Heuristieken zijn goedkope, deterministische controles: is de output gecodeerd als geldige JSON, citeert het een bron wanneer dat hoort, valt het binnen een logische lengte, bevat het een weigering. Guardrail-signalen hergebruiken de detectors van eerder in deze reeks — een PII-treffer, een toxiciteitsvlag, een injection-detector die afgaat op de output zijn allemaal ook kwaliteitssignalen. En LLM-as-judge gebruikt een model om een respons te scoren op basis van een rubriek, wat de enige van de drie is die open kwaliteiten zoals behulpzaamheid, getrouwheid of toon kan beoordelen.
LLM-as-judge scorer met een expliciete rubriek (ter illustratie)
Scoren brengt eigen kosten en latentie met zich mee — Een LLM-as-judge gebruikt een LLM tool om een respons te scoren op basis van een rubriek, wat de enige van de drie is die open kwaliteiten zoals behulpzaamheid, getrouwheid of toon kan beoordelen. Het antwoord is sampling, met een dosis statistische eerlijkheid. Een kleine willekeurige fractie van elke route geeft je een onbevooroordeelde schatting van de algehele kwaliteit; gerichte sampling verhoogt het percentage op de routes die je het meest dierbaar zijn — hoog volume, hoog risico of recent gewijzigd. Omdat je schat op basis van een steekproef, bevat elk kwaliteitsgetal een mate van onzekerheid, en kan een kleine steekproef op een route met laag volume veranderen om redenen die niets te maken hebben met een werkelijke wijziging.
Asynchroon steekproeven nemen en scoren, buiten het kritieke pad (ter illustratie)
Twee principes houden dit betrouwbaar: voer scoring asynchroon uit zodat het nooit latentie toevoegt aan het antwoord voor de gebruiker, en rapporteer kwaliteit samen met de steekproefgrootte zodat een ruisgevoelig segment met laag volume niet wordt aangezien voor een trend. Sampling verandert een onbetaalbaar "score alles" in een betaalbaar, statistisch valide instrument.
Eén enkel globaal kwaliteitsgetal is vrijwel nutteloos voor een diagnose — het kan je niet vertellen dat één route is verslechterd terwijl al het andere gelijk bleef. Kwaliteit moet op dezelfde manier worden opgesplitst als kosten in ons bericht over kostentoewijzing: per model, per route, per promptversie en per elke andere dimensie die door een wijziging kan beïnvloed. Die opsplitsingssleutels zijn precies de metadata die de gateway al aan elke request koppelt, wat de reden is waarom kwaliteit thuishoort naast kosten en latentie in plaats van in een afzonderlijk systeem.
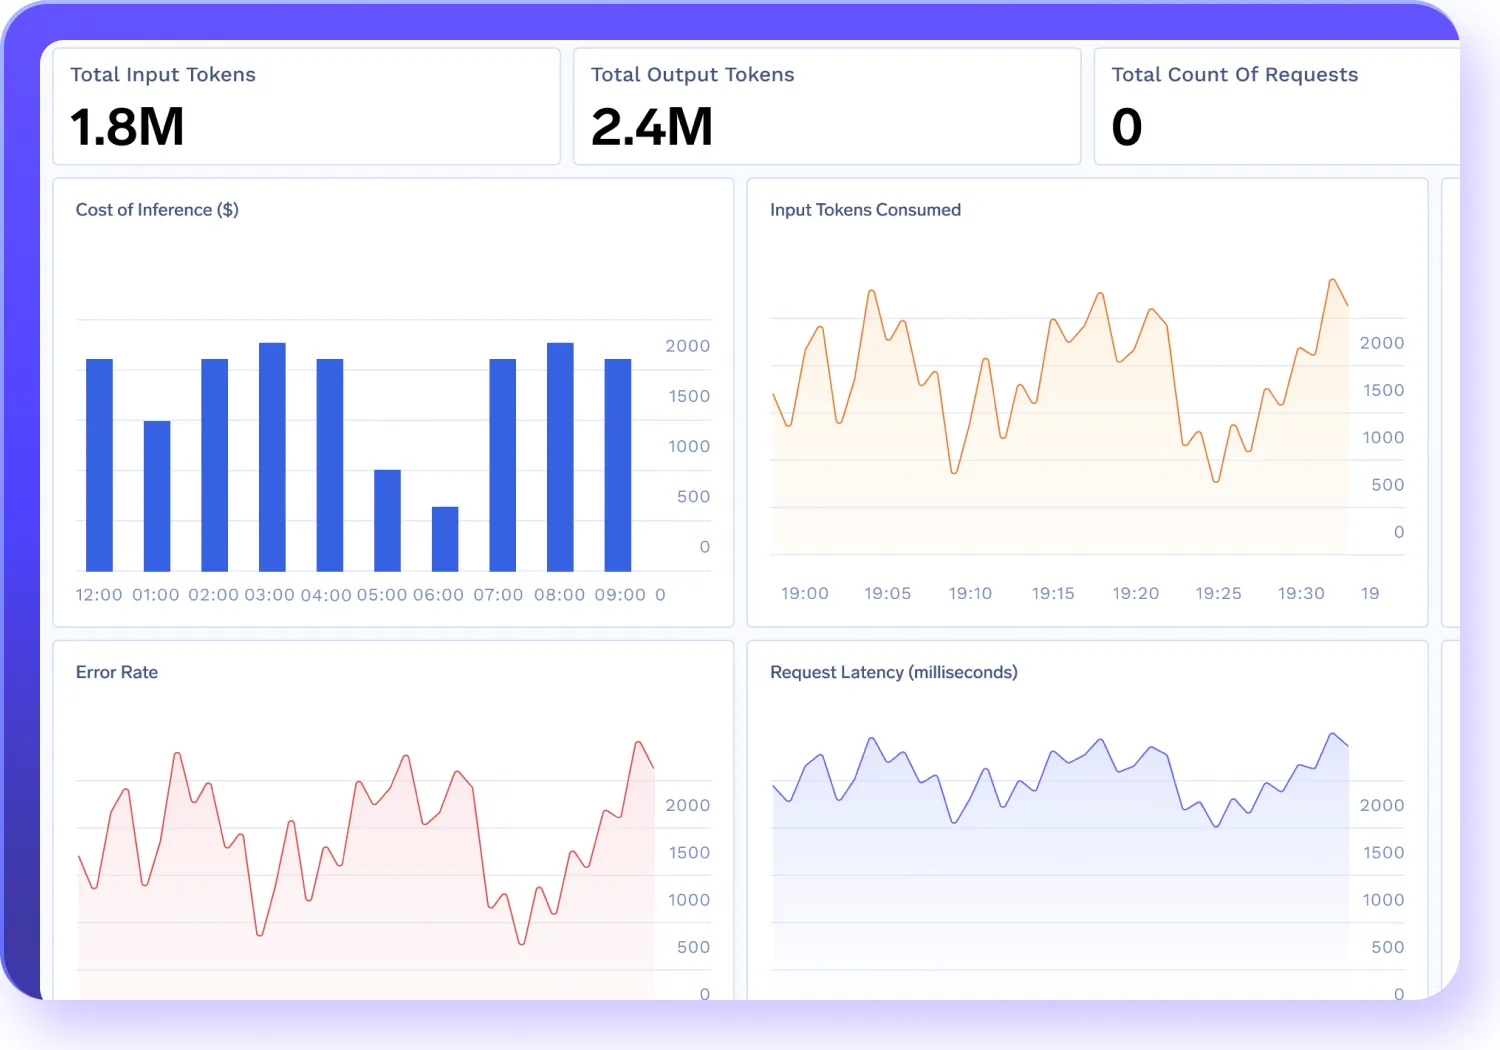
Kwaliteit op dezelfde assen plaatsen als kosten en latentie maakt de afweging zichtbaar in plaats van verborgen. Leena's wijziging zou direct zichtbaar zijn geweest als een kwaliteitsdaling op één route, op de dag dat ze het live zette, direct naast de kostendaling die ze vierde — de twee getallen die altijd samen gelezen moeten worden. TrueFoundry's AI Gateway biedt het observability-fundament — request/response-logs, metadata-tagging, tracing, kosten, latentie en routingcontext, opgesplitst per model, team en metadata — waar deze scoring zich aan koppelt. De hier beschreven judge-en-score-cirkel is een architectuurpatroon dat je bouwt bovenop die telemetrie, tenzij het is aangesloten via een specifieke evaluatie-integratie; online evaluatie is wat de kwaliteitsschatting toevoegt aan signalen die de gateway al verzamelt.
Concreet is de eenheid die online evaluatie genereert een scoring-event dat is gekoppeld aan de oorspronkelijke respons. Een werkbaar minimumschema ziet er als volgt uit — deze velden maken het verschil tussen een actiegericht signaal en een misleidend signaal:
Het opsplitsen van kwaliteit maakt regressiedetectie mogelijk: je vergelijkt de kwaliteitsschatting op een segment vóór en na een wijziging — een nieuw model op een route, een promptaanpassing, een update van het routingbeleid — en slaat alarm wanneer deze meer daalt dan de ruismarge. Omdat de scores zijn gebaseerd op steekproeven en ruis bevatten, moet de vergelijking rekening houden met onzekerheid: een daling binnen de steekproefmarge is geen regressie, en een klein segment heeft een grotere of langere steekproef nodig voordat je de verandering kunt vertrouwen.
Een segment vergelijken over een wijziging heen, rekening houdend met steekproefruis (ter illustratie)
De winst zit in de timing. Een regressiecontrole op de juiste segmenten veranderde Leena's periode van twee weken in een melding op dezelfde dag: op het moment dat de kwaliteitsschatting van de supportroute meer dan de ruismarge onder de nullijn daalt, krijgt iemand een melding — lang voordat de escalaties het aan het licht zouden hebben gebracht. Of je automatisch terugdraait (auto-roll-back) of alleen een melding stuurt, is een afweging die afhangt van hoeveel vertrouwen je hebt in het signaal op dat segment, en dat is precies waarom de kalibratie uit sectie 3 van belang is.
De reden om kwaliteit bij de gateway te meten, in plaats van in een afzonderlijke analyse-pipeline, is dat de gateway ook de plek is waar routingbeslissingen worden genomen — zodat het signaal de beslissing kan sturen. Ons bericht over routing beschreef kwaliteitsbewuste routing als een ambitie die een kwaliteitssignaal nodig heeft om werkelijkheid te worden; online evaluatie is dat signaal. Met kwaliteitsscores per segment in de hand is routing niet langer een statische gok, maar een feedback-loop: promoot een goedkoper model op een route alleen zolang de gemeten kwaliteit gehandhaafd blijft, en waarschuw of draai terug wanneer dat niet zo is — wat van de twee afhangt van het risico van de route en hoeveel je het signaal op dat segment vertrouwt.
Dat sluit de cirkel die in de inleiding open bleef. Leena's kostenbesparende wijziging is precies het soort beslissing dat afhankelijk gemaakt zou moeten worden van een live kwaliteitssignaal: voer het goedkopere model in, volg de kwaliteitsschatting op die route en behoud de besparing alleen zolang de kwaliteit binnen de tollerantie blijft. De gateway is de enige plek die zowel de responsen ziet om te scoren als de routingbeslissing neemt om aan te passen, wat het de juiste thuisbasis maakt voor deze cirkel in plaats van alleen voor de meting.
Niet alle evaluaties horen op één plek thuis, en het is goed om precies te zijn over de verdeling. Offline evaluatie woont in CI, tegen vaste testsets, en blokkeert deployments bij bekende gevallen. Evaluatie op applicatieniveau woont in de app wanneer het scoren context nodig heeft die de gateway niet heeft — domein-ground-truth, zakelijke resultaten, of de taak van de gebruiker daadwerkelijk is geslaagd. Online evaluatie op gateway-niveau woont bij de gateway voor het domeinoverschrijidende signaal: een gestreekproefde, opgesplitste kwaliteitsschatting op live verkeer, gekoppeld aan de kosten- en latentietelemetrie, die de routing aanstuurt.
De gateway vervangt de andere twee niet; het vult het gat op dat ze achterlaten — continue, consistente kwaliteitsmonitoring over al het verkeer, op de ene plek die zowel responsen kan observeren als kan handelen op routing. Dat is de rol die deze hele reeks aan de gateway toeschrijft: het domeinoverschrijidende controlevlak, hier toegepast op het signaal dat het moeilijkst te meten is en er het meest toe doet.
Waarom is offline evaluatie niet genoeg?
Omdat een vaste testset alleen de gevallen bevat die je van tevoren had bedacht. Productie heeft de 'long tail' die je niet had voorzien, plus drift in de loop van de tijd, plus regressies van elke live wijziging. Leena's goedkopere model slaagde voor de offline test en verslechterde toch in productie, omdat de testset niet leek op het echte supportverkeer. Offline is je controle vóór de vlucht; online is je continue instrument op de werkelijkheid. Je hebt ze beide nodig.
Kan ik een LLM vertrouwen om een andere LLM te beoordelen?
Als een trendsignaal, mits gekalibreerd — niet als absolute waarheid. Judgemodellen hebben vooringenomenheden (lengte, zelfvoorkeur, positie) en zijn niet volkomen consistent. Kalibreer de judge dus tegen door mensen gelabelde voorbeelden om te leren hoe goed het menselijke oordelen volgt voor jouw taak, bekijk de trend van de scores over de tijd en over segmenten in plaats van te handelen op een enkele score, en geef een release niet vrij uitsluitend op basis van een ongekalibreerde judge. Het is een nuttig, maar onvolmaakt instrument.
Wat had het probleem in de inleiding kunnen voorkomen?
Een gestreekproefde kwaliteitsscore op de supportroute, opgesplitst per model en promptversie, met een regressiecontrole ten opzichte van de nullijn van vóór de wijziging. Op de dag dat Leena van model wisselde, zou de kwaliteitsschatting van de route zijn gedaald naast de kostendaling, en zou de regressiewaarschuwing zijn afgegaan — waardoor een blinde vlek van twee weken veranderde in een signaal op dezelfde dag. De kostenbesparing was niet de fout; het live zetten zonder een kwaliteitssignaal was dat wel.
Hoeveel verkeer moet ik scoren?
Genoeg om het segment waarin je geïnteresseerd bent statistisch betekenisvol te laten zijn, wat afhangt van het volume en hoe groot de wijziging is die je wilt detecteren. Een kleine willekeurige basismeting over alle routes plus een hoger gericht percentage op routes met een hoog risico of recent gewijzigde routes is een verstandige standaard. Rapporteeer kwaliteit altijd met de steekproefgrootte, en wees sceptisch over veranderingen op segmenten met een laag volume totdat de steekproef groot genoeg is om te vertrouwen.
Gateway of applicatie voor online evaluatie?
Beide, voor verschillende signalen. De gateway beheert het domeinoverschrijidende signaal — gestreekproefde kwaliteit op live verkeer, opgesplitst en gekoppeld aan kosten en latentie, wat de routing aanstuurt — omdat het elke respons ziet en de routingbeslissing neemt. De applicatie beheert evaluatie die context nodig heeft die de gateway mist, zoals de vraag of de daadwerkelijke taak van de gebruiker is geslaagd. Ze vullen elkaar aan en concurreren niet.
De drie gemakkelijke signalen zullen altijd de signalen zijn die je als eerste meet, omdat de infrastructuur ze aanreikt. Kwaliteit is het signaal waar je zelf een meting voor moet bouwen — door responsen te steekproeven, ze eerlijk te scoren, de scores op te splitsen en te letten op regressies. Bouw dat signaal bij de gateway, waar de responsen en de routingbeslissingen zich al bevinden, en de volgende kostenbesparende wijziging die stilzwijgend de kwaliteit aantast wordt een melding op dezelfde dag in plaats van een raadsel van twee weken.
Northwind en Leena zijn ter illustratie, evenals de getoonde kwaliteits- en drempelwaarden. LLM-as-judge is een ruisgevoelige schatter met bekende vooringenomenheden en is geen absolute waarheid; de beschreven scores moeten worden gekalibreerd tegen menselijke labels en als trend worden bekeken in plaats van als een definitief oordeel, en online evaluatie vermindert blinde vlekken zonder kwaliteit te garanderen. Functionaliteiten van TrueFoundry zijn samengevat uit openbare productdocumentatie per juni 2026 en kunnen veranderen. Codevoorbeelden zijn ter illustratie van de beschreven patronen en niet gekopieerd uit een referentie-implementatie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















