



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het bijhouden van experimenten is een cruciaal onderdeel van de ontwikkeling van machine learning. Het stelt professionals in staat om de voortgang van hun experimenten efficiënt te beheren en te volgen. Bij het bijhouden van experimenten worden verschillende factoren geregistreerd en gemonitord, zoals modelprestaties, hyperparameter-instellingen en trainingsdata, om inzicht te krijgen in de prestaties van het machine learning-model.
Het beheren van experimenten en het bijhouden van resultaten kan een uitdagende taak zijn voor machine learning-engineers vanwege de complexiteit van de modellen, de grote hoeveelheden data en de verscheidenheid aan tools en frameworks die bij ML-ontwikkeling worden gebruikt. Hier zijn enkele van de belangrijkste uitdagingen bij het beheren van experimenten en het bijhouden van resultaten:
Weights & Biases (W&B) is een platform dat is ontworpen om machine learning-engineers te helpen hun experimenten effectief te beheren en bij te houden. Het biedt een reeks tools voor het bijhouden, visualiseren en samenwerken aan experimenten, waardoor het eenvoudiger wordt om robuuste en schaalbare machine learning-modellen te ontwikkelen.
De belangrijkste functies en voordelen van het W&B-platform zijn:
Het instellen van W&B voor het bijhouden van experimenten omvat de volgende stappen:
wandb.init() aan te roepen. Deze functie initialiseert de W&B-library en start een nieuwe run.wandb.log() aan te roepen. Deze functie accepteert een dictionary van metrics en logt deze naar het W&B-dashboard.wandb.config. Deze functie accepteert een dictionary van hyperparameters en logt deze naar het W&B-dashboard.wandb.log() aan te roepen met de gewenste visualisatiedata. W&B biedt een breed scala aan visualisatietools, waaronder 3D-visualisaties, confusion matrices en scatter plots.Hier is een voorbeeld van het loggen van metrics, modellen, hyperparameters en visualisaties met W&B:
import wandb
import numpy as np
import matplotlib.pyplot as plt
import tensorflow as tf

# Step 1: Initialize W&B
wandb.init(project="my-project")

# Step 2: Log hyperparameters
config = {
    "learning_rate": 0.001,
    "batch_size": 32,
    "epochs": 10
}
wandb.config.update(config)

# Step 3: Train model and log metrics
model = tf.keras.models.Sequential([
    tf.keras.layers.Dense(10, activation='relu', input_shape=(10,)),
    tf.keras.layers.Dense(1)
])
model.compile(optimizer=tf.keras.optimizers.Adam(config['learning_rate']),
              loss=tf.keras.losses.MeanSquaredError(),
              metrics=[tf.keras.metrics.MeanAbsoluteError()])
for epoch in range(config['epochs']):
    # ... train model ...
    history = model.fit(x_train, y_train, batch_size=config['batch_size'])
    loss = history.history['loss'][-1]
    mae = history.history['mean_absolute_error'][-1]
    wandb.log({"epoch": epoch, "loss": loss, "mae": mae})

# Step 4: Log visualizations and model
x = np.linspace(0, 10, 100)
y = np.sin(x)
fig, ax = plt.subplots()
ax.plot(x, y)
wandb.log({"my_plot": wandb.Image(fig)})
wandb.save('my_model.h5')

# Step 5: Finish run
wandb.finish()
c
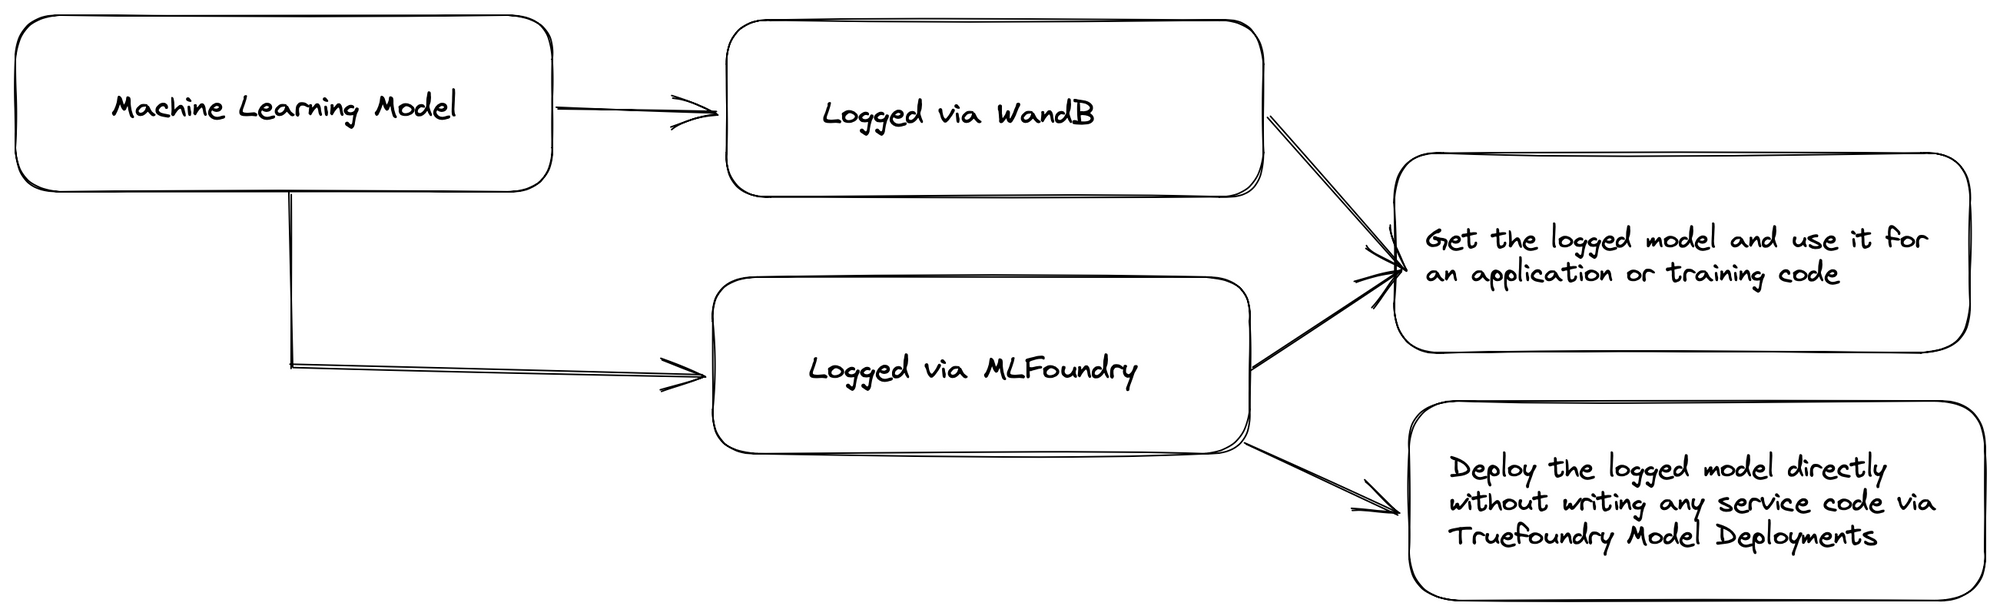
TrueFoundry integreert naadloos met de Weights & Biases Model Registry, waardoor u modellen die zijn gelogd in Weights & Biases direct kunt deployen naar uw Kubernetes Cluster via TrueFoundry.
📌
Naast het gebruik van Weights & Biases voor modelbeheer en experiment tracking, kunt u ook TrueFoundry's eigen Experimentation Tracking-tool MLFoundry gebruiken.
📌
U kunt de onderstaande code ook meevolgen via dit Colab notebook:
Colab Notebook
Stap 1 - Installatie en configuratie:
pip install wandb -qU
import wandb
wandb.login()
pip install -U "servicefoundry"
sfy login
Stap 2 - Train en log het model:
We gebruiken eerst wandb.init() om het project te initialiseren
Vervolgens trainen we ons ML-model en slaan we dit op als een joblib-bestand
Daarna slaan we het joblib-bestand op in wandb via wandb.save()
import wandb
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import joblib

# Initialize W&B
wandb.init(project="iris-logistic-regression")

# Load and preprocess the data
X, y = load_iris(as_frame=True, return_X_y=True)
X = X.rename(columns={
        "sepal length (cm)": "sepal_length",
        "sepal width (cm)": "sepal_width",
        "petal length (cm)": "petal_length",
        "petal width (cm)": "petal_width",
})

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Initialize the model
clf = LogisticRegression(solver="liblinear")

# Fit the model
clf.fit(X_train, y_train)

# Evaluate the model
preds = clf.predict(X_test)

# Log the model and the evaluation metrics to W&B
joblib.dump(clf, "model.joblib")
wandb.save("model.joblib")

# Finish the run
wandb.finish()
Stap 3 - Maak een inference-applicatie en dependency-bestand aan:
Om op TrueFoundry te deployen maken we twee bestanden aan: een app.py-bestand met onze applicatiecode en een requirements.txt-bestand met onze dependencies.
.
├── app.py
├── deploy.py
└── requirements.txt
c
wandb.restore() : <name_of_saved_file> en "username/project/run_id"wandb.restore("model.joblib", "adityajha-tfy/iris-logistic-regression/00r5xvyv")import os
import wandb
import joblib
import pandas as pd
from fastapi import FastAPI
wandb.login(key=os.environ["WANDB_API_KEY"])
# Retrieve the model from W&B
model_joblib = wandb.restore(
'model.joblib',
run_path="adityajha-tfy/iris-logistic-regression/00r5xvyy",
)
model = joblib.load(model_joblib.name)
# Load the model
app = FastAPI(root_path=os.getenv("TFY_SERVICE_ROOT_PATH"))
@app.post("/predict")
def predict(
sepal_length: float, sepal_width: float, petal_length: float, petal_width: float
):
data = dict(
sepal_length=sepal_length,
sepal_width=sepal_width,
petal_length=petal_length,
petal_width=petal_width,
)
prediction = int(model.predict(pd.DataFrame([data]))[0])
return {"prediction": prediction}
fastapi
joblib
numpy
pandas
scikit-learn
uvicorn
wandb
Stap 4 - Gebruik de TrueFoundry Python SDK en configureer de deployment
import argparse
import logging
from servicefoundry import Build, PythonBuild, Service, Resources, Port

# Setup the logger
logging.basicConfig(level=logging.INFO)

# Setup the argument parser
parser = argparse.ArgumentParser()
parser.add_argument("--workspace_fqn", required=True, type=str)
parser.add_argument("--wandb_api_key", required=True, type=str)
args = parser.parse_args()

service = Service(
    name="fastapi",
    image=Build(
        build_spec=PythonBuild(
            command="uvicorn app:app --port 8000 --host 0.0.0.0",
            requirements_path="requirements.txt",
        )
    ),
    ports=[
        Port(
            port=8000,
            host="ml-deploy-aditya-ws-8000.demo.truefoundry.com",
        )
    ],
    resources=Resources(
        cpu_request=0.25,
        cpu_limit=0.5,
        memory_request=200,
        memory_limit=400,
        ephemeral_storage_request=200,
        ephemeral_storage_limit=400,
    ),
    env={
        "WANDB_API_KEY": args.wandb_api_key
    }
)
service.deploy(workspace_fqn=args.workspace_fqn)
Stap 5 - Deploy uw Service via TrueFoundry
Voer het volgende commando uit en geef uw gegevens mee:
python deploy.py --workspace_fqn "<Your Workspace FQN>" --wandb_api_key "<Your Wandb API Key>"
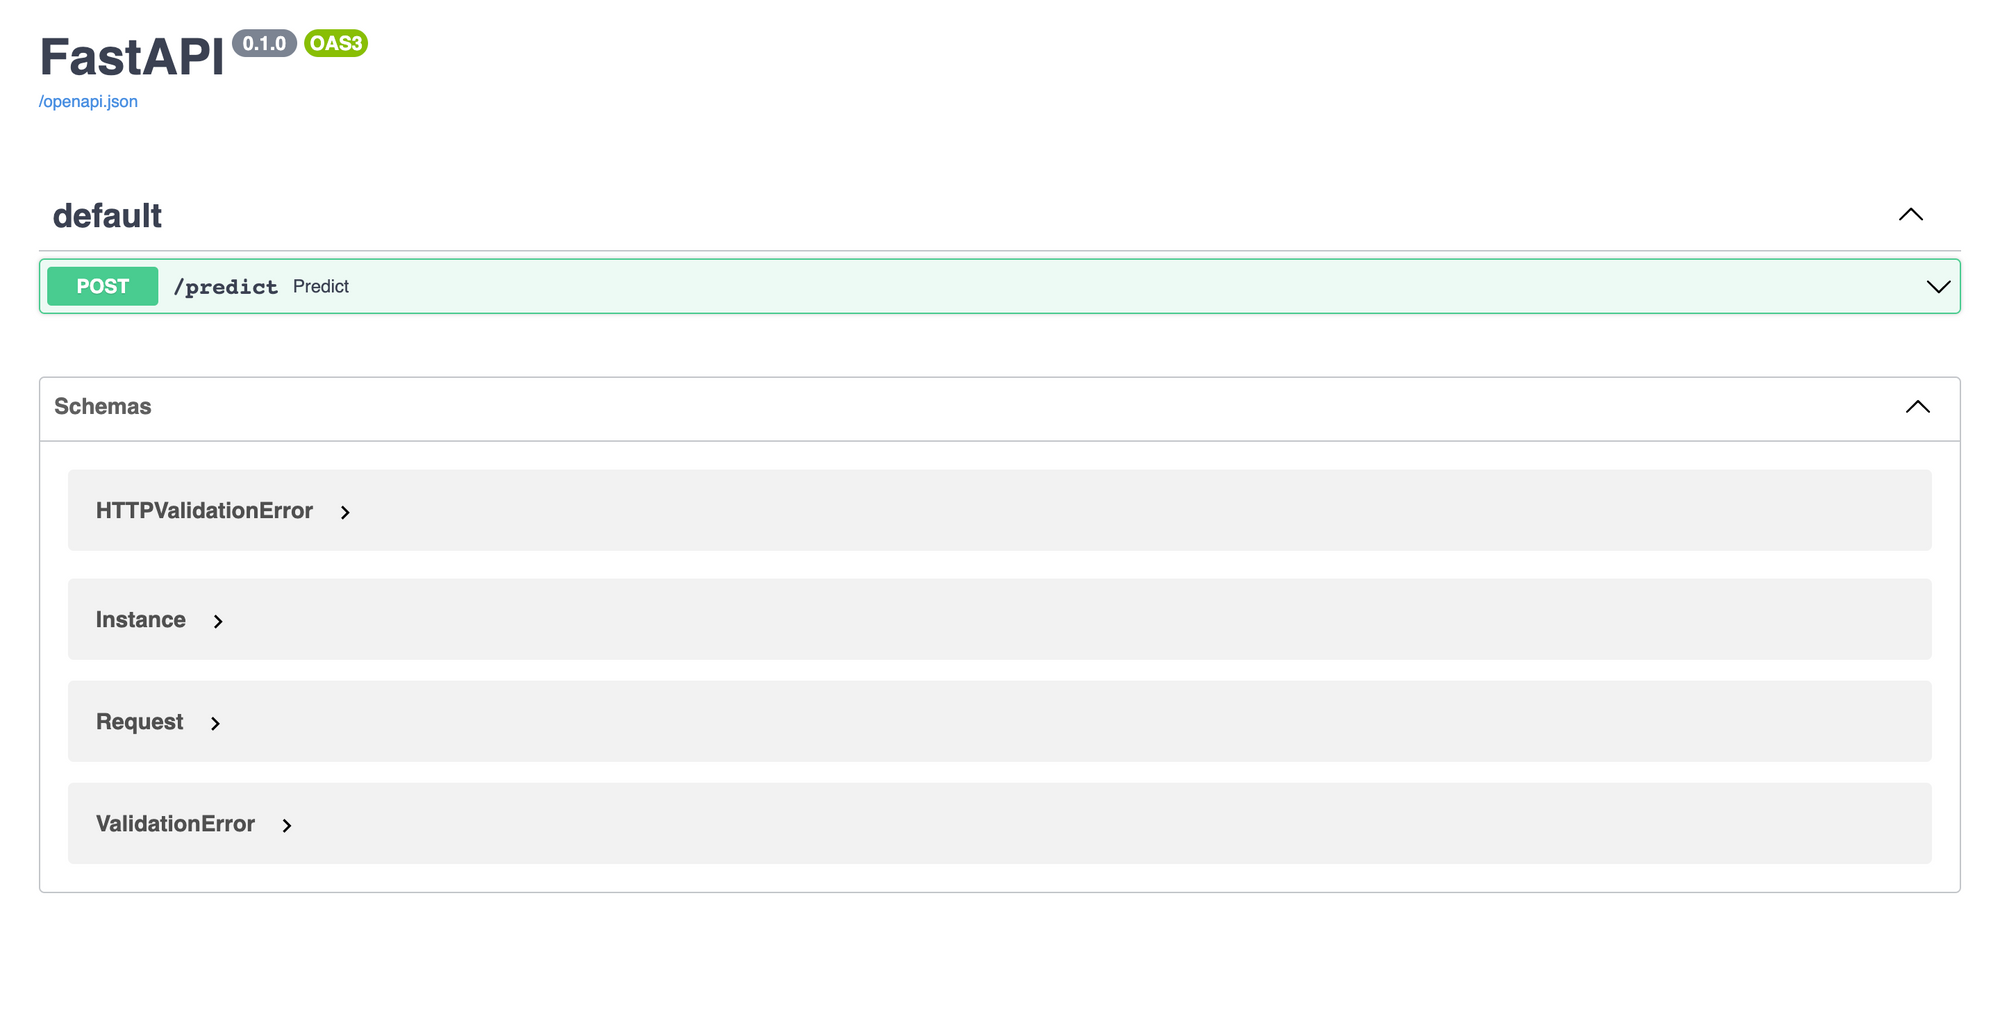
En voilà! In de logs vindt u het dashboard van uw gedeployde service. Rechtsboven vindt u het endpoint van uw gedeployde applicatie.
TrueFoundry is een ML Deployment PaaS op Kubernetes om developer workflows te versnellen, terwijl ontwikkelaars de volledige flexibiliteit behouden bij het testen en deployen van modellen met gegarandeerde beveiliging en controle voor het infrastructuurteam. Via ons platform stellen we Machine Learning-teams in staat om modellen binnen 15 minuten te deployen en te monitoren met 100% betrouwbaarheid, schaalbaarheid en de mogelijkheid om binnen enkele seconden te roll-backen. Dit helpt kosten te besparen en modellen sneller naar productie te brengen, wat leidt tot echte zakelijke waarde.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























