



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Elk tijdperk van enterprise software ontwikkelt een laag die secundair lijkt totdat operationele beslissingen zich daar ophopen. In het client-server-tijdperk was dat vaak de applicatieserver; in het cloudtijdperk de container-orchestrator; in het datatijdperk de pipeline-scheduler. Het patroon is niet dat het gevierde onderdeel verdwijnt, maar dat een steeds groter deel van de operationele differentiatie verschuift naar de machine die het uitvoert. Voor AI-agents heeft die machine een naam. De documentatie van TrueForge definieert de agent harness helder: “de runtime-laag rond een LLM die het verandert in een betrouwbare, langdurig draaiende agent.” Veel van de operationele ervaring die een onderneming met een agent heeft — of een run een herstart overleeft, of een geconfigureerde actie met hoog risico wacht op een mens, of werkcontext wordt gecompacteerd of uitbesteed, of code binnen een sandbox wordt uitgevoerd, en of een fout achteraf kan worden gereconstrueerd — krijgt vorm in die runtime-laag, in de executionsloop tussen het model en de wereld. We noemen de discipline van het ontwerpen van die cyclus loop engineering, en de gepubliceerde benchmark bevat de metingen. Dit artikel bevat er bewust geen. In plaats daarvan maakt het het strategische argument: nu de modelkeuze voor een toenemende reeks workloads verplaatsbaarder wordt, lijkt de loop steeds meer op middleware omdat deze beslissingen rond persistentie, context, goedkeuring, isolatie en observeerbaarheid concentreert. Open standaarden en open-source implementaties werden strategisch belangrijk in verschillende eerdere middleware-categorieën; die geschiedenis is de context voor, en niet het bewijs van, het besluit van TrueFoundry om zijn eigen harness als open-source vrij te geven.
Een model is een capaciteit; een loop is een plek waar beleid kan worden afgedwongen. Het onderscheid wordt concreet wanneer u opsomt wat de loop bij elke ronde bemiddelt. Of een geconfigureerde tool-call die naar een productiesysteem schrijft doorgaat of pauzeert — de capability-tabel van TrueForge vermeldt zijn versie in zes woorden: “Pauzeer vóór schrijf/destructieve MCP-tools.” Of de sessiestatus reconnects en herstarts overleeft — de harness-documentatie maakt dat een runtime-eigenschap in plaats van een promptinstructie. Of gegenereerde code harness-credentials kan zien — het sandbox-ontwerp van TrueForge bewaart geheimen in de harness en levert compute alleen wanneer dat nodig is. Of een lange taak context trimt of uitbesteedt; of een gedelegeerde subtaak zijn eindresultaat retourneert in plaats van zijn gehele werktranscript — dit zijn ook runtime-keuzes. Geen van deze wordt betrouwbaar afgedwongen door modelgedrag alleen. Elk is een operationele beslissing die een organisatie consistent toegepast wil zien, en dat is een reden waarom de loop op middleware begint te lijken: het is de plek waar operationele intentie herhaalbaar gedrag kan worden. Het is de moeite waard om de vertaaltabel in zijn geheel te bekijken, omdat het patroon het argument vormt:
Loop-beslissingen stapelen zich anders op dan promptinstructies omdat runtime-beleid elke stap deterministisch kan bemiddelen. Verander waar compactie plaatsvindt, en elke langdurige taak die die runtime gebruikt, kan de verandering erven. Voeg een goedkeuringsgrens toe, en een klasse van risicovolle acties vereist nu een expliciete autorisatiestap in plaats van alleen te vertrouwen op gedragsdiscipline; verkeerde configuratie, omzeilingen en slechte goedkeuringen blijven nog steeds mogelijk. Het mechanisme is bekend uit de middleware — definieer een controle eenmalig, pas deze consistent toe — en het verklaart waarom de aandacht van senior engineering verschuift naar de runtime. Prompt engineering vraagt wat er tegen het model moet worden gezegd. Context engineering vraagt wat er aan moet worden getoond. Loop engineering vraagt wat het systeem doet tussen model-calls, en die vraag hoort net zo goed thuis bij platform- en security engineering als bij prompt-auteurs.
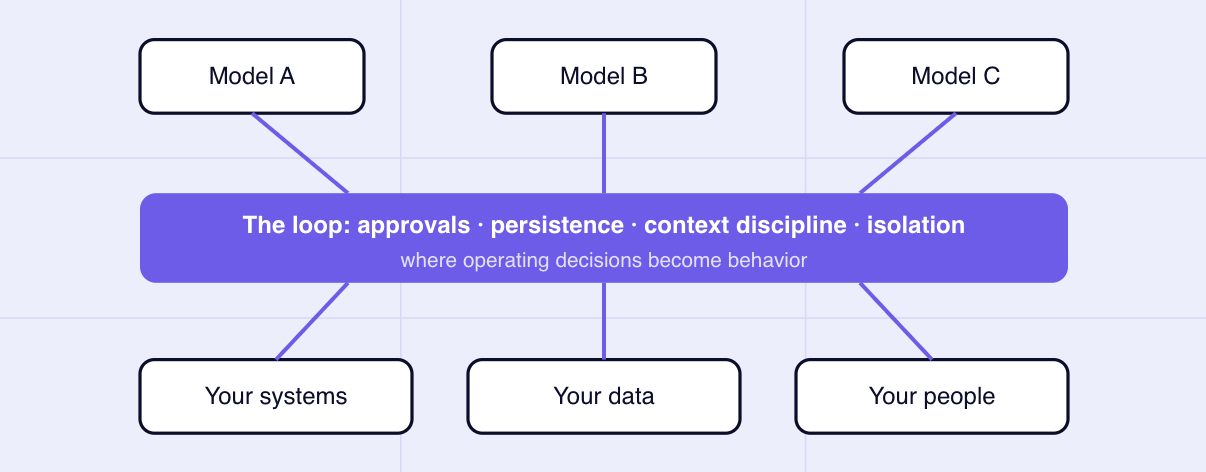
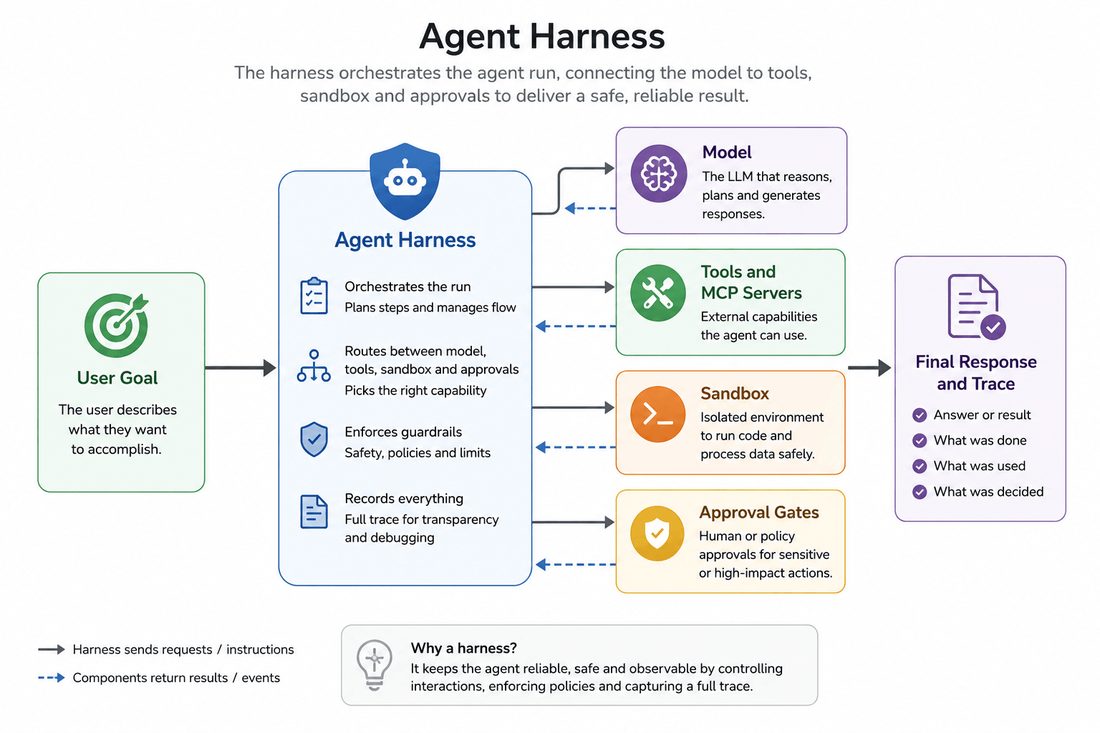
Als de loop de plek is waar uw operationele oordeel leeft, is de volgende vraag ongemakkelijk: hoe inspecteerbaar en overdraagbaar is deze? Het historische overzicht is gemengd, wat precies is waarom de nuttige les nauwer is dan “middleware wordt altijd open-source”. Enterprise applicatieservers bevatten nog steeds belangrijke propriëtaire producten naast open standaarden en open implementaties. Container-orchestratie daarentegen convergeerde sterk rond open-source Kubernetes, en workflow-scheduling heeft invloedrijke open-source systemen zoals Apache Airflow naast beheerde alternatieven. Het terugkerende patroon is geen onvermijdelijkheid; het is dat zodra een operationele laag strategisch belangrijk wordt, ondernemingen vaak waarde hechten aan open interfaces, beschikbaarheid van broncode, portabiliteit en de mogelijkheid om de laag op hun eigen voorwaarden uit te voeren of te vervangen. Een oordeelslaag heeft er baat bij controleerbaar te zijn omdat het oordeel van u is.
De agent loop kan een deel van die boog volgen, en het argument voor openheid is concreet in plaats van ideologisch. Beschikbaarheid van broncode maakt audits op implementatieniveau mogelijk; het bewijst op zichzelf niet dat een geïnstalleerd binair bestand betrouwbaar of correct geconfigureerd is. Een runtime die self-hosting ondersteunt, kan de uitvoeringslaag binnen uw eigen grenzen plaatsen. Een uitbreidbare open implementatie kan teams in staat stellen om compactie, checkpointing of integratiegedrag te wijzigen zonder te wachten op de roadmap van een leverancier. En openbare runtime-semantiek kan de overstapfrictie verminderen, hoewel echte portabiliteit nog steeds afhangt van datastructuren, integraties, externe diensten en operationele praktijken. Dit is de context voor de eigen stap van TrueFoundry: TrueForge is vrijgegeven onder de MIT-licentie met zijn runtime in het openbaar (repository), ondersteunt lokale en gehoste werking, behandelt modellen, MCP-servers en sandbox-providers als verbonden afhankelijkheden, en documenteert zijn gedrag openbaar op trueforge.dev. We hebben het uitgebreidere argument afzonderlijk gemaakt in Waarom agent harnesses open moeten zijn; de strategische samenvatting past op één regel.
De middleware-ondervraging, in zes vragen: Overleeft werk een herstart? Wat kan de code-executieomgeving zien? Welke acties pauzeren voor een mens — door de runtime, of door hoop? Laadt capaciteit op aanvraag of reist deze elke ronde mee? Kan een run worden gereconstrueerd uit de sporen ervan? En als u morgen bij uw runtime-leverancier zou vertrekken, wat zou u dan precies verliezen?
Die zes verdienen toelichting, omdat het verschil tussen een goed en een slecht antwoord architecturaal is, niet retorisch — en dit is de ondervraging die we op elke agent runtime zouden toepassen, inclusief de onze. Continuïteit: als het proces halverwege de taak stopt, kan de sessiestatus dan worden hervat of verdwijnt het werk? Inperking: wanneer de agent code uitvoert, wat kan die omgeving dan zien? Eén verdedigbaar patroon houdt harness-credentials buiten de sandbox; TrueForge documenteert deze scheiding en levert sandbox-compute alleen wanneer dat nodig is. Toestemming: welke acties pauzeren voor een mens, en wordt dat afgedwongen door runtime-beleid of slechts gevraagd in een prompt? Menselijke goedkeuring is een mitigatie, geen bewijs dat schadelijke acties onmogelijk zijn. Zuinigheid: laadt de runtime capaciteit op aanvraag — tool-definities en skills gematerialiseerd wanneer ze worden aangeraakt, zoals de harness capabilities beschrijven — of draagt elke agent de hele catalogus bij elke ronde mee? Leesbaarheid: wanneer er iets misgaat, kunt u dan de stappen die de runtime daadwerkelijk heeft geregistreerd reconstrueren en ze correleren met downstream logs? En portabiliteit: als u morgen zou moeten vertrekken bij uw runtime-leverancier, welke code, status, integraties en operationele praktijken zouden dan met u mee verhuizen? Een loop die deze vragen goed beantwoordt, gedraagt zich als infrastructuur. Een loop die ze alleen beantwoordt met een roadmap hoort thuis op het risicoregister.
Het stille voordeel van het stellen van deze vragen aan de hand van openbare documentatie is dat de antwoorden controleerbaar zijn. Elke bewerking in dit artikel over het gedrag van TrueForge is een citaat naar de gepubliceerde documentatie, geen karakterisering ervan — en waar het bewijs kwantitatief wordt, hebben we het bewust uit dit essay gehouden en geplaatst waar de methodologie erbij kan blijven: de benchmarkpagina. Strategieartikelen moeten argumenteren; cijfers moeten aankomen met hun foutmarges.
De werkhouding is dus: behandel de loop als een middleware-beslissing. Maak een inventarisatie van de operationele oordelen die uw agents momenteel afdwingen — en de oordelen die ze slechts beogen. Vraag waar elk oordeel leeft: in een prompt die modelgedrag beïnvloedt, in deterministisch beleid, of in een runtime waarvan u de implementatie en het exitpad wel of niet beheerst. Eerdere infrastructuurtijdperken bewijzen niet dat agent runtimes open source moeten worden, maar ze tonen wel de waarde aan van draagbare interfaces en operationele praktijken wanneer onderliggende leveranciers veranderen. De loop verdient dezelfde vooruitziendheid.
Eerst de onthulling: TrueFoundry publiceert dit essay, verkoopt de TrueFoundry AI Gateway en onderhoudt TrueForge, de open-source (MIT) agent harness die hierin wordt besproken — de stelling voor open runtime-lagen is er een waar we belang bij hebben, die hier met dat belang zichtbaar wordt gemaakt. Over de methode: dit is opzet een strategie-essay — het bevat geen prestatiecijfers, en lezers die bewijs zoeken, moeten de gepubliceerde benchmark en onze empirische loop-engineering-analyse raadplegen, waar cijfers verschijnen met hun reikwijdte en beperkingen. Alle uitspraken over het gedrag van TrueForge zijn geciteerd of nauwgezet geparafraseerd uit openbare documentatie op trueforge.dev, waarnaar bij elke claim wordt gelinkt; de historische analogieën met applicatieservers, orchestrators en schedulers zijn redactionele interpretatie, aangeboden als patroon in plaats van bewijs; en de middleware-kadering en de zesvragen-ondervraging zijn onze redactionele bijdragen. "Loop engineering" zet de woordenschat van onze eerdere serie voort, gelinkt in Referenties. Geen enkele vermelde derde partij beoordeelt of ondersteunt TrueFoundry.
TrueFoundry publiceert deze analyse, verkoopt de TrueFoundry AI Gateway en onderhoudt TrueForge (MIT). Dit essay bevat opzettelijk geen prestatie- of kosten-cijfers; kwantitatieve claims staan op de gelinkte benchmark en analyse, inclusief methodologie. Productgedrag is geciteerd uit openbare documentatie op trueforge.dev met links bij elke claim. De middleware-kadering, historische analogieën en leiderschapsvragen zijn redactioneel. Diagrammen zijn originele TrueFoundry-afbeeldingen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















