



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Elke AI Gateway op de markt biedt logs en analytics. Op het eerste gezicht lijken ze een standaard functionaliteit. Maar de architecturale keuzes die achter de schermen worden gemaakt, hebben enorme, verborgen consequenties voor je betrouwbaarheid, beveiliging en het eindresultaat. Het hoe is een cruciaal detail dat een echt enterprise-grade platform onderscheidt van een risicovol voorstel.
Toen we ons er voor het eerst toe zetten om onze klanten van snelle, schaalbare analytics te voorzien, stonden we voor precies deze uitdaging. Het doel was helder: krachtige inzichten leveren via onze AI Gateway-laag zonder een operationele nachtmerrie te creëren voor de platformteams van onze klanten.
We realiseerden ons al snel dat we, om een oplossing te bouwen die onze enterprise-klanten waardig is, verder moesten innoveren dan de industriestandaard aanpak. Deze blogpost beschrijft onze reis van het krachtige maar problematische ClickHouse naar een onderhoudsvrije, S3-native architectuur—een systeem dat onze klanten een krachtig en duurzaam concurrentievoordeel geeft.
Onze initiële keuze was, net als bij vele anderen in de sector, ClickHouse. Het is een fenomenaal stuk open-source technologie, bekend om zijn ongelooflijke snelheid bij analytische queries. De kracht ervan brengt echter hoge operationele kosten met zich mee.
Het kernprobleem is dit: het beheren van een stateful, missiekritieke database zoals ClickHouse binnen de cloudomgeving van een klant is een operationeel mijnenveld. Om het goed te doen, moet je het volgende afhandelen:
Dit is niet alleen theoretisch. Een enkel, verkeerd kubectl delete pv commando zou per ongeluk het persistent volume van een klant kunnen wissen, waarmee al hun historische logs en metrics-data voorgoed verloren gaan. Voor elke enterprise is dit risiconiveau simpelweg onacceptabel. We werden in feite een beheerde ClickHouse-leverancier, wat afleidde van onze kernmissie.
We hebben onderzoek gedaan en ontdekten dat de meeste platformen in de LLM Gateway-markt genoegen hebben genomen met een van de drie gebrekkige compromissen.
We hebben ze alle drie afgewezen. Er moest een manier zijn om prestaties, beveiliging én nul operationele last te leveren. Dus hebben we het gebouwd.
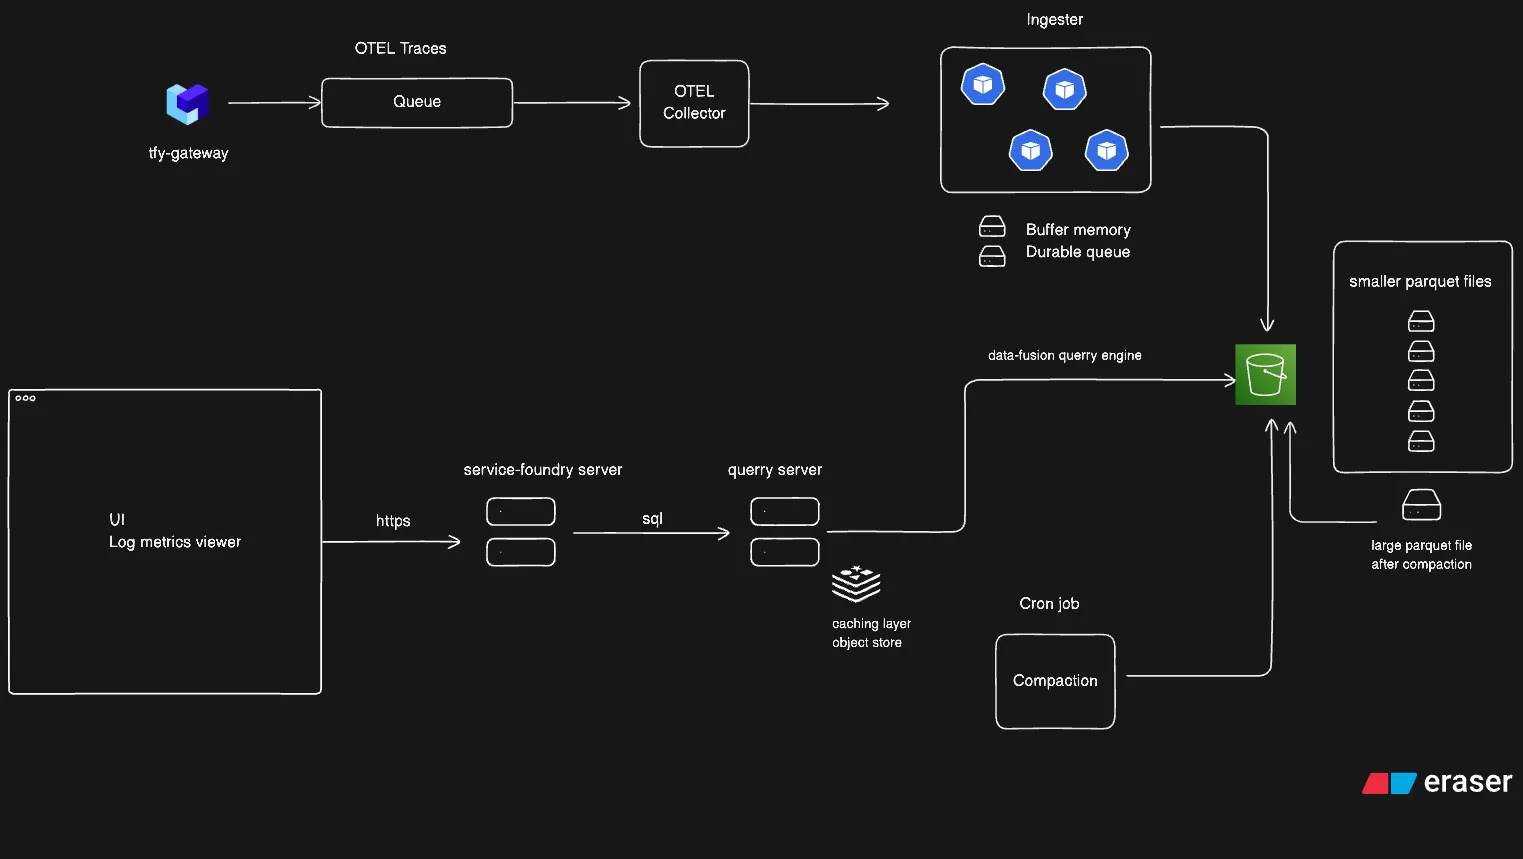
Ons leidende principe was eenvoudig maar krachtig: scheid opslag en compute. De data moet veilig en duurzaam in de eigen object storage van de klant staan (zoals S3), terwijl een stateless, schaalbare engine de queries afhandelt.

We hebben de databaseserver volledig geëlimineerd en de S3 bucket van de klant de 'source of truth' gemaakt.
We gebruiken DataFusion, een query engine van het Apache-project. Het is een moderne, stateless engine die Parquet-bestanden rechtstreeks vanuit S3 leest. Om de inherente netwerklatentie van S3 te overwinnen, hebben we een geavanceerde multi-level cachinglaag (in-memory en on-disk) gebouwd die 'hete' data gereedhoudt voor queries, wat een snelle en responsieve UI-ervaring oplevert.
Onze architectuur vertaalt zich in duidelijke, overtuigende waarde die direct invloed heeft op je organisatie.
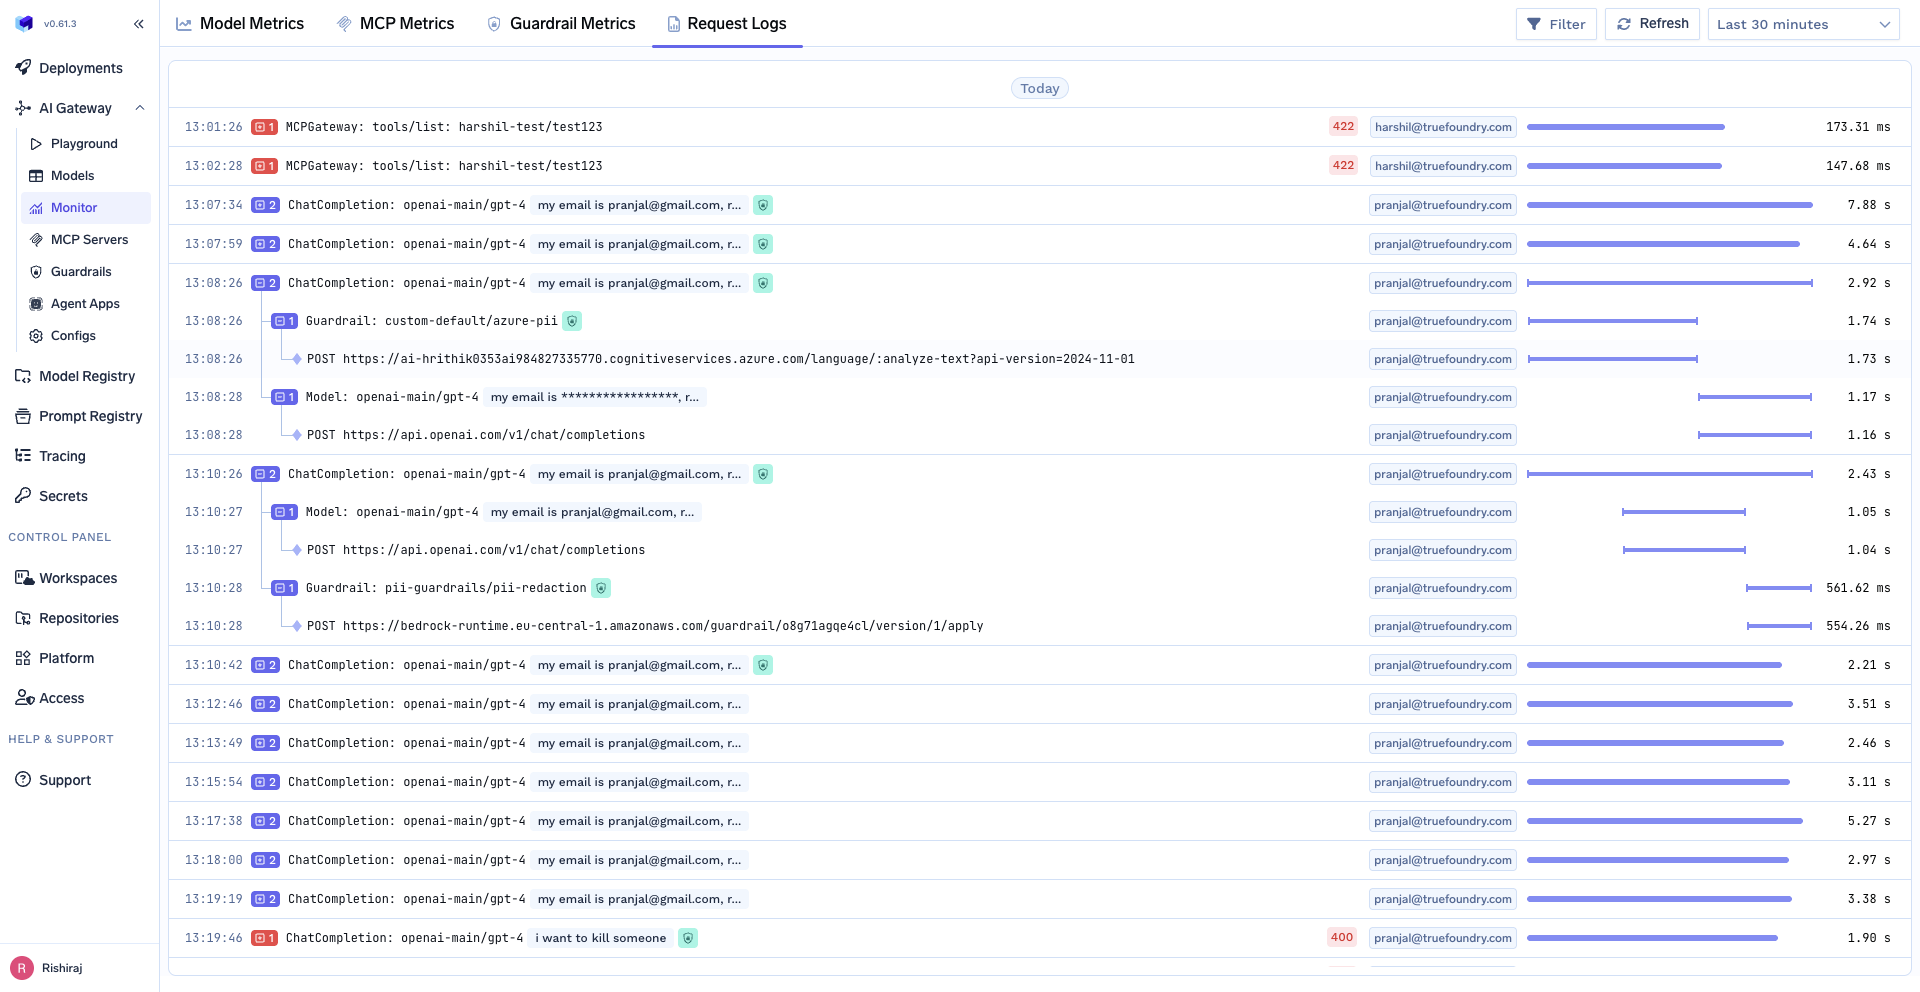
De reis om enterprise-ready analytics te bieden met onze AI Gateway zat vol met verleidelijke kortere wegen en gemakkelijke compromissen. We stonden voor een kritieke operationele uitdaging, wezen de standaardoplossingen in de markt af en ontwierpen vanaf de basis een superieure architectuur. Klaar om te zien hoe een echt onderhoudsvrije, veilige AI Gateway met een latentie van minder dan een milliseconde eruitziet? Plan vandaag nog een demo met ons.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























