April 16, 2024
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Benchmarks van leveranciers meten wat een model op zijn best kan presteren: volledige agent-harnesses, Docker-containers, gecureerde testsets. Dat is niet wat de meeste engineers daadwerkelijk moeten weten. De echte vraag is of het kwaliteitsverschil het prijsverschil op een productie-API-call rechtvaardigt.
We hebben MiniMax M3, Gemini 3.5 Flash en Claude Opus 4.8 getest via TrueFoundry AI Gateway op een Python-betalingsservice van 130 regels code met drie code-reviewtaken van toenemende moeilijkheidsgraad. De totale kosten voor alle negen calls: $ 0,067. Wat we vonden, was niet wat we hadden verwacht.
De codebase bevatte bewust ingebouwde problemen: een ontbrekende import time die de retry-logica bij de eerste rate-limit zou laten crashen, een hardcoded productie-API-sleutel, een mutable default argument in de charge-functie, geen idempotentie-sleutel bij retries en geen foutafhandeling in twee van de vier publieke functies.
Drie taken, geordend op moeilijkheidsgraad:
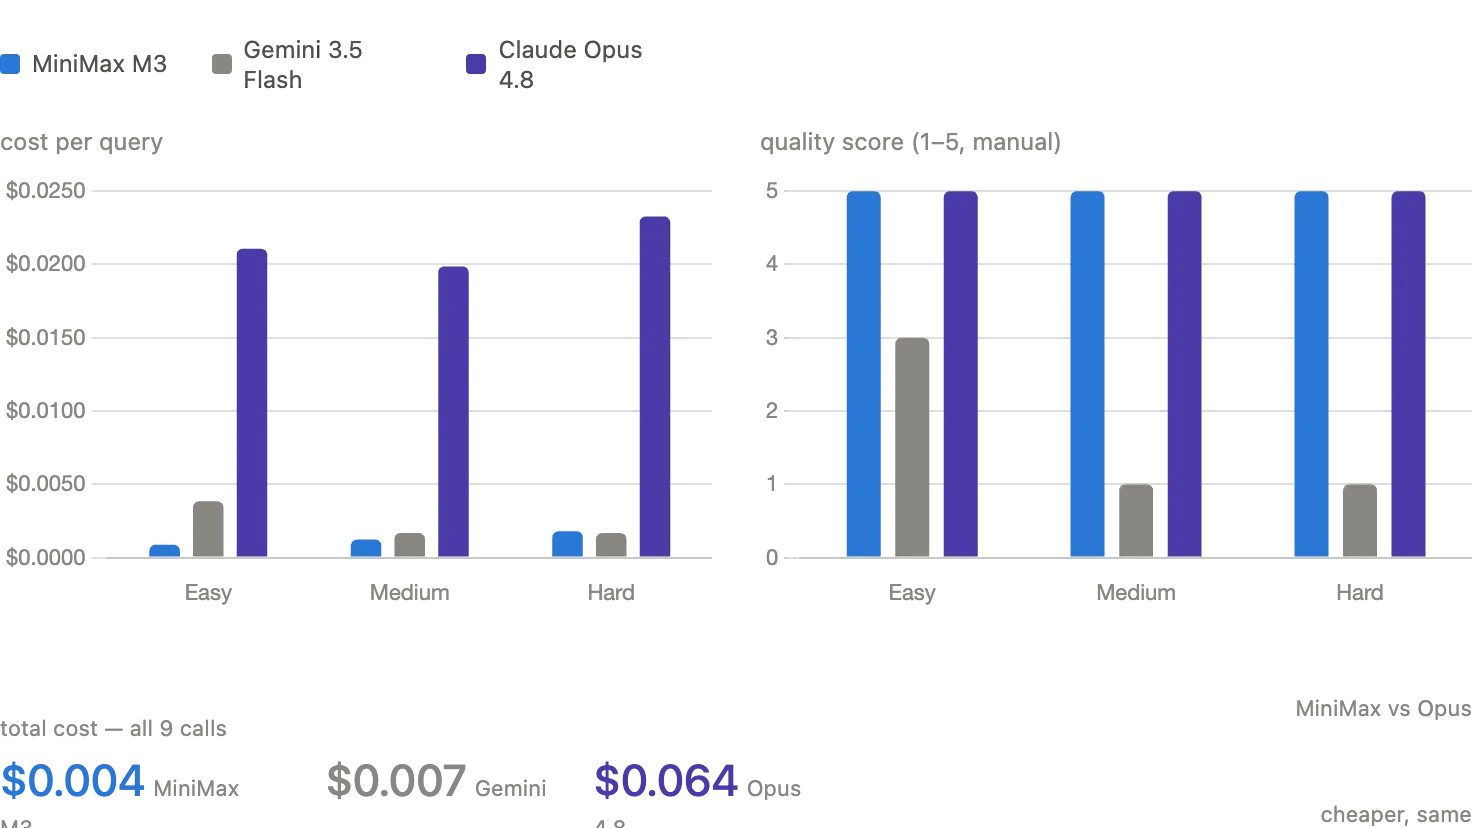
Alle negen calls verliepen via hetzelfde TrueFoundry AI Gateway-eindpunt. Hetzelfde basis-URL, dezelfde inloggegevens, een andere modelstring. We hebben elke reactie handmatig beoordeeld op een schaal van 1-5 na deze volledig te hebben gelezen, waarbij 5 betekende dat niet-voordehandliggende problemen werden opgemerkt en dat er toepasbare oplossingen werden geboden die specifiek waren voor deze codebase. Geen LLM-beoordelaar: een LLM-as-a-judge bij een code-reviewtaak bevoordeelt het model waarvan de outputstijl overeenkomt met de trainingsdata van de beoordelaar.
Gemini is aanzienlijk het snelst. MiniMax en Opus zijn vergelijkbaar qua latentie.
Wat opviel was de diepgang van de redenering, niet alleen het aantal gevonden problemen. Bij de gemiddelde taak merkte het niet alleen individuele bugs op — het achterhaalde hoe twee afzonderlijke problemen elkaar versterkten, waardoor wat leek op een crash veranderde in een stille fout die het verkeerde resultaat retourneert zonder dat er iets op wijst dat er iets misging. Bij de zware taak leverde het een concreet herontwerpplan op, geen lijst met problemen. Bij de eenvoudige taak ontdekte het een productiebug tijdens het beantwoorden van een vraag over de codestructuur.
Evenaarde MiniMax in alle drie de taken. Het ontdekte één probleem dat MiniMax miste: een beveiligingslek dat werd veroorzaakt doordat ongefilterde gebruikersinvoer rechtstreeks in een URL werd doorgegeven. Verschillende detectiepatronen, over het geheel genomen gelijkwaardige kwaliteit.
De reactie op de eenvoudige taak was correct maar algemeen. De reacties op de gemiddelde en zware taak waren ernstig onvolledig: gemiddeld begon halverwege een zin, zwaar eindigde halverwege een zinsdeel zonder afgeronde gedachte. Of dit nu het gevolg was van afgekapte streaming of een korte modelreactie, uw applicatie ontvangt een antwoord zonder foutmelding, maar mist het grootste deel van de inhoud. TrueFoundry Gateway registreert bij elke call het aantal output-tokens; dit is hoe u dit opmerkt voordat het de gebruikers bereikt.
MiniMax M3 evenaarde Opus tegen 16x lagere kosten ($ 0,00390 vs $ 0,06422 over negen calls). Bij 10.000 queries per dag op een context van 800 tokens bespaart het routen van standaardtaken naar MiniMax in plaats van Opus ongeveer $ 4.500/maand.
Voor taken waarbij een enkel gemist probleem asymmetrische gevolgen heeft (security-review, betalingslogica, compliance), gebruikt u Opus. De vondst van het path traversal-lek door Opus is het concrete voorbeeld uit deze test: MiniMax vond het niet, Opus wel. Bij een live betalingsservice is dat geen klein verschil.
Gebruik Gemini voor situaties waarin de volledigheid van de reactie verifieerbaar is: classificatie, intentiedetectie, samenvatten van korte documenten. Gebruik het niet zonder toezicht voor taken die een uitputtende output vereisen totdat het gedrag bij onvolledige reacties beter wordt begrepen.
Het instellen hiervan via TrueFoundry AI Gateway is één configuratiewijziging: een virtueel model met regels op basis van prioriteit dat de taak classificeert, naar de juiste tier meestuurt en automatisch terugvalt als een model niet beschikbaar is. De gateway verzorgt LLM routing over meer dan 1.000 modellen via één enkele OpenAI-compatibele API, voegt ongeveer 3-4 ms overhead toe bij 350+ RPS op een enkele vCPU en registreert de kosten en het aantal output-tokens per verzoek.
MiniMax M3 is geen budgetmodel met een mooi benchmarkverhaal. Op een echte codebase leverde het resultaten die niet te onderscheiden waren van Opus 4.8 tegen 16x lagere kosten. De bevinding over Gemini is even belangrijk: een model dat in stilte onvolledige reacties genereert, is in productie gevaarlijker dan een model dat simpelweg trager is, omdat u de fout niet kunt zien in uw applicatielogs.
De praktische vraag is niet welk model een benchmark wint. Het gaat erom welk routingbeleid de meeste waarde haalt uit de afweging tussen kosten en kwaliteit binnen uw werkelijke workload. Voer de benchmark uit op uw eigen codebase en bouw het beleid op basis van uw bevindingen.
Ontdek LLM routing op TrueFoundry AI Gateway
Wat is een LLM-modelvergelijking en hoe moeten teams er een uitvoeren?
Een LLM-modelvergelijking evalueert meerdere modellen op dezelfde taak onder dezelfde omstandigheden: dezelfde prompt, hetzelfde eindpunt, dezelfde evaluatierubriek. De meest nuttige vergelijkingen maken gebruik van taken uit uw eigen werkelijke workload. Routeer alle modellen via een gedeelde gateway om identieke infrastructuursituaties bij elke call te garanderen.
Hoe verhoudt MiniMax M3 zich tot Claude Opus 4.8 bij code-reviews?
Bij de drie taken die we hebben uitgevoerd, scoorde MiniMax M3 op alle drie een 5/5 en kostte het per query 16x minder dan Opus 4.8. Opus vond één extra probleem, een kwetsbaarheid voor URL path traversal, die MiniMax niet vond. Beide modellen identificeerden de idempotentiebug, het ontbrekende import-statement, het PII-loggingprobleem en het mutable default argument.
Wat is LLM routing en wanneer is het van belang?
LLM routing stuurt verzoeken naar verschillende modellen op basis van het type taak, de complexiteit, de kosten of de latentie-eisen, in plaats van alles naar één model te sturen. Het routen van eenvoudige taken naar goedkopere modellen, terwijl topmodellen bewaard blijven voor werk met een hoog risico, kan de LLM-uitgaven met 60-80% verlagen zonder kwaliteitsverlies in het minder complexe segment. TrueFoundry AI Gateway ondersteunt LLM routing van nature: u configureert een virtueel model met regels op basis van prioriteit en de gateway regelt automatisch de modelselectie, fallbacks en kostenbewaking.
Hoeveel latentie voegt TrueFoundry AI Gateway toe?
Ongeveer 3-4 ms overhead. De gateway verwerkt 350+ RPS op een enkele vCPU en is ontworpen om direct in het kritieke pad te staan zonder een bottleneck te worden.
Kan ik TrueFoundry in mijn eigen VPC implementeren?
Ja. TrueFoundry draait in uw VPC, on-premise, air-gapped, hybride of over meerdere clouds. Er verlaat geen data uw domein; dit is de belangrijkste reden waarom gereguleerde ondernemingen hiervoor kiezen in plaats van SaaS-only gateways.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox