Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
9,9
LLM-benchmarking voor enterprise-productie: Modellen evalueren voor uw specifieke usecase
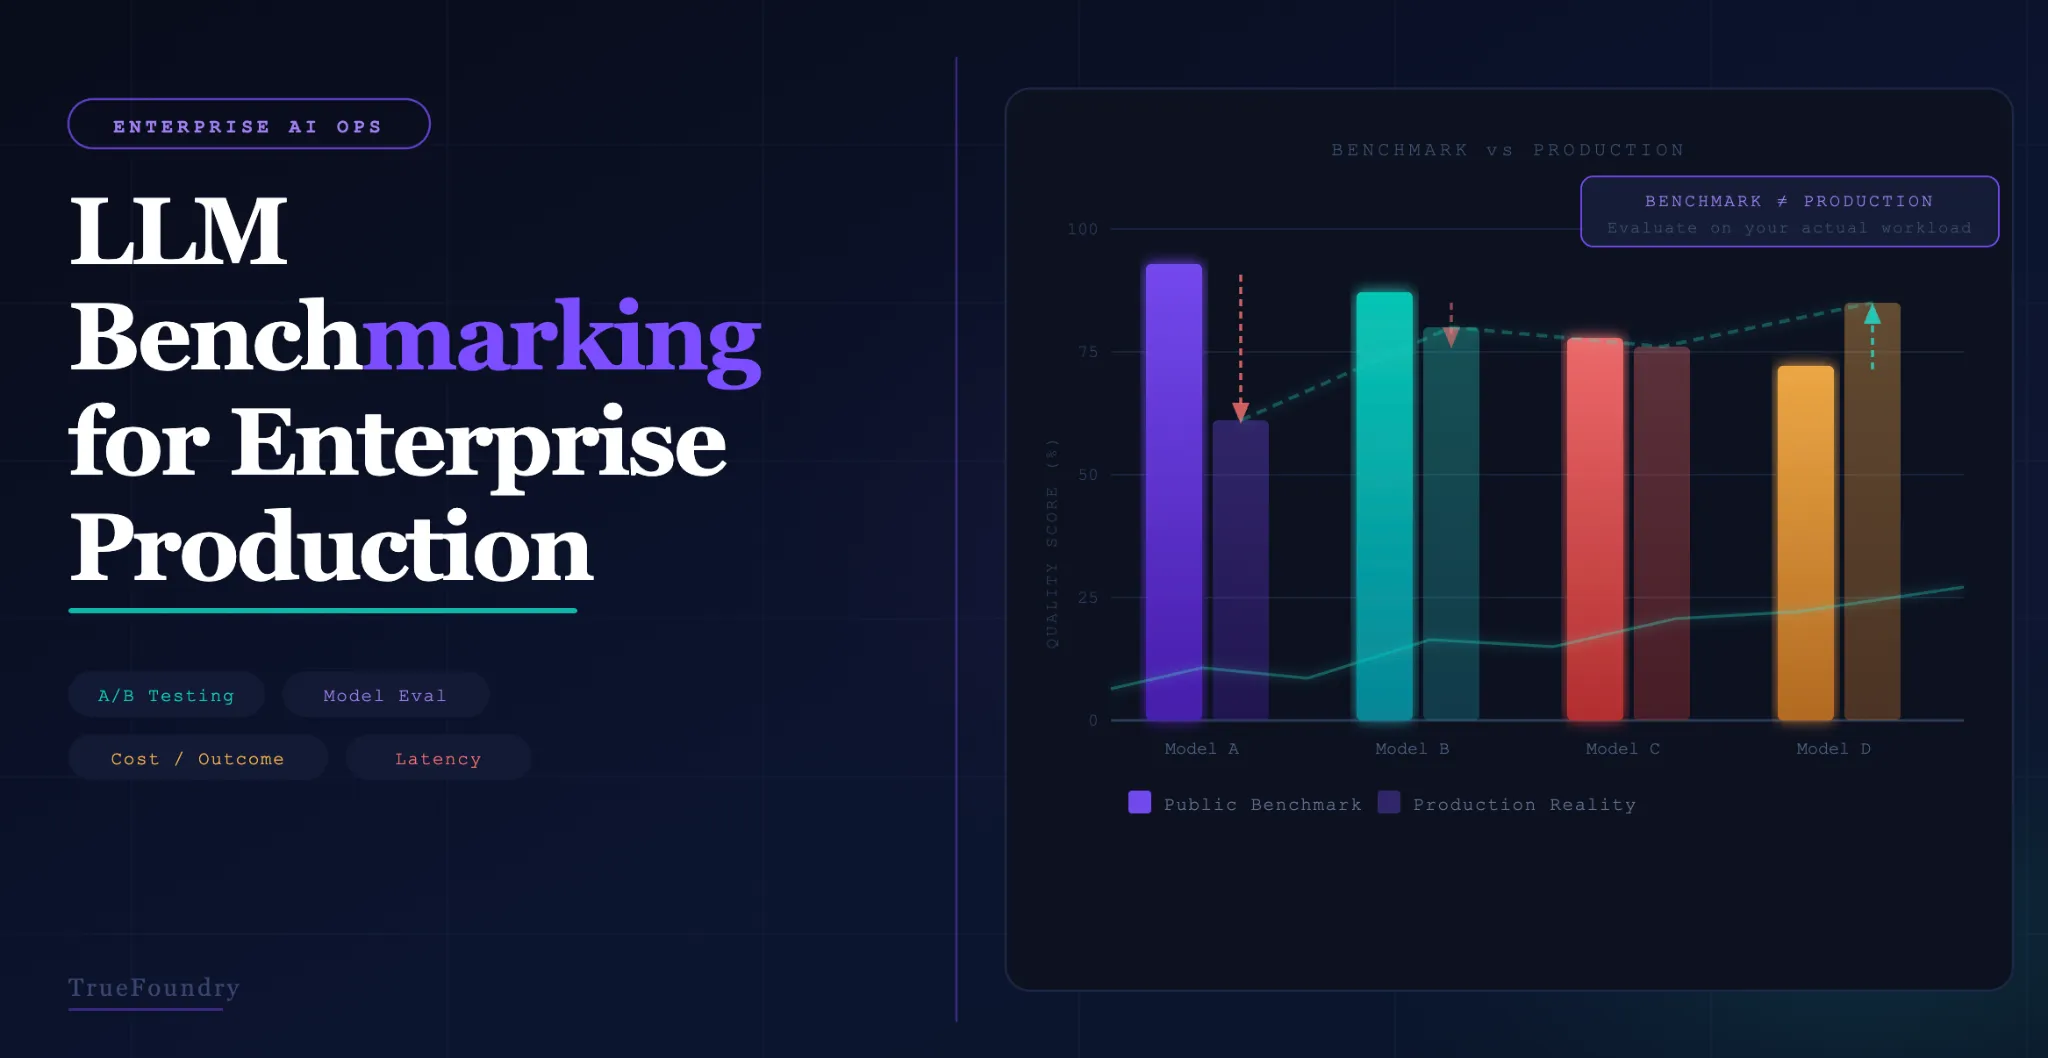
Publieke LLM-benchmarks meten waar AI-onderzoekers om geven: redeneervermogen op academisch niveau, codegeneratie bij canonieke problemen, kwaliteit van meertalige vertalingen. Handig voor het in kaart brengen van mogelijkheden in het abstracte. Maar vaak misleidend wanneer ze worden gebruikt voor inkoopbeslissingen in enterprise-omgevingen, omdat de benchmark een distributie van taken meet die waarschijnlijk vrijwel niets deelt met uw specifieke workload. Een model dat als eerste scoort op MMLU kan slechtere resultaten opleveren dan een goedkoper model bij uw workload voor het samenvatten van documenten, simpelweg omdat uw documenten andere kenmerken hebben dan de testset van de benchmark.
Kloof tussen de prestaties op publieke benchmarks en de prestaties in productie is geen klein kalibratieprobleem. Het is structureel. Benchmarks maken gebruik van gestandaardiseerde, schone data. Productiedata is rommelig. Domeinspecifiek. Volgens distributies die ontwerpers van benchmarks niet hadden voorzien. Benchmarks meten de nauwkeurigheid van canonieke taken. Productiesystemen moeten voldoen aan organisatorische vereisten voor de output-indeling, toon en consistentie die geen enkele publieke benchmark opvangt. En benchmarks zijn statische momentopnamen, terwijl de prestaties in productie veranderen naarmate modelproviders hun modellen bijwerken en uw datadistributie zich ontwikkelt.
Deze gids behandelt hoe u een enterprise LLM-evaluatieraamwerk opbouwt dat waardevolle signalen genereert voor beslissingen over modelselectie en -optimalisatie. Het behandelt de vier benchmarkdimensies die productieprestaties voorspellen, hoe u een testdataset samenstelt die uw daadwerkelijke workload weerspiegelt, hoe u A/B-tests uitvoert in productie zonder gebruikers te storen, en hoe u het wisselen van modellen automatiseert zodat de gateway voor elk verzoek naar het beste model routeert zonder tussenkomst van engineers. De AI Gateway van TrueFoundry maakt het eenvoudig om A/B-tests met verkeerssplitsing in productie te configureren en te monitoren.
Stop met gissen welk model het beste presteert voor uw usecase. Benchmark het in productie.
De AI Gateway van TrueFoundry beheert de verkeerssplitsing in productie, het loggen van resultaten en automatische rollback voor live A/B-tests van modellen. Boek een demo om te zien hoe u uw eerste benchmark uitvoert in minder dan 30 minuten.
Waarom publieke benchmarks onbetrouwbaar zijn voor enterprise-productiebeslissingen
Publieke benchmarkscores zijn de meest geciteerde, en meest misbruikte, gegevens bij de inkoop van enterprise LLM's. Ze duiken op in presentaties van leveranciers, nota's voor het bestuur en inkoop-spreadsheets. Ze worden behandeld als de absolute waarheid. Begrijpen waarom ze over het algemeen tekortschieten in het voorspellen van productieprestaties is de eerste vereiste om engineering-tijd te investeren in benchmark-gestuurde modelselectie.
Benchmarkbesmetting verhoogt de scores kunstmatig. Large language models worden getraind op enorme hoeveelheden internettekst, die in toenemende mate benchmarkvragen en -antwoorden bevat. Modellen die tijdens het trainen benchmarkinhoud hebben gezien, scoren hoger dan hun werkelijke vermogen op nieuwe data zou voorspellen. De mate van besmetting wordt zelden bekendgemaakt en is extern moeilijk te meten. Gepubliceerde scores behandelen als de absolute waarheid overdrijft het gat tussen de best gerangschikte modellen en vertelt u heel weinig over hoe ze met uw invoer zullen omgaan.
Academische taken komen niet overeen met enterprise-workloads. MMLU meet de prestaties op het gebied van kennisvragen op academisch niveau over 57 onderwerpen. HumanEval meet codegeneratie bij canonieke programmeerproblemen. Geen van beide meet waarvoor enterprise-teams daadwerkelijk modellen inzetten: gestructureerde gegevensextractie uit pdf's met inconsistente opmaak, het genereren van consistente JSON-output op basis van instructies in natuurlijke taal, het samenvatten van domeinspecifieke technische inhoud zonder hallucinatie van terminologie, het behouden van gesprekscontext over een interactie van 20 opeenvolgende berichten in de klantenservice.
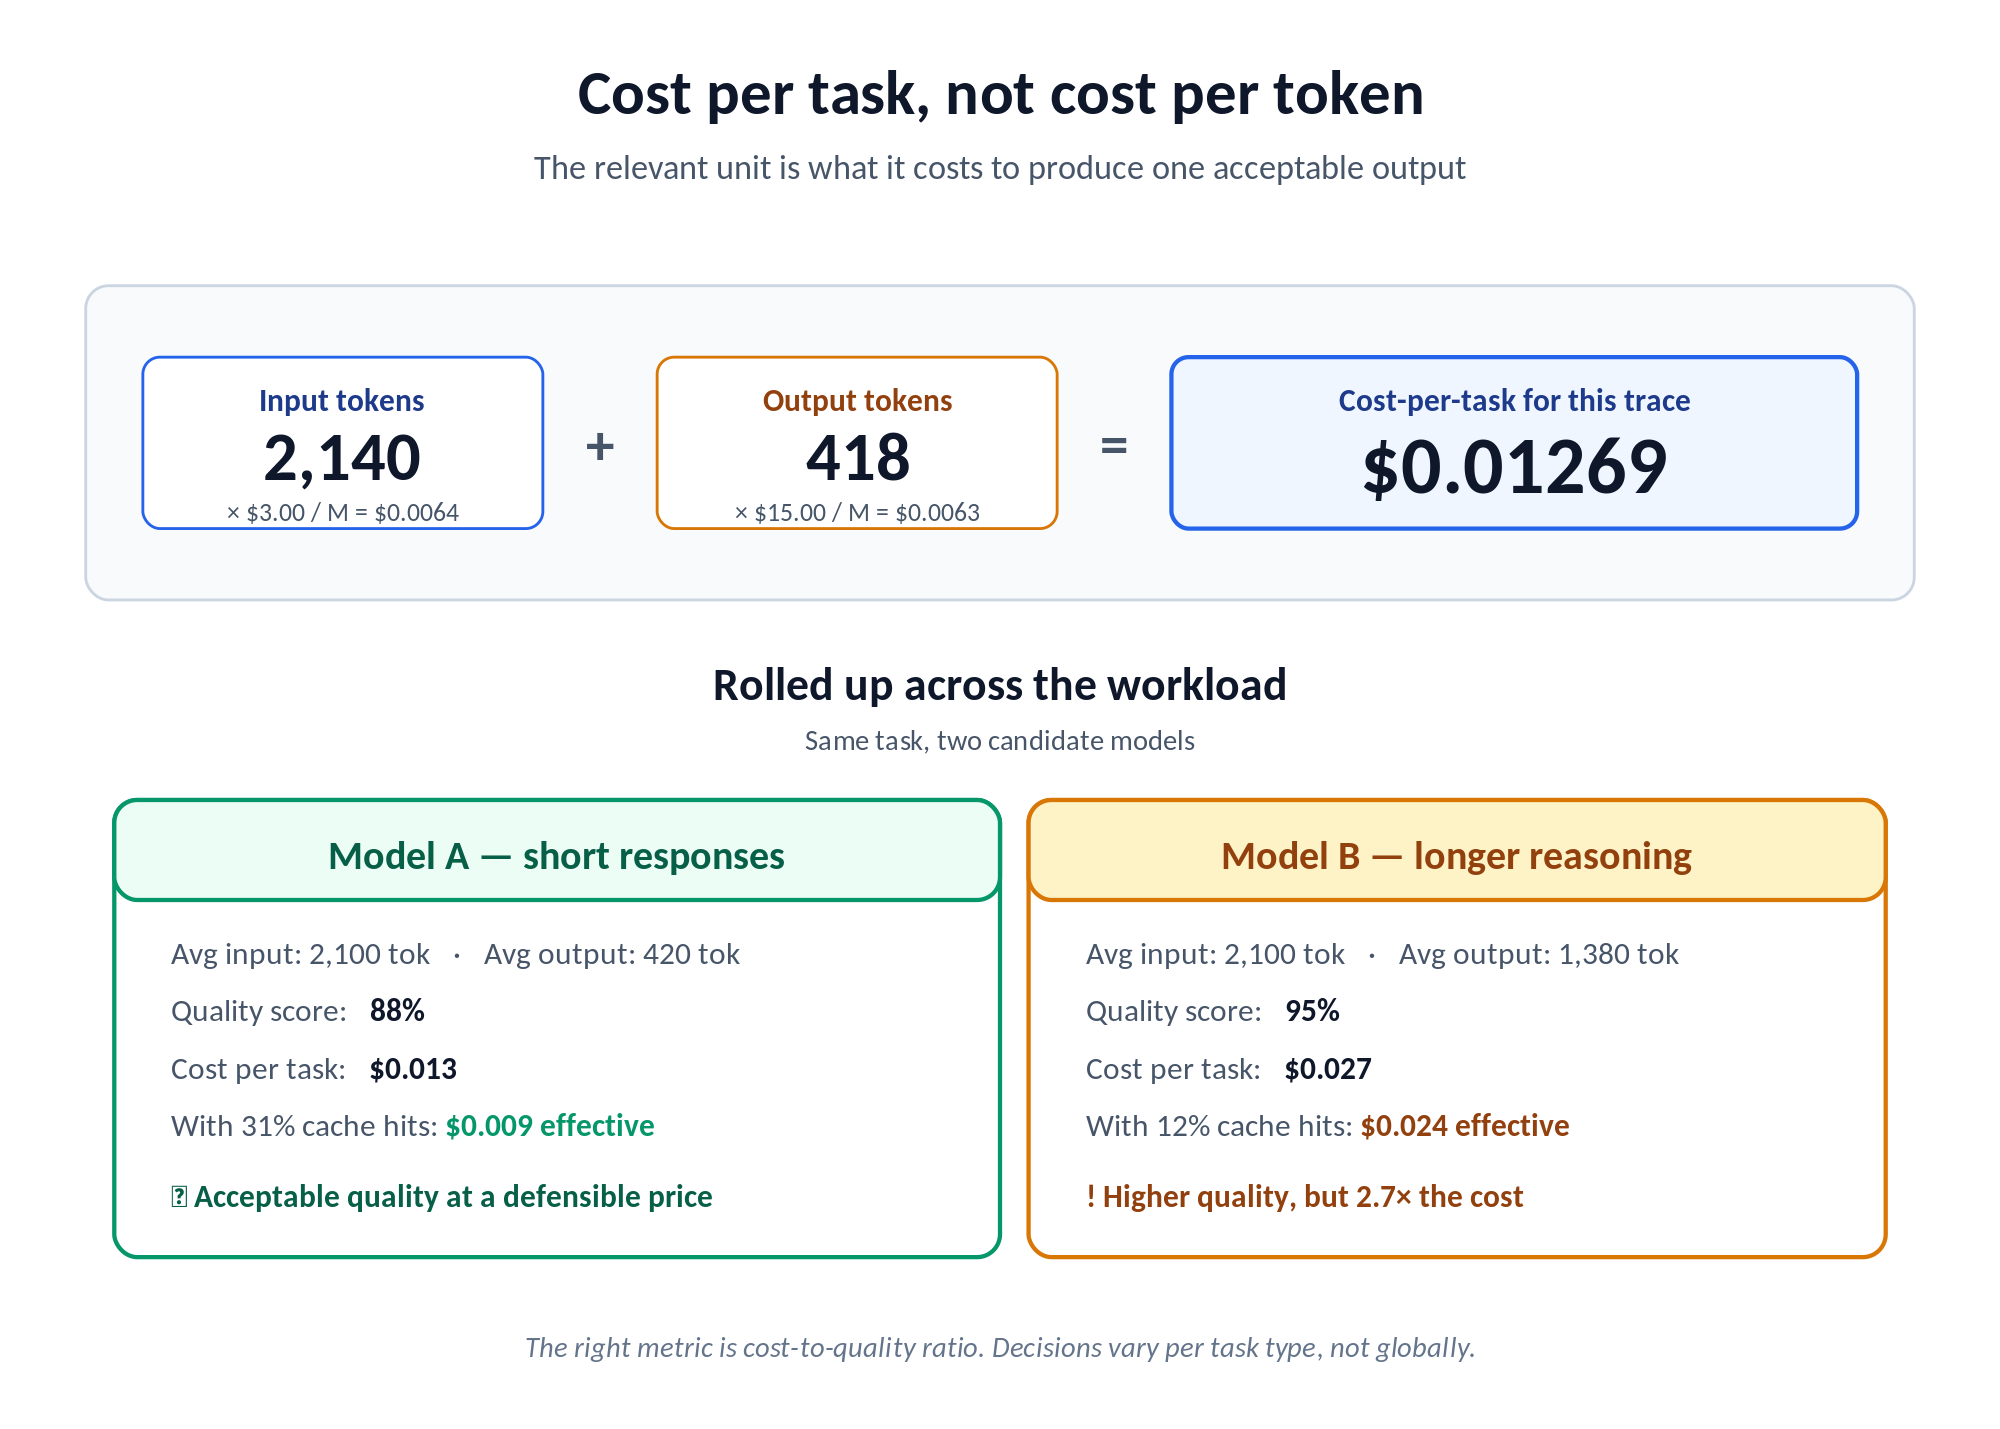
Kostenefficiëntie is onzichtbaar in op nauwkeurigheid gerichte benchmarks. Een model dat 95% scoort op een benchmark, maar gemiddeld 4.000 tokens nodig heeft om uw typische taak te voltooien, kan een slechtere kostprijs per resultaat hebben dan een model dat 88% scoort en gemiddeld 1.800 tokens per taak gebruikt. De kosten per resultaat — wat het daadwerkelijk kost om een acceptabele output voor uw usecase te produceren — worden vrijwel nooit gerapporteerd in publieke benchmarks. Het is ook vaak de belangrijkste metriek voor de budgetplanning van bedrijven.
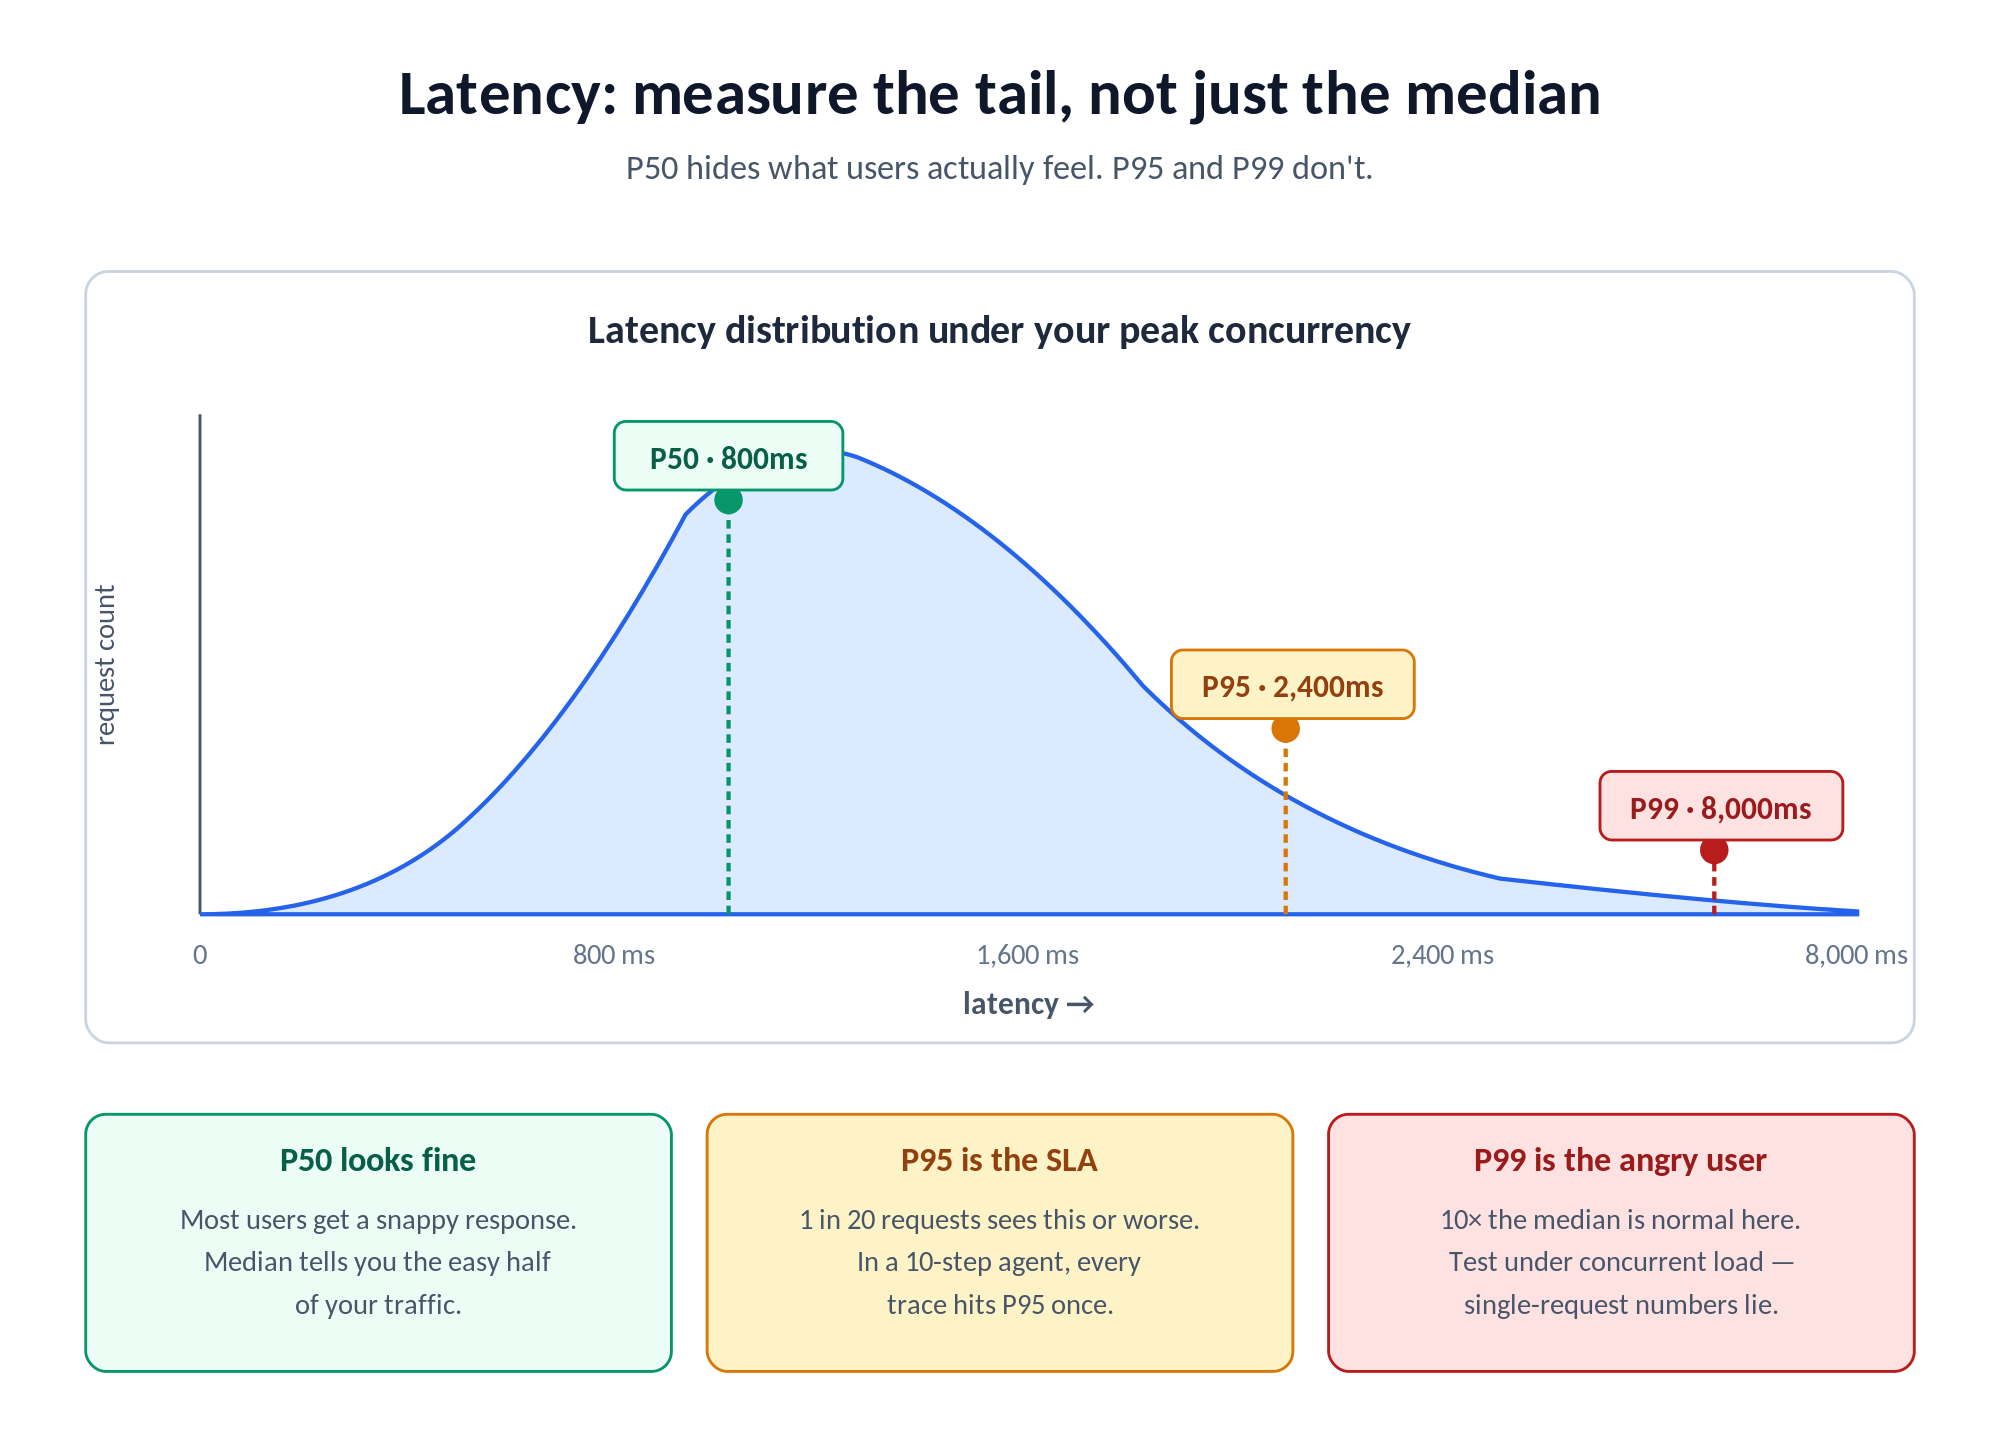
Latency-cijfers van benchmarks zijn niet van toepassing op uw omgeving. Gepubliceerde latency-cijfers voor model-API's worden gemeten onder specifieke omstandigheden: omvang van de aanvraag, niveau van concurrency en infrastructuur die aanzienlijk kunnen verschillen van de uwe. Een model dat een mediane latency van 800 ms laat zien in benchmarkomstandigheden, kan een P95-latency van 2.400 ms opleveren bij uw gelijktijdige volume in productie. Dat is een wezenlijk andere gebruikerservaring.
Modellen veranderen onder stabiele versienummers. Providers werken het gedrag van modellen bij zonder altijd nieuwe versienummers uit te geven of wijzigingen opvallend te communiceren. Een model dat drie maanden geleden goed presteerde op uw interne benchmark, kan zich vandaag anders gedragen als de provider de fine-tuning, het afhandelen van system prompts of het filteren van de output heeft bijgewerkt. Productiebenchmarking moet continu zijn, niet een eenmalige oefening op het moment van modelselectie.
De vier dimensies van enterprise LLM-benchmarking
Een nuttige enterprise LLM-benchmark omvat vier verschillende dimensies. Ze zijn niet onafhankelijk van elkaar. Een model dat uitblinkt op het gebied van kwaliteit, maar faalt op het gebied van kosten per resultaat, kan nog steeds de verkeerde keuze zijn als het kostenverschil niet wordt gerechtvaardigd door de kwaliteitsverbetering. Alle vier moeten worden gemeten. En er moet expliciet een afweging tussen gemaakt worden.
Dimensie 1: Outputkwaliteit voor uw specifieke taak
Definieer taakspecifieke kwaliteitscriteria voordat u evaluaties uitvoert. Kwaliteitscriteria moeten meetbaar zijn, hetzij door menselijke evaluatoren die een gedefinieerde rubriek gebruiken, door een geautomatiseerd beoordelingsmodel met gespecificeerde criteria, of door objectieve metrieken waar deze bestaan (code: slaagpercentage van tests; gestructureerde extractie: nauwkeurigheid van velden; classificatie: precisie en recall ten opzichte van een gelabelde set). Vage criteria zoals “goede output” leiden tot evaluaties die niet reproduceerbaar zijn en een beslissing over een leverancier niet kunnen rechtvaardigen.
Bouw een scoringsrubriek die consistent kan worden toegepast op alle te evalueren modellen. Voor het samenvatten van documenten kan een rubriek betrekking hebben op feitelijke nauwkeurigheid (bevat de samenvatting beweringen die niet worden ondersteund door de bron?), dekking (bevat het alle kernpunten?), geschikte lengte (binnen het beoogde aantal woorden?) en naleving van het formaat (volgt het de vereiste outputstructuur?). Elk criterium moet onafhankelijk worden gescoord, zodat modellen per dimensie kunnen worden vergeleken, en niet alleen op het totaal.
Voer kwaliteitsevaluaties blind uit. Evaluatoren of beoordelingsmodellen mogen niet weten welk model welke output heeft geproduceerd. Modelidentiteitsbias is reëel: evaluatoren die weten dat ze GPT-4-output lezen, scoren deze gemiddeld hoger dan identieke tekst zonder dat label. Blinde evaluatie geeft u scores die de werkelijke kwaliteit weerspiegelen in plaats van reputatie-effecten.
Dimensie 2: Kosten per resultaat
Kosten per 1.000 tokens is een misleidende op zichzelf staande metriek. De relevante eenheid is kosten per voltooide taak. De totale kosten (input-tokens + output-tokens, tegen de prijzen van het model) om een acceptabele output te produceren voor uw typische usecase. Een premium model dat geprijsd is op bijvoorbeeld $ 3 per miljoen input-tokens en $ 15 per miljoen output-tokens, kan meer of minder kostenefficiënt zijn dan een nominaal goedkoper model dat langere antwoorden nodig heeft om een gelijkwaardige kwaliteit te bereiken. De berekening hangt volledig af van de lengteverdeling van uw taak. Haal altijd de actuele tarieven per token op van de prijspagina van elke provider op de dag dat u de vergelijking uitvoert; de cijfers veranderen elk kwartaal.
Bereken de kosten per voltooide taak door de gemiddelde promptlengte (input-tokens) en gemiddelde responslengte (output-tokens) voor uw testdataset op elk model te meten, en dit vervolgens te vermenigvuldigen met de prijzen per token. Wanneer de kwaliteitsscores dicht bij elkaar liggen, zijn de kosten per taak de beslissende factor. Wanneer kwaliteitsverschillen reëel zijn, bepaalt de kosten-kwaliteitsverhouding (extra kosten per percentage punt van kwaliteitsverbetering) of het premium model de prijs waard is.
Neem cache-effecten op in de kosten per resultaat. De semantic cache van TrueFoundry retourneert eerder gegenereerde antwoorden voor semantisch vergelijkbare verzoeken, gescoord op basis van cosinus-similariteit over een embedding van het laatste gebruikersbericht. Cache-hits leveren nul modelkosten op, dus de effectieve uitgaven per verzoek zijn afhankelijk van uw hitrate. Als 35% van uw verzoeken de cache raakt, zijn de kosten per resultaat wezenlijk anders dan de berekening per token, en het negeren hiervan kan een modelvergelijking doen omslaan.
Dimensie 3: Latency onder uw daadwerkelijke verkeerspatroon
Meet de latency bij P50, P95 en P99, niet alleen de mediaan. Enterprise-applicaties moeten het slechtste geval kennen dat gebruikers te zien krijgen, niet alleen de typische ervaring. Een model met een uitstekende P50 maar een P99 van 8 seconden maakt interactief gebruik onacceptabel, zelfs als de mediaan er goed uitziet. Het metrics dashboard van TrueFoundry toont P50-, P75-, P90- en P99-selecties voor Request Latency, Time To First Token (TTFT), Inter Token Latency (ITL) en Time Per Output Token (TPOT). Alle vier de metrieken worden weergegeven omdat ze u elk iets anders vertellen.
Voer belastingstests uit onder uw verwachte gelijktijdige verzoekvolume, en niet onder omstandigheden met één enkel verzoek. De meeste modellen zien er in isolatie geweldig uit en gaan aanzienlijk achteruit onder de gelijktijdige belastingen die productie-applicaties genereren. TrueFoundry levert een LLM Benchmarking Tool in de Application Catalog waarmee u de maximale concurrency, het ramp-up rate, de verdeling van de promptgrootte en het maximale aantal output-tokens kunt configureren. Het brengt het aantal verzoeken per seconde, de responstijd, TTFT en de inter-token latency in kaart. Voer het uit op elk OpenAI-compatibel endpoint, inclusief door TF ingezette modellen, externe providers via een API-sleutel of elk model achter uw AI Gateway. Test op ongeveer 2× uw verwachte piekconcurrency om uzelf een aanzienlijke capaciteitsmarge te geven.
Houd TTFT afzonderlijk van de totale generatietijd bij voor streaming-usecases. Applicaties die de model-output naar gebruikers streamen, ervaren TTFT als "waargenomen latency", de tijd voordat er iets op het scherm verschijnt. Een model met een langere totale generatietijd maar een lagere TTFT kan een betere ervaring bieden dan een technisch sneller model met een trage eerste token. TPOT (totale tijd gedeeld door output-tokens) is het enkele getal dat de volledige generatiesnelheid omvat en is wat de latency-based routing van TrueFoundry gebruikt om het snelste doel te kiezen.
Dimensie 4: Consistentie en betrouwbaarheid
Voer elke prompt in uw testdataset drie tot vijf keer uit over meerdere sessies om de outputvariantie te meten. Sommige modellen produceren dramatisch verschillende outputs voor dezelfde invoer over verschillende uitvoeringen: verschillende feitelijke beweren, verschillende outputstructuren, verschillende dekking van de vereiste punten. Hoge variantie creëert stroomafwaarts problemen voor parsing, gestructureerde gegevensextractie en de consistentie van de gebruikerservaring.
Test het gedrag in foutmodi expliciet. Wat retourneert het model wanneer de invoer het contextvenster overschrijdt? Wat gebeurt er als het inhoudsbeleid wordt geactiveerd bij een twijfelachtige invoer? Volgt het expliciete instructies over het formaat betrouwbaar, of vervalt het soms in antwoorden in de vrije vorm wanneer gestructureerde output vereist was? Deze foutmodi zijn grotendeels afwezig in publieke benchmarks, maar dit is wel waar productiesystemen breken.
Het bouwen van een representatieve benchmarkdataset voor uw onderneming
De benchmarkdataset is het meest doorslaggevende onderdeel van een enterprise LLM-evaluatie. Een goed ontworpen dataset levert betrouwbare voorspellingen op van productieprestaties. Een slecht ontworpen dataset levert misleidende resultaten op die leiden tot verkeerde keuzes. Het ontwerp van de dataset verdient evenveel engineering-investeringen als de evaluatiemethodologie zelf.
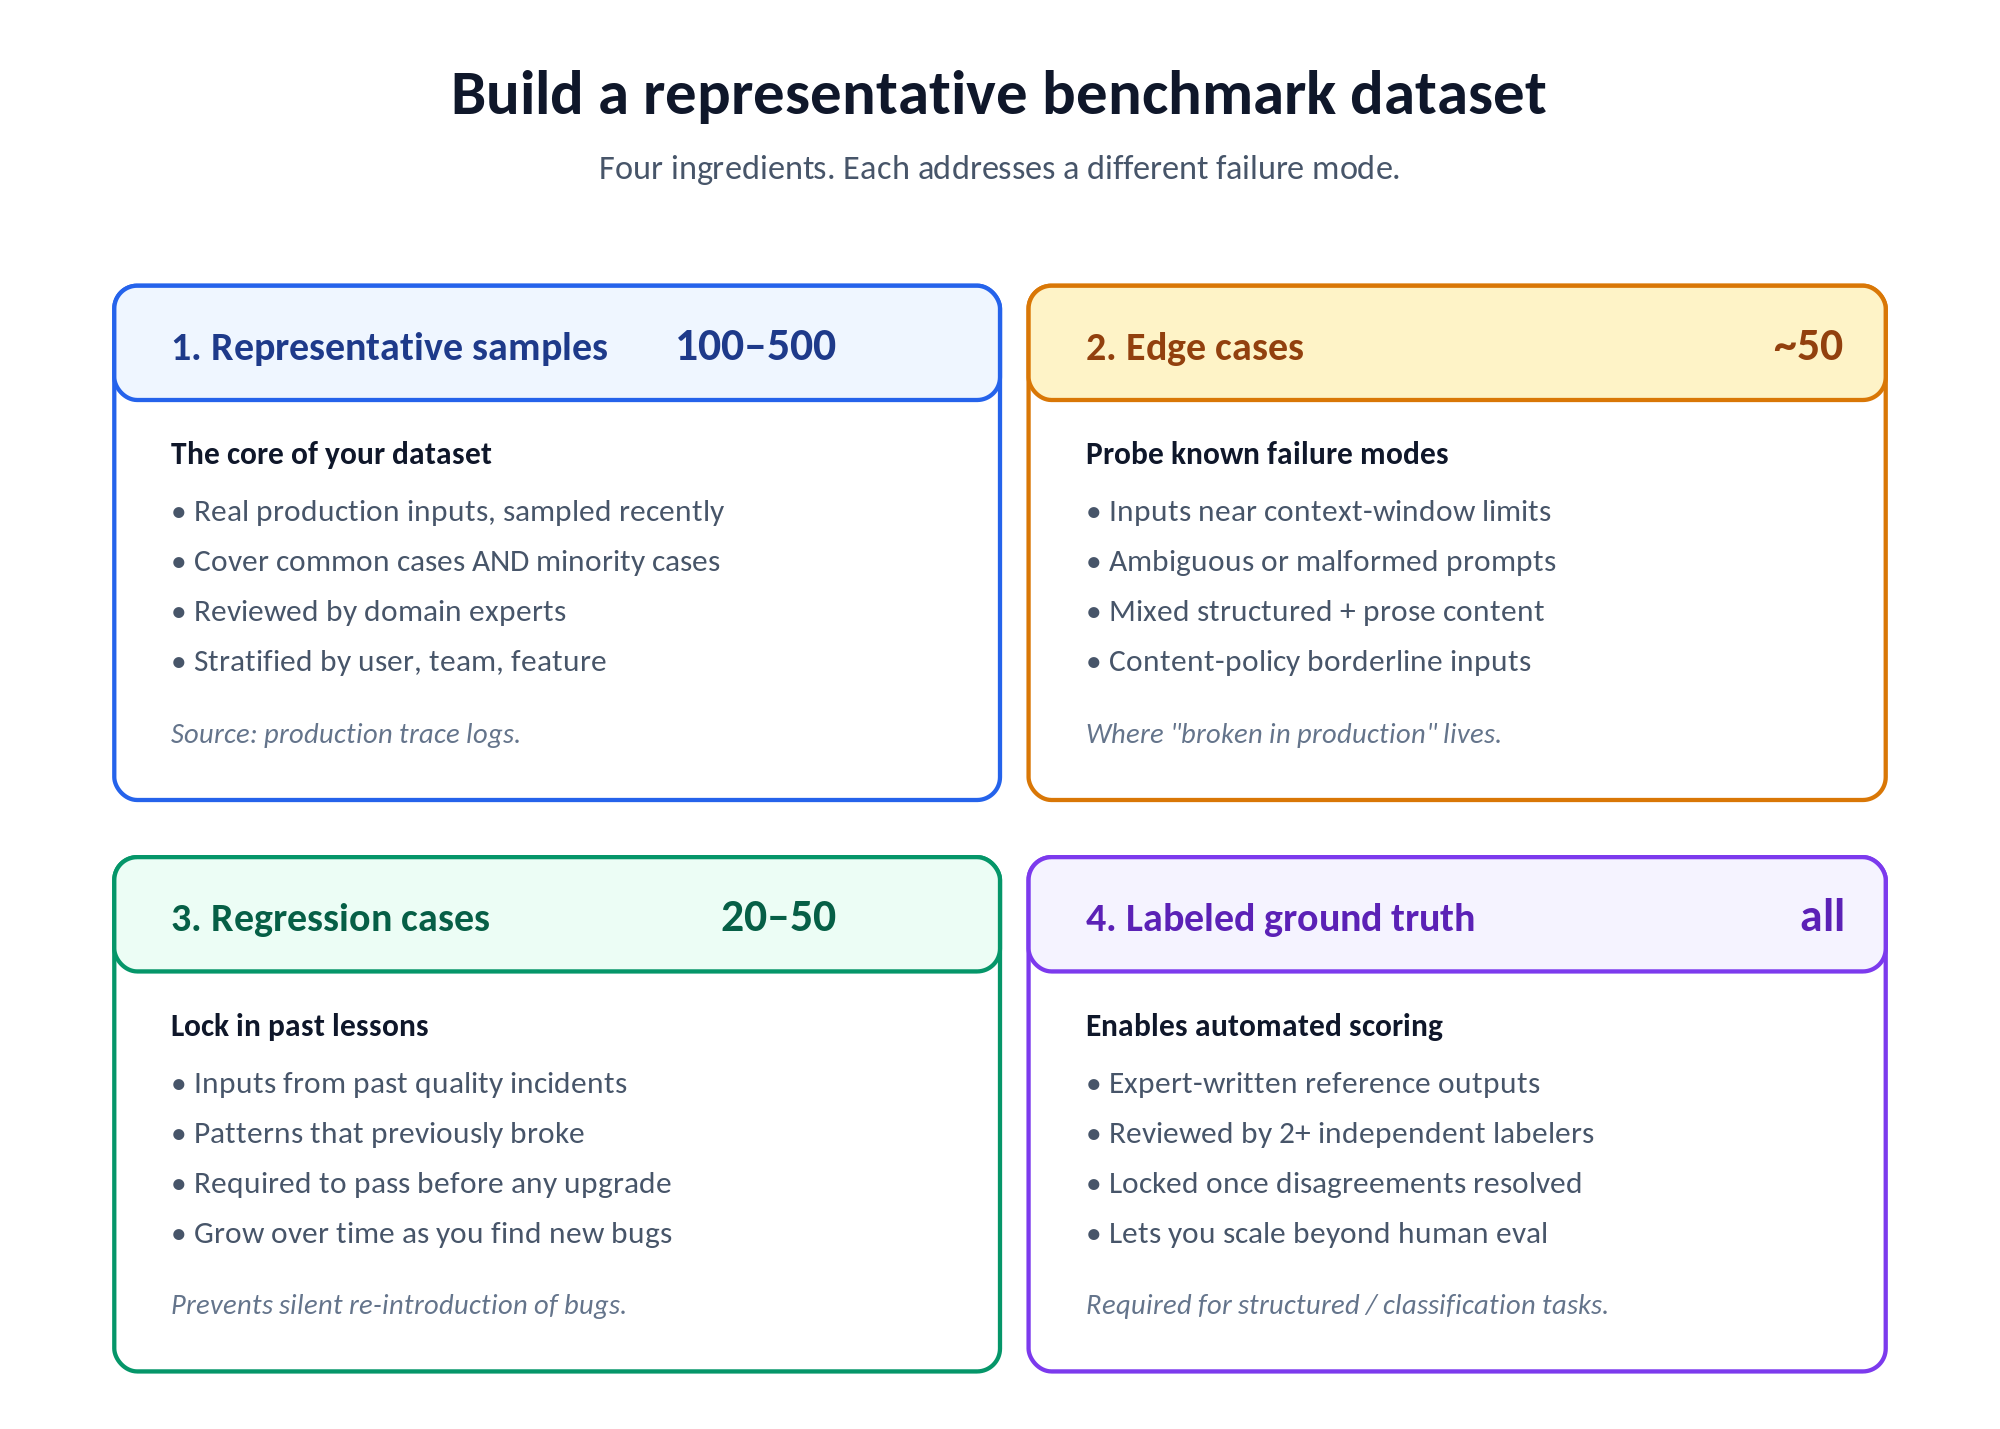
Representatieve steekproeven vormen de kern van de dataset. Verzamel 100 tot 500 echte voorbeelden uit uw productieworkload, handmatig beoordeeld door domeinexperts om te bevestigen dat ze de werkelijke distributie vertegenwoordigen van de invoer die uw systeem verwerkt. Dek de volledige distributie af: veelvoorkomende gevallen, randgevallen, de minderheid van de invoer die technisch moeilijk is of waar de kwaliteitseisen het strengst zijn. Steekproeven moeten worden getrokken uit recente productiedata om de huidige distributies te weerspiegelen, niet uit historische data die mogelijk niet langer representatief zijn. Als u tracing hebt ingeschakeld op uw AI Gateway, is de Query Spans API (via de TrueFoundry SDK) waarschijnlijk de schoonste manier om een gestratificeerde steekproef te trekken, gefilterd op gebruiker, team, virtueel account of een aangepaste metadata-sleutel die u hebt gekoppeld.
Randgevallen testen bekende foutmodi van modellen. Ontwerp specifieke testinvoeren om deze aan het licht te brengen. Voor documentverwerking: zeer lange documenten in de buurt van de limieten van het contextvenster, documenten met inconsistente opmaak, documenten met tabellen of gestructureerde data gemengd met tekst. Voor codegeneratie: verzoeken met dubbelzinnige specificaties, verzoeken in ongebruikelijke frameworks, verzoeken die redenering over beveiligingsimplicaties vereisen. Voor klantgerichte applicaties: invoer met grammaticafouten, invoer in niet-standaard taal, grensgevallen van het inhoudsbeleid. De set van randgevallen is waar de kloof tussen “95% op de benchmark” en “kapot in productie” zich bevindt.
Regressiegevallen voorkomen achteruitgang van functionaliteit. Onderhoud een set van 20 tot 50 voorbeelden die zijn ontleend aan incidenten uit het verleden: gevallen waarin uw huidige model onjuiste output produceerde, gevallen waarin een eerdere model-upgrade tot kwaliteitsachteruitgang leidde, gevallen waarin specifieke invoerpatronen consequent problemen veroorzaakten. Elk nieuw model dat wordt geëvalueerd, moet de regressieset doorstaan voordat het in aanmerking komt voor productie. Dit maakt upgrades veiliger omdat u niet stilzwijgend eerder opgeloste problemen opnieuw kunt introduceren.
Gelabelde ground truth maakt geautomatiseerde scoring mogelijk. Voor usecases waar geautomatiseerde scoring haalbaar is (gestructureerde extractie, classificatie, codegeneratie), voegt u ground truth-labels toe die zijn gemaakt door menselijke experts voor elk testgeval. Geautomatiseerde scoring ten opzichte van ground truth schaalt beter dan menselijke evaluatie voor grote testsets. Labels moeten door ten minste twee onafhankelijke evaluatoren worden beoordeeld om meningsverschillen op te lossen voordat ze worden vastgelegd als de evaluatiestandaard.
Productie A/B-tests uitvoeren: De meest betrouwbare benchmark
Offline benchmarking op een testdataset is een noodzakelijke eerste stap. Het meest betrouwbare signaal komt over het algemeen uit productieverkeer. Echte gebruikers genereren een distributie van invoer die naar verluidt gevarieerder en uitdagender is dan welke handmatig gecureerde testset dan ook. Productie A/B-testing — het routeren van een percentage van het live verkeer naar een nieuw model terwijl de resultaten worden vergeleken met het huidige model — is wat een modelbeslissing verdedigbaar maakt.
Begin met 1-5% van het productieverkeer. Routeer een klein percentage van de live verzoeken naar het kandidaatmodel terwijl de rest op het huidige model blijft. Monitor de outputkwaliteit, latency, kosten en het foutpercentage gedurende minimaal twee weken, lang genoeg om de volledige distributie van uw productie-invoer op te vangen, inclusief wekelijkse patronen en randgevallen die slechts af en toe voorkomen. In TrueFoundry is dit een enkel veld in een Virtual Model-configuratie: weight: 5 op de kandidaat, weight: 95 op het huidige model.
Definieer succes criteria voordat de test begint. Formuleer de specifieke omstandigheden waaronder het nieuwe model wordt geaccepteerd voor volledige inzet in productie. Voorbeeld: het nieuwe model moet ten minste 97% van de kwaliteitsscore van het huidige model behalen tegen niet meer dan 110% van de kosten per taak van het huidige model, met een P95-latency die niet slechter is dan het huidige model. Vooraf gedefinieerde criteria voorkomen rationalisatie achteraf, waarbij teams een slechter presterend model accepteren omdat sommige andere metrieken toevallig goed lijken.
Gebruik de AI Gateway-routinglaag voor verkeerssplitsing. Configureer de gateway om het verkeer tussen modellen op basis van percentages te splitsen zonder applicatiecode te wijzigen. De applicatie stuurt een standaardverzoek naar een virtuele modelnaam (zoals support-bot/summarize), en de gateway beslist welk echt model moet worden gebruikt op basis van de geconfigureerde splitsing. Dit elimineert de engineering-overhead van het implementeren van modelspecifieke codebranches voor evaluatie. De load-balancingconfiguratie van TrueFoundry is declaratieve YAML, bewerkbaar in de UI of gepusht via de tfy CLI voor GitOps-workflows.
Stel automatische rollback-triggers in. Configureer voorwaarden die de kandidaat automatisch uit de rotatie halen: drempelwaarde voor foutpercentage, latency-plafond, vloer voor kwaliteitsscore. De fouttolerantieconfiguratie van TrueFoundry (allowed_failures_per_minute, cooldown_period_minutes, failure_status_codes) wordt per model ingesteld, en een doel dat de drempelwaarde overschrijdt, wordt als ongezond gemarkeerd en uitgesloten van routing voor de duur van de cooldown. De load-balancing blog toont een typische configuratie waarbij drie fouten per minuut een cooldown van vijf minuten activeren op [429, 500, 502, 503, 504]. Voor latency ondersteunt priority-based routing een SLA cutoff op TPOT: configureer time_per_output_token_ms per doel, en de gateway monitort een voortschrijdend venster van 3 minuten met maximaal 10 samples (minimaal 3) om te beslissen of de kandidaat aan uw latency-norm voldoet. Productie A/B-tests zijn 'fail-safe'. Het ergste geval is dat een klein percentage van het verkeer wordt bediend door een slecht model voordat het automatische herstel in werking treedt.
Log resultaatmetrieken die verder gaan dan technische signalen. Log naast latency en foutpercentage ook zakelijke resultaatsignalen waar deze meetbaar zijn: heeft de gebruiker de output van het model geaccepteerd of afgewezen? Is de taak van de agent succesvol afgerond? Is de interactie met de klantenservice binnen de sessie opgelost? Deze stroomafwaartse metrieken zijn zinvoller voor modelselectie dan technische kwaliteit alleen, en ze vereisen instrumentatie op applicatieniveau om te verzamelen. Met de custom metadata van TrueFoundry (verzonden via de X-TFY-METADATA-header) kunt u elk verzoek taggen met feature, omgeving, klant-ID of welke dimensie uw organisatie ook belangrijk vindt, en het metriekendashboard later op basis van die dimensie opsplitsen.
Modelselectie automatiseren: Verder dan handmatige A/B-tests
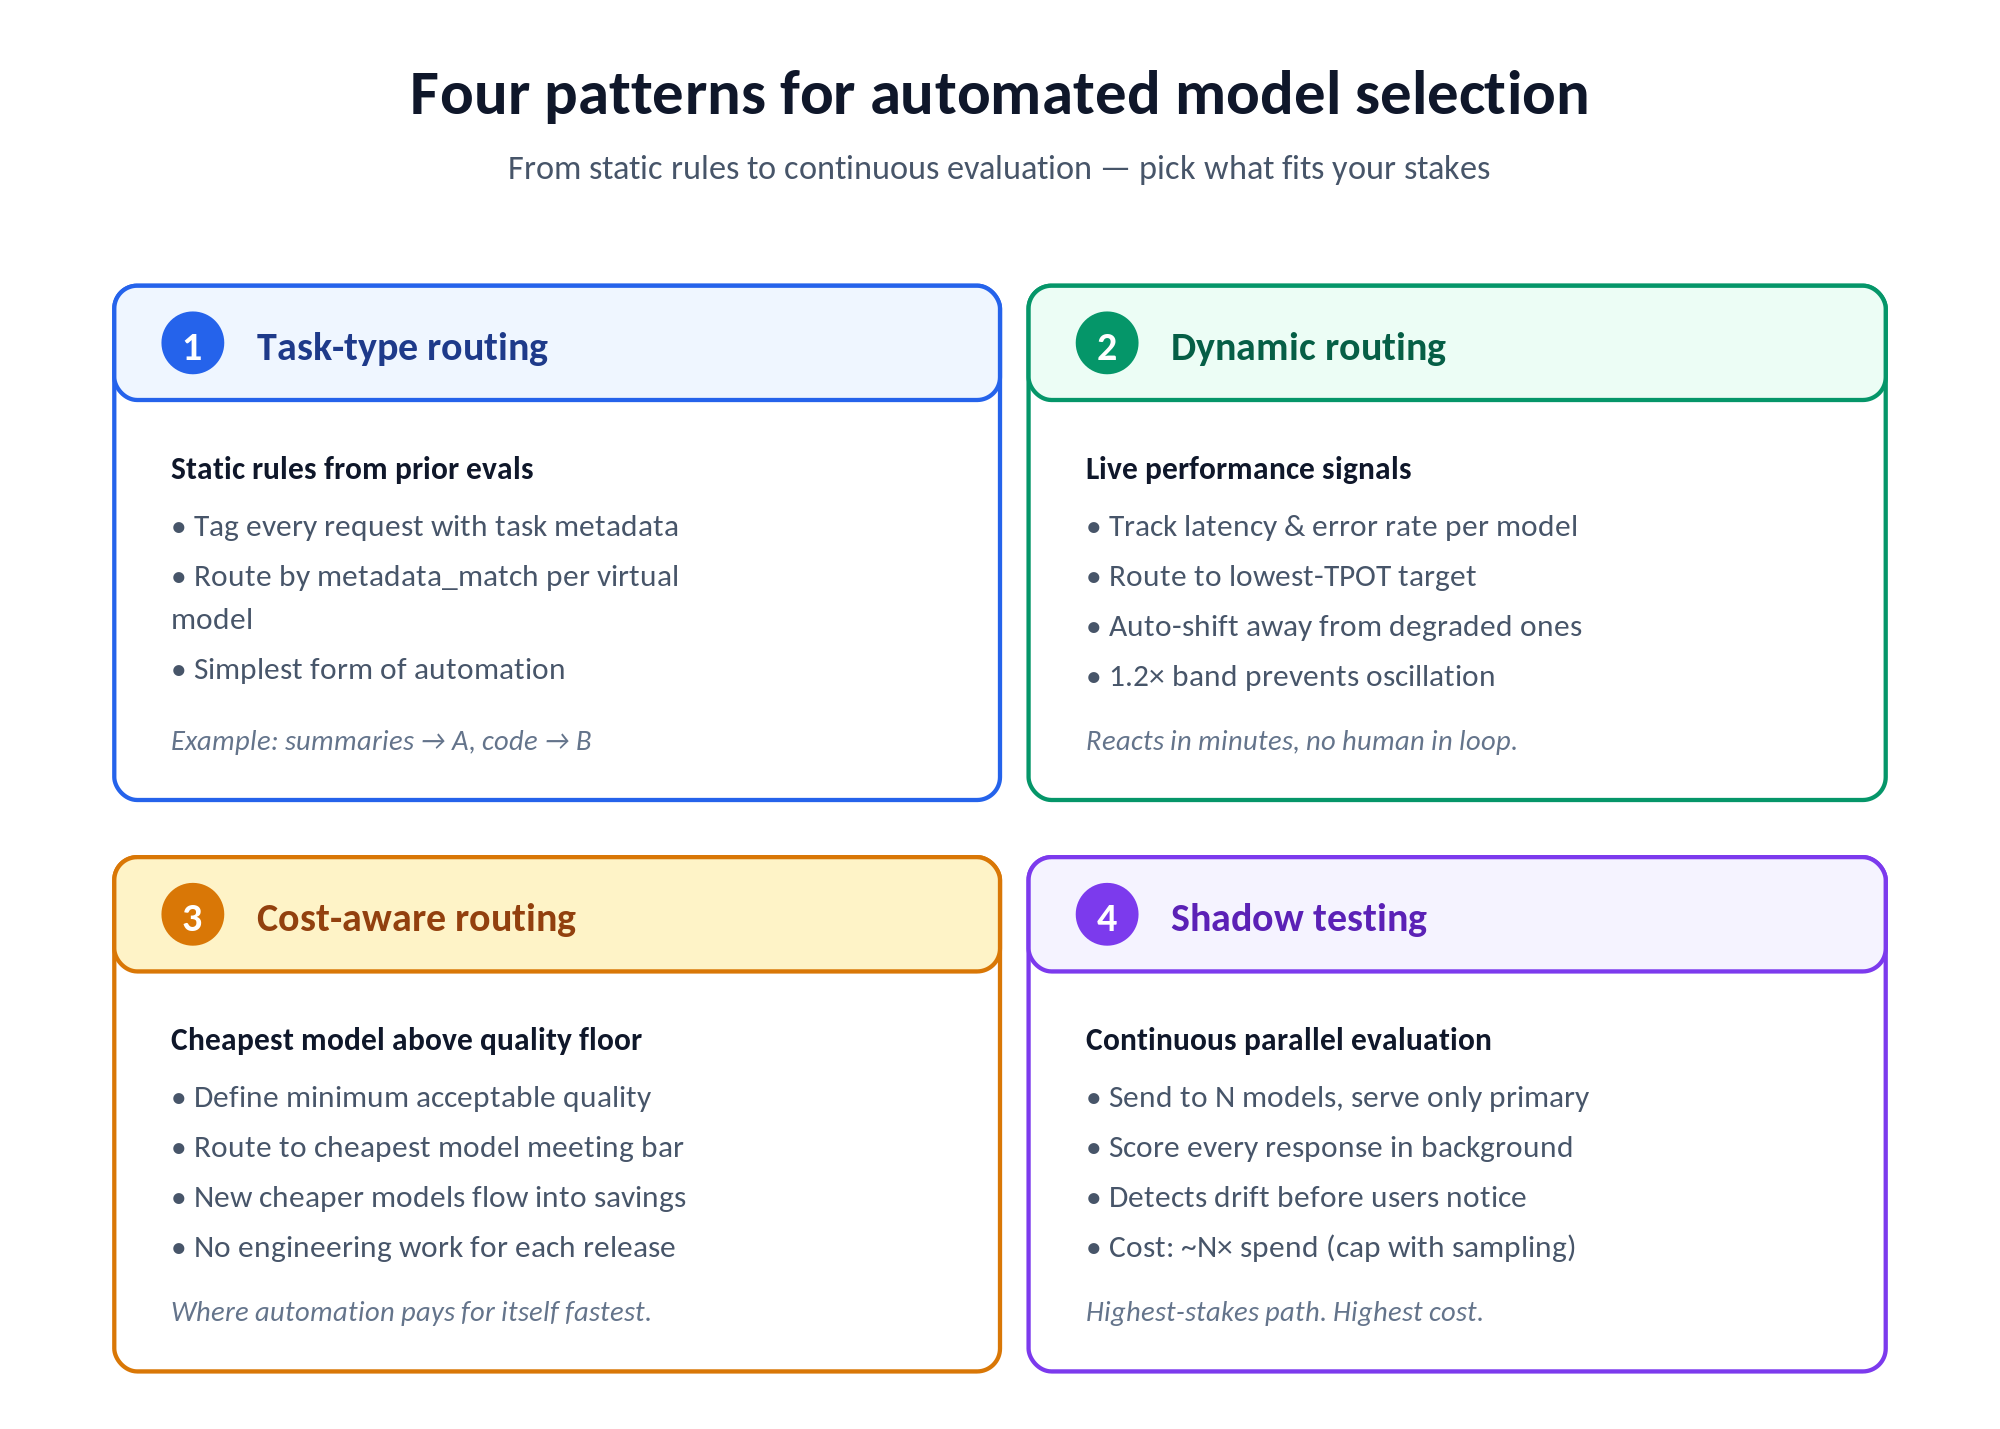
Het eindpunt van een matuur evaluatieprogramma voor enterprise LLM's is het volledig verwijderen van modelselectie uit het kritieke pad van engineeringbeslissingen. In plaats van handmatige A/B-tests uit te voeren telkens wanneer er een nieuw model uitkomt, past de gateway automatisch geconfigureerde selectiecriteria toe. Elk verzoek gaat naar het model dat op basis van de huidige prestatiegegevens waarschijnlijk het beste resultaat oplevert.
Taaktype-routing op basis van evaluatieresultaten. Zodra evaluaties hebben vastgesteld dat Model A beter is voor het samenvatten van documenten en Model B beter is voor codegeneratie, configureert u de gateway om te routeren op basis van de taaktype-tag die aan elk verzoek is gekoppeld. Dit is statische routing op basis van eerdere evaluatie, de eenvoudigste vorm van geautomatiseerde modelselectie. In de virtuele modellen van TrueFoundry is dit een metadata_match-blok op elk doel: stuur {task: "summarize"}-verzoeken naar de ene provider, {task: "code_gen"} naar een andere, waarbij de metadata door uw applicatie wordt gevuld via de X-TFY-METADATA-header.
Dynamische routing op basis van realtime prestatiesignalen. Geavanceerdere routing maakt gebruik van de live latency- en foutpercentagegegevens van de gateway om weg te routeren van modellen die momenteel verminderd presteren. Wanneer de API van een provider een verhoogde latency ervaart, verplaatst de gateway het verkeer naar het op een na beste model voor dat taaktype, zonder te wachten tot een mens het opmerkt. De latency-based routing van TrueFoundry routeert naar de laagste TPOT in de afgelopen 20 minuten (of de laatste 100 verzoeken, afhankelijk van wat het minst is), met een bandbreedte van 1,2×, zodat modellen binnen dat bereik als even snel worden behandeld en het verkeer niet schommelt door kleine verschillen.
Kostenbewuste routing met kwaliteitsvloeren. Configureer regels die verzoeken naar het goedkoopste model sturen dat aan een gedefinieerde kwaliteitsdrempel voldoet. Voor taken waarbij elk model boven een minimumniveau acceptabel is, realiseert de gateway kostenbesparingen doordat goedkopere modellen aan de norm voldoen zonder engineeringwerk. Dit is waar geautomatiseerde routing zichzelf het snelst terugverdiend: elk nieuwer, goedkoper model dat uw kwaliteitsvloer haalt, leidt direct tot besparingen.
Continue evaluatie met shadow testing. Shadow testing routeert elk productieverzoek gelijktijdig naar meerdere modellen, serveert de respons van het primaire model en evalueert de outputs van alle kandidaten. Dit creëert een continue evaluatiestroom die veranderingen in modelprestaties in realtime detecteert, voordat ze leiden tot voor de gebruiker zichtbare kwaliteitsachteruitgang. De kosten-overhead is ongeveer N× de modeluitgaven als u schaduwt tegen N modellen, wat aanzienlijk is, maar vaak minder dan de kosten van het in productie nemen van een model dat achteruitgaat. U kunt die overhead beheren door slechts een fractie van het verkeer te schaduwen, of door alleen te schaduwen tegen kleinere, goedkopere modellen die worden geëvalueerd als kandidaten voor kostenverlaging.
Hoe TrueFoundry enterprise LLM-benchmarking en modelselectie oplost
De AI Gateway van TrueFoundry is gebouwd om van productiemodelevaluatie een continue mogelijkheid te maken voor enterprise platformteams, en niet een eenmalig project. De onderstaande onderdelen zijn gedocumenteerd in de live AI Gateway-documentatie en zijn geverifieerd in het geïmplementeerde product.
Verkeerssplitsing zonder codewijzigingen.Virtual Models beheren de verkeerssplitsing in productie tussen een willekeurig aantal echte doelen op basis van percentages. Engineering-teams configureren de splitsing in de UI YAML-editor of via tfy apply -f loadbalancer-config.yaml voor GitOps. De applicatiecode blijft ongewijzigd: deze roept één virtuele modelnaam aan zoals support-bot/summarize, en de gateway beslist welke echte provider elk verzoek afhandelt. Splitsingen kunnen in realtime worden aangepast, van 1% naar 10% naar 50%, naarmate het vertrouwen in de kandidaat groeit.
Ingebouwde automatische rollback-triggers. Twee complementaire mechanismen bepalen wanneer een doel uit de rotatie wordt gehaald. De fouttolerantieconfiguratie (per model configureerbaar via allowed_failures_per_minute, cooldown_period_minutes en een lijst van failure_status_codes) markeert een doel als ongezond zodra het foutpercentage de drempelwaarde overschrijdt, en herstelt het vervolgens automatisch nadat de cooldown is verstreken. Met de SLA cutoff (alleen bij priority-based routing) kunt u een TPOT-drempelwaarde per doel instellen; de gateway bewaakt een voortschrijdend venster van 3 minuten en verlaagt de prioriteit van een doel dat deze overschrijdt. Productie A/B-tests zijn 'fail-safe' zonder dat er menselijke bewaking nodig is buiten de kantooruren.
Kosten per resultaat bijhouden over verschillende modellen.Cost tracking ondersteunt zowel Public Cost (automatisch ingevuld op basis van tarieven van de provider) als Private Cost (aangepaste contracten, gefinetunede modellen). Het Metrics dashboard splitst kosten uit per gebruiker, model, team of virtueel account, met een “View by metadata”-pivot waarmee u uitgaven kunt filteren op elke custom tag die door uw applicatie is toegevoegd. CSV-export en een HTTP API voor ruwe en geaggregeerde metrics maken het eenvoudig om de gegevens door te sturen naar uw finance- of business-intelligence-stack.
Semantic caching die routeringswijzigingen overleeft.Semantic caching retourneert eerder gegenereerde antwoorden voor semantisch vergelijkbare verzoeken, waarbij gebruik wordt gemaakt van cosine similarity op de embedding van het laatste gebruikersbericht met een configureerbare drempelwaarde (het aanbevolen startpunt is 0.9). Andere verzoekparameters (model, eerdere berichten, temperatuur) worden afzonderlijk gehasht en moeten exact overeenkomen, zodat cache hits strikt afgebakend zijn. Cache-invoer is standaard geïsoleerd per gebruiker/virtueel account, met optionele custom namespaces voor multi-tenant applicaties. Cache hits retourneren een antwoord in milliseconden zonder modelkosten, ongeacht welk doel de routeringslaag anders zou hebben geselecteerd.
Breedte aan providers in één enkele evaluatie. TrueFoundry routeert over OpenAI, Anthropic (direct en via AWS Bedrock), Azure OpenAI, AWS Bedrock, AWS SageMaker, GCP Vertex AI, Cohere, Together AI, Mistral, Groq, Cerebras, xAI, Databricks, Self-Hosted models en andere (de volledige lijst staat op de AI Gateway overzichtspagina). Teams kunnen AWS Bedrock Claude Sonnet 4.5 vergelijken met Azure OpenAI-equivalenten in één enkele A/B-test zonder afzonderlijk integratiewerk voor elke provider. De geclaimde overhead van de gateway is “doorgaans minder dan 5ms” met een aanhoudende doorvoer van 350+ RPS op 1 vCPU, wat de gateway zelfs op productie-schaal buiten het kritieke pad houdt.
Voer uw eerste productie-model A/B-test uit in minder dan 30 minuten met TrueFoundry.
TrueFoundry's AI Gateway beheert traffic splitting, cost-per-outcome tracking en automatische rollback voor live modelevaluaties. Boek een demo om de configuratie te bekijken.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting
How do we design a benchmark test set for a use case where we don't yet have production data to sample from?
Bootstrap with synthetic data plus a small expert-curated seed set. Have subject-matter experts hand-write 30-50 representative inputs, then expand with synthetic variations: paraphrases, edge cases, format variations, length variations. Validate the synthetic inputs against your expected production distribution as best you can. The first wave of real production traffic gives you the data you need to refine the dataset, so plan to revise the test set after the first month of production data is available. Treat the initial dataset as a v0, not as a permanent ground truth, and use TrueFoundry's request logs to harvest a stratified sample of real inputs once they exist.
What's the minimum duration for a production A/B test before the results are reliable enough to make a model selection decision?
Two weeks is a defensible minimum for most enterprise applications. The reasoning is that two weeks captures both weekly cycles (different traffic patterns Monday-Friday vs weekend) and a full deployment cycle of the calling application. For statistical confidence on the comparison, target at least a few thousand requests served by the candidate model: that's typically enough to distinguish a real quality or latency difference from noise, assuming your traffic generates a meaningful distribution of inputs. Higher-stakes decisions (replacing a model in a customer-facing application) usually warrant four weeks. For lower-stakes decisions (internal-tool model swap), one week with adequate volume can be enough.
Hoe handelt TrueFoundry automatische rollback af, wat triggert het, en hoe snel keert verkeer terug naar het oorspronkelijke model?
Twee mechanismen dekken het pad van storing naar rollback. De configuratie voor foutentolerantie wordt per model ingesteld met drie knoppen: allowed_failures_per_minute (hoeveel fouten worden getolereerd), cooldown_period_minutes (hoe lang het model wordt uitgesloten zodra het de drempel overschrijdt), en failure_status_codes (welke HTTP-codes als fouten tellen). Een doel dat de drempel overschrijdt, wordt als ongezond gemarkeerd en uitgesloten van routering gedurende de cooldownperiode, en vervolgens automatisch hersteld. SLA-afsnijding is beschikbaar voor op prioriteit gebaseerde routering: stel time_per_output_token_ms in op een doel, en als het voortschrijdend gemiddelde over 3 minuten de drempel overschrijdt (met minstens 3 samples), wordt het doel naar het einde van de fallback-keten verplaatst. Beide mechanismen draaien zonder menselijke tussenkomst. Het praktische effect is dat tijdens een slechte rollout een klein percentage verkeer het slechte model krijgt voordat het automatisch wordt uitgesloten, en gezonde doelen blijven bedienen.
Can TrueFoundry route different request types to different models simultaneously, so we can A/B test one use case without affecting others?
Yes. Two patterns make this work. First, create one virtual model per use case: support-bot/summarize, code-bot/generate, extraction-bot/parse are each independent virtual models with their own routing rules and weights, so an A/B test on the summarization workflow doesn't touch code generation. Second, use metadata_match filters on individual targets within a virtual model to scope them to specific request types: a target with metadata_match: {task: "code_gen"} only receives traffic where the request metadata includes that key-value pair. The same approach works for region or environment-aware routing: tag requests with X-TFY-METADATA: {"region": "eu-west"} from your application, and add metadata_match blocks on targets that should serve only that region.
How should we benchmark models for agentic AI workloads where the quality of a multi-step agent task is harder to measure than a single-turn response?
Agent quality has to be measured at the outcome level, not the per-turn level. Define what success means for the end-to-end task (the deal got booked, the ticket got resolved, the document got correctly extracted) and measure that as the primary signal. Per-turn metrics matter for debugging but not for model selection. For trace-level visibility, TrueFoundry's request tracing logs the full prompt and response for every step in the chain, with a trace_id correlating them, so you can replay a failed agent run and see where the chain broke down. For automated scoring, a judge-model approach is often the most practical: define a rubric for “did this trace accomplish the user's stated goal?” and score traces against it. Run the same agent loop on multiple candidate models and compare end-to-end success rates rather than per-step accuracy. Be more conservative with A/B test rollout percentages for agentic workloads (start at 1% rather than 5%) since failure modes can compound across steps.
What's the cost overhead of running shadow tests, and is it worth it for most enterprise use cases?
Shadow testing roughly doubles model spend if you shadow every request against one alternative, so the headline overhead is meaningful. There are three ways to make it economical. First, shadow only a fraction of traffic: a 10% shadow rate gives you a continuous evaluation stream at one-tenth the cost overhead of a full shadow. Second, shadow against smaller, cheaper candidates rather than premium models: if you're evaluating whether a smaller model could replace your current premium one, the shadow itself is cheap. Third, run shadows asynchronously where the application doesn't need to wait, so the latency budget isn't doubled. Whether it's worth it depends on the cost of a bad model deployment in your context. For high-stakes applications, the spend is usually justified by avoiding even one regression incident. For lower-stakes use cases, periodic A/B tests on the candidate set probably give you enough signal at much lower steady-state cost.