



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Een judge is een model dat drie dingen krijgt: een te beoordelen output, een rubriek die beschrijft wat "goed" is, en een instructie om een machinaal leesbaar oordeel terug te sturen — pass/fail, een score, of een voorkeur tussen twee kandidaten.
Het bestaat omdat het alternatief niet schaalbaar is. Exact-match-statistieken werken wanneer er één juist antwoord is; ze zijn waardeloos voor een supportreactie waarbij vijf verschillende antwoorden allemaal correct zijn. Mensen beoordelen die goed, maar langzaam. Een judge zit daar tussenin: minder nauwkeurig dan een zorgvuldige mens, veruit beter dan een stringvergelijking, en snel genoeg voor duizenden samples. Zie het als een goedkoop, ruisgevoelig, mensgecorreleerd alternatief.
De meest gemaakte fout hier is het behandelen van offline evaluatie en online gating als één ding met twee verschillende implementatiedoelen.
De rij met de foutmodus is de belangrijkste om te onthouden. Offline kost een verkeerde score een beslissing die u de volgende sprint heroverweegt; online is het een gebruiker die naar een foutmelding staart. Stem een online judge dus af op precisie, zelfs als dat ten koste gaat van de recall. Het kopiëren van een rubriek tussen modi is de reden dat teams uiteindelijk een paar procent van het legitieme verkeer blokkeren.
Judges zijn goed in criteria die beschrijfbaar maar niet berekenbaar zijn — is dit gegrond in de opgehaalde context, is de toon juist voor een klinische setting. U kunt de regel in een alinea schrijven, maar niet als een regex. Ze gaan op drie manieren de mist in.
Positiebias. Gegeven twee kandidaten bevoordelen judges één specifieke positie; draai de volgorde om en een aanzienlijk deel van de oordelen klapt om. De oplossing is om elk paar tweemaal te beoordelen met gewisselde posities en alleen de overeenstemming te tellen, wat de kosten verdubbelt.
Lengtebias (verbosity bias). Langere antwoorden scoren hoger, vrijwel onafhankelijk van de vraag of de extra woorden iets toevoegden. Dit stuurt productieprompts ongemerkt aan tot opvulling: u optimaliseert tegen de judge, de judge beloont lengte, de tokenrekening stijgt, en niemand legt de link tussen die twee.
Zelfvoorkeur. Een model beoordeelt tekst die lijkt op zijn eigen generaties hoger. Als GPT GPT-output beoordeelt, wordt de score gevleid — het sterkste argument voor een judge uit een andere familie dan het geteste model.
Judges zijn ook slecht gecalibreerd op continue schalen: vraag om een score uit 10 en alles clustert rond de 7 en 8. Binaire pass/fail tegen een strak criterium is veel betrouwbaarder. En een judge kan een feit dat hij niet heeft niet verifiëren — zonder referentiemateriaal krijgt u zijn aannames, geen feitencontrole.
Een andere familie dan het geteste model, omdat zelfvoorkeur reëel is en gratis te vermijden. Kleiner dan u denkt, omdat beoordelen classificatie tegen een lange prompt is, geen redenering. Vastgezet, niet zwevend, omdat een provider-alias die automatisch meebeweegt uw kwaliteitsnorm verschuift zonder een codewijziging. En een lagere p99 dan hetgeen het beveiligt, anders wordt de judge uw tail-latency.
Dan de rekensom. Een inline judge is een tweede inferentie; controleer zowel prompt als respons en het zijn er twee. Dat is geen overhead die u weg kunt programmeren, dus de vraag is welk deel van het verkeer u aanpakt:
Als u de regel in code kunt uitdrukken, druk hem dan uit in code.
Ze brengen de offline rubriek over naar het verzoekpad. Een rubriek met tien dimensies die werkt in een nachtelijke run, wordt een trage, variabele blokkade in productie. Online rubrieken moeten één criterium zijn, binair, strak genoeg geformuleerd zodat een klein model het consistent kan beantwoorden.
Ze meten de judge nooit. Het is een model in productie zonder eigen evaluatie. Label handmatig een paar honderd echte voorbeelden en lees precisie en recall afzonderlijk af. Als u de vals-positieve frequentie niet kunt benoemen, kunt u niet benoemen welk percentage van de gebruikers door de guardrail wordt belemmerd.
Ze gaan direct over op blokkeren. Een judge die 90% nauwkeurig is, blokkeert één op de tien goede antwoorden op de dag dat u hem afdwingt. Voer eerst een audit uit, lees een week aan traces en promoveer pas daarna.
Ze vergeten gestreamde responsten. Stream tokens naar de browser en een uitvoer-judge heeft niets om te beoordelen totdat de stream eindigt. De meeste gateways, inclusief TrueFoundry, slaan uitvoer-guardrails over bij streamingverzoeken.
TrueFoundry heeft geen eval-product. Geen eval-pagina, geen datasets, geen experimenttracering, geen scoring-UI. Offline evaluatie hoort thuis op platforms die daarvoor zijn gebouwd, en de rol van TrueFoundry is het exporteren van traces via OpenTelemetry — traces, geen OTEL-statistieken, vanaf dat scherm. Voor een gescoorde dataset en een leaderboard gebruikt u Braintrust, Arize of een gelijkwaardig platform en richt u de exporter daarop.
Wat TrueFoundry implementeert is de online helft: een judge die draait als guardrail in het verzoekpad, waarbij het oordeel, de latentie en de token-uitgaven op dezelfde trace staan als het verzoek dat hij beveiligt.

Elke judge hieronder is een kleine service die u uitrolt, aangeroepen door de gateway als een rail via het custom-guardrail-contract. Dat contract heeft één regel die het onthouden waard is: HTTP 2xx betekent dat de guardrail volledig is uitgevoerd, en de beleidsbeslissing bevindt zich uitsluitend in de JSON-body. De documentatie waarschuwt dat een "geblokkeerd"-signaal als HTTP 400 kan worden gelezen als een runtime-fout en alsnog wordt doorgelaten. Retourneer 2xx met verdict: false.
NeMo draait als een FastAPI-wrapper die is uitgerold op TrueFoundry — geen native NeMo SDK-aanroepen vanaf de gateway, geen client-SDK-wijzigingen in uw app. Intern gebruikt het een kleine judge LLM plus Colang, een domeinspecifieke taal, om prompts en responsten te beoordelen via de self_check_input- en self_check_output-rails. De rubriek bevindt zich in de Colang-bundle, waar config/prompts.yml few-shot-voorbeelden bevat die in v1 DAN-stijl rollenspellen, "negeer eerdere instructies", system-prompt-extractie en policy-bypass-markers opvangen.
Het detail dat operationeel van belang is: de judge LLM roept terug via dezelfde TrueFoundry-gateway. De .env van de wrapper bevat TFY_BASE_URL, TFY_API_KEY en JUDGE_MODEL — het voorbeeld in de documentatie is openai-main/gpt-4o-mini. Omdat de inferentie van de judge gateway-verkeer is, landen de tokens, kosten en latentie in dezelfde dashboards als al het andere, zodat u kunt zien wat guardrails kosten. Het wisselen van judges vereist één regel: wijzig JUDGE_MODEL (de doc toont openai-main/gpt-4o) en rol opnieuw uit.
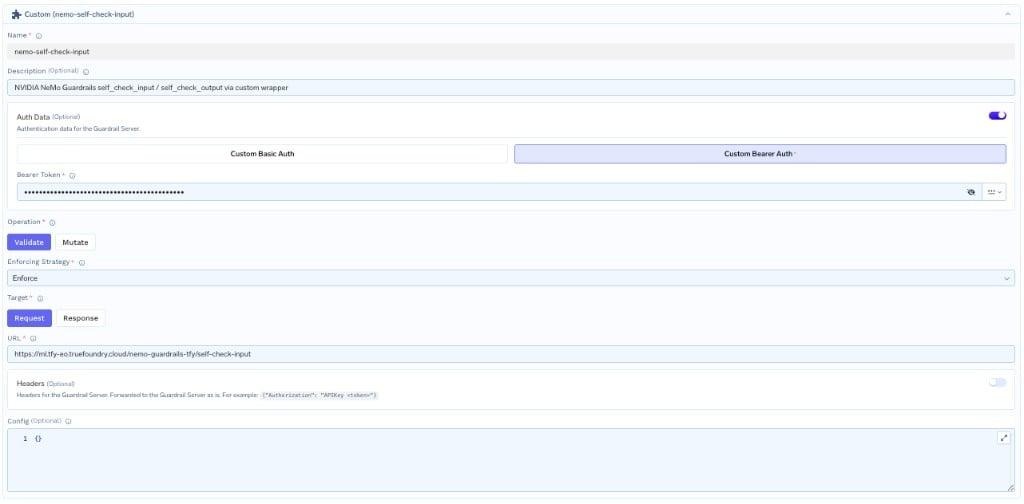
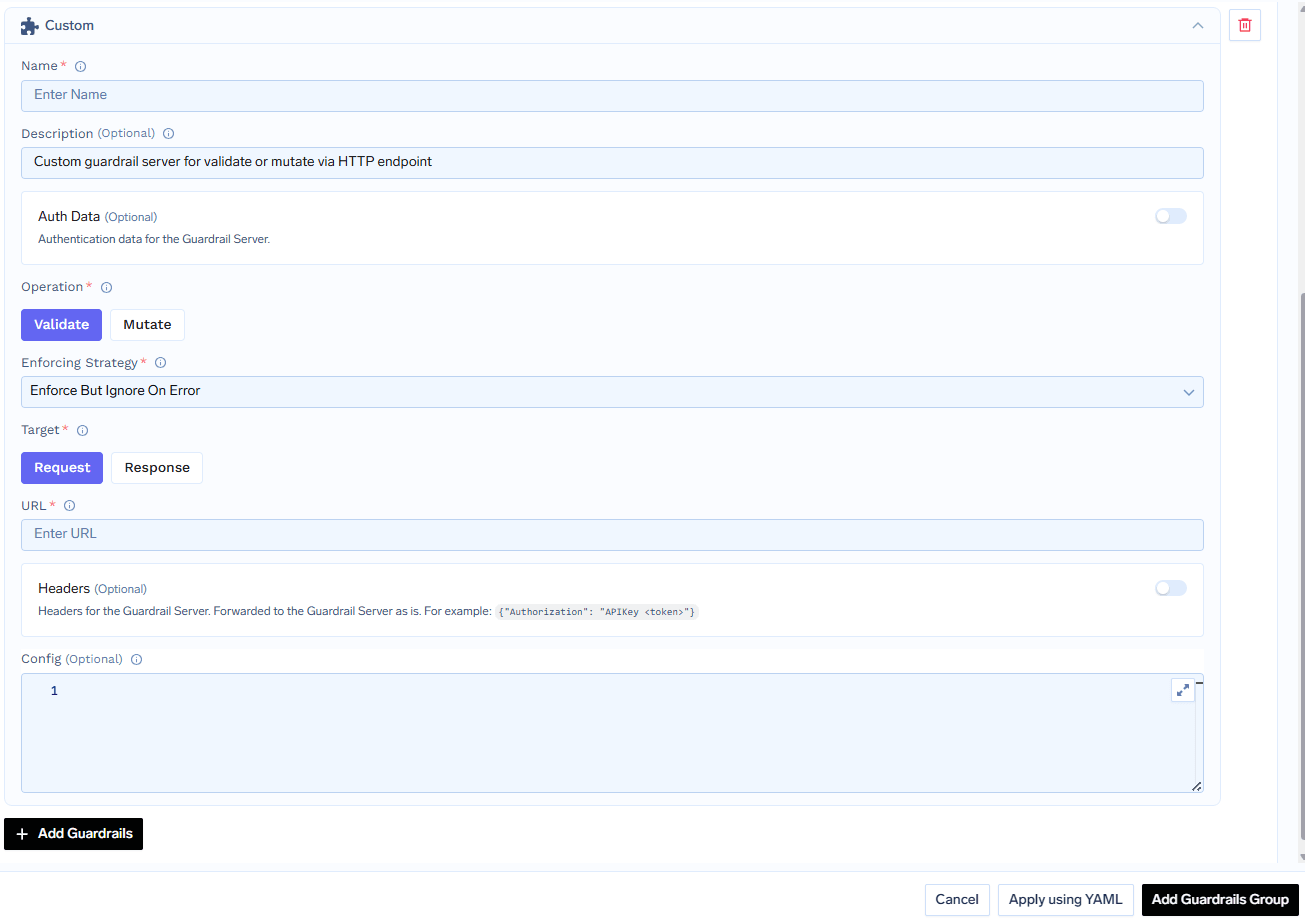
Registreer twee Custom Guardrail Configs, beide Validate — selectors nemo-self-check/nemo-self-check-input en .../nemo-self-check-output — waarbij Enforce But Ignore On Error wordt aanbevolen. Het oordeelcontract is zeer klein: HTTP 200 plus {"verdict": bool, "message": Optional[str]}; een daadwerkelijke storing komt binnen als 5xx.
De gateway verstuurt de invoer-rail-aanroep en de modelaanroep parallel, zodat de judge de time-to-first-token niet verhoogt; bij een blokkade annuleert hij de lopende modelaanroep. De uitvoer-rail draait sequentieel, omdat dat simpelweg moet.
De documentatie is eerlijk over de prijs. Onder bekende beperkingen staat in hun eigen woorden: elk beveiligd verzoek voegt één of twee LLM-aanroepen toe, één per richting. Ze merken ook op dat er geen streaming-bewuste guardrails zijn, omdat het contract gebufferd is, en dat in-memory-status per replica geldt.
Patronus is hetgeen in de catalogus het dichtst in de buurt komt van een kant-en-klare judge, en het is alleen Validate — de operatie is letterlijk "validate", en de documentatie vermeldt dat het niet kan muteren.
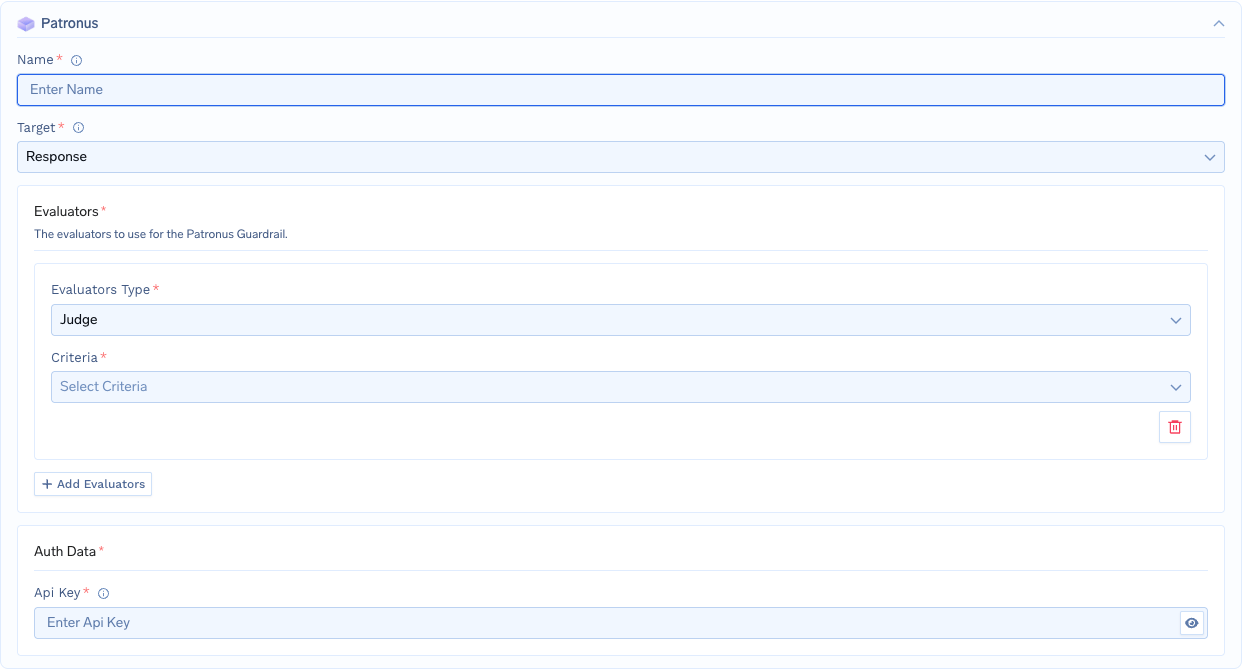
Configuratietype is integration/guardrail-config/patronus. Stel target in op request of response, en som vervolgens evaluators op; er bestaan zes typen — answer-relevance, glider, judge, pii, phi, toxicity. Het type judge is het LLM-as-a-judge-type, en het veld criteria is verplicht. Alle vijftien gedocumenteerde waarden:
De gerelateerde glider-familie voegt er nog vijf toe: patronus:is-compliant, patronus:is-factually-consistent, patronus:is-good-summary, patronus:is-harmful-advice, patronus:is-informal-tone.
Vergeleken met de beslissingstabel hierboven is de verdeling helder: is-json en is-csv zijn formaatcontroles die een validator beter en goedkoper uitvoert, terwijl no-harmful-therapeutic-guidance en is-good-summary de puur prozaïsche criteria zijn waarvoor een judge is bedoeld.
Als data.results[].evaluation_result.pass false is, wordt het verzoek geblokkeerd en wordt er een 400 geretourneerd. De voorbeeldrespons in de doc toont evaluator_id: "judge-large-2024-08-08", evaluator_family: "Judge", profile_name: "patronus:prompt-injection", pass: false, score_raw: 0, evaluation_duration: "PT4.44S", usage_tokens: 687, en evaluation_metadata.highlighted_words. De pagina claimt responstijden van slechts 100 ms; die duur van 4,44 seconden in het voorbeeld herinnert eraan dat de tail van een judge niet zijn mediaan is.
Het grootste deel van Guardrails AI is bewust geen judge. Zijn v1-bundle — DetectPII, SecretsPresent, ToxicLanguage, ProfanityFree over zeven eindpunten — draait lokaal in de wrapper-pod, zonder LLM-roundtrip per verzoek, met een steady-state-latentie van onder de 100 ms.
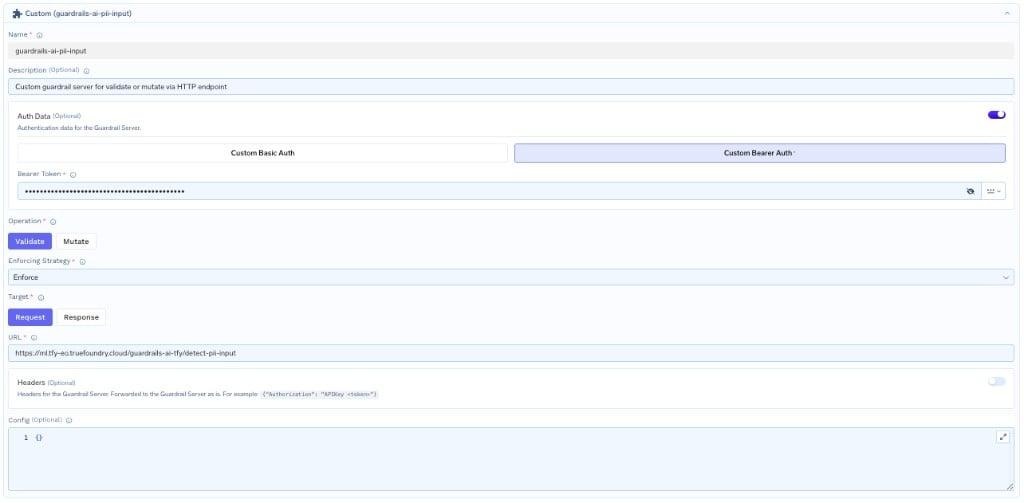
De op judges gebaseerde validators zijn een opt-in-niveau uit de Hub: hub://guardrails/restricttotopic (beoordeeld door LLM), hub://guardrails/provenance_llm — wat in de doc als duur staat gemarkeerd — en hallucination_check. Configureer ze via LITELLM_*-omgevingsvariabelen en routeer ze via uw gateway voor uniforme observeerbaarheid, hetzelfde patroon dat NeMo gebruikt voor JUDGE_MODEL. Goedkope alternatieven staan er direct naast: competitor_check werkt op basis van een allowlist, regex_match is, in de woorden van de doc, goedkoop.
De hallucinatiepagina van TrueFoundry documenteert vier typen — feitelijk, contextueel, logisch en bron — en exact twee implementatiewegen: AWS Bedrock Guardrails, waar u Grounding en Relevance inschakelt, Guardrail Action instelt op Block en een drempelwaarde bepaalt; of een custom guardrail op de repository-template.
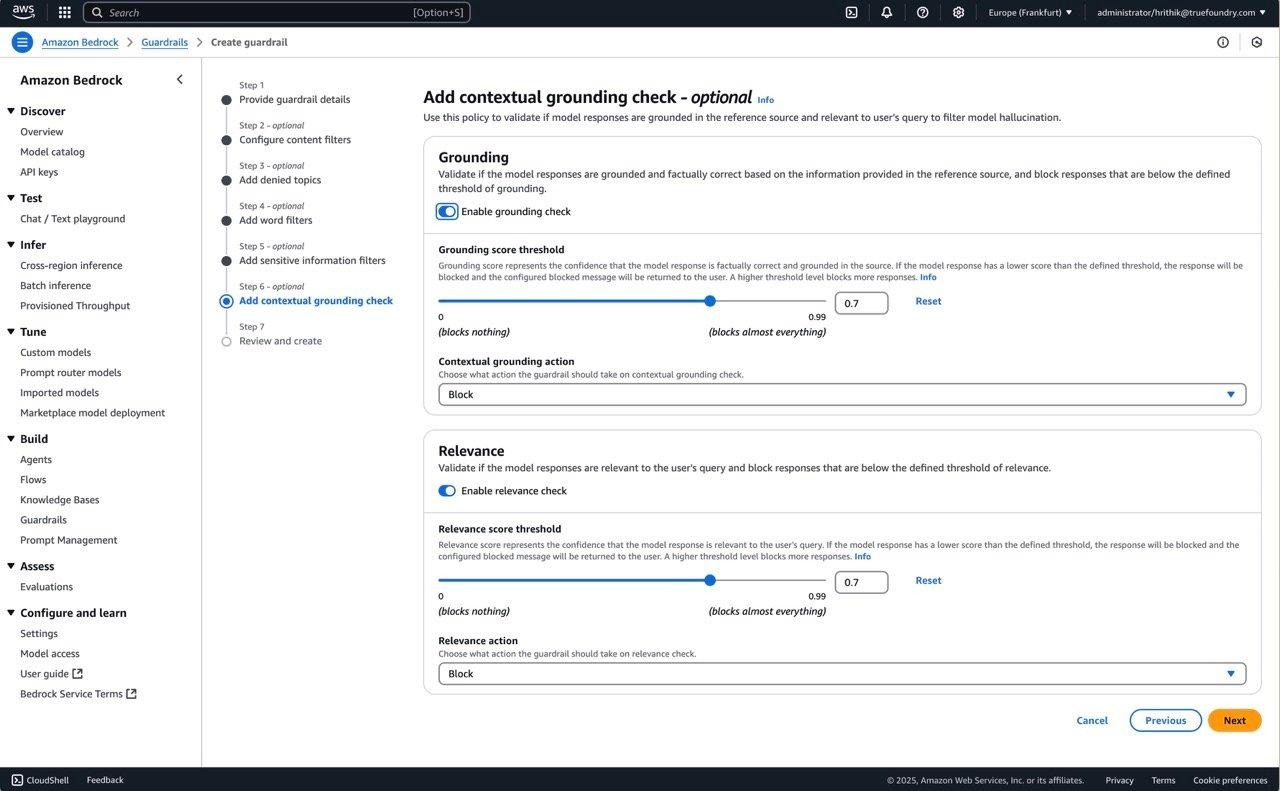
De documentatie vermeldt duidelijk dat de repository-template momenteel standaard geen hallucinatie-guardrail bevat — deze bevat voorbeelden zoals PII-redactie en NSFW-filtering. De custom route vergt daadwerkelijk werk, het is geen eenvoudige instelling.
De Playground voert alle vier de hooks uit, zodat u een kwaadwillige prompt op de invoer-rail kunt afvuren voordat er enig beleid bestaat.
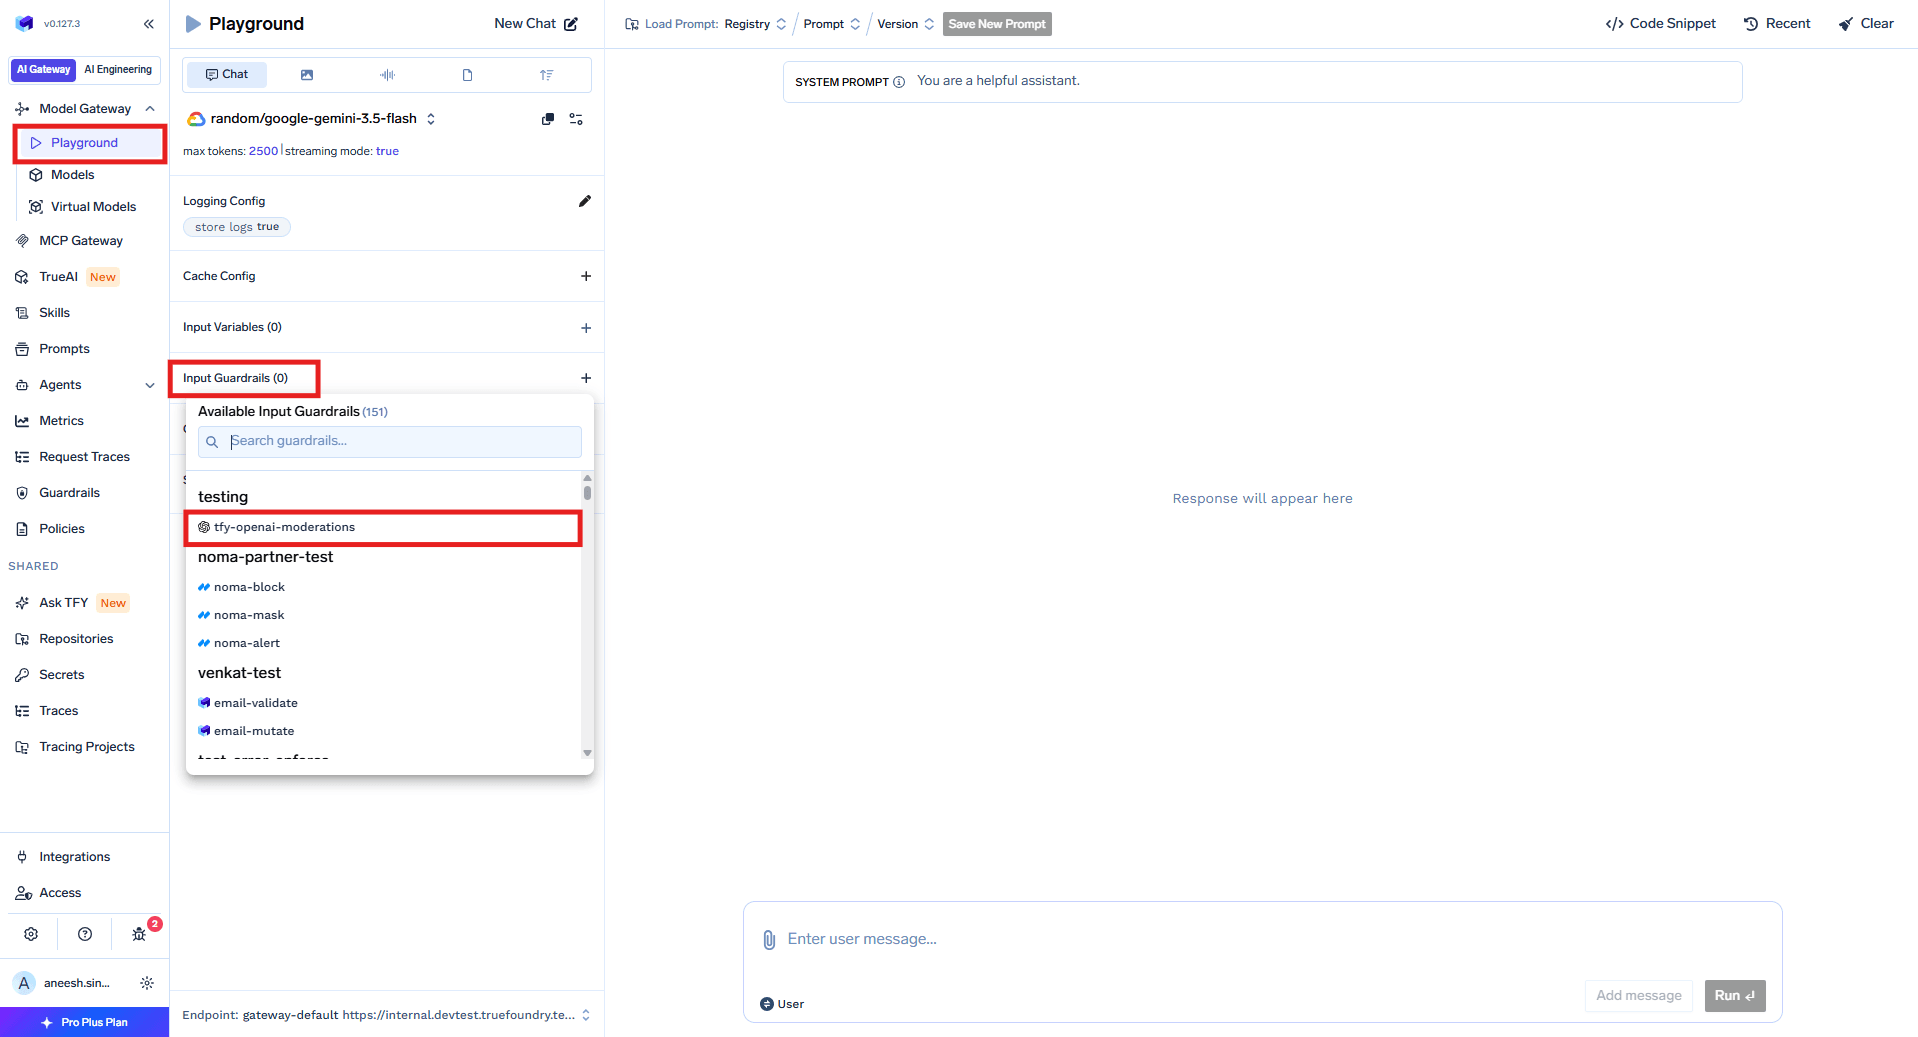
Zodra deze live is, is elke guardrail-evaluatie een eigen span in Monitor → Request Traces met uitvoeringstijd, resultaat, scope, invoer en uitvoer — ook gelogd voor geblokkeerde verzoeken, zodat een geweigerde aanroep bewijsmateriaal is in plaats van een ontbrekend gegeven.

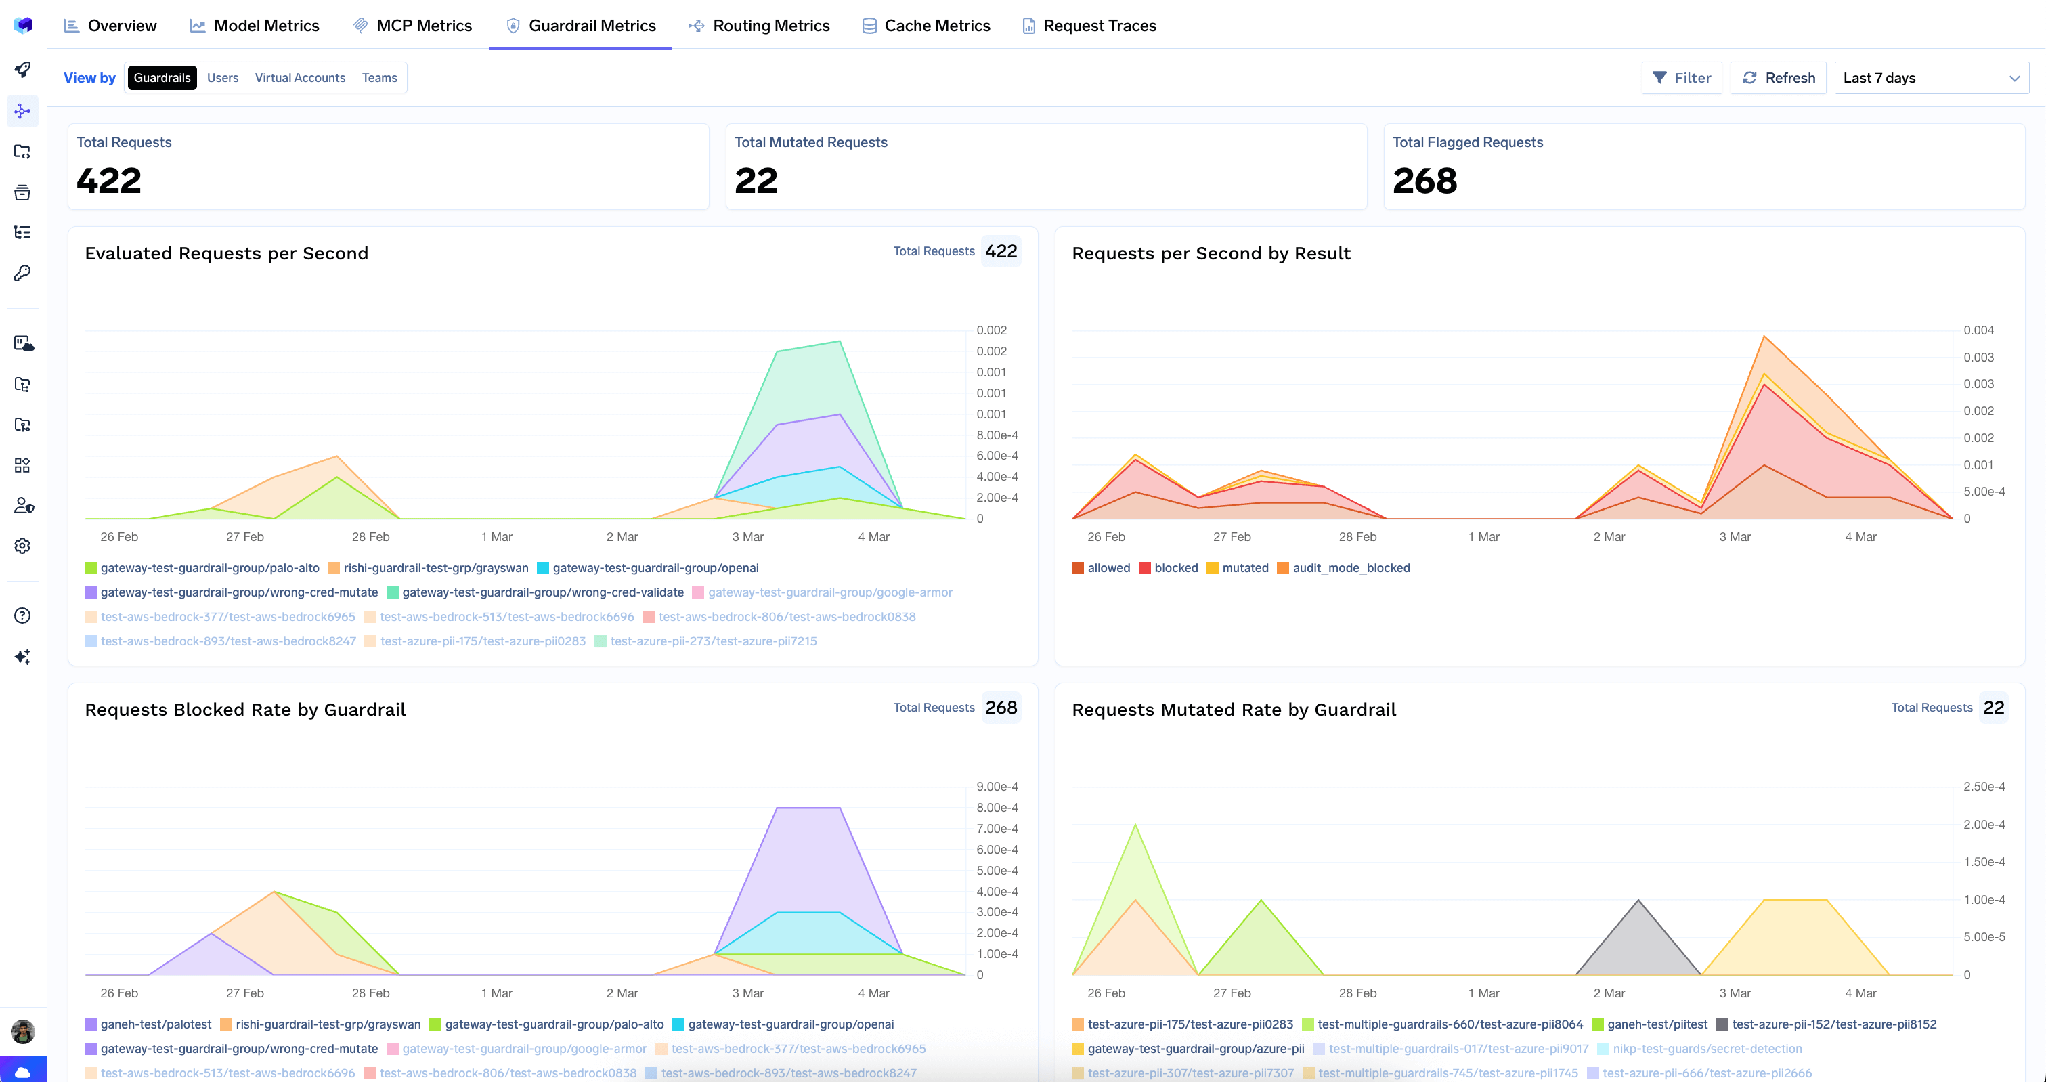
In de weergave van het Metrics Dashboard splitst de guardrail-weergave verzoeken per seconde op tussen allowed, blocked, mutated en audit_mode_blocked, met block- en mutate-percentages per guardrail en guardrail-latentie op P50, P75, P90 en P99. Die laatste grafiek is de manier om een judge te ontdekken waarvan de tail uw tail is geworden.
Het oordeel van een judge is een bewering over kwaliteit, en de enige manier om dit te testen is aan de hand van een menselijk oordeel over hetzelfde verzoek. Elke AI Gateway-respons bevat een x-tfy-feedback-target-id header. Verstuur deze naar POST https://{control_plane_url}/api/svc/v1/gateway-feedback met {"target": {"feedbackTargetId": "<base64>"}, "rating": 4, "comment": "...", "metadata": {...}} — beoordeling loopt van 1 (laagst) tot 5 (hoogst) — en u ontvangt {"data": {"id": "..."}} terug. Correcties gebruiken PUT .../gateway-feedback/{feedback_id}, verwijderingen DELETE. Feedback wordt getoond naast de span, en de volledige lijst staat in Raw Data onder tfyGatewayFeedbacks.
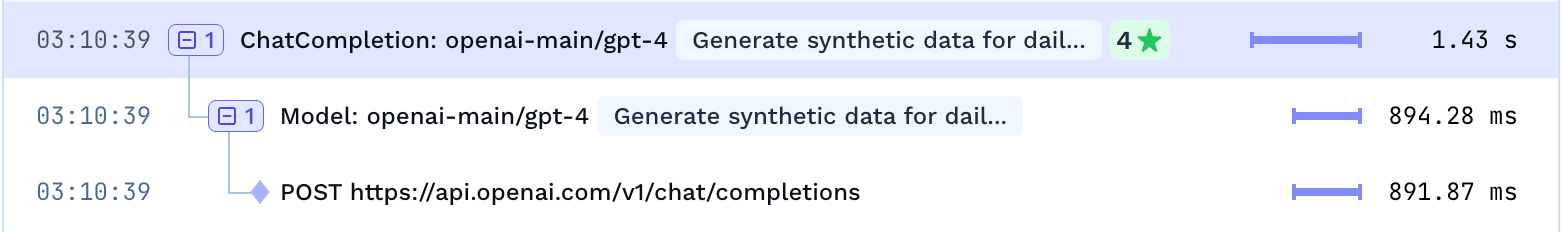
Eén beperking: het target ID heeft uitsluitend betrekking op de root span. Feedback komt terecht op het verzoek, niet op een tussenstap.
Een interne assistent beantwoordt vragen van zorgcoördinatoren. Compliance eist twee dingen: nooit schadelijk therapeutisch advies, en een klinisch passende toon. Geen van beide kan worden uitgedrukt als een regex, dus dit is het terrein voor een judge.
1. Kies de meest specifieke rubriek. Twee Patronus-judge-criteria, geen tien — patronus:no-harmful-therapeutic-guidance en patronus:clinically-inappropriate-tone, met target: response. De rest van de compliance-lijst gaat naar de goedkope detectors.
2. Start in Audit. Een beleidsregel onder AI Gateway → Policies → Guardrails beperkt dit tot de modellen van de assistent en het zorgcoördinatieteam, met de handhavingsstrategie Audit: log het oordeel, blokkeer niets.
3. Lees een week aan traces. audit_mode_blocked vertelt u hoeveel echte verzoeken deze regel zou hebben geblokkeerd; evaluation_metadata.highlighted_words vertelt u waarom. Typisch slaat het toon-criterium aan op goede antwoorden die toevallig erg bondig zijn.
4. Vergelijk met menselijke beoordelingen. De duimknop van de assistent is gekoppeld aan de feedback-API via x-tfy-feedback-target-id. Als de gesignaliseerde verzoeken de verzoeken zijn die mensen een 1 of 2 hebben gegeven, bewijst de judge zijn nut. Zo niet, pas dan de rubriek aan, niet de drempelwaarde.
5. Promoveer, en houd de rekening in de gaten. Schakel over naar Enforce But Ignore On Error zodat een storing bij Patronus leidt tot een onbeveiligde uitvoering in plaats van een storing in uw eigen dienst. Patronus rapporteert usage_tokens per evaluatie en inferentie van de judge wordt via de gateway gerouteerd, waardoor de kosten van het beoordelen zichtbaar zijn in plaats van geschat — en dat getal bepaalt uw steekproeffrequentie.
Uitvoer-guardrails worden overgeslagen bij gestreamde responsten. Met "stream": true draaien uitvoer-rails niet; invoer-rails draaien altijd. Als uw product streamt, beveiligt uw judge de prompt en verder niets.
Systeemprompts worden nooit gezien door guardrails. De gateway verwijdert deze voordat inhoud naar een guardrail wordt gestuurd, met CrowdStrike AIDR als de enige gedocumenteerde read-only uitzondering. Een judge kan niet beoordelen of uw instructies zijn opgevolgd.
Uitvoervalidatie kost u nog steeds de modelaanroep. Als een invoer-rail halverwege mislukt, kan de gateway het verzoek annuleren. Een uitvoer-rail draait nadat de respons bestaat, en de documentatie merkt op dat modelkosten op dat moment al zijn gemaakt.
LLM as a judge is een goede techniek met een specifiek, juist toepassingsgebied. Het is de enige manier om subjectieve tekst op schaal te beoordelen, en het heeft een bias naar lange antwoorden, naar de output van zijn eigen familie, en naar de kandidaat die als eerste komt. Een team dat alleen het eerste deel gelooft, rolt een guardrail uit die stilzwijgend zijn eigen gebruikers blokkeert.
De verdeling die het hanteerbaar maakt, is de verdeling waarmee dit artikel begon. Offline scoring is een datasetprobleem dat thuishoort op een eval-platform, waarbij TrueFoundry daar via OTEL traces naartoe exporteert. Online gating is een probleem in het verzoekpad: één strak criterium, een kleine vastgezette judge uit een andere familie, eerst audit-modus, precisie boven recall, en eerlijk inzicht in de kosten.
Schrijf de regel als code waar dat kan. Waar u deze alleen als een zin kunt schrijven, gebruikt u een judge — en meet u deze zoals het model dat het is.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Using one language model to score another’s output against a written rubric, returning a machine-readable verdict — pass/fail, a score, or a preference between candidates. It exists because open-ended text has no computable correctness metric, and it is best treated as a cheap, noisy proxy for a human rater.
For narrow, binary, tightly worded criteria, often yes; for broad quality rubrics, usually not. Measure precision and recall separately on hand-labelled examples first — a judge that is 90% accurate blocks roughly one in ten legitimate answers the day you enforce it.
At least one extra model call per guarded request, and two if you judge both prompt and response — TrueFoundry’s NeMo docs state that arithmetic explicitly. The only lever is coverage: sample for telemetry, reserve full coverage for the checks that must never miss.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Roughly 3-4 ms, sustaining 350+ RPS on a single vCPU across 1,000+ LLMs. Guardrail time is separate and reported at P50, P75, P90 and P99.
Ja. De gateway is OpenTelemetry-compliant en exporteert traces naar externe backends, wat hoe gatewaydata platforms zoals Braintrust, Langfuse of Arize bereikt. TrueFoundry voert zelf geen offline scoringtaken uit.



Het laatste nieuws, artikelen en bronnen in je inbox



















