



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
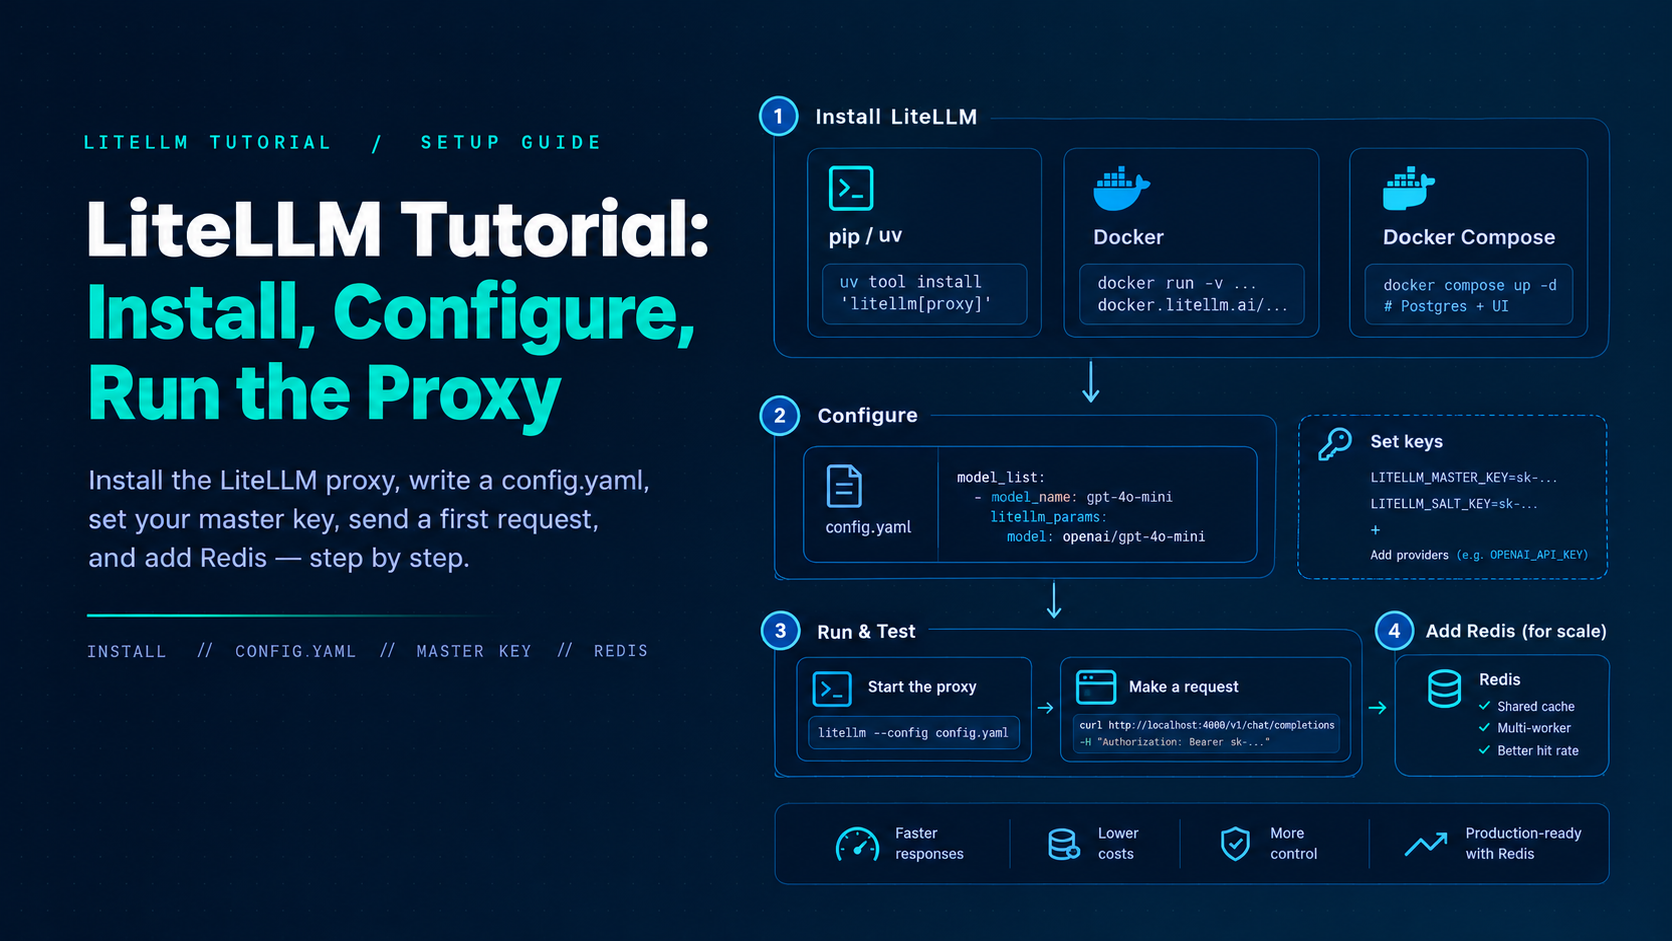
Deze LiteLLM-handleiding leidt platform engineers door het installeren van de proxy, het schrijven van een minimale config.yaml, het instellen van de master key, het verzenden van een eerste OpenAI-SDK-verzoek, het toevoegen van modellen, het inschakelen van Redis voor multi-worker-opstellingen, en het vermijden van de misconfiguraties die in de eerste week van productie verschijnen. Commando's volgen de officiële LiteLLM-quickstarts. Zet versies vast wanneer je verder gaat dan een laptop—LiteLLM brengt ongeveer wekelijks minor-versies uit. Nieuw met dit patroon? Begin met wat een LLM gateway is en waarom platformteams er een voor model providers plaatsen.
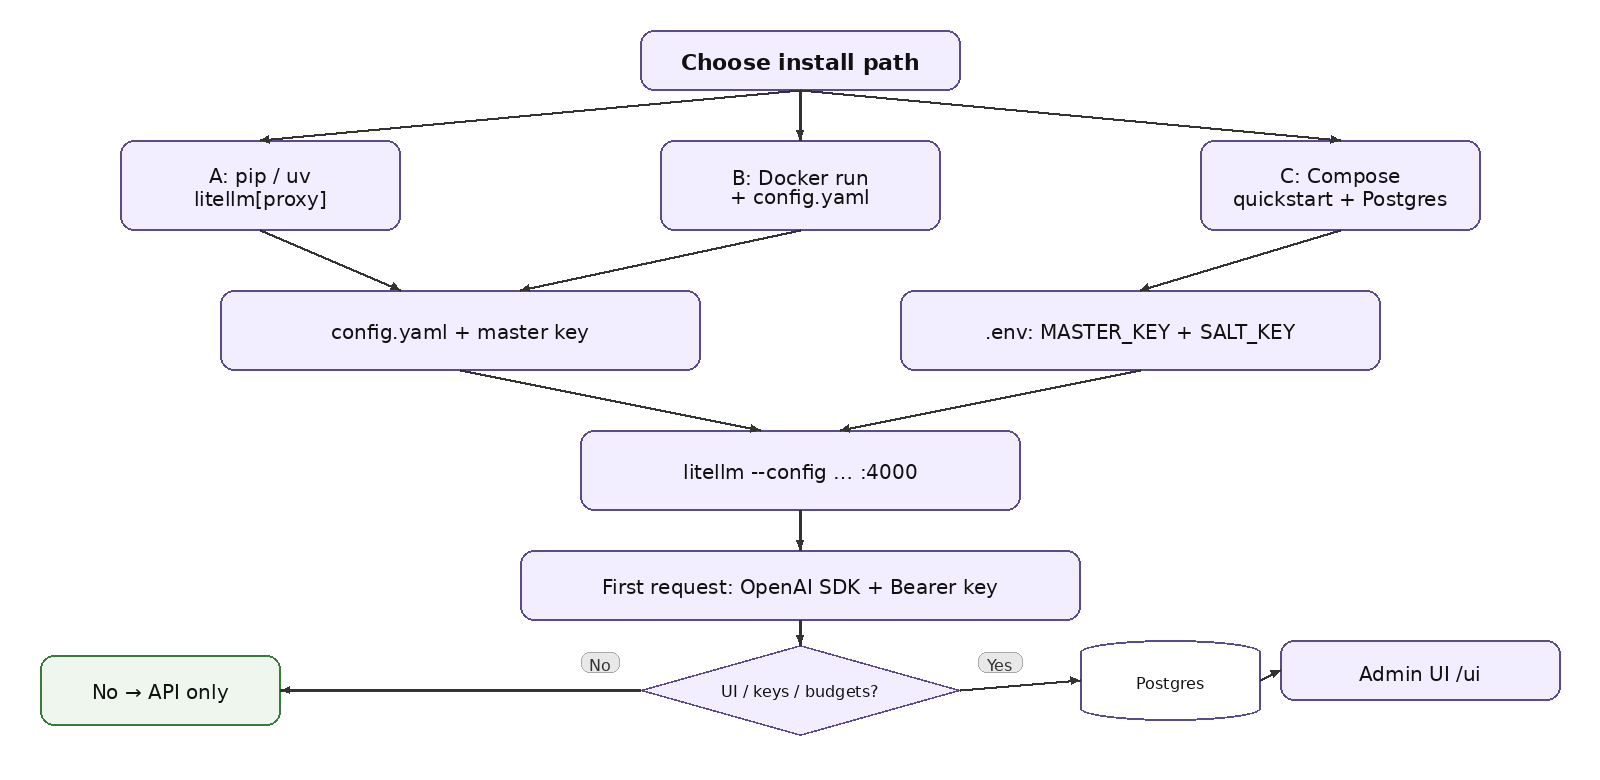
(gateway op jouw machine)Officiële gateway quickstart installeert de proxy-extras met uv:
Gelijkwaardig:
Exporteer minimaal één provider sleutel (bijvoorbeeld OPENAI_API_KEY), maak config.yaml aan (volgende sectie), en start vervolgens met:
De proxy luistert standaard op 0.0.0.0:4000. Dit pad is ideaal voor lokale iteratie; voor gedeelde omgevingen heeft het de voorkeur om containers met vastgezette tags te gebruiken.
Als je alleen de OpenAI-compatibele API nodig hebt—geen Admin UI modelbeheer, virtuele sleutels of uitgavenmonitoring—voer dan de gepubliceerde image uit met een gekoppelde config. Officiële voorbeeldstructuur:
Verzoeken authenticeren met de master key. Gebruik bij voorkeur een vastgezette tag (productiedocumentatie toont ghcr.io/berriai/litellm:main-stable of expliciete v1.x.x-tags)—vermijd :latest voor alles wat gedeeld wordt. Houd rekening met de gedocumenteerde waarschuwing: zonder database dwingen budgetinstellingen zoals litellm_settings.max_budget geen harde uitgavenlimiet af zoals teams verwachten, en zijn virtuele sleutels niet beschikbaar.
Voor de volledige control-plane-ervaring, de officiële Docker quickstart:
Dat brengt de gateway op poort 4000 en Postgres voor modellen, sleutels en uitgavenlogs in de lucht. Compose weigert te starten zonder master- en salt-sleutels. Houd .env duurzaam: het opnieuw genereren van LITELLM_SALT_KEY maakt referenties die al in de database zijn opgeslagen onleesbaar totdat je ze opnieuw invoert. Bewerk het compose-bestand om een release-tag vast te zetten voor elk gedeeld gebruik.
Een minimale model_list-invoer koppelt een openbare model_name (wat clients aanvragen) aan litellm_params (provider route + secrets). Voorbeeldpatroon uit documentatie:
Andere blocks op het hoogste niveau: router_settings (routing_strategy, Redis voor gedeelde router-status), litellm_settings (request_timeout, cache, drop_params, json_logs, set_verbose), en environment_variables. Gebruik bij voorkeur os.environ/...-referenties in plaats van secrets direct in de YAML te plakken. Bij meerdere implementaties van dezelfde model_name verdeelt de router de belasting; stel rpm/tpm in op deployments als je wilt dat de proxy de rate envelopes van de provider respecteert. Voor het bredere routingbeeld—strategieën, fallbacks en cooldowns—raadpleeg onze gids over LLM load balancing.
Stel de master key in:
export LITELLM_MASTER_KEY="sk-<long-random-value>"
Best practices voor productie vereisen het sk--prefix. De master key authenticeert admin API-aanroepen en is het standaard Admin UI-wachtwoord. Iedereen die deze sleutel bezit, heeft volledige beheerderstoegang—behandel deze als een root-wachtwoord, sla deze op in je secret manager en roteer met de officiële master-key-rotatieflow.
Als je een database gebruikt, stel dan ook LITELLM_SALT_KEY in voordat je modellen toevoegt in de UI. Het versleutelt opgeslagen provider-referenties (NaCl SecretBox afgeleid van de salt, volgens de beveiligings-FAQ). Er is geen eenvoudige rotatie ter plaatse: het later wijzigen maakt opgeslagen sleutels onleesbaar. Als er geen salt key is ingesteld, valt de master key terug als de versleutelingssleutel, wat het roteren van de master key koppelt aan het opnieuw versleutelen van referenties. Stel vroegtijdig een permanente salt key in.
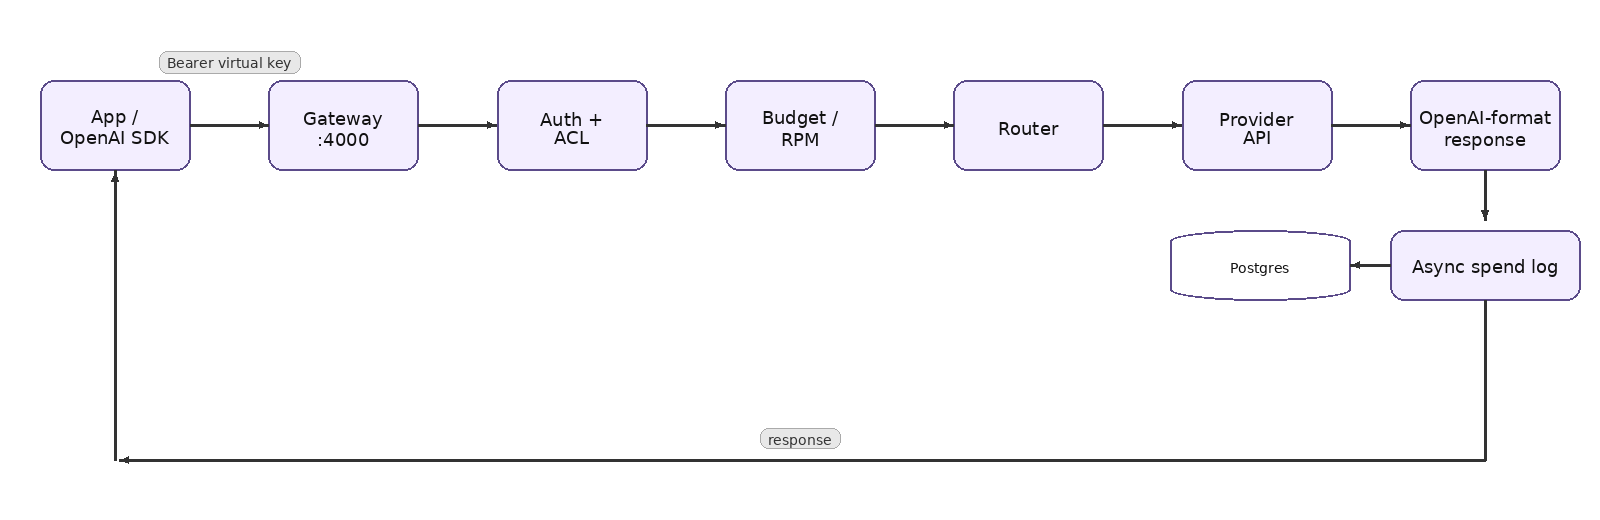
curl-voorbeeld (officiële quickstart-structuur):
Python OpenAI SDK:
Bij een Docker-run op basis van alleen een configuratie zonder virtuele sleutels is de master key het Bearer credential. Op het Compose/UI-pad maak je een virtuele sleutel aan en gebruik je die in applicaties—verspreid de master key niet naar elke microservice. JS/TS-clients gebruiken baseURL + apiKey op dezelfde manier.
Open http://localhost:4000/ui. Gebruikersnaam is admin; wachtwoord is je LITELLM_MASTER_KEY-waarde uit .env (volgens de Docker quickstart). Mislukte UI-inlogpogingen worden op basis van het bronadres qua frequentie beperkt; stel general_settings.trusted_proxy_ranges in op de CIDR's van je load-balancer (of [] als clients rechtstreeks verbinden), zodat de proxy het echte client-IP kent. Indien dit niet is ingesteld, waarschuwt de proxy volgens de documentatie bij het opstarten en geldt er slechts een zwakkere limiet per gebruikersnaam.
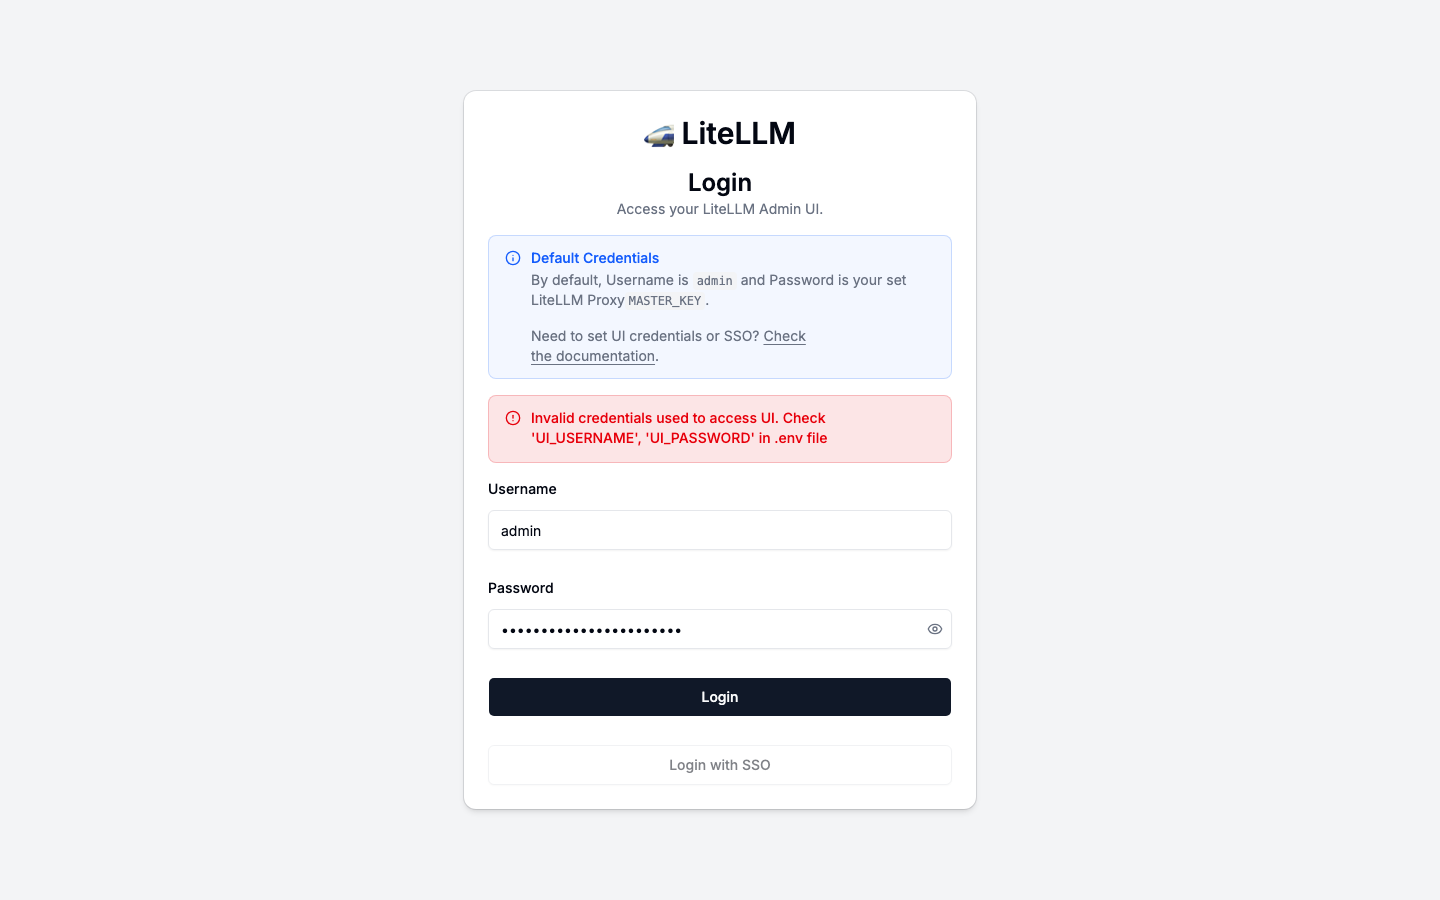
Enterprise-implementaties moeten UI-inloggen verplaatsen naar SSO (Okta, Azure AD, Google Workspace, OIDC/SAML) in plaats van de master key te delen als een menselijk wachtwoord. Bewaar de master key in een secrets manager voor break-glass admin API-gebruik. SSO is volgens de documentatie gratis tot vijf gebruikers; daarboven is een enterprise-licentie vereist.
UI-pad (met DB-ondersteuning): Models + Endpoints → Add Model → kies provider, plak of verwijs naar os.environ/PROVIDER_KEY, Test Connect, Add Model. Gebruik bij voorkeur in de omgeving gekoppelde provider-sleutels wanneer je beveiligingsmodel vereist dat sleutels buiten de UI-database blijven.
Ga vervolgens naar Virtual Keys → Create New Key → kopieer deze eenmalig. Koppel budgetten, RPM/TPM en model-allowlists naar behoefte. YAML-pad: voeg model_list-invoeren toe en herstart (of vertrouw op GitOps). Als store_model_in_db true is, worden via de UI toegevoegde modellen overlapt via DB-polling (standaard ~30s, aanpasbaar via proxy_config_reload_interval_seconds). Vermijd dubbele model_name-invoeren in YAML en DB die onverwachte extra deployments veroorzaken.
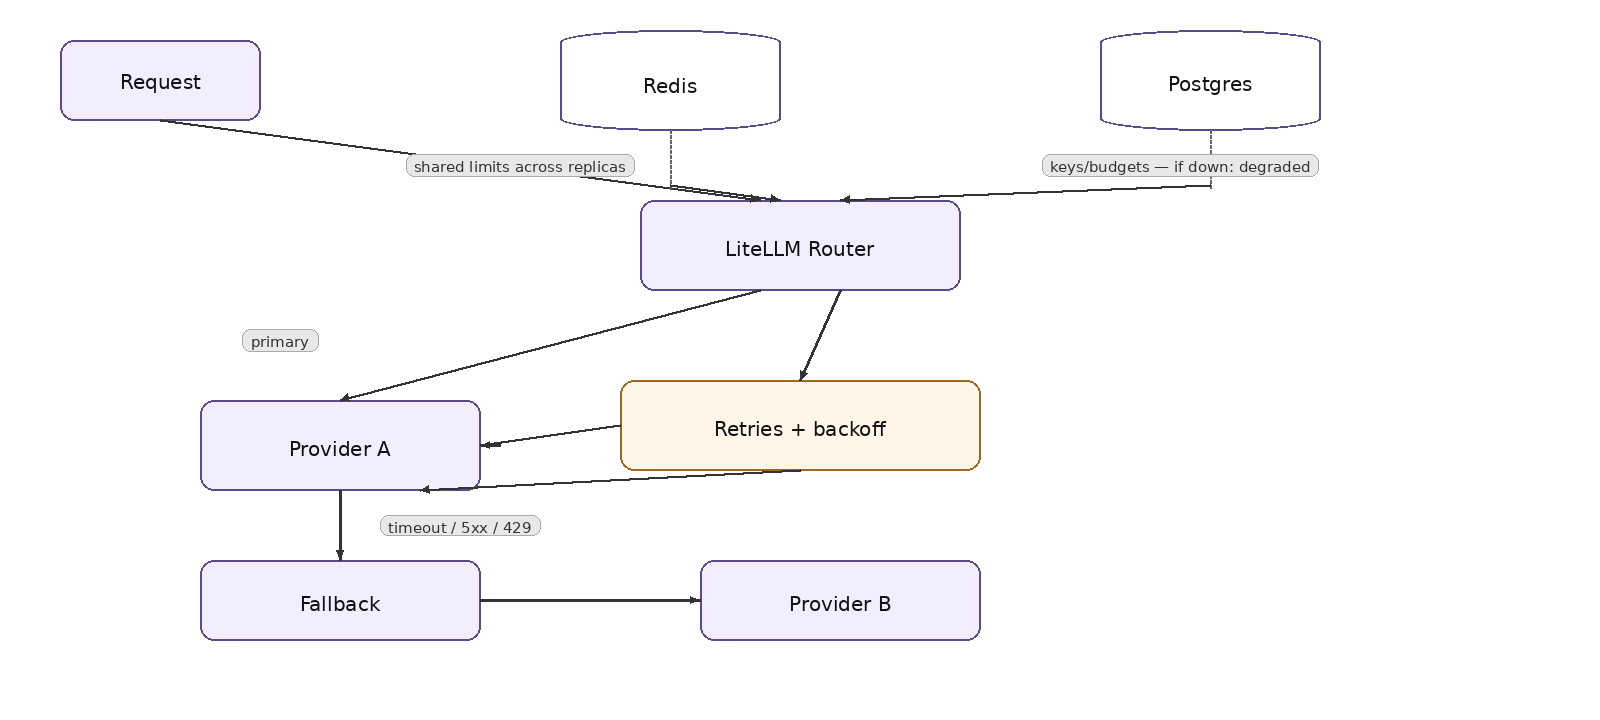
Een enkele worker op een laptop kan Redis overslaan. Zodra je --num_workers > 1 instelt of twee pods uitvoert, configureer je Redis voor zowel router_settings als litellm_settings.cache_params. Alleen het instellen van REDIS_HOST in de omgeving is niet voldoende—de configuratie moet de proxy naar Redis verwijzen. Officieel over “Wanneer is Redis nodig”: zonder Redis staat een limiet van 100 RPM over vier workers effectief ~400 toe, kunnen ingetrokken sleutels op andere workers blijven hangen en blijven respons-cache-hits lokaal.
Voorbeeldstructuur uit productiedocumentatie:
Op Kubernetes adviseren productietips één Uvicorn worker per pod (~1 vCPU / 4Gi ondergrens per worker) en horizontale schaalbaarheid. Gebruik LITELLM_JOB_ROLE=serving op traffic pods en een enkele worker role replica voor achtergrondtaken met één eigenaar (budget-resets, opschonen van uitgaven) wanneer je veel replica's uitvoert. Houd de standaard simple-shuffle routing-strategie aan voor hoog verkeer; op gebruik gebaseerde routing voegt Redis-lookups toe aan het verzoekpad.
Verwijs elke interne service naar de gateway base_url; geef virtuele sleutels per team of per app uit met model-allowlists en budgetten; bewaar provider-sleutels alleen op de gateway; bewaak uitgaven in de UI of via logging callbacks; stel meldingen in op vastlopende verzoeken en het overschrijden van budgetten (Slack-almering is gedocumenteerd onder general_settings.alerting). Behandel configuratie en secrets als productie-configuratiebeheer—niet als een bijproject in een notebook.
Wanneer je Compose ontgroeit, stap dan over op Helm (monolithische litellm-helm) of de gecomponenteerde chart / Terraform-modules (gateway + backend + UI) in de officiële implementatiedocumentatie. Zet versies vast, voer migraties uit via de gedocumenteerde job/hook, en houd een staging-proxy op dezelfde minor-versielijn die je gaat promoten. LiteLLM ondersteunt de vier meest recente stabiele minor-versielijnen (beleid van kracht vanaf 2026-06-29)—plan upgrades voordat je versielijn veroudert.
Na installatie: (1) curl /health/readiness op :4000, (2) chat completion met master of virtuele sleutel, (3) log in op /ui indien door DB ondersteund, (4) maak een tweede virtuele sleutel aan met een zeer lage max_budget en bevestig het gedrag bij budgetoverschrijding, (5) bij multi-replica, curl /cache/ping en bevestig Redis, (6) trek een sleutel in en bevestig dat andere replica's deze weigeren binnen je auth cache TTL. Die volgorde ondervangt de meeste “het is gestart maar het beheer is nep”-problemen.
Je hebt nu een werkende LiteLLM-proxy: geïnstalleerd, geconfigureerd via config.yaml, beveiligd met een master- en salt-sleutel, en bereikbaar vanaf elke OpenAI SDK-client. Voeg voor productie Postgres toe voor sleutels en uitgaven, Redis voor gedeelde status, vastgezette image-tags, en de bovenstaande optimalisatieknoppen—voer vervolgens de verificatievolgorde uit bij elke upgrade.
Als je die stack liever niet zelf beheert, bekijk dan hoe de AI Gateway van TrueFoundry routing, sleutels en observability afhandelt →
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Install the proxy extras with uv tool install 'litellm[proxy]' (or pip install 'litellm[proxy]' in a virtualenv), write a config.yaml with a model_list, and start it with litellm --config config.yaml. The proxy listens on port 4000 by default. If you need the Admin UI, virtual keys, and spend tracking, use the Docker Compose quickstart, which adds Postgres.
Stel de base_url van de client in op de proxy (bijvoorbeeld http://localhost:4000 of uw ingress) en geef een virtuele LiteLLM-sleutel door als api_key. Het model-veld is de publieke model_name uit config.yaml, en antwoorden komen terug in OpenAI-formaat. Bij een configuratie-only run zonder database is de master key de Bearer-credential, maar apps moeten in elke gedeelde opzet virtuele sleutels krijgen.
Without shared Redis, each worker or replica keeps its own rate-limit counters, router state, and cache. A 100 RPM limit across four workers then effectively allows about 400, revoked keys can linger on other workers, and cache hits stay local. Configure Redis in both router_settings and litellm_settings.cache_params—setting REDIS_HOST in the environment alone is not enough.
1,000+ LLMs through a single OpenAI-compatible API. Switching models means changing the model name in the request — same URL, same credentials — which is what makes swapping in a new provider a configuration change rather than an integration project.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Elk verzoek wordt getraceerd van prompt tot modeluitvoering, zodat metrics zoals latentie, kosten en fouten naast uw bestaande dashboards terechtkomen.



Het laatste nieuws, artikelen en bronnen in je inbox



















