



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Als je kijkt naar alternatieven voor Deep Agents, is dat waarschijnlijk niet omdat deepagents slecht is. Dat is het niet. LangChain heeft een van de meest complete open-source agent harnesses gebouwd, en als je al LangGraph gebruikt, biedt het direct out-of-the-box planning, een virtueel bestandssysteem, subagent-delegatie, contextbeheer, geheugen, vaardigheden, code-uitvoering en human-in-the-loop-ondersteuning.
Maar die compleetheid brengt compromissen met zich mee. De scaffolding en geaccumuleerde context kunnen aanzienlijke token-overhead veroorzaken bij langlopende taken, terwijl het Python-library-oppervlak beperkend kan zijn als je een HTTP API of een inbedbare UI nodig hebt. En omdat deepagents gebouwd is op LangGraph, verbind je je ook aan het ecosysteem en de abstracties daarvan.
Dat is waarom teams alternatieven beginnen te evalueren — niet om deepagents direct te vervangen, maar om een harness te vinden dat beter aansluit bij hun kosten-, prestatie-, deployment- of integratie-eisen.
Deze gids vergelijkt de vijf beste Deep Agents alternatieven, wat elk anders doet en waar elk het meest logisch is.
Tokens per voltooide run, niet tokens per beurt. Dit is het getal dat op je factuur terechtkomt, en harnesses die hetzelfde model op dezelfde taak draaien kunnen wel 4x verschillen. Beoordeel op kosten per correct antwoord.
Hoe het context verwerkt. Compactie, uitgestelde tool-loading en response offloading zijn wat langlopende runs betaalbaar houdt. Replay is wat ze duur maakt.
ToepassingsOppervlak. Library, HTTP API, SDK, inbedbare UI. Wees eerlijk over welke van deze je over twaalf maanden nodig zult hebben, niet alleen vandaag.
Sandbox-economie. Always-on containers betekenen dat je betaalt voor isolatie bij beurten die nooit code uitvoeren. On-demand provisioning verandert de rekensom op grote schaal.
Wat migratie werkelijk kost. Als je tools MCP servers zijn, verhuizen ze ongewijzigd mee. Het werk zit in alles wat je specifiek aan LangGraph hebt gekoppeld.
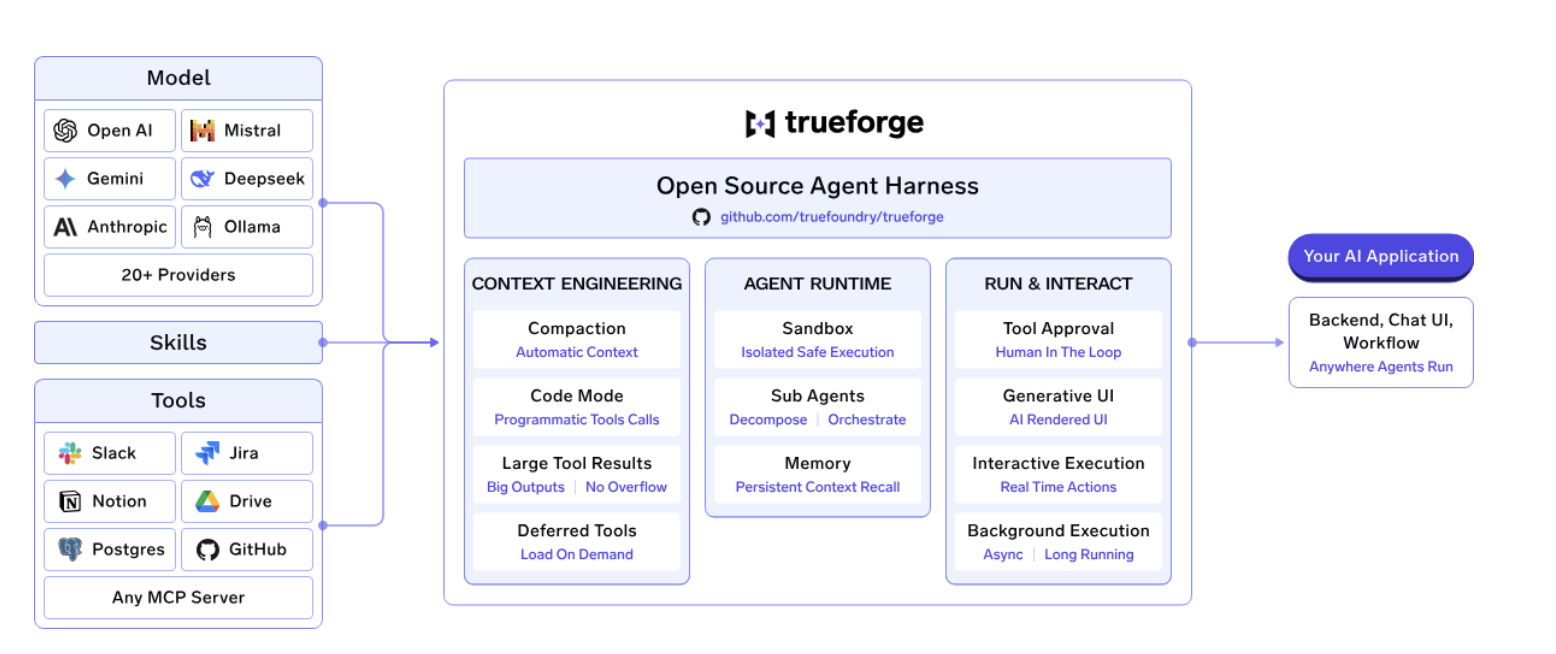
LangChain Deep Agents lost veel van het zware werk op binnen een individuele agent, waaronder planning, subagents, bestandssysteemtools, vaardigheden, geheugen en langlopende uitvoering. Maar zodra je agents over meerdere teams heen draait, verschuift het probleem van het bouwen van de agent naar het beheren van de vloot.
TrueForge is TrueFoundry's open-source, leveranciersneutrale agent harness voor die runtime-laag. Het draait de agent loop rond het model, inclusief planning, tool calls, contextbeheer, goedkeuringen en session state, terwijl je je eigen modellen, MCP servers en sandbox-providers kunt meebrengen.
De architectuur is opgedeeld in drie delen: een core server die de agent loop draait, een HTTP API en TypeScript SDK voor programmatische toegang, en een chat UI met een React UI SDK die rechtstreeks gebruikt of ingebed kan worden in een applicatie.
Je kunt het lokaal draaien met npx @truefoundry/trueforge, of dezelfde harness deployen voor een team met Docker Compose of Helm.
Bekijk de TrueForge documentatie.
TrueForge biedt ook verschillende mechanismen om de hoeveelheid context en tool-data die het model bereikt te controleren.
Uitgestelde tool-loading betekent dat MCP tool schemas op verzoek laden in plaats van vooraf het venster te vullen. Code Mode laat de agent meerdere tool calls ketenen binnen één sandbox script, zodat alleen de afgedrukte samenvatting in de context komt in plaats van elk tussenresultaat. Tegrote tool-responses worden ge-offloaded naar een sandbox-bestand en vervangen door een pad en een voorbeeld. Compactie treedt in werking bij 80% van de contextlengte van het model en vervangt oude geschiedenis door een gestructureerde samenvatting, wat het directe antwoord is op replay. Subagents draaien met hun eigen schone context en leveren alleen het resultaat terug.
Het sandbox-model is de andere knop om aan te draaien. De meeste harnesses wikkelen de gehele sessie in een container. TrueForge behandelt de sandbox als een tool en start er pas een op wanneer de agent daadwerkelijk code moet uitvoeren, waardoor één server veel agents tegelijk draait en beurten die nooit code aanraken goedkoop blijven.
TrueForge is ook gestructureerd als een runtime in plaats van alleen een library-interface.
De core server draait de agent loop en biedt streaming, goedkeuringspoorten, subagent-delegatie, compactie en persistente sessies. Een HTTP API en TypeScript SDK (@truefoundry/trueforge-sdk) stellen dezelfde functionaliteiten programmatisch beschikbaar. Een afzonderlijke chat UI en UI SDK (@truefoundry/trueforge-ui) kunnen rechtstreeks worden gebruikt, van een thema worden voorzien of worden ingebed in een ander product.
Dit geeft teams een deployment-oppervlak voorbij de Python agent-definitie zelf: dezelfde runtime kan een applicatie, API of ingebedde agent-ervaring aansturen.
Modellen, MCP servers en sandbox-providers zijn allemaal bring-your-own. Wanneer een goedkoper model uitkomt, verwijs je daarnaar in plaats van de agent opnieuw te schrijven; dit is hoe dezelfde benchmark-run op GLM-5.2 dezelfde ~11 van de 14 taken oploste voor $2.90 per run.
Het verschil tussen een agent framework en een agent runtime wordt duidelijker wanneer je ze vergelijkt op dezelfde workloads. TrueFoundry heeft TrueForge en Deep Agents gebenchmarkt op DevRev's Enterprise-Bench, wat bestaat uit 14 cross-systeem enterprise-taken. Elke taak vereist dat de agent plant, MCP tools aanroept over een CRM, project tracker en document store, de resultaten combineert en een antwoord teruggeeft dat voldoet aan de evaluatie-rubriek. Beide harnesses draaiden dezelfde taken met dezelfde MCP servers, en antwoorden werden beoordeeld door een blinde LLM-beoordelaar.
Met Opus 4.8 als constante factor produceerden de twee harnesses een vergelijkbare taaknauwkeurigheid, maar hun uitvoeringskosten verschilden:
De benchmark laat een relatief klein verschil zien in taaknauwkeurigheid, maar een veel groter verschil in uitvoeringskosten. TrueForge gebruikte minder dan een kwart van de tokens die door Deep Agents werden gebruikt en was ongeveer 2,5x goedkoper per run op hetzelfde model.
Het verschil komt grotendeels voort uit hoe de twee runtimes orchestratie en context verwerken. Deep Agents biedt mogelijkheden zoals planning, een virtueel bestandssysteem en subagents, maar deze kunnen ook meer orchestratie en context toevoegen aan elke beurt. TrueForge kiest voor een slankere aanpak door gerichte tool calls en context-compactie te gebruiken om te voorkomen dat grote geschiedenissen en tool-responses herhaaldelijk naar het model worden teruggestuurd. Dit is belangrijk omdat de kosten van een agent niet alleen door de modelprijs worden bepaald. Twee agent-systemen die hetzelfde model draaien, kunnen een heel verschillend tokenverbruik hebben, afhankelijk van hoe ze planning, toolgebruik, contextbeheer en subagents implementeren.
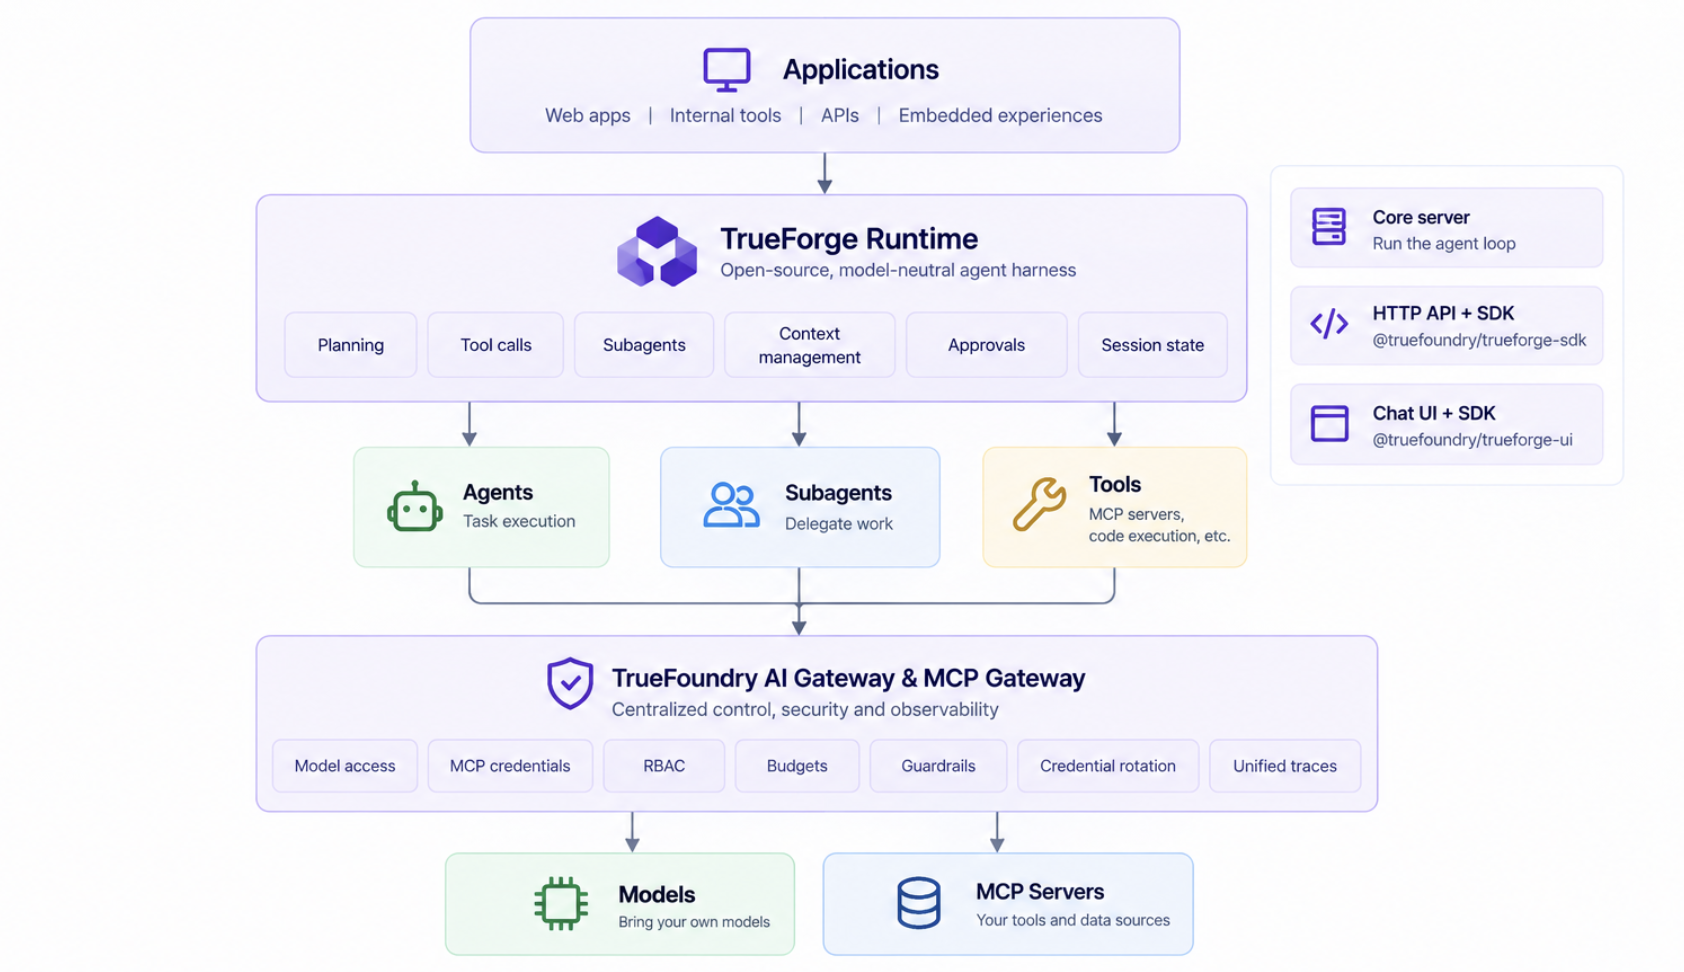
TrueForge kan ook verbinding maken met TrueFoundry's AI Gateway en MCP Gateway om de functies te bieden die belangrijk worden zodra agents geen geïsoleerde projecten meer zijn, waaronder gecentraliseerde modeltoegang, MCP-referenties, RBAC, budgetten, guardrails, rotatie van inloggegevens en geünificeerde traces. Dit verplaatst die zaken uit individuele agent-definities naar een gedeelde platformlaag.
Voor teams die Deep Agents evalueren voor productie is de benchmark een nuttige herinnering dat het framework slechts één onderdeel van de stack is. De runtime-architectuur rond de agent kan een aanzienlijke impact hebben op tokenverbruik, latentie en kosten. TrueForge is ontworpen om die runtime-laag te bieden terwijl de model- en infrastructuurkeuzes open blijven.
Als wat je daadwerkelijk met deepagents hebt gebouwd een coding agent was, is opencode waarschijnlijk een betere keuze voor je. Het is MIT-gelicenseerd, model-agnostisch en de meest-gestarde open-source coding agent van 2026, uitgebracht als een terminal TUI, een desktop-app en een IDE-extensie.
Het is een volledige harness in plaats van een wrapper: tool loop, LSP-integratie, sessiebeheer, afzonderlijke plan- en build-modi. Verwijs het naar Claude, GPT, Gemini, GLM of een lokaal Ollama model.
Het ecosysteem is de reden om hiervoor te kiezen. Met 900 contributors bestaat de integratie die je nodig hebt meestal al.
Wat je verliest bij de overstap van deepagents is het algemene kader. opencode is gebouwd rond code, dus cross-systeem zakelijke workflows zijn niet de sterkste kant, en er is geen UI SDK om het in een product in te bedden.
Het beste voor: Developer-gerichte coding workflows waarbij de breedte van het ecosysteem doorslaggevend is.
Pi is het filosofische tegenovergestelde van deepagents, wat precies de reden is waarom sommige teams eroverstappen. De CLI levert vier tools mee: Read, Write, Edit, Bash. Al het andere voeg je zelf toe via TypeScript-extensies, aangepaste tools, aangepaste providers, prompt-templates, vaardigheden en pakketten.
Een lazy-loading skill-systeem voegt alleen instructies toe wanneer een taak ze nodig heeft, zodat de context slank blijft zonder zware compactie. Het is BYOK en provider-agnostisch, en het wordt geleverd met compactie, JSON/RPC-modi en een SDK.
Als je klacht over deepagents is dat je tokens betaalt voor mechanica die je nooit gebruikt, is Pi het directe antwoord. Als je klacht de kosten zijn, maar je wel alle extra's wilt, is het dat niet.
Het beste voor: Teams met TypeScript-capaciteit die liever vanuit een kleine kern opbouwen dan de standaarden van iemand anders afslanken.
OpenHands, voorheen OpenDevin, is de meest volwassen autonome coding agent in open source. De event-stream architectuur doorloopt vier toestanden per loop: de agent redeneert, zendt een actie uit, de omgeving voert deze uit, de omgeving geeft een observatie terug. Elke sessie krijgt een geïsoleerde Docker sandbox.
Die always-on Docker kost meer per sessie dan on-demand provisioning, en voor wat OpenHands doet is dat de juiste afweging. Een agent die in een repository werkt zonder dat er iemand meekijkt, heeft harde isolatie nodig.
Het is echter specifieker dan deepagents. Als je deepagents gebruikte voor werk dat zich uitstrekt over een CRM, een tracker en een document store, is dit geen vervanging.
Het beste voor: Teams waarvan de deepagents-workload eigenlijk alleen uit autonoom coderen bestond.
De enige gesloten optie hier, opgenomen omdat het oprecht is waar sommige deepagents-teams eindigen. Anthropic draait de harness, de sandbox en het sessielogboek. Er is voor jou helemaal geen runtime om te beheren.
Op dezelfde benchmark kwam het uit op $11.8 per run op 10M tokens, dus het is goedkoper dan deepagents en duurder dan TrueForge, en het neemt het operationele werk volledig weg. De prijzen zijn token-tarieven plus een runtime-heffing per sessie-uur.
Het addertje onder het gras is structureel. Het is alleen voor Anthropic, dus elke taak draait op een Claude model, of het er nu een nodig had of niet, en de knop voor een goedkoper model bestaat nooit. Het is ook hosted, wat het uitsluit als je VPC- of data-residency-vereisten hebt. We hebben het head-to-head gebenchmarkt in onze Enterprise-Bench writeup.
Het beste voor: Kleine teams die toegewijd zijn aan Claude en geen behoefte hebben aan het beheren van infrastructuur.
Nauwkeurigheid over de drie harnesses die we hebben gebenchmarkt was een gelijkspel tussen alle drie. Iedereen eindigde binnen één taak van elkaar, omdat het model het plafond bepaalt van wat mogelijk is. Wat de harness bepaalt, is de prijs om daar te komen, en bij identiek werk liep de spreiding van $8.5 tot $21 per run.
Drie dingen verklaren het grootste deel van dat gat.
De begin-payload is groter. Elke beurt verwerkt de system prompt en tool-definities opnieuw, en deepagents voegt daar nog planning-scaffolding, een virtueel bestandssysteem en subagent-mechanica aan toe. Die vaste overhead is één keer klein, maar aanzienlijk over honderden beurten.
De loop plant meer calls. Het grootste deel van de kosten van een agent zit in de loop in plaats van het antwoord, en elke tool round-trip stuurt de groeiende context terug naar het model. Het behalen van hetzelfde resultaat in minder calls vormt een groot deel van het verschil.
En de context wordt herhaald (replay) in plaats van gecompacteerd. Dit is de belangrijkste factor. Het inkorten van de geschiedenis en het offloaden van grote tool-responses, in plaats van alles woordelijk opnieuw te versturen, is wat 3.8M tokens scheidt van 16.5M op dezelfde taak.
De volledige methodologie, inclusief hoe we tools en sessies constant hielden en de beoordelaar blind hielden, staat in onze Enterprise-Bench writeup.
Minder dan je zou denken, zolang je je tools in MCP hebt gehouden.
Je MCP servers verhuizen ongewijzigd mee. Elk alternatief hier spreekt MCP, dus als de tools van je agent al MCP servers zijn, verbinden ze zonder aanpassingen met de nieuwe harness. Dat is meestal het grootste deel van het integratiewerk en dat is al gedaan.
Modeltoegang bestaat uit drie configuratiewaarden. Elke harness met een OpenAI-compatibele interface accepteert een base URL, een key en een modelnaam.
Je prompts moeten worden opgeschoond, niet herschreven. Verschillende harnesses worden geleverd met verschillende standaardinstructies, dus prompts die zijn afgestemd op de standaarden van deepagents hebben meestal een herziening nodig in plaats van een volledige heropbouw.
Het echte werk zit in alles wat je aan LangGraph hebt gekoppeld. Aangepaste graph nodes, LangGraph-specifieke state handling en checkpointer-logica verhuizen niet mee. Schat dit eerlijk in voordat je je vastlegt, want dit is het onderdeel dat bepaalt of dit een week of een kwartaal duurt.
Draai ze vervolgens parallel. Verwijs een kopie van je agent naar de nieuwe harness, stuur je echte taken door beide, en vergelijk de kwaliteit en kosten op je eigen workload. Dat is hoe wij de bovenstaande cijfers hebben geproduceerd, en je zou je eigen cijfers meer moeten vertrouwen dan de onze.
V: Wat zijn de beste LangChain Deep Agents alternatieven?
A: TrueForge is de sterkste optie qua kosten; het lost dezelfde benchmarktaken op voor $8.5 per run tegenover $21 voor deepagents op hetzelfde model, terwijl het een HTTP API en inbedbare UI toevoegt die deepagents niet heeft. opencode is beter als je agents eigenlijk coding agents zijn, Pi als je een minimale kern wilt, en Claude Managed Agents als je liever helemaal geen runtime beheert.
V: Wat is deepagents?
A: deepagents is LangChain's geprononceerde agent harness gebouwd op LangGraph. Het bundelt planningstools, een virtueel bestandssysteem, subagent-delegatie, persistent geheugen, vaardigheden, ge-sandboxten uitvoering en human-in-the-loop ondersteuning, zodat je een complete agent runtime krijgt in plaats van er een samen te stellen uit primitieven.
V: Is deepagents gratis?
A: De library is open source en gratis te downloaden. Het beheren ervan is dat niet: op onze benchmark verbruikte het 16.5M tokens per run tegenover 3.8M voor een slankere harness op identieke taken, wat bij de Opus 4.8 tarieven neerkwam op $21 per run tegenover $8.5.
V: Wat is het verschil tussen deepagents en LangGraph?
A: LangGraph is het onderliggende framework voor het bouwen van stateful agent workflows. deepagents is een geprononceerde harness die erop is gebouwd en een complete agent loop levert met vooraf gekozen standaarden. Je kunt een agent rechtstreeks op LangGraph bouwen of create_agent; deepagents bespaart je dat werk ten koste van het meedragen van de scaffolding bij elke beurt.
V: Kan ik een agent harness in mijn eigen VPC of on-prem draaien?
A: Ja, met elk van de open-source opties hier. TrueForge draait lokaal vanuit een enkel npx commando, of via Docker Compose en Helm voor team-deployments met Postgres, Redis, replicas en OIDC-login. TrueFoundry's beheerde versie draait ook self-hosted, on-prem, air-gapped of hybride, zodat er geen data uit jouw domein vertrekt.
V: Hoe beheer ik governance voor modellen en MCP servers over veel agents heen?
A: Via een gateway-laag. TrueFoundry's AI Gateway plaatst 1.000+ LLMs achter één OpenAI-compatibele API met ongeveer ~3–4 ms toegevoegde latentie en 350+ RPS op een enkele vCPU, met RBAC, budgetten, guardrails en rotatie van inloggegevens, plus een MCP Gateway voor toegangsbeheer op tool-niveau en OpenTelemetry-traces naar Grafana, Datadog of Prometheus.
De meeste teams die alternatieven voor Deep Agents evalueren, zijn niet ontevreden over de developer-ervaring. Ze zijn ontevreden over de kosten om het op schaal te draaien, en die kosten komen voort uit een specifieke architectonische keuze: de volledige uitrusting bij elke beurt meedragen en context herhalen (replay) in plaats van compacteerders te gebruiken.
Als LangGraph cruciaal is voor jou en je volume is matig, is blijven zitten de meest rationele keuze. Als je agent-factuur iets is geworden waar finance vragen over stelt, is het verschil meetbaar en de moeite waard om op je eigen taken te meten. TrueForge is MIT-gelicenseerd en npx @truefoundry/trueforge heeft het binnen een minuut draaien, dus het benchmarken tegen je huidige setup kost je een middag. De repo staat op GitHub
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















