March 25, 2025
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Nu Large Language Models verschuiven van experimenten naar productie, heroverwegen teams hoe AI-verkeer moet worden beheerd, beveiligd en geobserveerd. Wat ooit een eenvoudige API-integratie leek, omvat nu prompts, tokens, model-routing, retries, kostenbewaking en betrouwbaarheidsproblemen waarop traditionele applicatie-infrastructuur nooit is ontworpen.
Veel engineeringteams beginnen deze reis door vertrouwde API-gateways zoals Kong uit te breiden, waarbij gebruik wordt gemaakt van bestaande patronen voor routing, authenticatie en rate limiting. Naarmate het gebruik van LLM's groeit, komen AI-native gateways zoals Portkey in beeld, die abstracties bieden die zijn afgestemd op prompts, modellen en observatie op token-niveau.
Beide benaderingen hebben tot doel echte problemen op te lossen, maar ze vertrekken vanuit een fundamenteel ander uitgangspunt. Kong is verworteld in het beheren van HTTP-API's en microservices, terwijl Portkey specifiek is ontworpen voor LLM-applicatieworkflows. De verschillen tussen deze filosofieën worden steeds belangrijker naarmate AI-systemen schalen over teams, omgevingen en productie-use-cases heen.
In dit artikel vergelijken we Kong en Portkey op het gebied van architectuur, observatie, governance en enterprise-readiness. We bekijken waar elke tool het beste past, waar beperkingen aan het licht beginnen te komen en waar platformteams rekening mee moeten houden als AI een kernonderdeel van hun infrastructuurstack wordt.
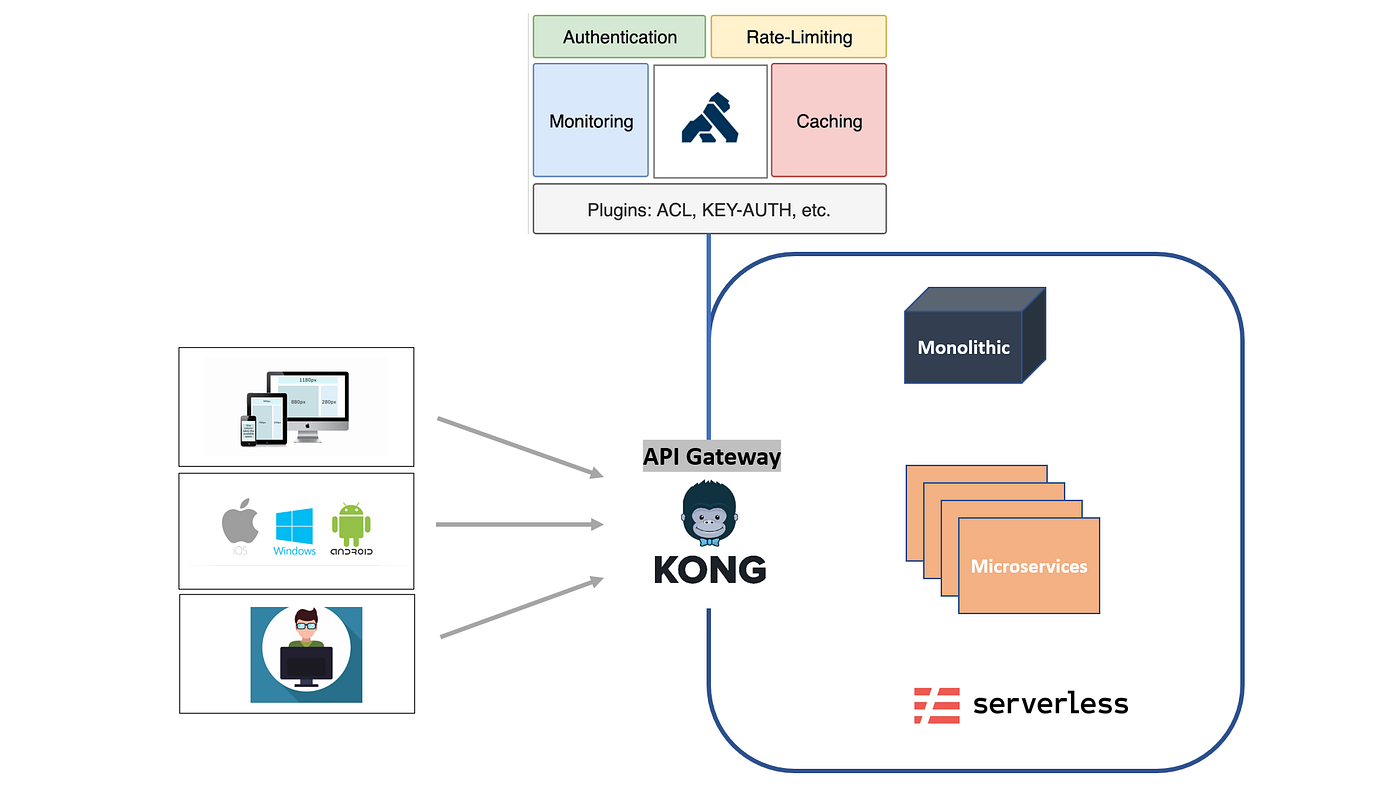
Kong is een veelgebruikte API-gateway die is gebouwd om HTTP-verkeer over microservices heen te beheren, te beveiligen en te routen. Het wordt vaak gebruikt als een ingress-laag in op Kubernetes gebaseerde architecturen en staat bekend om het afhandelen van zaken als authenticatie, rate limiting, verkeersrouting en observatie op verzoekniveau.
Vanuit architectonisch oogpunt is Kong geoptimaliseerd voor API-first-systemen. De kernabstracties draaien om endpoints, services, routes en plugins — waardoor het uitstekend past in traditionele backend- en microservices-omgevingen waar verzoeken stateless, voorspelbaar en uniform zijn.
Wanneer teams LLM's introduceren, is Kong vaak de eerste tool die opnieuw wordt ingezet om AI-verkeer te beheren - waarbij LLM-calls worden behandeld als gewoon een ander API-endpoint. Dit werkt aanvankelijk voor:
LLM-verkeer introduceert echter eigenschappen die niet naadloos aansluiten op traditionele API's.
Naarmate het gebruik van AI verder groeit dan eenvoudig experimenteren, worden deze hiaten steeds zichtbaarder, vooral in omgevingen met meerdere teams of waar kosten een grote rol spelen.
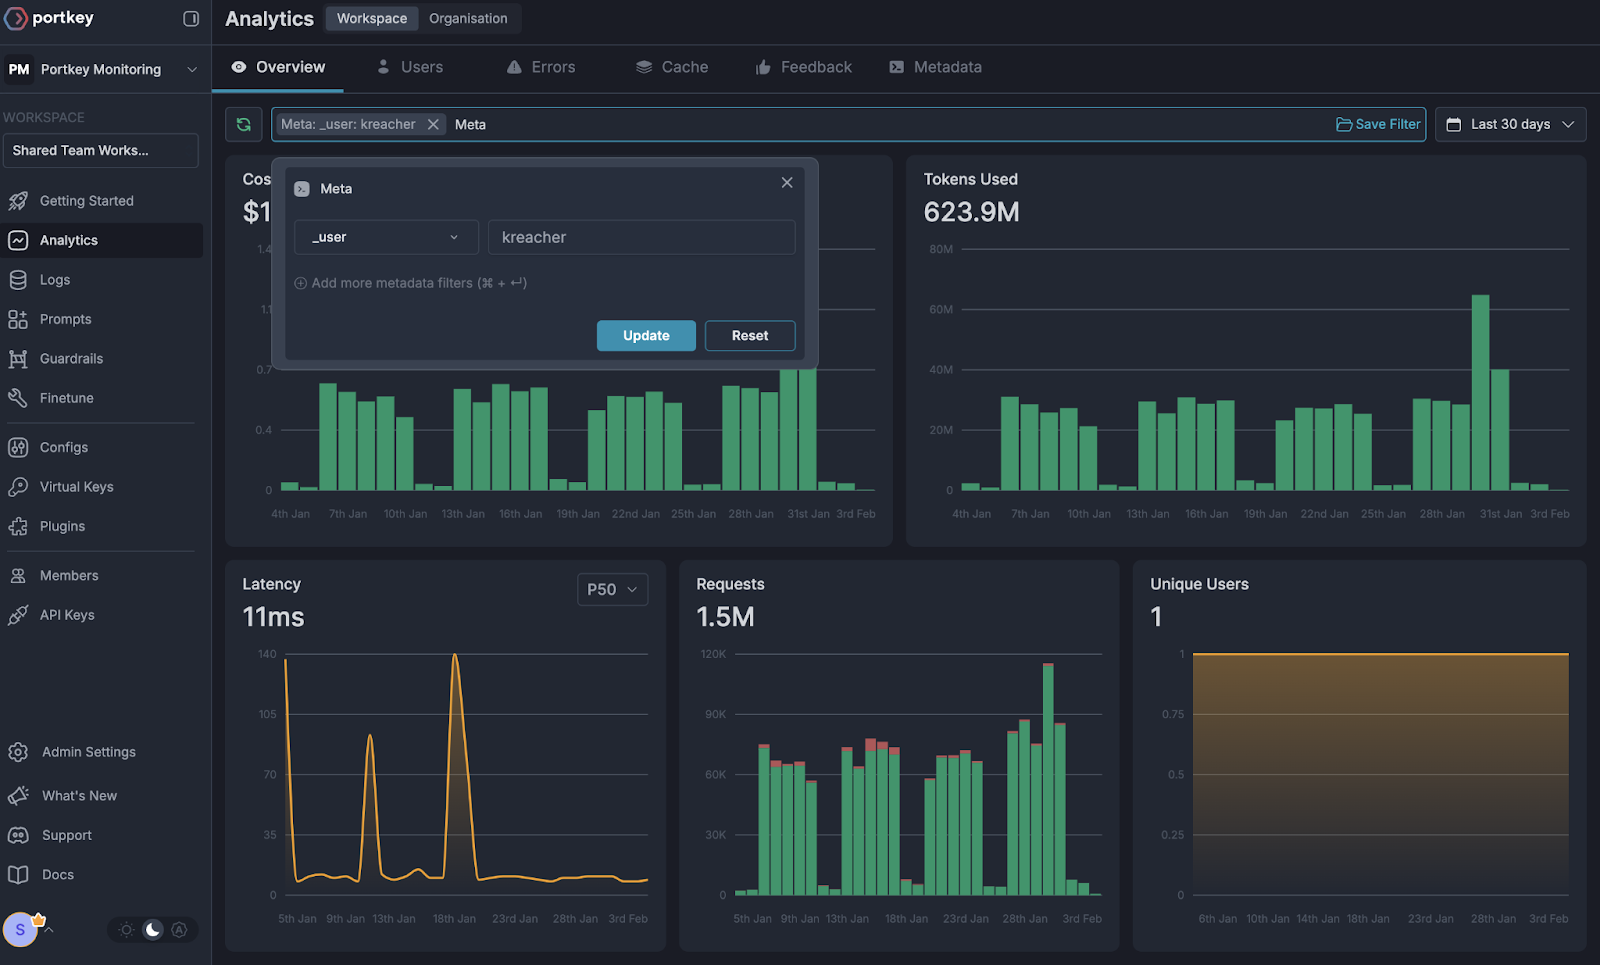
Portkey is een AI-native gateway die specifiek is ontworpen voor applicaties die zijn gebouwd op Large Language Models. In plaats van LLM-calls te behandelen als generieke API-verzoeken, introduceert Portkey abstracties die aansluiten bij hoe AI-applicaties daadwerkelijk werken — prompts, modellen, tokens en providers.
In de kern fungeert Portkey als een tussenlaag tussen AI-applicaties en meerdere LLM-providers. Het stelt ontwikkelaars in staat om te schakelen tussen modellen, verkeer te routen en gebruik te observeren zonder de applicatiecode nauw te koppelen aan de API van een specifieke provider.
Vergeleken met API-gateways zoals Kong is Portkey van nature LLM-aware. Het begrijpt dat:
Dit maakt Portkey een sterke keuze voor teams die LLM-aangedreven applicaties bouwen en daaraan itereren, vooral in vroege of mid-stage productieomgevingen.
Naarmate het gebruik van LLM's schaalt over teams en omgevingen heen, komen er enkele beperkingen naar voren:
Deze beperkingen worden belangrijk wanneer AI verandert van een applicatiefunctie in een gedeelde enterprise-capaciteit.
Belangrijkste statistieken voor het evalueren van een gateway
| Criterium | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latency | Voegt <10ms p95 overhead toe voor time-to-first-token? | Must Have | ✅ Ondersteund |
| Data-residentie | Bewaart logs binnen uw regio (EU/US)? | Afhankelijk van use-case | ✅ Ondersteund |
| Routing op basis van latency | Stuurt automatisch om op basis van realtime latency/storingen? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & Intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |

Hoewel Kong en Portkey zich beide voor AI-workloads kunnen bevinden, zijn ze gebouwd op zeer verschillende architectonische aannames. Het begrijpen van dit verschil is cruciaal voor platformteams die beslissen hoe ze AI verder willen schalen dan een enkele applicatie.
Kong is een goede keuze als:
In deze opzet werkt Kong als een tijdelijke uitbreiding van de bestaande API-infrastructuur.
Portkey past goed wanneer:
Portkey blinkt uit op de applicatielaag, vooral voor snel bewegende AI-productteams.
Samen lossen Kong en Portkey echte uitdagingen in de AI-stack op, maar ze doen dat op verschillende en uiteindelijk beperkte lagen. Deze beperkingen worden duidelijk naarmate AI zich ontwikkelt van een losse applicatiefunctie tot een gedeelde enterprise-capaciteit die meerdere teams, omgevingen en regelgevende grenzen omvat.
Kong is ontworpen om API-verzoeken te beheren, niet AI-gedrag. Prompts, tokens, modelselectie en de uitvoering van agents zijn ondoorzichtig voor de gateway.
Portkey introduceert LLM-aware middelen, maar governance blijft grotendeels beperkt tot het applicatiedomein.
Enterprise AI-teams hebben echter antwoorden nodig op vragen zoals:
Noch Kong noch Portkey biedt organisatiebrede AI-governance als een primaire functionaliteit.
AI-kosten worden gevormd door een combinatie van:
Kong heeft geen zicht op deze AI-specifieke kostendrijvers.
Portkey geeft statistieken op token-niveau weer, maar kostentoewijzing wordt steeds moeilijker naarmate het gebruik zich uitstrekt over meerdere teams, applicaties en omgevingen.
Zonder toewijzing op infrastructuurniveau hebben platform- en financeteams moeite om een basisvraag te beantwoorden: wie uitgeeft wat, en waarom?
Productie-AI-systemen vereisen een strikte scheiding tussen:
Kong is niet gebouwd met AI-omgevingsisolatie in het achterhoofd.
Portkey optimaliseert voor applicatieworkflows in plaats van harde omgevingsgrenzen af te dwingen.
Voor bedrijven in gereguleerde industrieën wordt dit gebrek aan isolatie snel een blocker voor uitrol.
Enterprise AI-deployments moeten voldoen aan vereisten zoals:
Deze beperkingen moeten worden afgedwongen op de infrastructuurlaag, niet worden ingebed in applicatiecode of handmatig worden afgehandeld door teams.
Kong behandelt AI-verkeer als generieke HTTP-verzoeken.
Portkey gaat uit van cloud-first gebruik op applicatieniveau.
Geen van beide benaderingen is ontworpen voor compliance-first AI-deployments.
AI in productie is niet langer beperkt tot synchrone prompt-response-calls. Real-world systemen omvatten:
Gateways die zich alleen richten op API-verkeer of prompt-routing slagen er niet in om de volledige levenscyclus van AI-workloads te beheren.
Naarmate de adoptie van AI volwassener wordt, komen bedrijven tot hetzelfde inzicht: gateways alleen zijn niet genoeg. AI in productie draaien vereist een infrastructuurlaag die toegang, deployment, observatie, governance en compliance verenigt. Dit is de reden waarom organisaties uiteindelijk voorbij API-gateways en LLM-applicatiegateways bewegen, naar AI-native infrastructuurplatformen gebouwd voor enterprise-schaal
De beperkingen van Kong en Portkey komen voort uit dezelfde oorzaak: ze zijn beide ontworpen om problemen op gateway-niveau op te lossen, niet enterprise AI-infrastructuurproblemen.
Naarmate AI een gedeelde, productie-kritische capaciteit wordt, hebben bedrijven meer nodig dan verkeersrouting of prompt-abstractie. Ze hebben een platform nodig dat AI-governance, deployment, observatie en beveiliging behandelt als primaire infrastructuureisen. Dit is waar TrueFoundry zich onderscheidt.
TrueFoundry is gebouwd rond het idee dat AI-workloads net zo moeten worden beheerd als elk ander kritiek productiesysteem, maar met AI-native primitieven. In plaats van alleen te werken in het verzoekpad, fungeert TrueFoundry als een geïntegreerd AI-control-plane.
Op een hoog niveau brengt TrueFoundry het volgende samen:
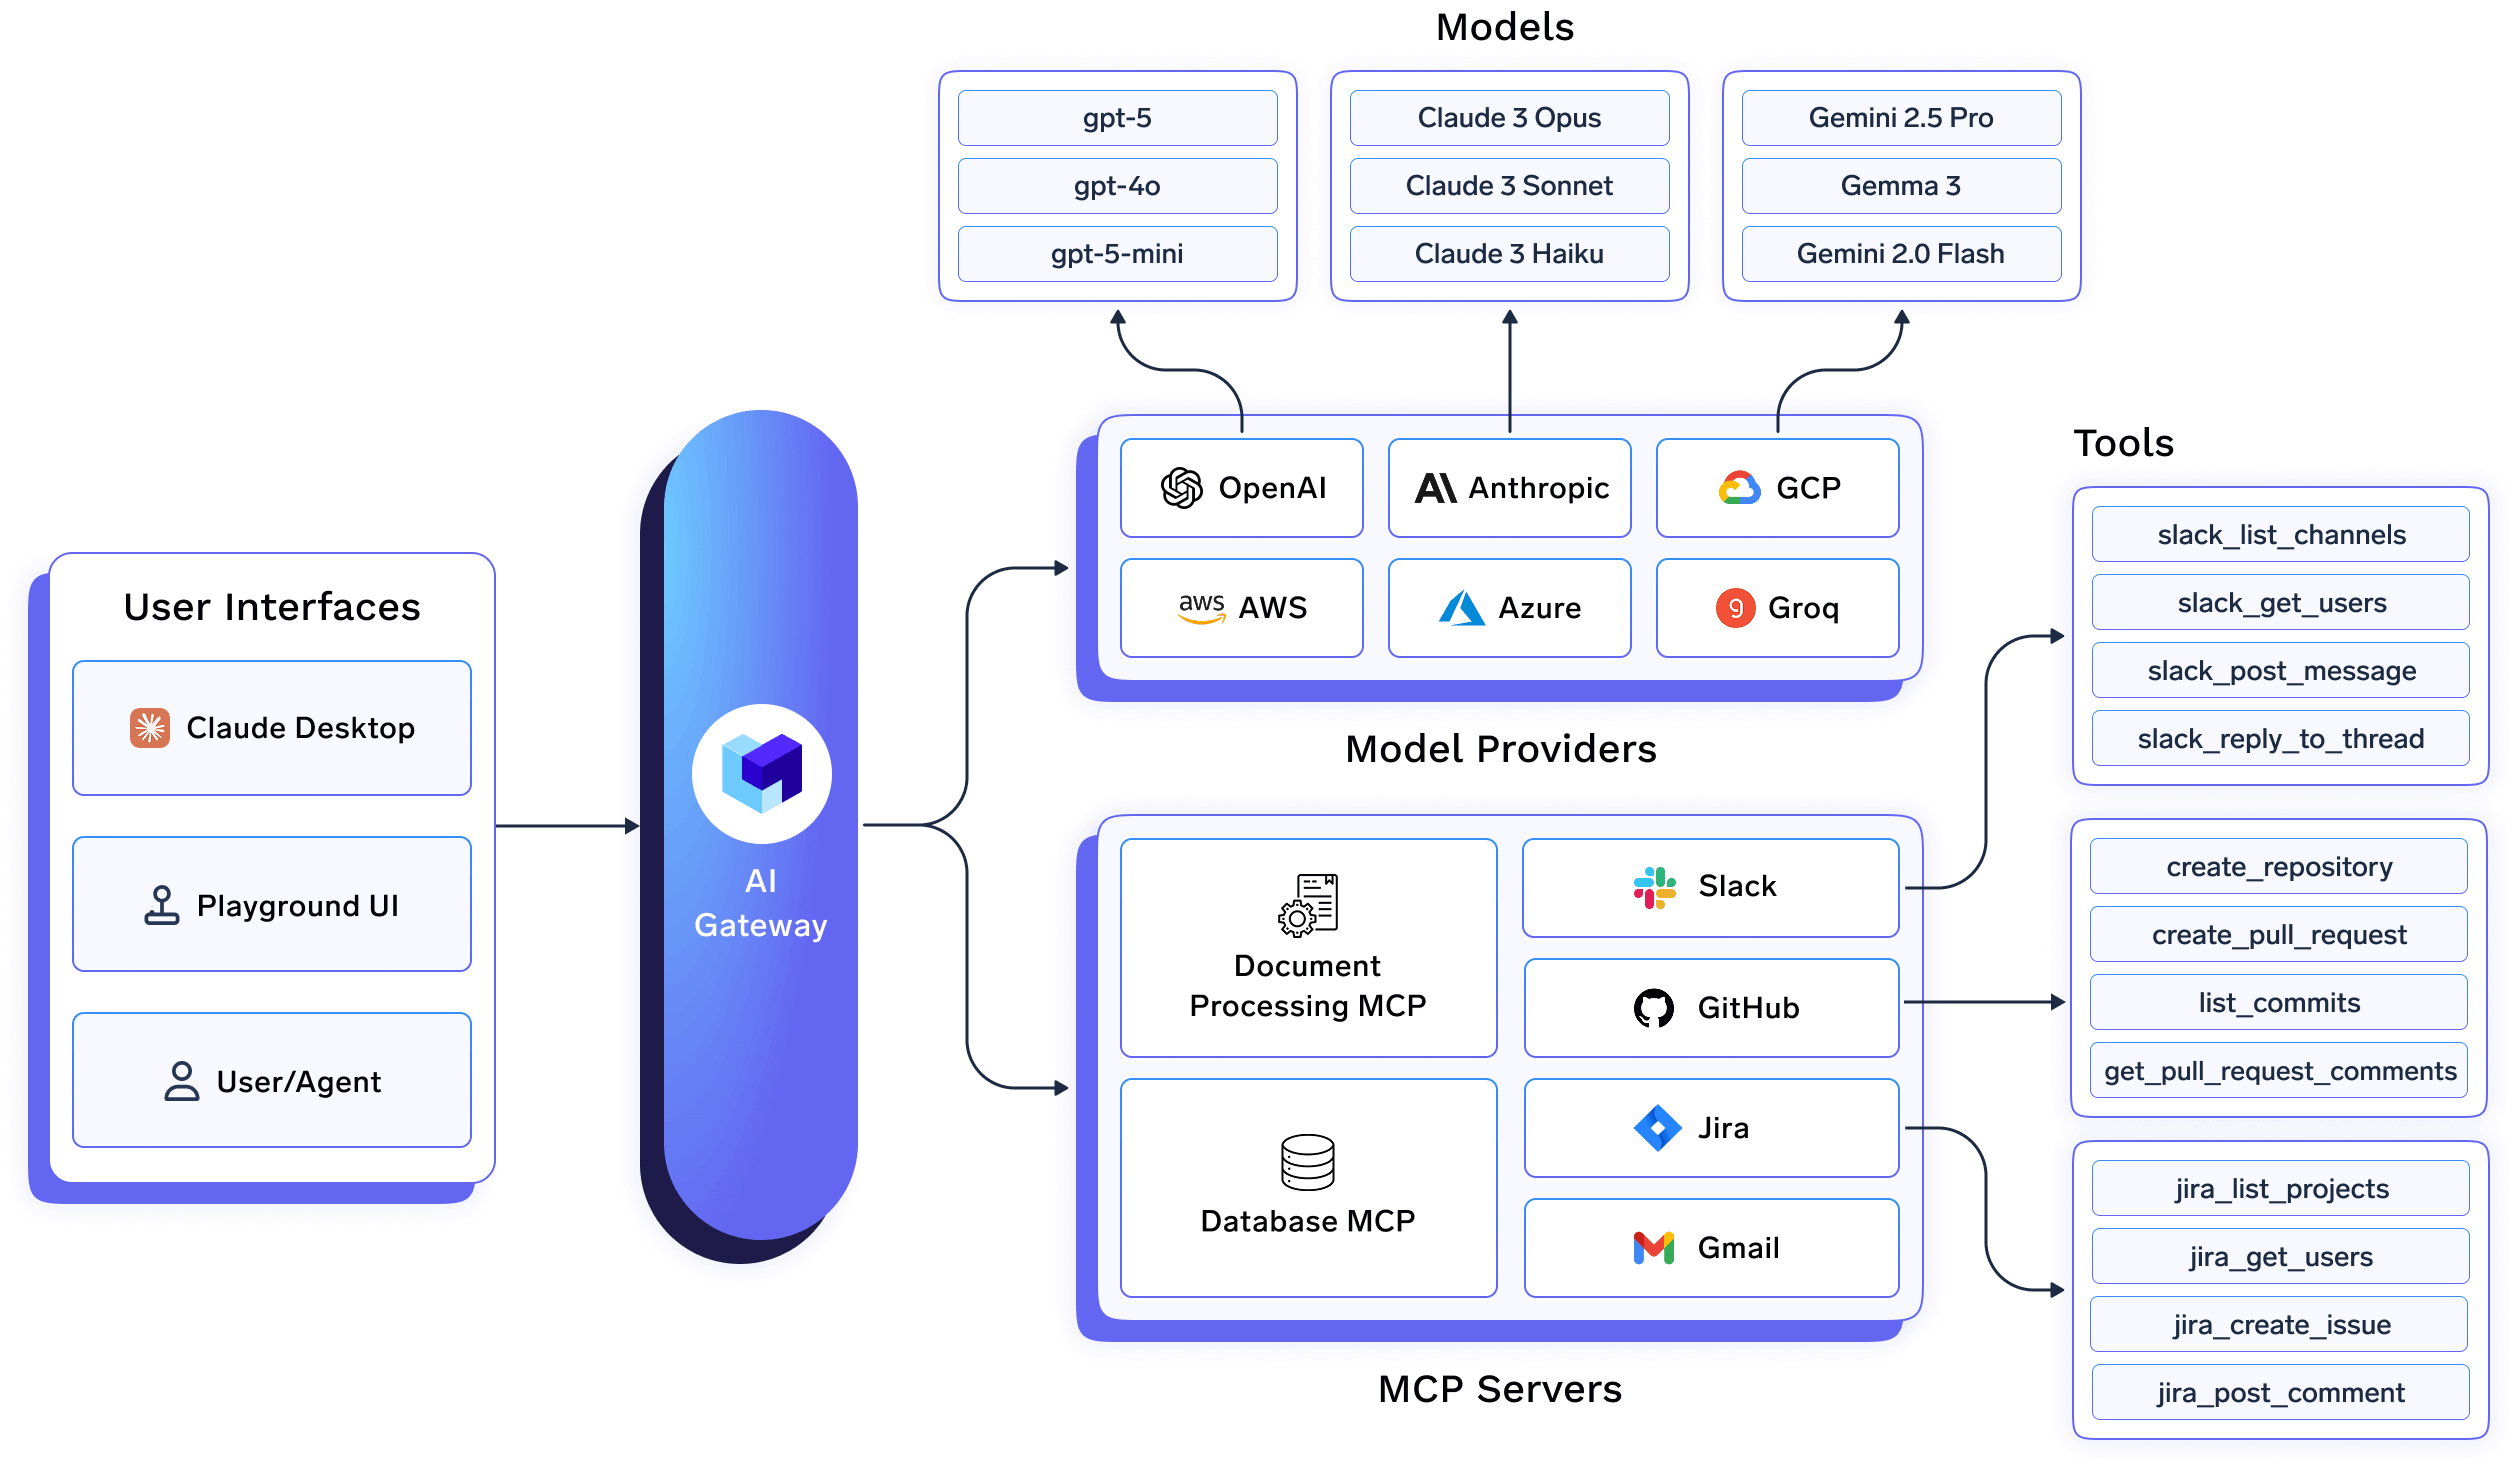
In veel AI-stacks wordt het gebruik van LLM's behandeld als een API-integratieprobleem: verzoeken worden gerouteerd, geauthenticeerd en gelogd, maar alles voorbij de grens van het verzoek wordt overgelaten aan individuele applicaties. TrueFoundry kiest voor een andere benadering door AI-workloads, services, jobs en agents te behandelen als infrastructuurobjecten met een levenscyclus, eigenaarschap en operationele grenzen.
In plaats van alleen te beslissen of een verzoek moet worden toegestaan, bepaalt TrueFoundry waar AI-systemen draaien, hoe ze worden uitgevoerd en onder welke beperkingen, van deployment tot en met runtime. Deze verschuiving van verkeersrouting naar levenscyclusbeheer maakt consistente governance mogelijk naarmate het gebruik van AI schaalt.
Concreet komt dit tot uiting in verschillende kritieke dimensies.
In gateway-centrische architecturen zijn toegangsregels meestal ingebed in applicatiecode, SDK-configuratie of gateway-regels per service. Dit wordt snel kwetsbaar naarmate teams, services en omgevingen zich vermenigvuldigen.
TrueFoundry dwingt toegangs- en gebruiksbeleid af op workspace- en omgevingsniveau. Modellen, agents en tools worden afgebakend naar omgevingen zoals development, staging en productie, waarbij machtigingen en regels consistent worden toegepast op alle workloads die in die omgeving zijn gedeployed.
Omdat regels gekoppeld zijn aan omgevingen in plaats van aan individuele applicaties:
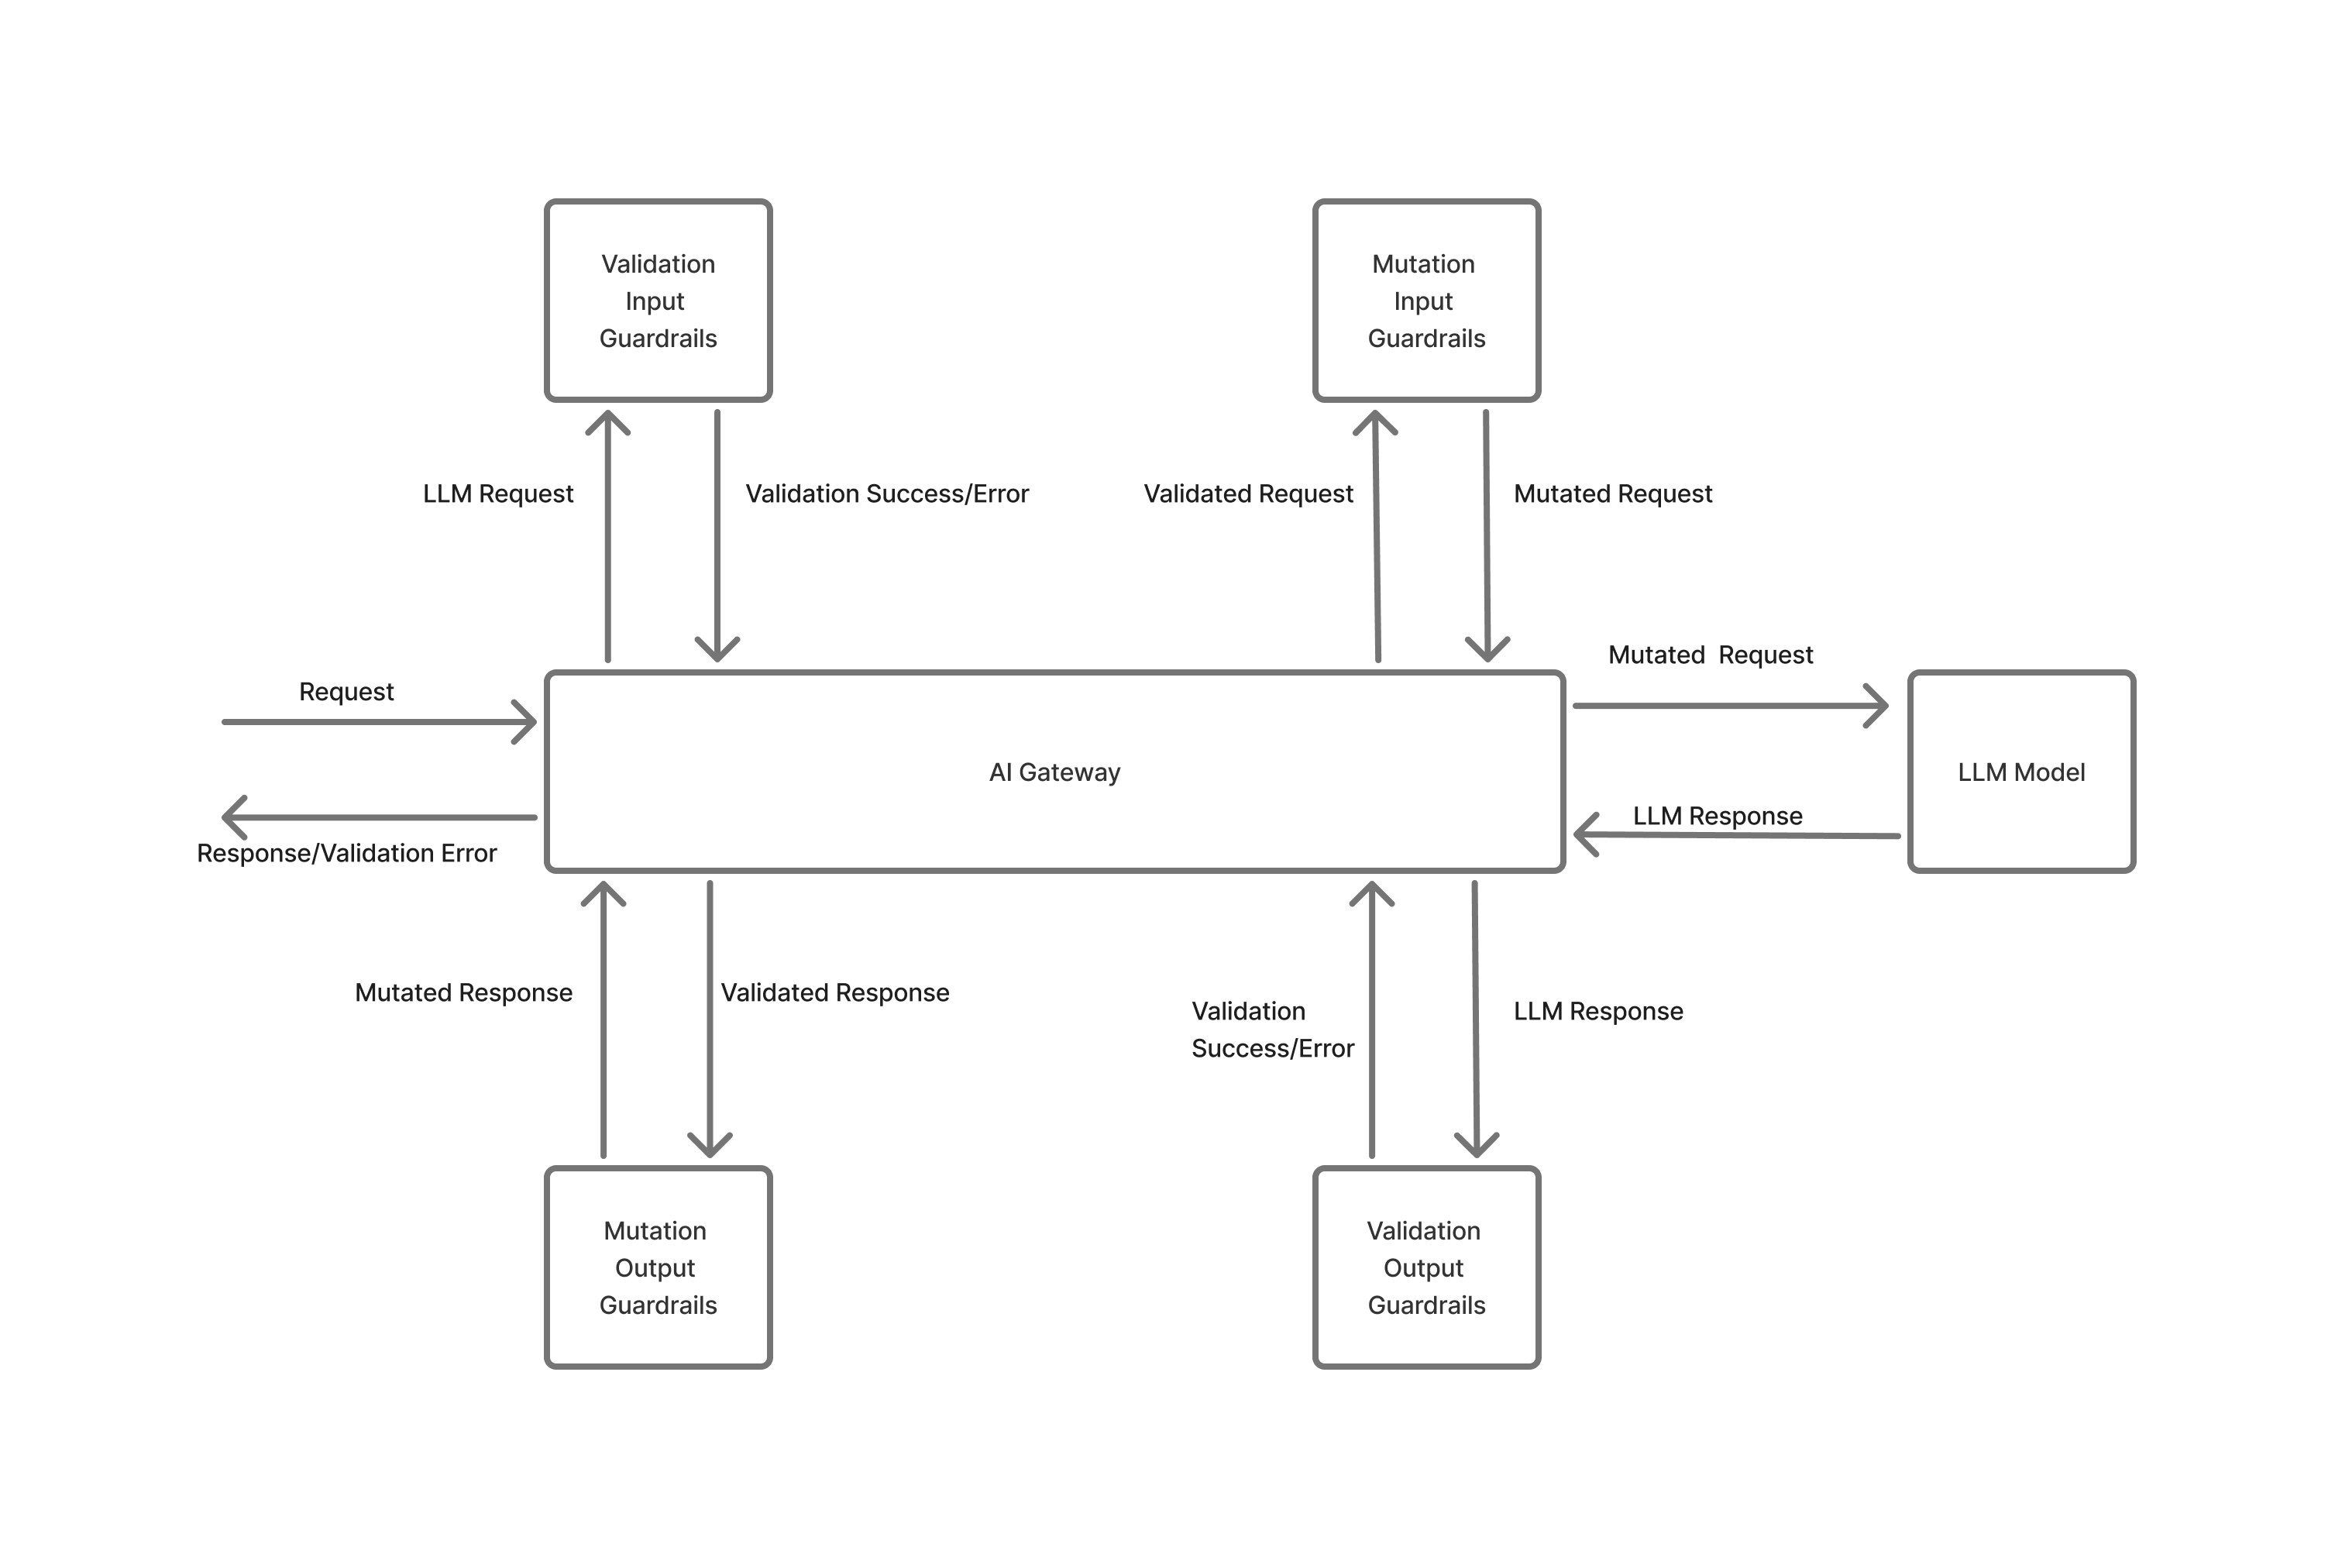
AI-systemen falen in productie niet omdat een enkel verzoek ongeldig is, maar omdat het gebruik zich op onverwachte manieren opbouwt door pieken in gelijktijdigheid, retry-storms of achtergrond-workloads die op schaal draaien.
TrueFoundry dwingt gebruiks-guardrails af tijdens het uitvoeren, met zichtbaarheid in hoe workloads zich gedragen in runtime. Gelijktijdigheidslimieten, throughput-beperkingen en gebruiksplafonds worden centraal toegepast op services en jobs die onderliggende modellen of infrastructuur delen.
Omdat deze limieten op de platformlaag worden afgedwongen:
Dit is fundamenteel anders dan controles aan de clientzijde of op SDK-niveau, die ervan uitgaan dat applicaties zich correct en onafhankelijk gedragen.
TrueFoundry dwingt isolatie af op de deployment- en omgevingslaag, niet alleen bij de toelating van verzoeken. AI-services, batch-jobs en agent-workflows worden gedeployed als geïsoleerde workloads binnen gedefinieerde omgevingen, waarbij toegang, beleid en middelen per omgeving zijn afgebakend.
Deze workloads draaien als afzonderlijke deployments en jobs met onafhankelijke runtime-processen en foutdomeinen, in plaats van een enkele platte uitvoeringscontext achter een gateway te delen. Het resultaat is dat:
LLM-gateways op applicatieniveau, die voornamelijk in het verzoekpad werken, beheren de runtime-uitvoering of infrastructuurstatus niet. Daardoor kunnen ze dit niveau van deployment- en omgevingsisolatie niet bieden — een probleem dat steeds zichtbaarder wordt naarmate AI-workloads schalen over teams en productieomgevingen.

Statistieken op token-niveau zijn nuttig, maar onvoldoende zodra AI-workloads zich uitstrekken over langlopende services, achtergrondtaken en agent-workflows. In productiesystemen ontstaan kosten en prestaties uit de interactie tussen:
TrueFoundry correleert deze signalen op de platformlaag, waardoor teams over AI-gedrag kunnen redeneren zoals ze over andere productiesystemen redeneren — per omgeving, service en eigenaar, niet per individuele API-call.
Veel enterprise AI-deployments werken onder beperkingen die gateways op applicatieniveau stilzwijgend negeren, waaronder:
Het control-plane van TrueFoundry is ontworpen om binnen deze deployment-modellen te werken, wat ervoor zorgt dat governance, isolatie en observatie consistent blijven, ongeacht waar inference draait. Zo worden compliance-eigenschappen — zoals datagrenzen en controleerbaarheid — afgedwongen als onderdeel van de infrastructuur zelf, in plaats van achteraf te worden toegevoegd via applicatielogica of procescontroles.
Kong en Portkey lossen elk belangrijke problemen op in verschillende fasen van AI-adoptie. Kong breidt vertrouwde API-gatewaypatronen uit naar AI-verkeer, terwijl Portkey LLM-native abstracties introduceert die het gemakkelijker maken om AI-aangedreven applicaties te bouwen en te beheren.
Wanneer AI echter een gedeelde, productie-kritische functionaliteit wordt, lopen enterprises al snel tegen uitdagingen aan die verder gaan dan request routing of prompt management. Governance, cost attribution, isolatie van omgevingen en compliance vereisen allemaal controls op infrastructuurniveau, en niet alleen bij de gateway.
Dit is waarom veel organisaties verder kijken dan API- en LLM-application gateways en overstappen op AI-native infrastructuurplatformen zoals TrueFoundry, die zijn ontworpen om AI-systemen betrouwbaar uit te voeren, te beheren en te schalen over teams en omgevingen heen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox