



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
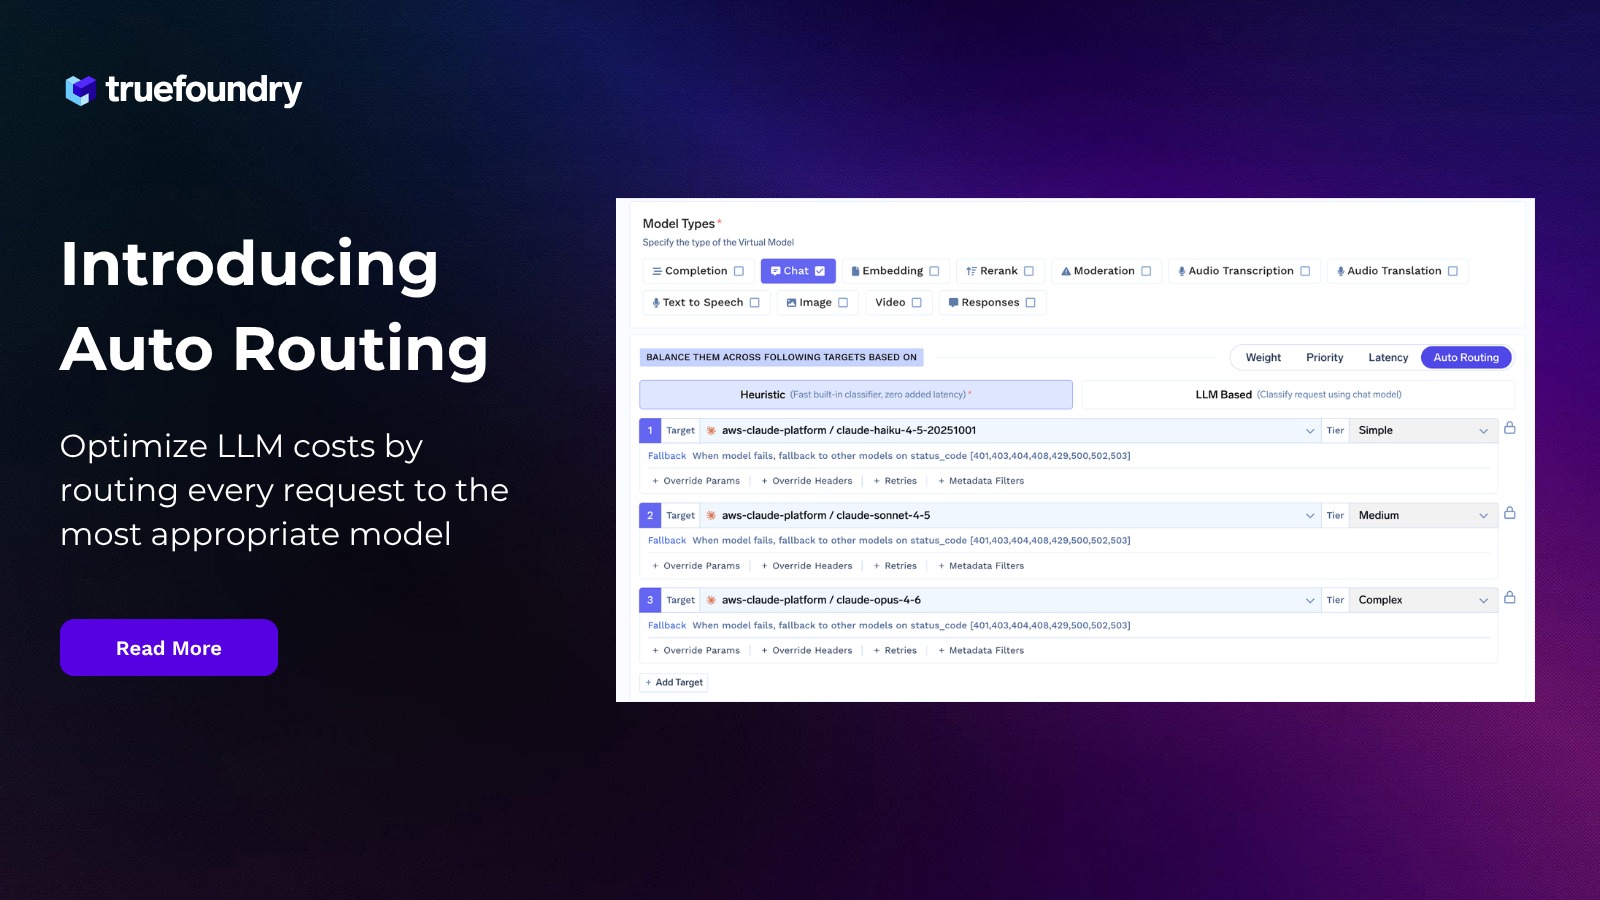
We hebben zojuist een nieuwe functionaliteit toegevoegd aan de TrueFoundry AI Gateway. De nieuwe Auto-Routing-functie leest elk inkomend verzoek, deelt het in een van de drie complexiteitsniveaus in en stuurt het naar het meest geschikte model dat aan dat niveau is toegewezen.
We hebben dit gebouwd om een terugkerend patroon in het verkeer van klanten op te lossen. Meestal is het merendeel van de vragen eenvoudig en kan het worden afgehandeld door eenvoudige modellen, terwijl slechts een klein aantal daadwerkelijk complexe vragen naar een complexer model moet worden gestuurd. In de praktijk krijgt echter één model uniform elke vraag toegewezen, ongeacht de complexiteit. Het gevolg is dat bedrijven aan het einde van elke cyclus worden geconfronteerd met een onnodig hoge rekening. Het hardcoden van routingregels is geen schaalbare oplossing, omdat elk team uiteindelijk zijn eigen routinglogica toepast zonder enige standaardisatie.
Dat werk hoort nu thuis bij de gateway.
Gedurende het grootste deel van de afgelopen twee jaar maten teams de AI-adoptie aan de hand van consumptie. Het aantal verbruikte tokens werd een synoniem voor verricht werk. Sommige bedrijven eerden interne ranglijsten om degene te vieren die het meeste verbruikte. Dit was wellicht logisch in de beginfase van AI-adoptie, toen het doel was om te begrijpen hoeveel werk daadwerkelijk aan modellen kon worden uitbesteed.
Toen kwamen de facturen binnen. In een IDC-enquête onder cloud- en AI-beslissers overschreed 61% van de organisaties hun cloud AI-budget voor 2025. De CTO van Uber maakte bekend dat zijn team medio april al het gehele jaarlijkse AI-budget had opgebruikt. Reasoning loops werden langer, context windows raakten voller en agents begonnen uit zichzelf duizenden keren per dag modellen aan te roepen zonder dat iemand meekeek.
De prioriteiten zijn dus verschoven. Tokenmaxxing is vervangen door tokenomics, een strategie waarbij bedrijven proberen de AI-uitgaven te maximeren zonder de adoptie of het experimenteren te vertragen. Dit betekent dat er meer focus is op real-time kostenobservatie, chargeback-modellen, toewijzing per team en gebruikslimieten. Dit zijn allemaal belangrijke functies, maar ze helpen alleen om uitgaven te monitoren of te beperken, niet om ze te optimaliseren.
De beslissing die uw rekening daadwerkelijk bepaalt, vindt veel eerder en veel sneller plaats: welk model krijgt dit verzoek. Dat is de laag waarin Auto Routing opereert.
Auto Routing wordt geconfigureerd op een virtueel model, een benoemde ingang die uw applicatie aanroept. Er zijn drie complexiteitsniveaus waaraan u specifieke modellen kunt toewijzen.
Omdat de niveautoewijzingen zich op het virtuele model bevinden, kunt u het model achter een niveau vervangen zodra er een betere of goedkopere optie beschikbaar is, zonder dat er wijzigingen in de applicatiecode nodig zijn. Het routingbeleid wordt een configuratie-object met een eigenaar, een wijzigingshistorie en één enkele plek om het te bewerken.
Er zijn twee methoden waarmee elke query in een van de drie niveaus wordt gecategoriseerd:
De heuristische classifier leest de prompt, beoordeelt deze op basis van een vaste set signalen en kiest een niveau. Het draait binnen het gateway-proces, dus het veroorzaakt geen latentie en geen kosten, en het is volledig deterministisch.
Het bepaalt de complexiteit van een query op basis van bepaalde parameters:
Hier kiest u het classifier-model, wat een catalogus-chatmodel moet zijn in plaats van een ander virtueel model, en stelt u een timeout in milliseconden in. U moet ook configureren wat er gebeurt als die aanroep mislukt. Er zijn twee fallback-opties beschikbaar: heuristic, die de beslissing teruggeeft aan de ingebouwde signalen, of static, die alles naar een door u genoemd niveau stuurt. Een fout in de classifier laat het verzoek nooit mislukken.
Dit brengt twee afwegingen met zich mee. De classifier draait als een modelaanroep voorafgaand aan het verzoek, dus het voegt latentie toe. En het is een factureerbaar gateway-verzoek, toegewezen aan dezelfde tenant en subject als het verzoek dat het heeft geactiveerd.
Auto Routing gaat verder dan eenvoudige routingregels en biedt u extra mogelijkheden om ervoor te zorgen dat de modeluitgaven worden geoptimaliseerd, behoudens de nauwkeurigheid:
We hebben Auto Routing getest tegen een baseline die elk verzoek naar Claude Opus 5 stuurt, over 16 publieke datasets en ongeveer 4.700 aanroepen, met behulp van de gratis heuristische classifier en een Haiku, Sonnet, Opus-ladder. De beoordeling is deterministisch: gegenereerde code draait tegen de unit-tests van elke benchmark in een sandbox, en wiskunde- en meerkeuzeantwoorden worden gekoppeld aan sleutels.
In elk geval waren er aanzienlijke kostenbesparingen, zonder dat dit ten koste ging van de kwaliteit.
Voor de volledige methodologie, de uitsplitsing per dataset en de analyse van het productieverkeer leest u de technische deep dive: How we cut LLM cost by two-thirds without losing quality.
Auto Routing bevindt zich op een virtueel model. Ga naar AI Gateway → Models → Virtual Model, kies Complexity onder routing type, kies een classificatiestrategie en stel een doel in voor elk niveau dat u wilt bedienen. Wijs uw applicatie vervolgens naar de naam van het virtuele model en test het uit met prompts van verschillende complexiteit in de playground.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox

















