April 16, 2024
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De meeste teams die met AI bouwen, lopen tegen dezelfde muur op. Ze voeren duizenden model-calls per dag uit via verschillende providers en apps, en ze hebben vrijwel geen idee wat er precies in die calls gebeurt. Welke prompts werkten wel? Waarom gaf die agent een vreemd antwoord? Was de respons wel goed? Om die vragen te beantwoorden, moet er meestal handmatig trackingcode aan elke app worden toegevoegd — een taak waar niemand op zit te wachten en die door de meeste teams wordt overgeslagen. De integratie tussen de TrueFoundry AI Gateway en HoneyHive lost dit op door automatisch elke call vast te leggen die via de gateway loopt: de centrale plek waar alle calls sowieso al langskomen.
Zie de TrueFoundry AI Gateway als één centrale voordeur voor elk model dat je team gebruikt. In plaats van dat elke app rechtstreeks communiceert met OpenAI, Anthropic of een andere aanbieder, lopen alle verzoeken via de gateway. Deze regelt de complexe zaken op één plek: wie wat mag aanroepen, naar welk model een verzoek moet worden gestuurd, en het veilig en binnen de limieten houden van het systeem. Omdat elk verzoek via deze ene deur gaat, is het ook de perfecte plek om bij te houden wat er precies is gebeurd.
Het beste hieraan is dat er geen aanvullende instrumentatie nodig is. De gateway registreert automatisch de belangrijkste details van elke call: het gebruikte model, de tijdsduur, het aantal betrokken tokens, en de prompt en respons. Dit gebeurt nadat het verzoek al onderweg is terug naar de gebruiker. Zo vertraagt het toevoegen van deze zichtbaarheid de ervaring van de gebruikers van je app op geen enkele manier.
In HoneyHive wordt al die activiteit omgezet in iets wat je daadwerkelijk kunt inzien en kunt gebruiken om je agent te verbeteren. Het verzamelt de gegevens van je AI-calls en zet deze om in duidelijke, end-to-end traces: een stapsgewijs overzicht van alles wat er binnen een enkel verzoek of een volledige sessie is gebeurd. Dit omvat eventuele tools of agent-stappen onderweg, inclusief alle inputs, outputs en timing. Als er iets misgaat, kun je het spoor volgen in plaats van te gissen. Je kunt bovendien je coding agent gebruiken om de oorzaak van problemen te achterhalen via de HoneyHive CLI.
HoneyHive blijft niet steken bij observeren alleen. Dezelfde geregistreerde activiteit kan worden gebruikt voor evaluaties en experimenten. Zo kun je meten of je AI na verloop van tijd beter of slechter wordt, en wijzigingen testen voordat je ze naar productie brengt. Een trace is daarmee niet langer zomaar een logbestand van wat er is gebeurd, maar een concreet voorbeeld dat je kunt gebruiken om de kwaliteit te verhogen.
De twee tools sluiten naadloos op elkaar aan omdat ze dezelfde taal spreken. TrueFoundry legt van elke call al gegevens vast; HoneyHive weet precies hoe het die gegevens moet uitlezen. Ze verbinden dan ook heel eenvoudig. Voor verkeer dat toch al via de gateway wordt geleid, hoeft er geen code in je apps te worden toegevoegd en hoeven teams niets te onderhouden. Je schakelt de trace-export eenmalig in via de gateway, en vanaf dat moment verschijnt elke model-call die via TrueFoundry loopt automatisch in HoneyHive.
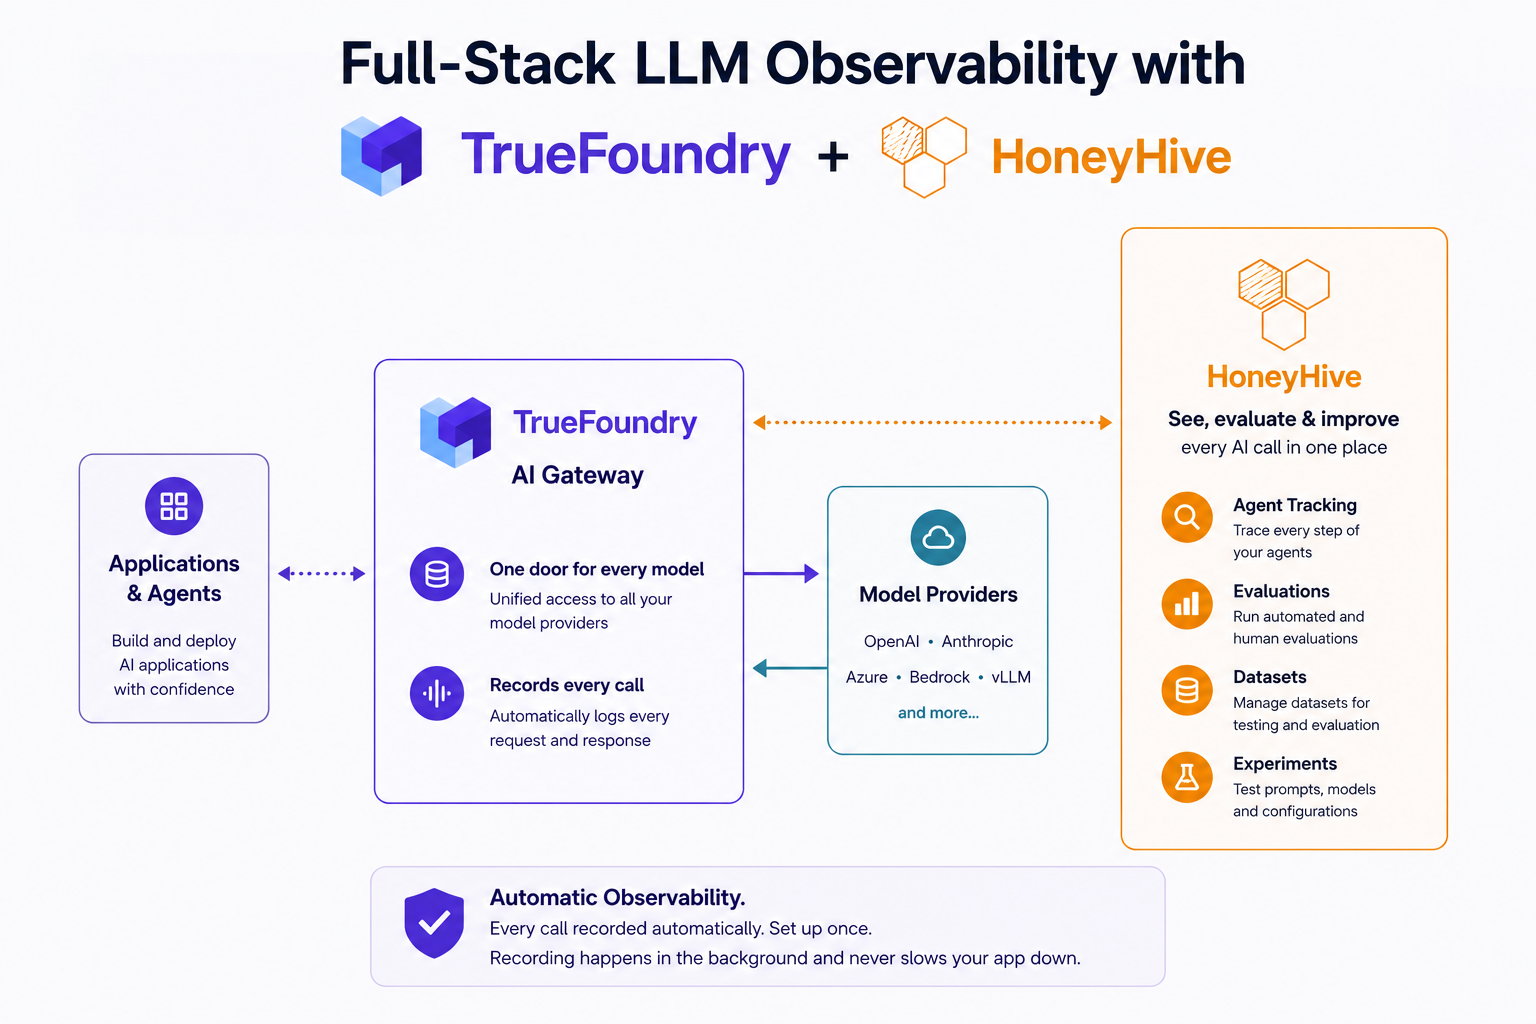
Figuur 1: Verzoeken stromen via de TrueFoundry AI Gateway naar modelproviders, terwijl de gateway een kopie van elke trace naar HoneyHive stuurt.
De verbinding werkt slechts in één richting en is puur een aanvulling op wat je al hebt. De gateway stuurt een kopie van elke afgeronde call naar HoneyHive, zonder dat dit invloed heeft op de werking van je app en zonder dat HoneyHive tussen de live verzoeken in komt te staan. En als je met gevoelige gegevens werkt, verwijdert de knop Exclude Request Data met één klik de inhoud van de prompt en respons voordat er iets uit de gateway vertrekt.
Het uitgangspunt is dat de gebruiker altijd op de eerste plaats komt. Het verzoek wordt beantwoord, en pas daarna stuurt de gateway het rapport geruisloos door naar HoneyHive.
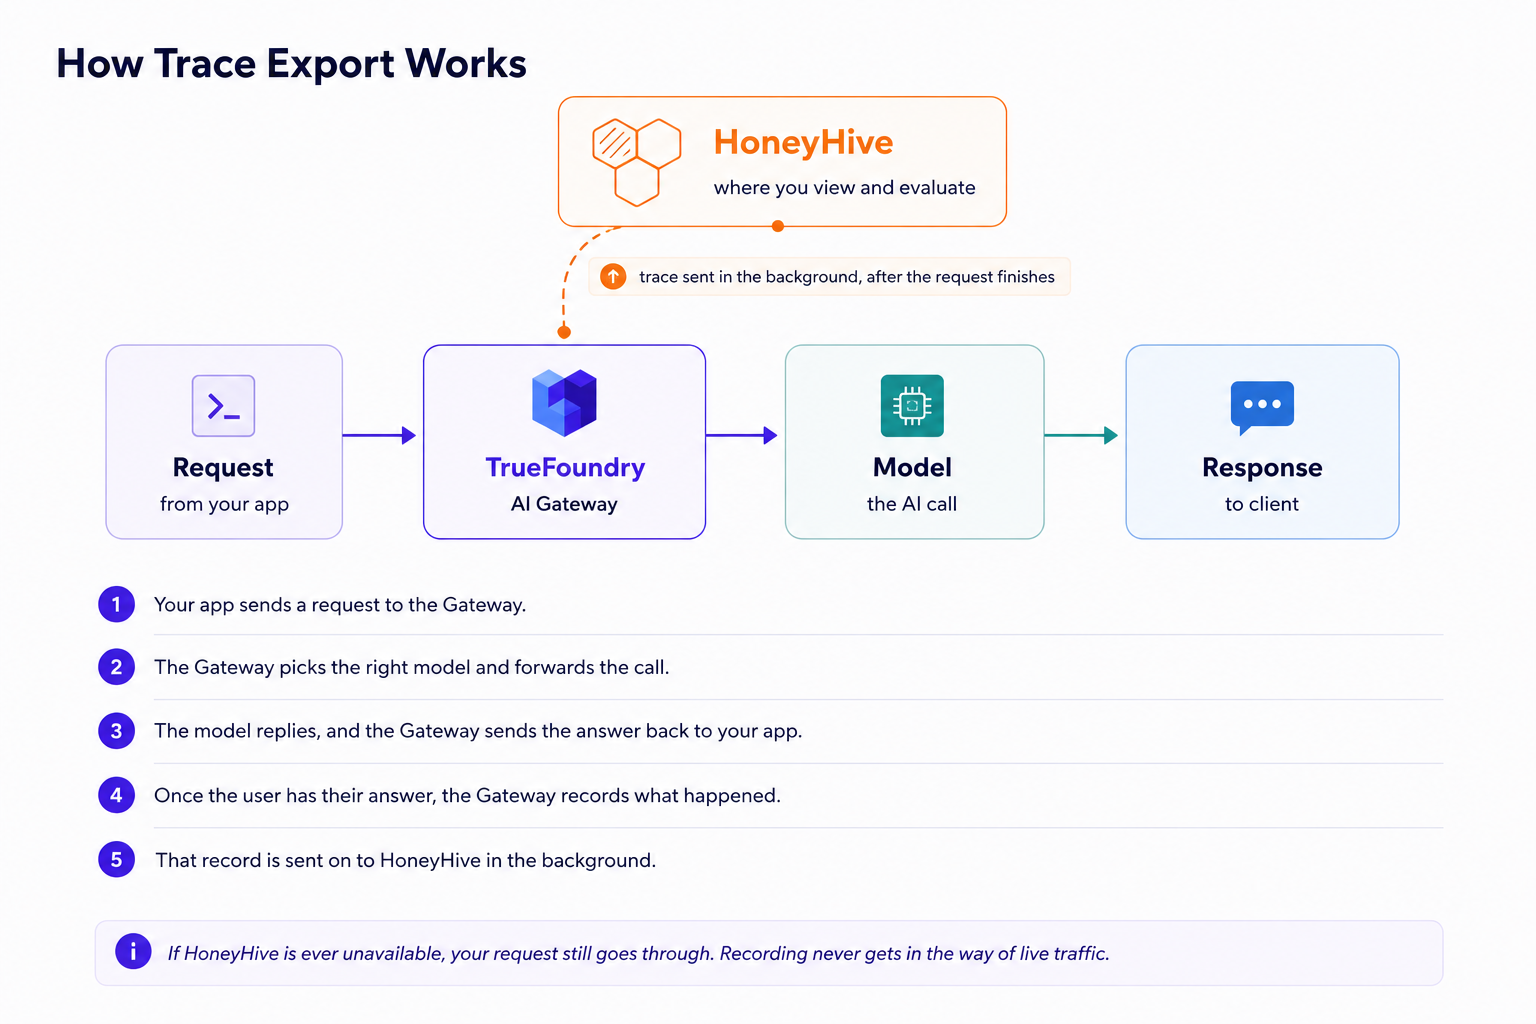
Figuur 2: Een verzoek wordt end-to-end beantwoord en de trace wordt pas achteraf, op de achtergrond, naar HoneyHive gestuurd.
De instelling is een configuratiewijziging, geen heel engineeringproject. Maak een project API key aan in HoneyHive. Open vervolgens in het TrueFoundry-dashboard AI Gateway → Controls → Settings, schakel de OTEL traces exporter in en verwijs deze naar je HoneyHive OTLP endpoint. De exacte waarden vind je hieronder.
Traces endpoint: https://<provider-host>/opentelemetry/v1/traces
Protocol: OTLP/HTTP
Encoding: Json
Auth header: Authorization: Bearer <HH_API_Key>
Om de koppeling te controleren, stuur je een paar verzoeken via de gateway. Open vervolgens Observe → Traces in HoneyHive en zoek naar nieuwe gebeurtenissen waarvan de SOURCE is ingesteld op otlp. De volledige stappen staan beschreven in de TrueFoundry HoneyHive integration docs.
Wat deze combinatie zo krachtig maakt, is dat elke tool doet waar hij het beste in is, verbonden via één eenvoudige koppeling. TrueFoundry voert je AI-calls uit en stuurt ze aan; HoneyHive helpt je om ze inzichtelijk te maken, te meten en te verbeteren. Omdat de gateway toch al voor al het verkeer staat, is zichtbaarheid niet langer een extra taak die elk team moet onthouden, maar simpelweg een vast onderdeel van hoe het platform werkt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox