Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
Machine Learning heeft een aanzienlijke impact op bijna alle aspecten van het bedrijfsleven. Maar vaak begint de nauwkeurigheid van het gedeployde model af te nemen, wat leidt tot een slechte klantervaring en de organisatie negatief beïnvloedt. De vraag is dus: waarom neemt de nauwkeurigheid van dit model af? Dit kan meerdere oorzaken hebben. Bijvoorbeeld:
Een spamdetectiemodel is na verloop van tijd niet meer in staat spamemails correct te detecteren omdat 'spammers' woorden en emailpatronen aanpassen die 'onbekend' zijn voor het model.
Een aanbevelingsmodel voor webshops kan sterk worden beïnvloed door grote wereldgebeurtenissen zoals de uitbraak van covid-19, waardoor de voorkeuren van klanten veranderen.
Een churn prediction-model zal na verloop van tijd verslechteren doordat klantgedrag en uitgavenpatronen langzaam veranderen.
Modelverslechtering na verloop van tijd
Hoe zorgen we er dus voor dat onze model performance na verloop van tijd niet afneemt? Hoe komen we erachter wanneer we ons model opnieuw moeten trainen om een daling in nauwkeurigheid te voorkomen?
Het antwoord is 'drift'. Men moet 'drift' tijdig en 'nauwkeurig' detecteren en op basis daarvan passende maatregelen nemen.
Wat is Model drift?
Model Drift verwijst naar de verandering in de distributie van data over een bepaalde periode. In de context van Machine Learning verwijzen we meestal naar drift in modelfeatures, voorspellingen of werkelijke waarden (actuals) ten opzichte van een gegeven baseline.
Er worden verschillende methoden gebruikt voor drift tracking, waaronder de Kolmogorov-Smirnov-statistiek, de Wasserstein-afstand en de Kullback-Leibler-divergentie. Deze metrieken worden vaak gebruikt in online learning-scenario's, waarbij het doel-systeem continu evolueert en het model zich in real-time moet aanpassen om zijn nauwkeurigheid te behouden. Een aanbevelingsmodel voor films kan bijvoorbeeld na verloop van tijd driften als het klantgedrag verandert, en een churn prediction-model kan driften door veranderende economische omstandigheden.
Verschillende typen Model drift:
Data Drift: Dit verwijst naar de verandering in distributies van verschillende features of veranderingen in relaties tussen verschillende features na verloop van tijd. Dit kan het gevolg zijn van veranderingen in de inputs zelf. Bijvoorbeeld: bij een model dat kredietwaardigheid bepaalt en is getraind op data van één jaar, zal het gemiddelde inkomen driften als gevolg van economische veranderingen of een recessie.
Concept Drift: Concept drift verwijst naar de drift in de ground truth-waarden van het model. Dit duidt op een verandering in de distributie van de werkelijke waarden waarvoor het model wordt gebruikt. Concept drift hangt niet af van het model, maar uitsluitend van de ground truth-waarden. Drift in werkelijke waarden geeft aan dat er mogelijk een verandering is opgetreden in de relatie tussen features en werkelijke waarden (vergeleken met de trainingsdataset of eerdere tijdsintervallen), wat wijst op de noodzaak om het model opnieuw te trainen.
Prediction Drift: Prediction drift verwijst naar de drift in de distributie van voorspelde waarden vergeleken met voorspelde waarden van de trainingsdata of data uit een voorgaand tijdsinterval. Prediction drift duidt meestal op een onderliggende data drift, aangezien voorspellingen een functie zijn van het model en de features, en het model ongewijzigd blijft. Prediction drift kan ons helpen om data drift en een daling in de nauwkeurigheid van het model te detecteren.
Model Drift
Verschillende methoden voor Drift Monitoring
Statistische methoden
Statistische methoden worden gebruikt om het verschil tussen de gegeven distributie en de referentiedistributie te meten. Op afstand gebaseerde metrieken of divergentie worden vaak gebruikt om de drift op een feature of werkelijke waarde te berekenen. Statistische methoden kunnen goed zijn in het detecteren van outliers of verschuivingen in de inputdistributie en zijn zeer eenvoudig te berekenen en te interpreteren. Ze houden geen rekening met de verandering in de correlatie tussen verschillende features, dus ze beschrijven het volledige driftverhaal alleen wanneer de inputfeatures onafhankelijk zijn.
Hier zijn een paar bekende op afstand gebaseerde metrieken voor het berekenen van drift:
Kolmogorov-Smirnov-statistiek: Deze meet het maximale verschil tussen twee cumulatieve distributiefuncties. Het is een niet-parametrische test die niet uitgaat van een specifieke distributie voor de data. Het wordt veel gebruikt bij drift-detectie vanwege het vermogen om veranderingen in de distributie van de data te detecteren.
Wasserstein-afstand: Deze staat ook wel bekend als de Earth Mover's Distance (EMD). Het meet de hoeveelheid "werk" die nodig is om de ene distributie in de andere te veranderen. Het heeft het vermogen om subtiele veranderingen in de distributie van de data vast te leggen die mogelijk niet door andere afstandsmetrieken worden opgemerkt.
De Wasserstein-afstand is de laatste tijd erg populair geworden vanwege het vermogen om te gaan met hoogdimensionale en ruisrijke data.
Kullback-Leibler-divergentie: Dit is een maatstaf voor het verschil tussen twee kansverdelingen, ook wel relatieve entropie of informatiedivergentie genoemd. Het is een niet-symmetrische metriek, wat betekent dat de KL-divergentie van distributie A naar distributie B niet gelijk is aan de KL-divergentie van distributie B naar distributie A.
Het is een van de meest gebruikte metrieken voor drift tracking, maar de cardinaliteit van de feature/voorspelling die wordt gevolgd, mag niet te hoog zijn.
PSI (Population Stability Index): PSI meet in één enkel getal hoeveel een populatie na verloop van tijd of tussen twee verschillende steekproeven van een populatie is verschoven. Dit gebeurt door de twee distributies in buckets te verdelen en de percentages van items in elk van de buckets te vergelijken, wat resulteert in één enkel getal dat u kunt gebruiken om te begrijpen hoe verschillend de populaties zijn. De gebruikelijke interpretaties van het PSI-resultaat zijn:
PSI < 0,1: geen significante populatieverandering
PSI < 0,2: matige populatieverandering
PSI >= 0,2: significante populatieverandering
Men kan dus monitors instellen op de driftwaarde van features die de nauwkeurigheid van het model beïnvloeden en op basis daarvan relevante acties ondernemen.
Drift op modelniveau (Multivariate drift-detectie)
Multivariate drift-detectie helpt bij het detecteren van veranderingen of drift in meerdere variabelen of features samen. In tegenstelling tot univariate drift-detectie, die zich alleen richt op het detecteren van veranderingen in één enkele variabele, houdt multivariate drift-detectie rekening met de relatie tussen meerdere features en gaat het er niet van uit dat alle features onafhankelijk van elkaar zijn.
Daardoor kunnen multivariate drift-detectiemethoden veranderingen in de distributie van de data, veranderingen in de relatie tussen variabelen en veranderingen in de functionele relatie tussen variabelen detecteren. Deze methoden zijn bijzonder nuttig in complexe systemen waar veranderingen in één variabele een aanzienlijke impact kunnen hebben op het gedrag van andere variabelen. Multivariate drift helpt gebruikers dus om een beter inzicht te krijgen in de veranderingen in de inferencedata. Het is ook eenvoudiger te monitoren omdat er slechts één metriek gevolgd hoeft te worden, vergeleken met het afzonderlijk volgen van elke feature. Maar tegelijkertijd is het berekenen ervan computationeel zwaar en kan het overkill zijn voor eenvoudigere systemen.
Multivariate drift-detectiealgoritmen zijn meestal afhankelijk van een machine learning-model om de drift te berekenen. Deze algoritmen kunnen als volgt worden geclassificeerd:
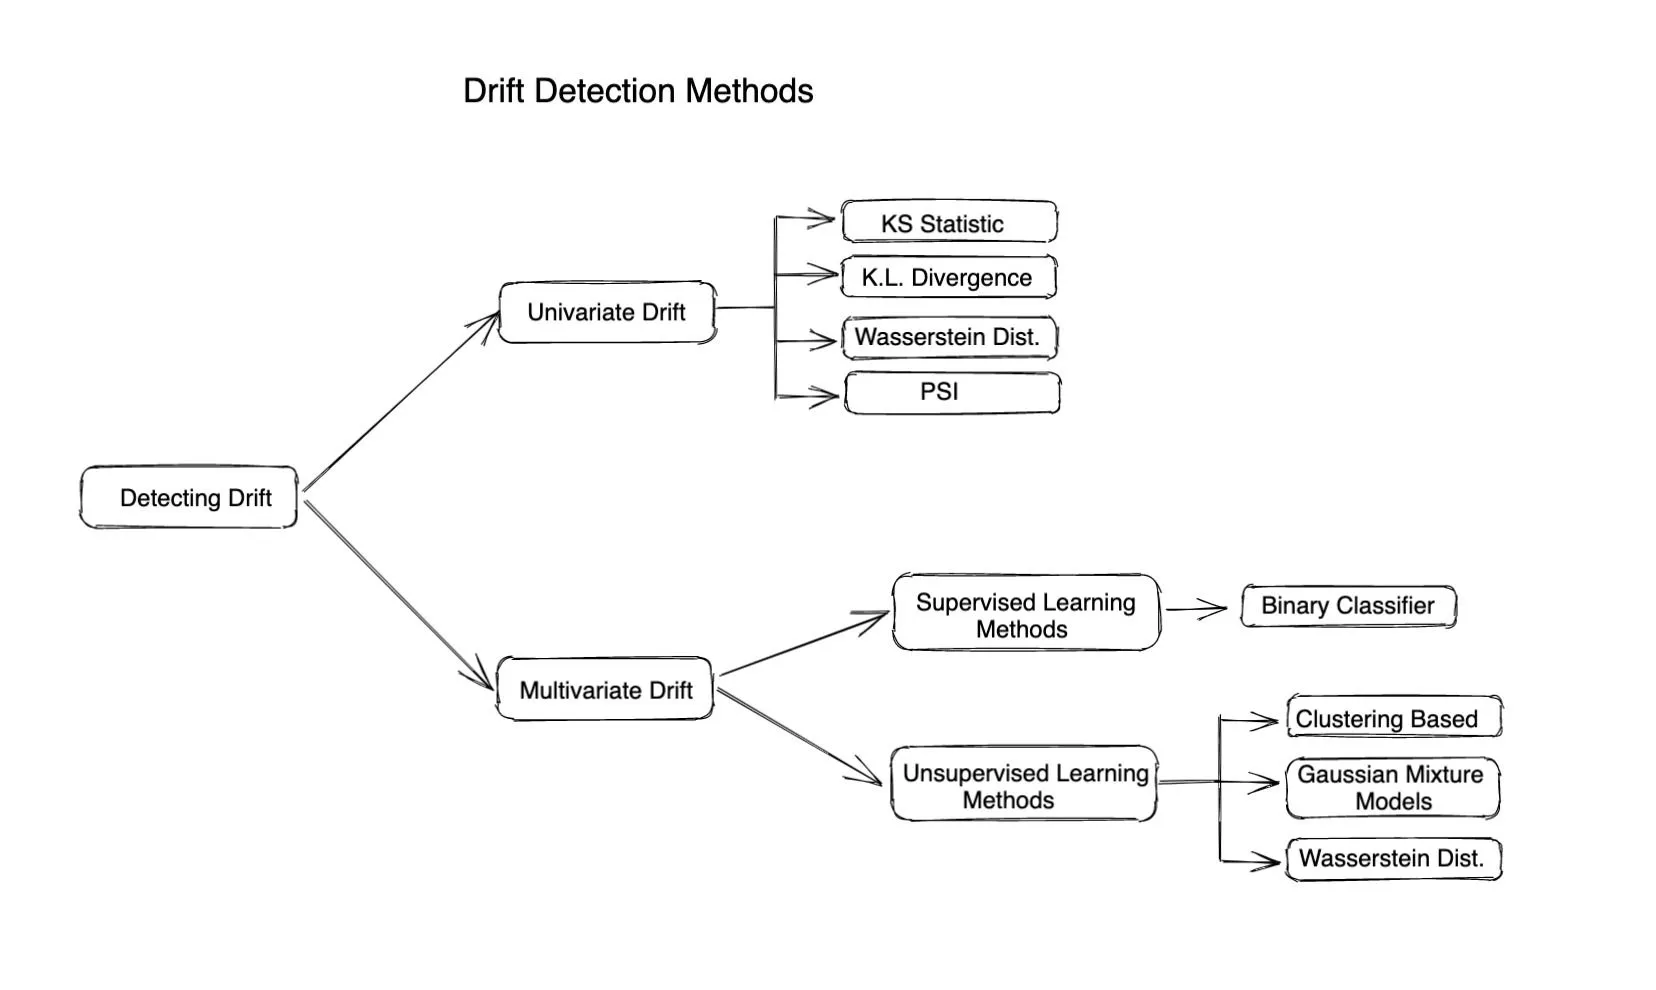
Gebruikmaken van gecontroleerde (Supervised) methoden: Deze zijn doorgaans gebaseerd op het trainen van een binair classificatiemodel om te raden of een datapunt afkomstig is uit de baseline dataframe. Een hogere nauwkeurigheid van het model duidt op een hogere drift.
Om te bepalen welke features zijn gedrift, wordt de feature importance van dit binaire classificatiemodel gebruikt.
Ongecontroleerde (Unsupervised) leermethoden: Hier zijn enkele methoden: Clustering: Gebruik K-means, DBSCAN of een ander clusteringalgoritme om clusters te vinden in de referentiedataset en de huidige dataset, en zoek vervolgens naar verschillen tussen de clusters om te beoordelen of de data is gedrift of niet.
Gaussian Mixture Models (GMM): GMM representeert onze data als een mengsel van Gaussische distributies. GMM kan worden gebruikt om multivariate drift te detecteren door de parameters van de Gaussische distributies van de huidige dataset te vergelijken met de referentiedataset.
Principal Component Analysis (PCA): Gebruik PCA om de dimensies van de dataset te reduceren en gebruik vervolgens reguliere univariate drift-detectiealgoritmen waarbij de features als uniek worden beschouwd.
Samenvattend is multivariate drift-detectie nuttig in complexe systemen en eenvoudiger te monitoren omdat er maar één KPI is om in de gaten te houden.
Model drift detecteren
Conclusie:
De performance van een model dat in productie is genomen, zal uiteindelijk afnemen. De tijd die nodig is voor deze verslechtering hangt af van de use case. In sommige gevallen driften modellen pas na een jaar, terwijl andere modellen elk uur opnieuw moeten worden getraind! Het begrijpen van de oorzaak van deze achteruitgang en het detecteren ervan is dus uiterst belangrijk. Dit is waar 'vroegtijdige detectie van drift' kan helpen.
Kortom, modellen in productie moeten beschikken over geschikte mechanismen voor drift tracking of drift monitoring en ingerichte retraining pipelines om de maximale waarde uit een machine learning-model te halen!
TrueFoundry is een ML Deployment PaaS op Kubernetes om de workflows van developers te versnellen, terwijl ze volledige flexibiliteit behouden bij het testen en deployen van modellen, met gegarandeerde veiligheid en controle voor het infrateam. Via ons platform stellen we Machine Learning-teams in staat om binnen 15 minuten modellen te deployen en te monitoren met 100% betrouwbaarheid, schaalbaarheid en de mogelijkheid om binnen enkele seconden een rollback uit te voeren – waardoor ze kosten besparen, modellen sneller naar productie brengen en echte bedrijfswaarde realiseren.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting