



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
GPT-6 Astra is geland op 3 september 2026. De API-string is gpt-6-astra — geen snapshot met datum, geen afzonderlijke alias; de modelpagina vermeldt gpt-6-astra als zowel de snapshot als de alias.
De specificaties, uit de modeldocumentatie van OpenAI:
Drie zaken in de kleine lettertjes zijn belangrijker dan de kop.
Ten eerste, reasoning.effort accepteert geen none meer. GPT-5.6 Sol deed dat wel. Als u een goedkoop snel pad had vastgepind op none, zal dit niet meegaan.
Ten tweede, temperature, top_p en logprobs zijn verdwenen. De changelog vermeldt dat Astra “geen aangepaste temperature- of top_p-waarden of log probabilities ondersteunt.” Alles in uw stack dat sampling-parameters instelt, moet worden gecontroleerd voordat u overstapt.
Ten derde, tool calling vereist de Responses API. Als u vandaag tools aanroept via Chat Completions, is dat een migratie, geen eenvoudige modelwissel.
[SCREENSHOT: OpenAI Platform — de gpt-6-astra modelpagina met weergave van context window, max output en prijs per token]
Het context window en de outputlimiet zijn niet veranderd. De prijs wel.
Bronnen: GPT-6 Astra model docs, GPT-5.6 Sol model docs, september 2026. Merk op dat OpenAI de tarieven van GPT-5.6 Sol beschrijft als promotionele prijzen die beschikbaar zijn tot ten minste 21 november 2026, dus de verhouding blijft na die datum mogelijk niet hetzelfde.
Elk tarief is met exact dezelfde factor gestegen. Dat blijkt van belang te zijn voor de caching-vraag hieronder.
Batch en Flex blijven op 50% van Standard. Fast mode, waarvan OpenAI zegt dat het tot 2x de snelheid van Standard-verwerking levert, is geprijsd op 2x de toepasselijke tarieven — dus Fast mode Astra kost $20 input en $100 output.
OpenAI publiceert een grote head-to-head tabel in de launch post. Hier is het gedeelte dat het reproduceren waard is, en vervolgens het gedeelte dat de meeste verslaggeving overslaat.
Bron: GPT-6 Astra launch post, september 2026. Scores zijn het maximum bij elke reasoning effort.
Waar Astra duidelijk leidt. Agentisch werk met een lange horizon. Terminal-Bench 4.0 stijgt meer dan twintig punten ten opzichte van Sol. Terminal-Bench Science is bijna verdrievoudigd. AutomationBench is meer dan verdubbeld. Long-context retrieval bij 512K-1M gaat van 73,8% naar 96,3%. Dit zijn de workloads waarvoor het model is gebouwd en de kloof is niet subtiel.
Waar de kloof kleiner wordt tot ruis. Single-shot kennis en redenering. GPQA Diamond verschuift van 94,6% naar 96,0%. DeepSWE verschuift van 72,7% naar 74,1%. Als uw verkeer bestaat uit vragen met antwoorden in plaats van taken met stappen, betaalt u 2,5x voor ongeveer één punt winst.
Waar Astra niet wint. Op de twee samengestelde indexen van derden die OpenAI heeft opgenomen, staat Astra niet bovenaan. Artificial Analysis Intelligence Index plaatst Claude Fable 5.1 op 65,7 tegenover Astra’s 61,2. De Coding Agent Index plaatst Claude Opus 5 op 68,1 tegenover Astra’s 67,0. OpenAI heeft beide cijfers gepubliceerd, wat hen te prijzen valt, en ze vormen een eerlijk tegenwicht voor de agentische overwinningen hierboven.
Eén ding dat het prijsverhaal nuanceert. De kostenramingen per taak van OpenAI vallen soms lager uit dan bij Sol ondanks de 2,5x tarieven, omdat Astra in minder tokens klaar is. De launch post claimt een ruimschoots 9% lagere geschatte API-kosten per taak op Terminal-Bench 4.0 vergeleken met Sol, ongeveer 27% lager op Terminal-Bench Science bij een lagere kosteninstelling, en ongeveer 43% lager op BenchCAD. Dit zijn OpenAI's eigen schattingen in specifieke configuraties, geen onafhankelijke reproducties, en ze zullen niet direct gelden voor uw verkeer. Maar ze betekenen wel dat “2,5x duurder” een verkeerde samenvatting is voor agentisch werk. Meet tokens per voltooide taak, niet de prijs per token.
TrueFoundry heeft de cache break-even wiskunde op GPT-5.6 doorgerekend toen cache writes voor het eerst factureerbaar werden. Dezelfde vraag geldt hier, en het antwoord is interessanter dan het lijkt.
Astra's cache-vermenigvuldigers zijn identiek aan die van GPT-5.6. De model docs vermelden dat cache writes gefactureerd worden op 1,25x het niet-gecachete input-tarief, en het gepubliceerde gecachete-input-tarief van $1,00 ten opzichte van een $10,00 input-tarief is exact 0,10x. Dus:
Laat w het aandeel requests tegen een gedeelde prefix zijn dat cache writes zijn in plaats van reads. Caching speelt quitte (break-even) wanneer:
1,25w + 0,10(1 - w) = 1
1,15w = 0,90
w = 78,3%
Het break-even punt is 78,3%, ongewijzigd ten opzichte van GPT-5.6. P valt weg, en dat is waarom de 2,5x prijsstijging niets verandert. Caching stopt pas met lonen wanneer meer dan ongeveer 78% van uw requests tegen een gegeven prefix writes zijn — dat wil zeggen, wanneer uw gedeelde context gemiddeld minder dan ongeveer 1,3 requests overleeft voordat deze verandert of verloopt. Bijna geen enkele echte agent-workload bevindt zich op dat niveau.
Wat de prijsstijging wel verandert, is de omvang van de besparing. Neem een gedeelde prefix van 32K tokens die hergebruikt wordt gedurende een sessie van 25 requests — één write, vierentwintig reads:
Het percentage is identiek. Het geldbedrag is 2,5x groter. Caching was altijd al de moeite waard; op Astra kost het niet toepassen ervan tweeënhalf keer zoveel.
Het faalscenario is ook ongewijzigd: context die snel wisselt. Als uw agent elke paar turns zijn system prompt of tool-schema opnieuw opbouwt, betaalt u $12,50 per miljoen om een cache te schrijven die u nauwelijks leest. Dat is nu een fout van $12,50 in plaats van een van $5,00.
Het geadverteerde GPT-6 context window is 1.050.000 tokens. De facturatie schaalt echter niet gelijkmatig hierover.
Uit de model docs: “Prompts met meer dan 272K input tokens worden geprijsd op 2x het input- en cache-tarief en 1,5x output voor de gehele request.”
Lees dat zorgvuldig. Het geldt voor de gehele request, niet alleen voor de overschrijding boven 272K. Het overschrijden van de grens kost u niet het dubbele voor de extra tokens; het kost u het dubbele voor ál de tokens.
Een toename van 0,7% in promptgrootte leidt tot een toename van 101% in de inputrekening. Gecachete reads verdubbelen ook, van $1,00 naar $2,00 per miljoen, en output gaat van $50,00 naar $75,00. GPT-5.6 Sol heeft dezelfde regel, dus dit is niet nieuw — maar bij Astra's tarieven is de stap 2,5x hoger.
Het praktische gevolg: als uw prompts dicht bij de 272K liggen, is de hoogst haalbare kostenoptimalisatie die voor u beschikbaar is, om ze eronder te krijgen. Het schrappen van 5K tokens uit een prompt van 275K is meer waard dan welke routing-wijziging u ook zou kunnen doorvoeren.
[SCREENSHOT: OpenAI Platform — usage dashboard met input, gecachete input en output token-uitgaven per model]
Vier faalscenario's komen herhaaldelijk voor in de eerste weken na de lancering van een frontier model, en Astra kent ze alle vier.
Alles wordt naar het nieuwe model gerouteerd. Het duurste wat een team kan doen na een lancering, is de standaardinstelling naar het nieuwe model laten wijzen. Bij $10 input en $50 output kost een classificatie-aanroep die een goedkoop model correct beantwoordt nu 2,5x zoveel als vorige maand, zonder enige kwaliteitswinst. De benchmark-spreiding hierboven is een argument voor een gemengde vloot, niet voor een blindelings uitgevoerde migratie.
De migratie is geen eenvoudige string-wissel. Geen none reasoning effort, geen temperature, geen top_p, geen logprobs, en tool calling vereist de Responses API. Code die werkte met gpt-5.6-sol kan mislukken met gpt-6-astra op manieren die pas in productie duidelijk worden.
Misalignment-monitoring kan uw request stoppen. OpenAI voert asynchrone controles uit op agent-werk bij ondersteunde Responses API-requests. De launch post is expliciet over het gevolg: in ChatGPT of Codex wordt u mogelijk gevraagd om een actie te beoordelen, maar “in de API zal de taak stoppen.” OpenAI erkent dat deze controles “soms legitiem werk kunnen onderbreken.” Dat is een nieuwe betrouwbaarheidskarakteristiek om rekening mee te houden in het ontwerp, geen voetnoot.
Niemand weet wat het daadwerkelijk kost totdat de factuur arriveert. Prijs per token zegt heel weinig wanneer het model een verschillend aantal tokens per taak gebruikt. Zonder kostenallocatie per request en per team is de vraag “is Astra goedkoper of duurder voor ons” onbeantwoordbaar.
Een duurder frontier model verzwakt de noodzaak voor een gateway niet. Het versterkt deze juist, omdat elke routingbeslissing nu 2,5x meer waard is.
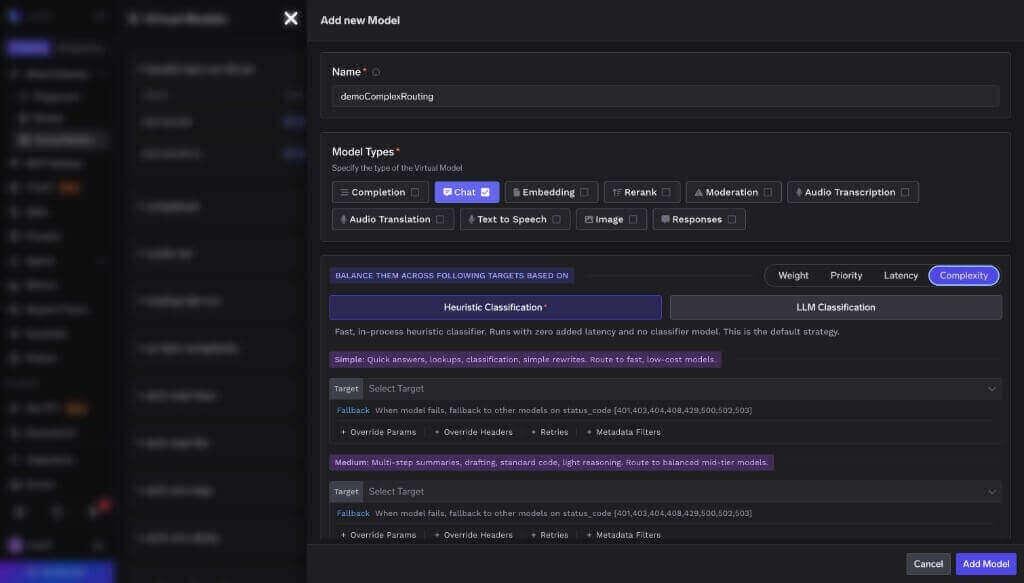
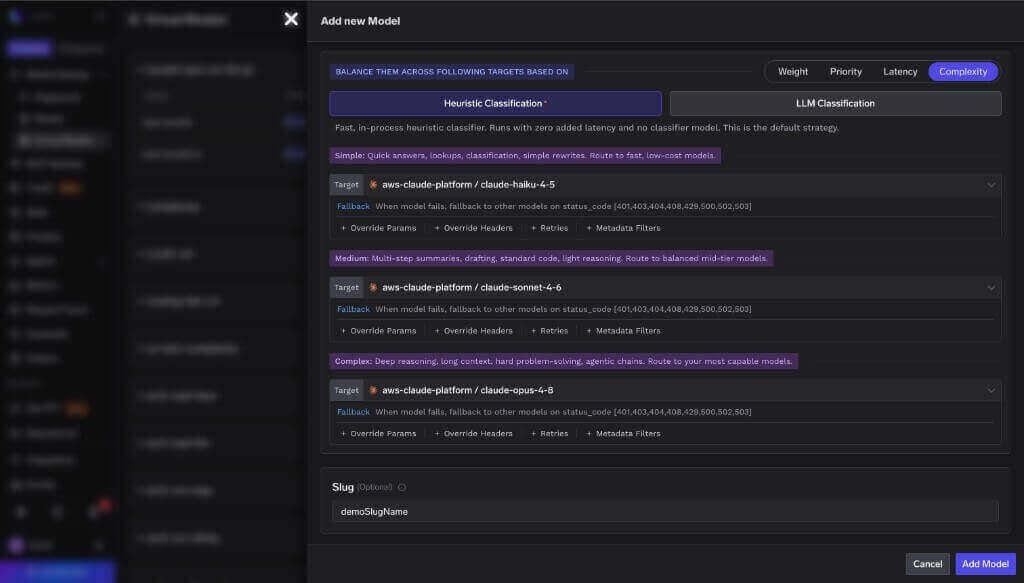
Routeer op complexiteit, niet uit gewoonte. De AI Gateway classificeert inkomende requests en stuurt elke request naar een passend tier, zodat zwaar agentisch werk Astra bereikt en extractie, classificatie en samenvatting dat niet doen. In TrueFoundry’s eigen Auto Routing benchmark over 550 prompts verlaagde deze tiering de kosten met 69% behoudens 98% van de baseline-kwaliteit, waarbij de gemiddelde latency daalde van 7,6s naar 4,0s. Op productie-achtig verkeer bereikte de reductie zelfs 80%. Die percentages toegepast op $10/$50 tarieven zijn aanzienlijk meer waard dan ze waren op $4/$20.
Normaliseer caching over providers heen. Astra’s cache-semantiek is die van OpenAI. Die van Anthropic is anders, en die van Bedrock wijkt opnieuw af. Provider-agnostische prompt caching bij de gateway betekent dat u de prefix één keer schrijft en dat de 78.3% regel hierboven waar blijft, ongeacht welk model de router kiest.
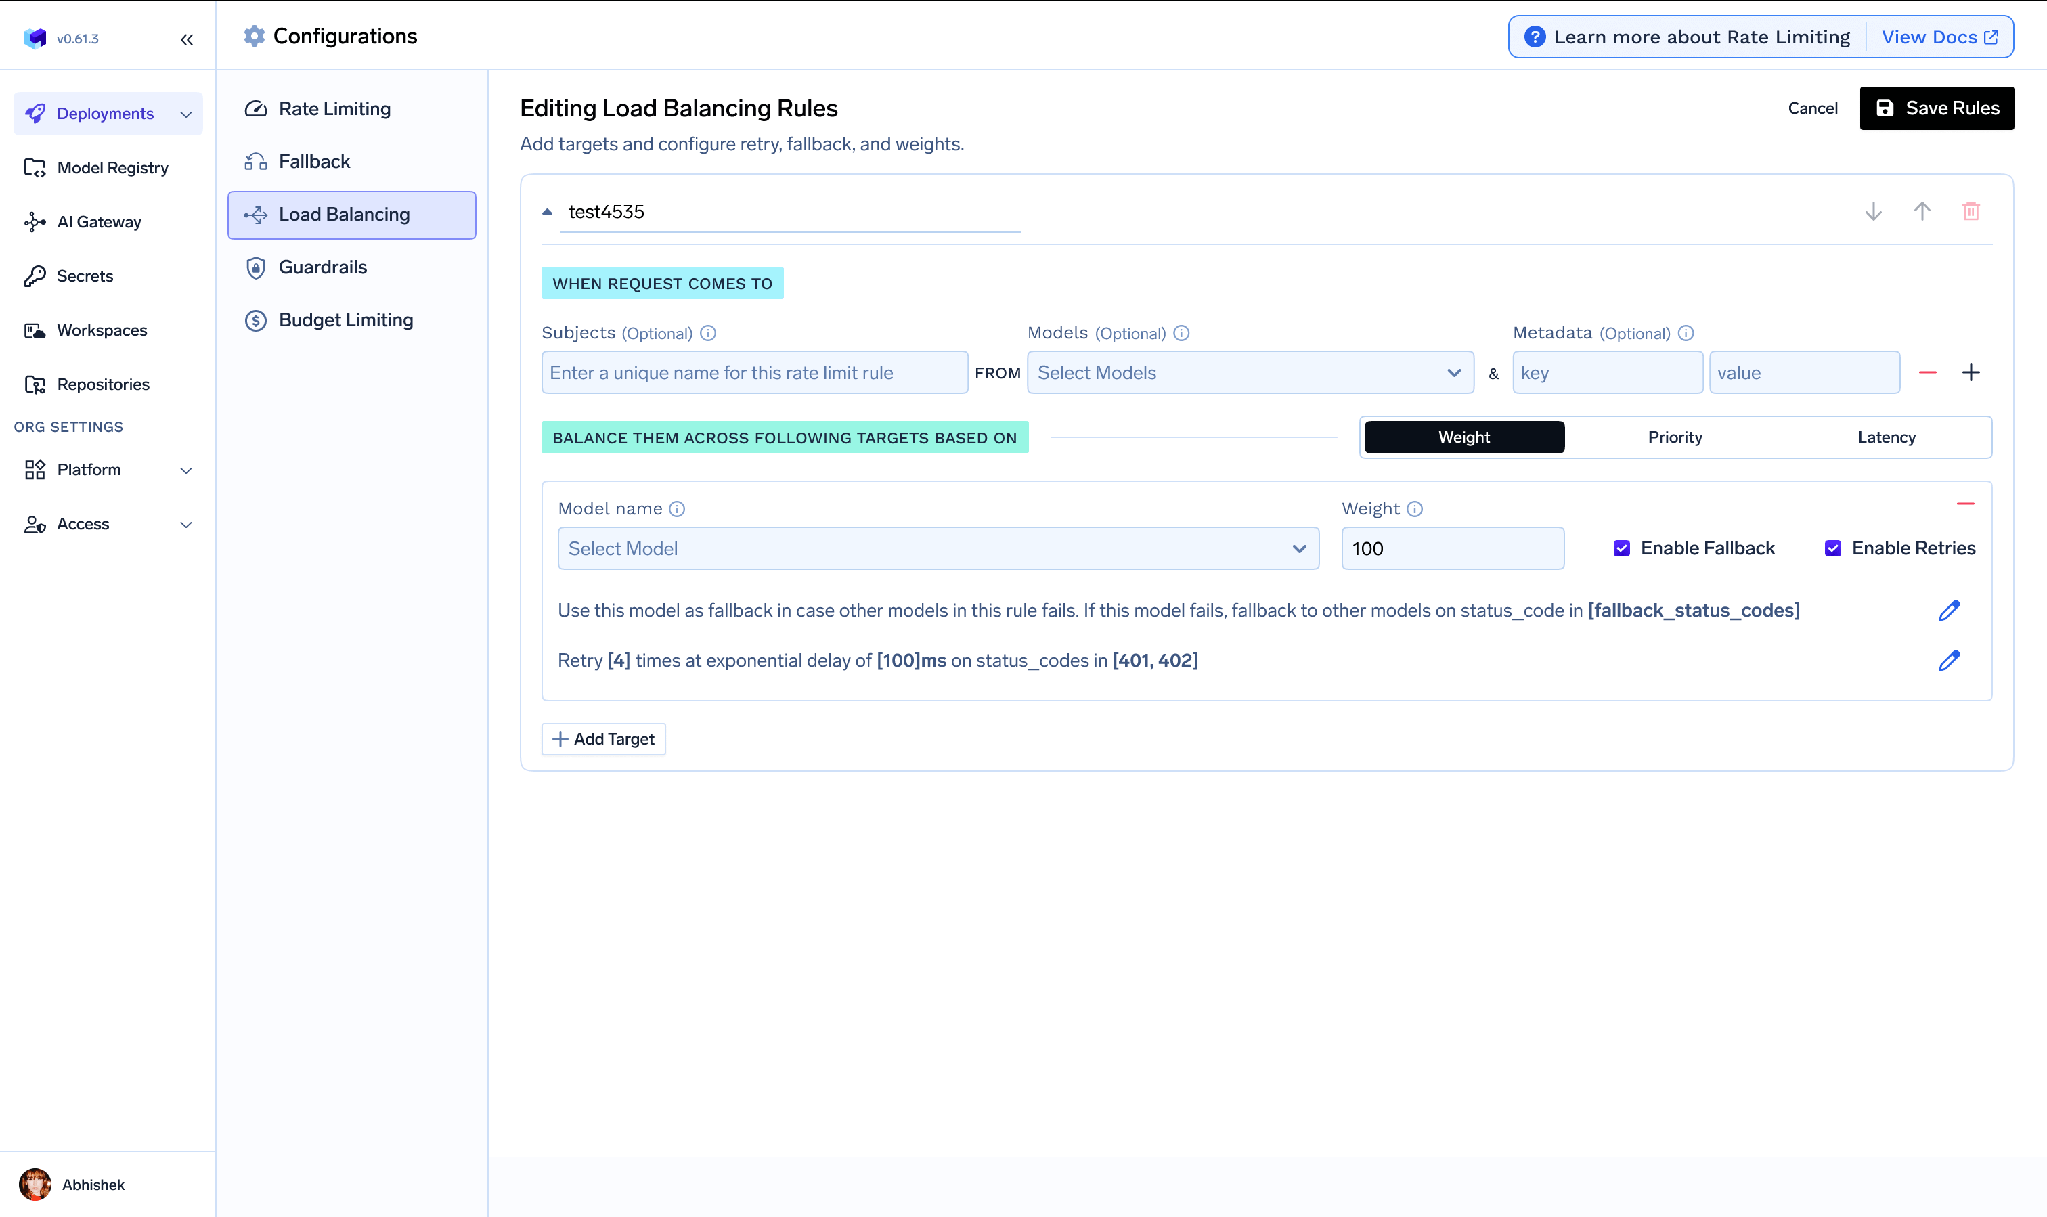
Meet kosten per taak, niet kosten per token. Het hele prijsargument voor Astra draait om token-efficiëntie, en dat kunt u niet oplossen aan de hand van een prijslijst. Kosten per request, token-aantallen en latency gespecificeerd per team en model is de manier waarop u erachter komt of Astra's claim van minder-tokens-per-taak standhoudt op uw workload.
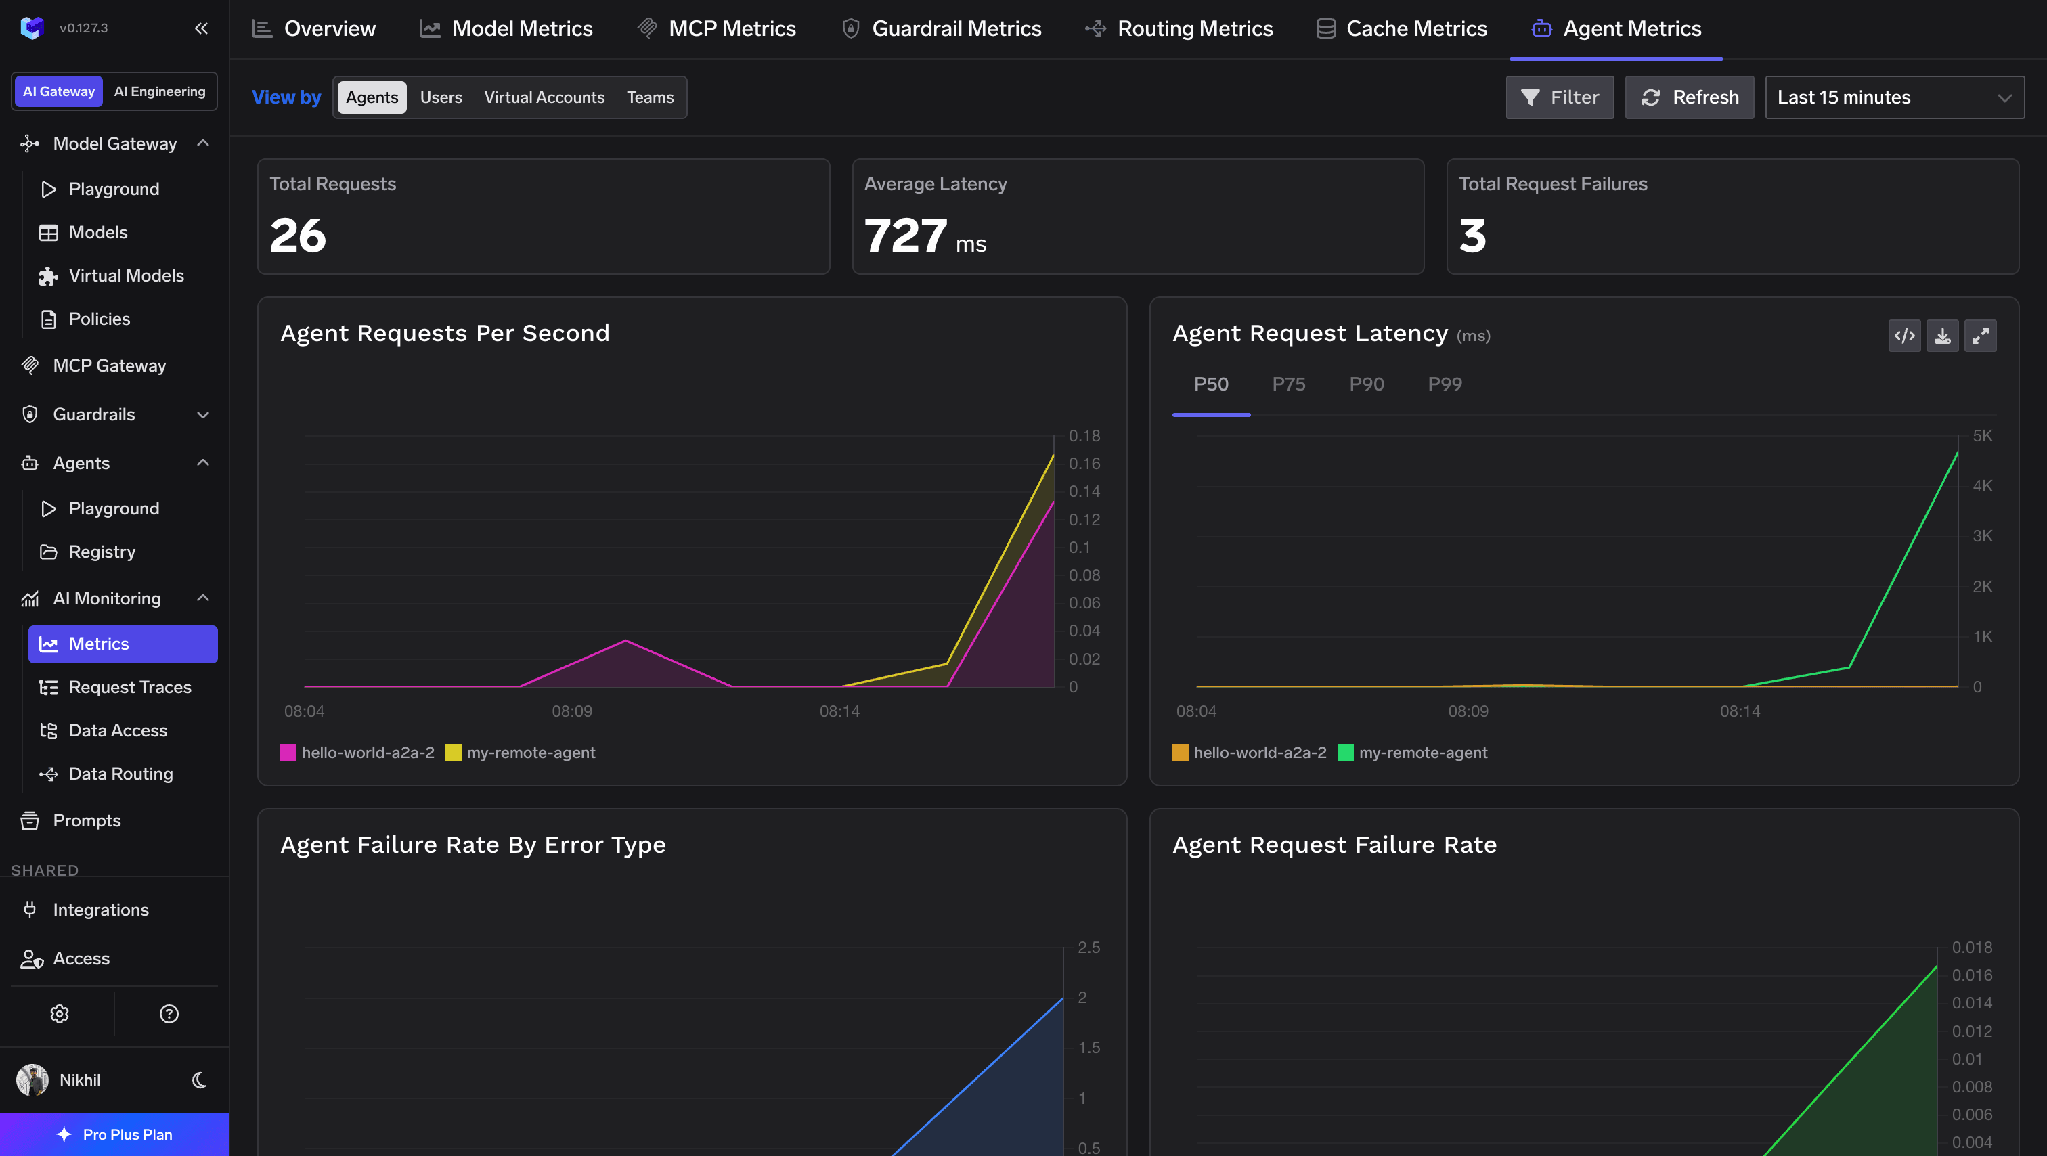
Behoud één guardrail-pad over alle modellen heen. Guardrails op gateway-niveau draaien op het request- en response-pad, welk model er ook antwoordt, zodat een routing-wijziging uw veiligheidsniveau niet stilzwijgend verandert.

De korte versie, per september 2026:
GPT-6 Astra is een echte stap voorwaarts voor het werk waarvoor het is gebouwd. Terminal-Bench 4.0 twintig punten hoger, long-context retrieval tweeëntwintig punten hoger, AutomationBench meer dan verdubbeld — dat zijn geen incrementele stappen. Op de samengestelde indexen van derden die OpenAI zelf heeft gepubliceerd, is het niet de leider, en op single-shot kennisvragen is het verschil ten opzichte van GPT-5.6 Sol niet veel meer dan een afrondingsfout.
De prijsstelling laat dezelfde tweedeling zien. Elk tarief ging 2,5x omhoog, wat klinkt als een lineaire prijsstijging, totdat u opmerkt dat OpenAI's eigen schattingen per taak lager uitvallen dan bij Sol op verschillende agentische benchmarks, omdat Astra in minder tokens klaar is. Beide zaken kunnen waar zijn. Welke voor u geldt, is een empirische vraag over uw specifieke verkeer, en de enige manier om die te beantwoorden is door beide te draaien en de kosten per voltooide taak te meten.
Twee dingen vereisen geen meting. Caching loont nog steeds op precies hetzelfde 78,3% break-even punt als op GPT-5.6, dus als u vandaag cached, blijf dat doen. En de 272K facturatiecliff is een stapsgewijze functie die een inputrekening stilzwijgend kan verdubbelen voor een prompt die slechts met een paar duizend tokens is gegroeid.
Het komt er dus op aan wat u wilt beheren. Als u één model en een eenvoudige rekening wilt, richt dan alles op Astra en accepteer dat u te veel betaalt voor de eenvoudige helft van uw verkeer. Als u liever zwaar werk naar het frontier model stuurt en al het andere naar iets goedkopers, heeft u een routinglaag nodig — en bij $10 input en $50 output is de onderbouwing om er een te bouwen zojuist tweeënhalf keer overtuigender geworden.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



GPT-6 Astra is OpenAI’s frontier model, released on 3 September 2026 and callable in the API as gpt-6-astra. It is available through the OpenAI API, Microsoft Azure and AWS Bedrock, and to ChatGPT Plus, Pro, Business and Enterprise users.
As of September 2026, per 1M tokens: $10.00 input, $1.00 cached input, $12.50 cache writes, $50.00 output. Batch and Flex are 50% of those rates; Fast mode is 2x. Requests over 272K input tokens are billed at 2x input and cache rates and 1.5x output for the entire request.
1,050,000 tokens, with a 128,000-token maximum output. Both are identical to GPT-5.6 Sol. The practical limit is commercial rather than technical: past 272K input tokens the whole request is billed at double the input rate.
It depends entirely on task shape. On long-horizon agentic work the gains are large — Terminal-Bench 4.0 goes from 37.3% to 57.9%. On single-shot knowledge questions they are marginal, and you are paying 2.5x per token for them. Route accordingly rather than switching wholesale.
Ja, en met dezelfde marge. Cacheschrijvingen zijn 1,25x input en lezingen zijn 0,10x, precies zoals bij GPT-5.6, dus het break-evenpunt ligt hoe dan ook bij een schrijfaandeel van 78,3%. Hogere lijstprijzen verhogen de absolute besparingen, niet de drempel.
De AI Gateway van TrueFoundry voegt ongeveer 3-4 ms toe en houdt 350+ RPS vol op 1 vCPU, wat verwaarloosbaar is naast generatietijden van meerdere seconden.



Het laatste nieuws, artikelen en bronnen in je inbox



















