



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De meeste AI-teams kunnen precies vertellen hoeveel tokens hun applicaties vorige week hebben verbruikt. Veel minder teams kunnen zeggen hoeveel van die antwoorden daadwerkelijk goed waren. Tracing legt vast wat er is gebeurd; evaluatie beoordeelt of het juist was. In een organisatie waar tientallen services modellen aanroepen via verschillende SDK's en agent-frameworks, is het inrichten van beide in elke codebase een project dat nooit helemaal afkomt.
De integratie tussen TrueFoundry AI Gateway en Confident AI verplaatst dat werk naar de infrastructuurlaag. Elke request die de gateway passeert, kan in Confident AI aankomen als een trace, klaar om te worden beoordeeld door evaluatiemetrics, zonder dat er één regel tracing-code in de applicatie nodig is.
TrueFoundry AI Gateway bevindt zich tussen applicaties en de modellen die ze aanroepen. Het biedt één OpenAI-compatibele API over verschillende providers heen en beheert authenticatie, routing over virtuele modellen, rate limiting en guardrails in één enkele uitvoeringslaag. De configuratie wordt in het geheugen van stateless gateway pods bewaard, waardoor de gateway dit alles afhandelt met een vertraging van slechts ongeveer 3 ms.
De eigenschap die hier van belang is, is dat de gateway OpenTelemetry-compliant is. Elke request genereert spans voor de inbound handler, authenticatie, modelresolutie, de outbound providercall en de streaming response. Die spans bevatten standaard gen_ai.*-attributen zoals token-aantallen en finish reasons, samen met tfy.input en tfy.output voor de request- en response-payloads. Traces worden asynchroon gepubliceerd nadat de request is voltooid en kunnen worden geëxporteerd naar elk OTLP-endpoint, naast TrueFoundry's eigen trace-opslag.
Confident AI is een platform voor LLM-evaluatie en observability van het team achter het open-source DeepEval-framework. De tracing is OpenTelemetry-native: elke trace komt binnen via de OTEL server, een OTLP/HTTP-ingestie-endpoint dat elke batch authenticeert met een project-API-sleutel en traces herbouwt op basis van hun span ID's. Binnenkomende spans worden getypeerd als LLM-, tool-, agent- of retriever-spans, waarbij model, tokenverbruik en kosten worden ingevuld vanuit de OpenTelemetry GenAI semantische conventies.
Wat een trace-store verandert in een kwaliteitssysteem is online evaluatie. Teams groeperen metrics zoals antwoordrelevantie, getrouwheid (faithfulness), toxiciteit en PII-lekkage in metric collections, en koppelen deze vervolgens aan live verkeer via Evaluation Rules die filteren op span-type en samplen op een gekozen percentage, bijvoorbeeld 5% van productie en alles van staging. Evaluatie draait op de server zodra traces worden binnengehaald, waardoor een kwaliteitsscore direct naast de latency en kosten op de trace te zien is.
Elke zijde bevat de helft van de oplossing. De gateway ziet elke modelcall binnen de organisatie, ongeacht de taal of het framework waarmee deze is gemaakt, maar het beoordelen van de antwoordkwaliteit is niet de taak van de gateway. Confident AI kan elke span die het ontvangt typeren en scoren, maar het ontvangt alleen wat er naartoe wordt gestuurd. Door de OTEL Traces Exporter van de gateway naar de OTEL-server van Confident AI te laten wijzen, wordt de gateway het centrale instrumentatiepunt voor elke applicatie die erachter zit.
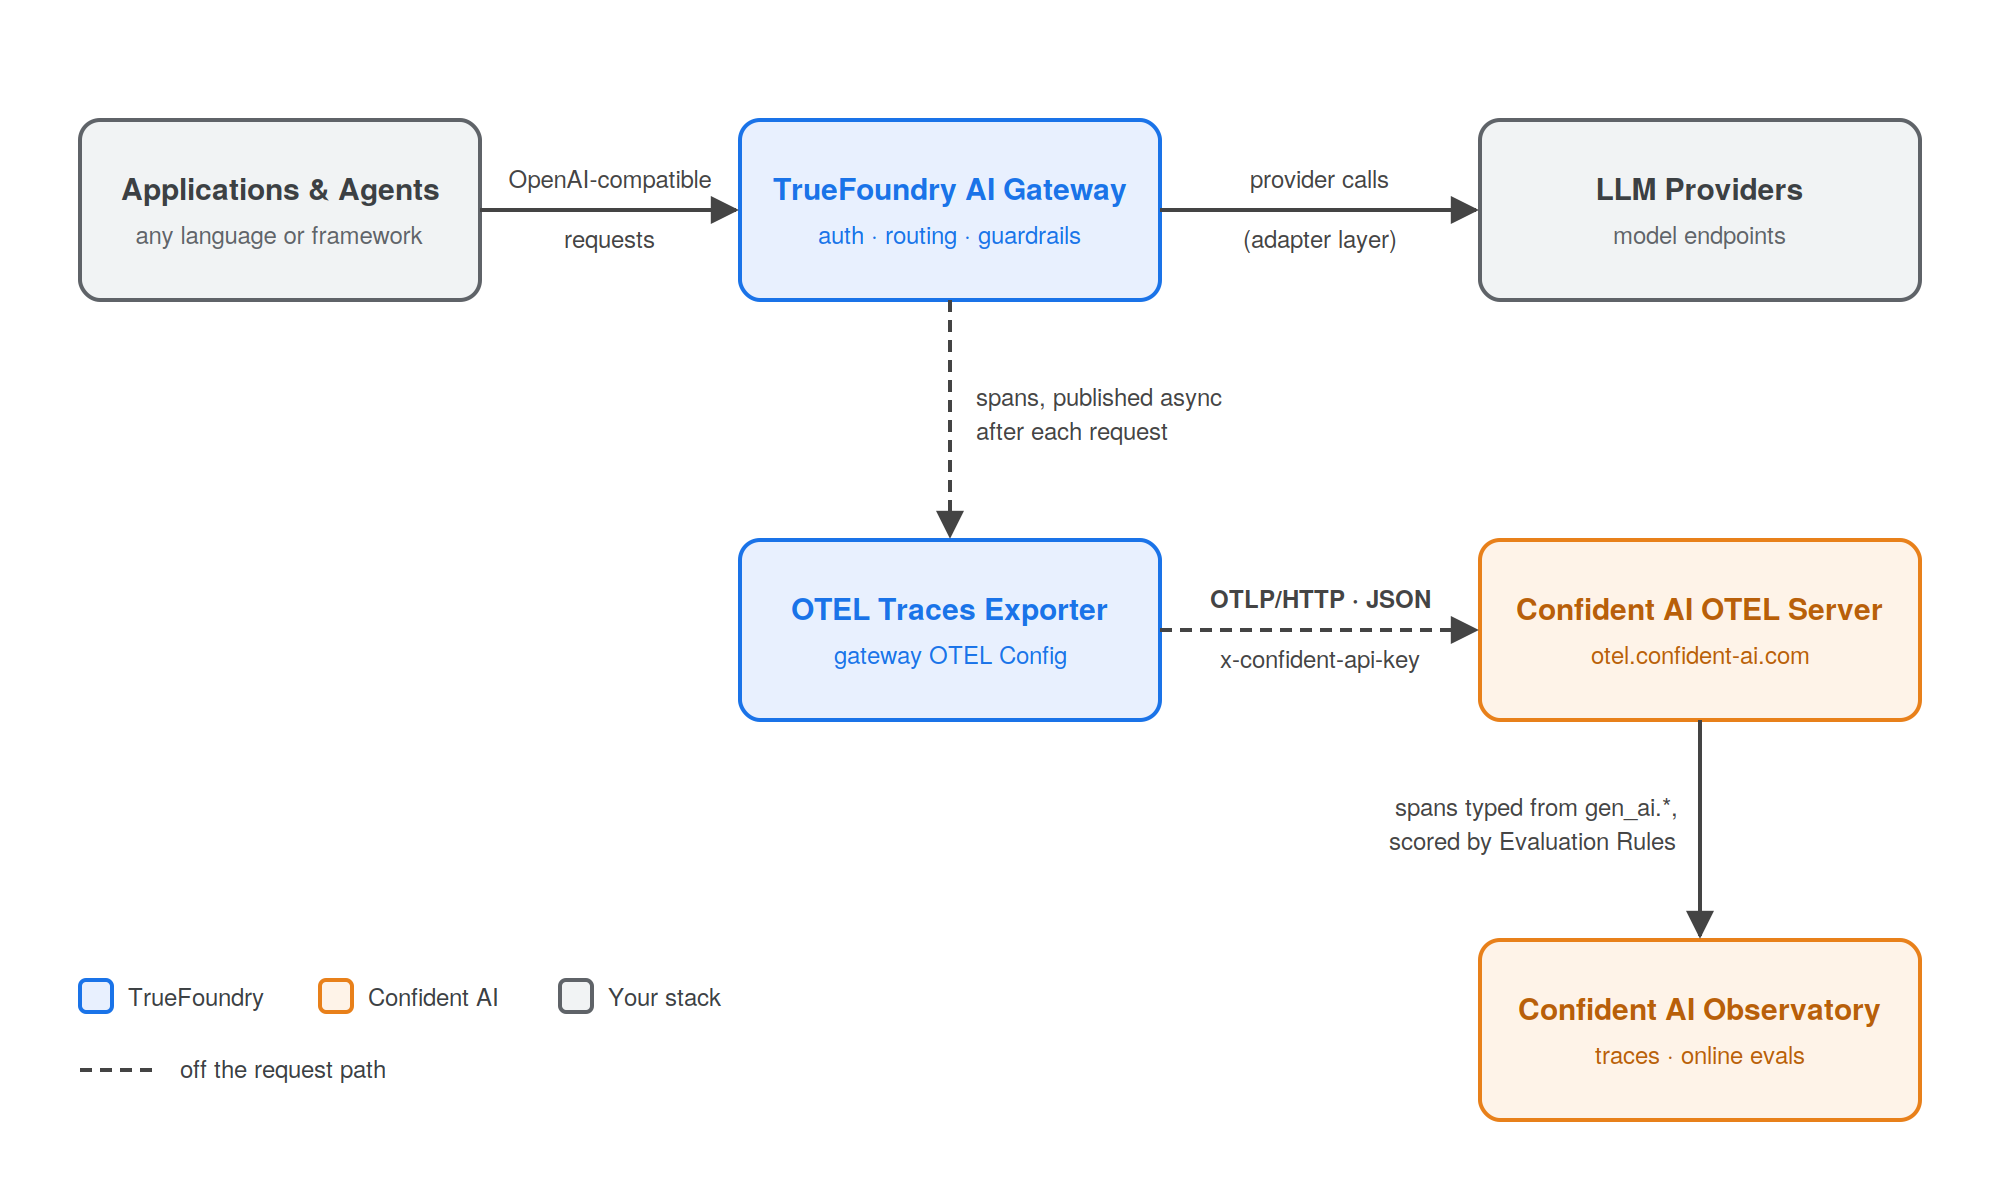
Gateway-traces verlaten het request-pad asynchroon en bereiken de OTEL-server van Confident AI via OTLP/HTTP, waar ze worden getypeerd en gescoord.
De configuratie bevindt zich aan de TrueFoundry-zijde, onder AI Gateway → Controls → Settings → OTEL Config. De exporter gebruikt HTTP met JSON-encoding en authenticeert met de Confident AI-project sleutel, zodat traces terechtkomen in het project dat deze heeft uitgegeven. Confident AI accepteert OTLP uitsluitend via HTTP, wat de reden is waarom de gRPC-optie van de gateway hier niet wordt gebruikt.
De exporter heeft slechts vier instellingen nodig:
Traces endpoint: https://otel.confident-ai.com/v1/traces (EU: https://eu.otel.confident-ai.com/v1/traces)
Protocol: HTTP
Encoding: JSON
Headers: Content-Type: application/json en x-confident-api-key: <project API key>
Één schakelaar vereist een bewuste keuze. Exclude Request Data bepaalt of prompts en completions meesturen met de trace. Wanneer dit uit staat, worden tfy.input en tfy.output geëxporteerd, wat content-gebaseerde metrics iets geeft om te beoordelen. Wanneer dit aan staat, worden die attributen vóór de export verwijderd, wat geschikt is voor gevoelige workloads die wel latency-, token- en statusgegevens in Confident AI willen ontvangen.
De integratie is zo gebouwd dat evaluatie nooit tussen een gebruiker en het antwoord in staat. Een enkele request doorloopt twee afzonderlijke fasen:
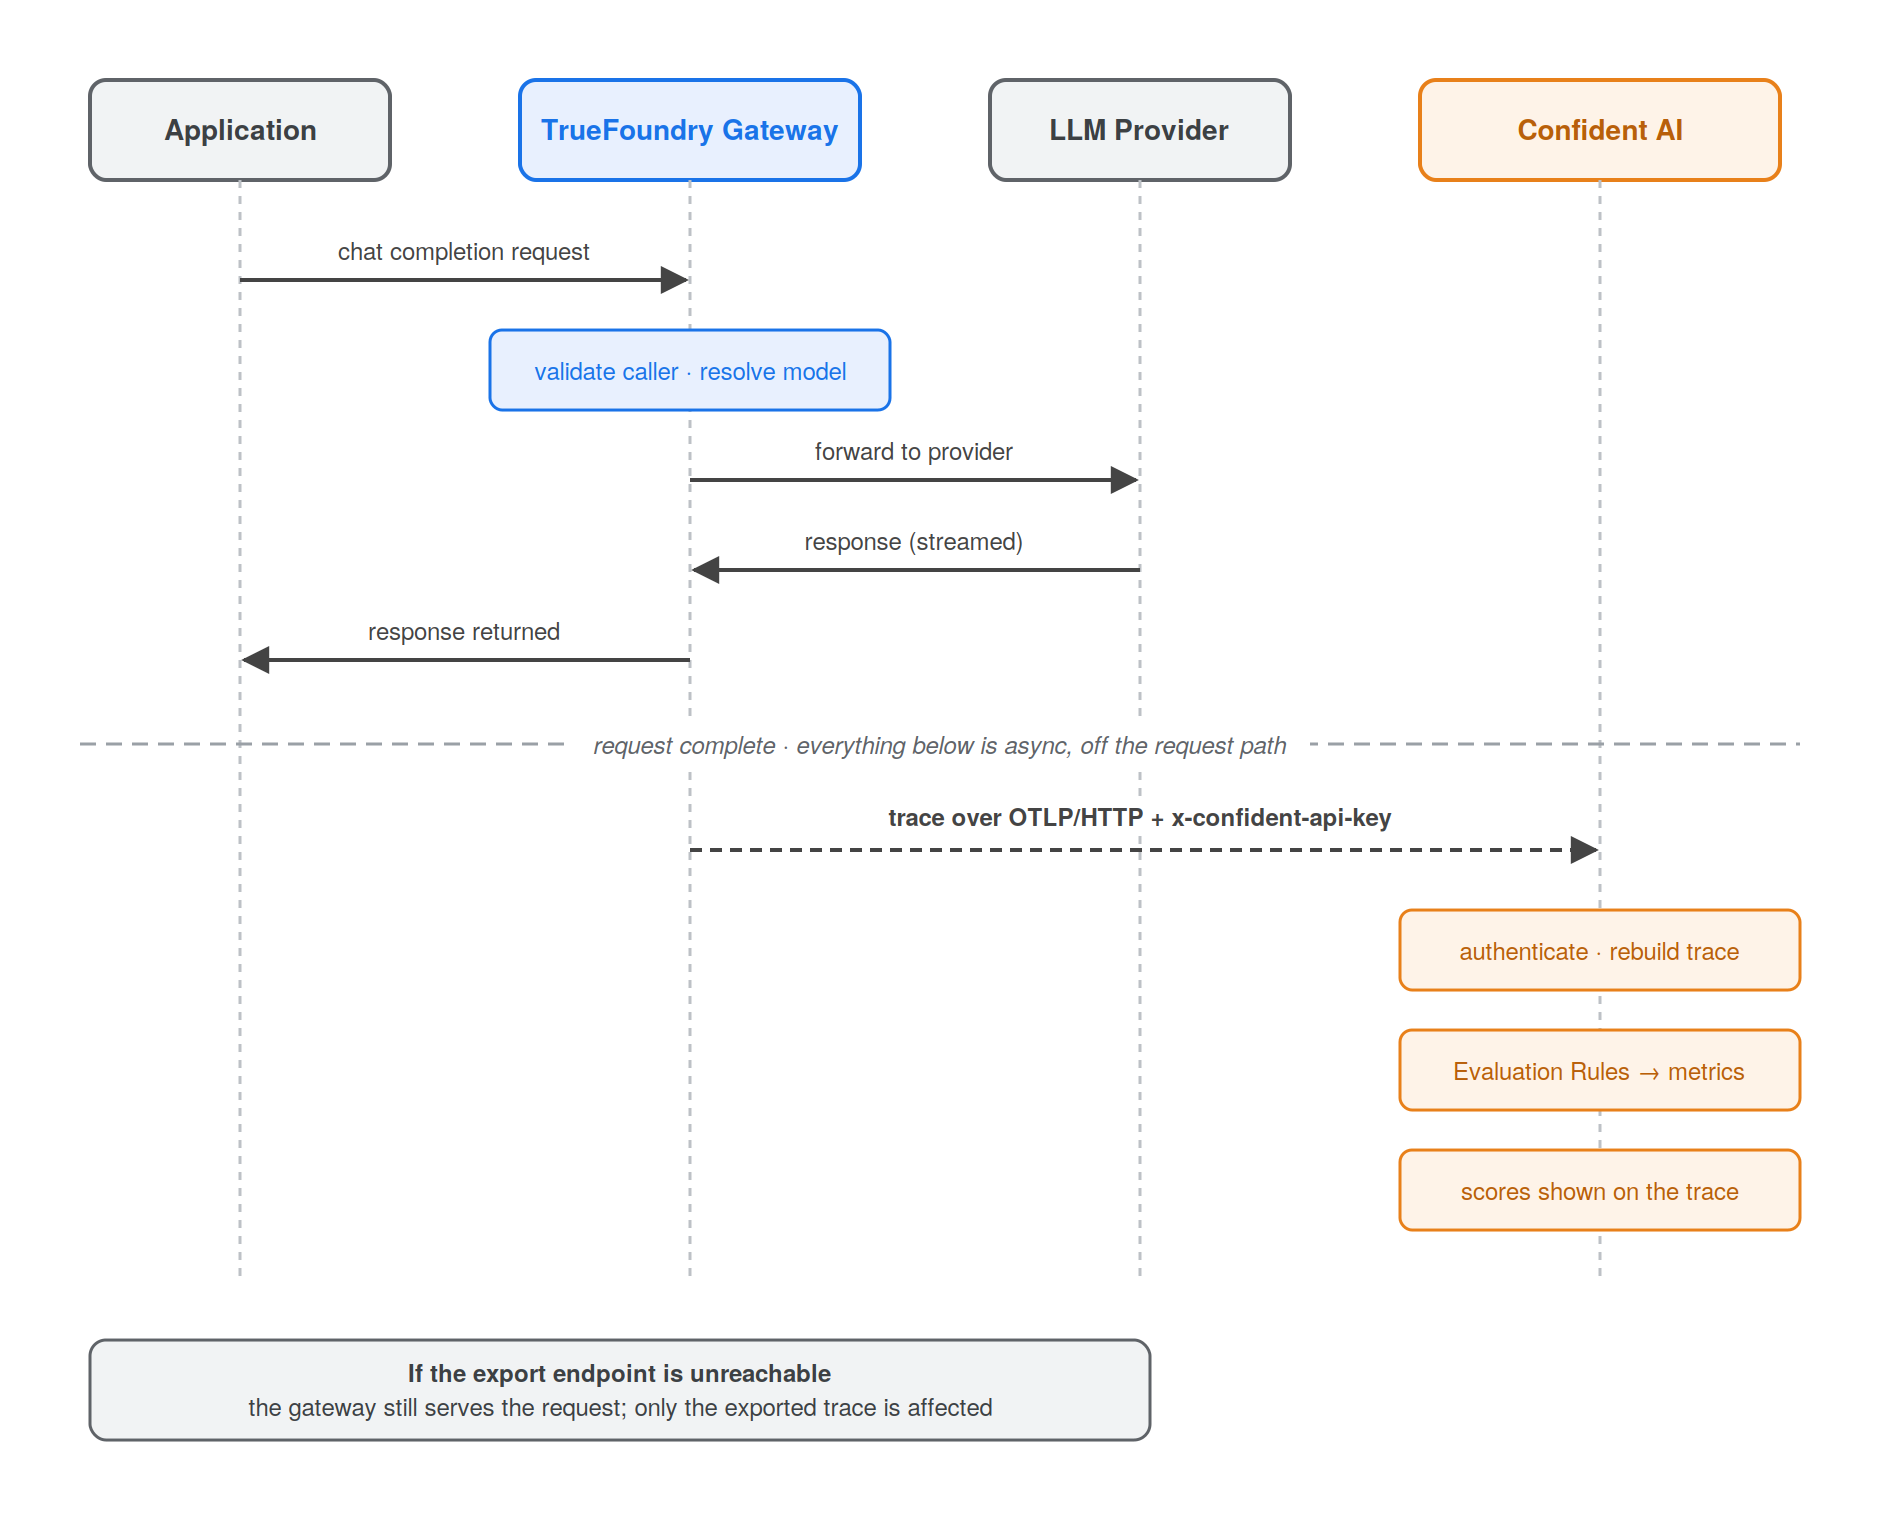
De request is al voltooid voordat de export begint, waardoor evaluatie geen extra latency toevoegt aan de gebruikers-call.
Omdat export buiten het request-pad om gebeurt, faalt de gateway nooit een request wanneer een extern OTEL-endpoint onbereikbaar is. Het ergste geval is een ontbrekende trace, niet een ontbrekend antwoord. En omdat Evaluation Rules geconfigureerd worden in Confident AI in plaats van in de code, kan een team aanpassen welke metrics draaien op gateway-verkeer, of hoeveel er van ge-samplet wordt, zonder ooit iets opnieuw te hoeven deployen.
De instelling vereist enkel een Confident AI-project-API-sleutel en een klein aantal velden in de OTEL Config van de gateway. Zowel US- als EU-endpoints zijn beschikbaar, en self-hosted Confident AI-implementaties bieden hun eigen traces-endpoint. Stuur een paar requests en controleer vervolgens of ze verschijnen in de traces-weergave van Confident AI voordat u Evaluation Rules toevoegt.
De volledige stappen vindt u in de TrueFoundry-integratiegids. De OpenTelemetry-documentatie van Confident AI behandelt de OTEL-server, en hun online evaluatiegids legt metric collections en Evaluation Rules uit. Teams die ook gebruiker-, thread- en zakelijke context willen toevoegen, kunnen de confident-trace SDK van Confident AI in de code opnemen, zoals beschreven op hun TrueFoundry-integratiepagina.
De integratie blijft overzichtelijk omdat uitvoering en evaluatie elkaar ontmoeten op basis van een standaard in plaats van een SDK. De gateway is de plek waar verkeer samenkomt, waardoor het de logische plaats is voor instrumentatie; Confident AI leest de OpenTelemetry GenAI-conventies, waardoor het spans kan typeren en scoren die het zelf nooit heeft geïnstrumenteerd. De twee perspectieven vullen elkaar bovendien aan: gateway-traces leggen vast hoe elke request is opgelost en afgehandeld (iets wat de eigen spans van een applicatie niet kunnen zien), terwijl in-code tracing de gebruiker- en gesprekscontext toevoegt die alleen de applicatie kent. TrueFoundry beheert en routeert de call, Confident AI beoordeelt het antwoord, en OpenTelemetry transporteert het bewijs tussen beide.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox

















