



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
DSPy is een framework van Stanford om LM-systemen te bouwen door ze te programmeren in plaats van te prompten. In plaats van handmatig prompt-strings aan te passen, declareer je de vorm van een taak — een signature zoals question -> answer — en voeg je deze samen in modules (ChainOfThought, ReAct, aangepaste dspy.Module-klassen). Vervolgens stemmen de optimizers van DSPy de daadwerkelijke prompts en few-shot demonstraties af op een door jou gedefinieerde metric, waarbij de prompt als een leeraardige parameter wordt behandeld.
Dit is een effectief ontwerp, maar wel een met een kostenprofiel dat teams vaak onderschatten. Omdat optimalisatie inhoudt dat je programma herhaaldelijk wordt uitgevoerd op een dataset (creatie, evaluatie, selectie), is DSPy in staat om kleine stukjes code om te zetten in duizenden LM-calls. Dit framework voert taken uit die je anders handmatig zou doen, maar verbruikt daarbij wel de nodige tokens.
Dit is precies het soort workload waar een gateway voor bedoeld is.
DSPy stuurt elk LM-verzoek via LiteLLM, wat betekent dat het het OpenAI-compatibele protocol spreekt. Om dat verkeer via de TrueFoundry AI Gateway te leiden, geef je het model de prefix openai/ en richt je api_base op de URL van je gateway.
Dat is de volledige integratie. Elke signature, module en optimizer die je vanaf hier schrijft, roept op de achtergrond de gateway aan — zonder verdere code-aanpassingen. Je kunt dit ook eenmalig instellen via omgevingsvariabelen:
export OPENAI_API_KEY="your-truefoundry-api-key"
export OPENAI_BASE_URL="{GATEWAY_BASE_URL}"
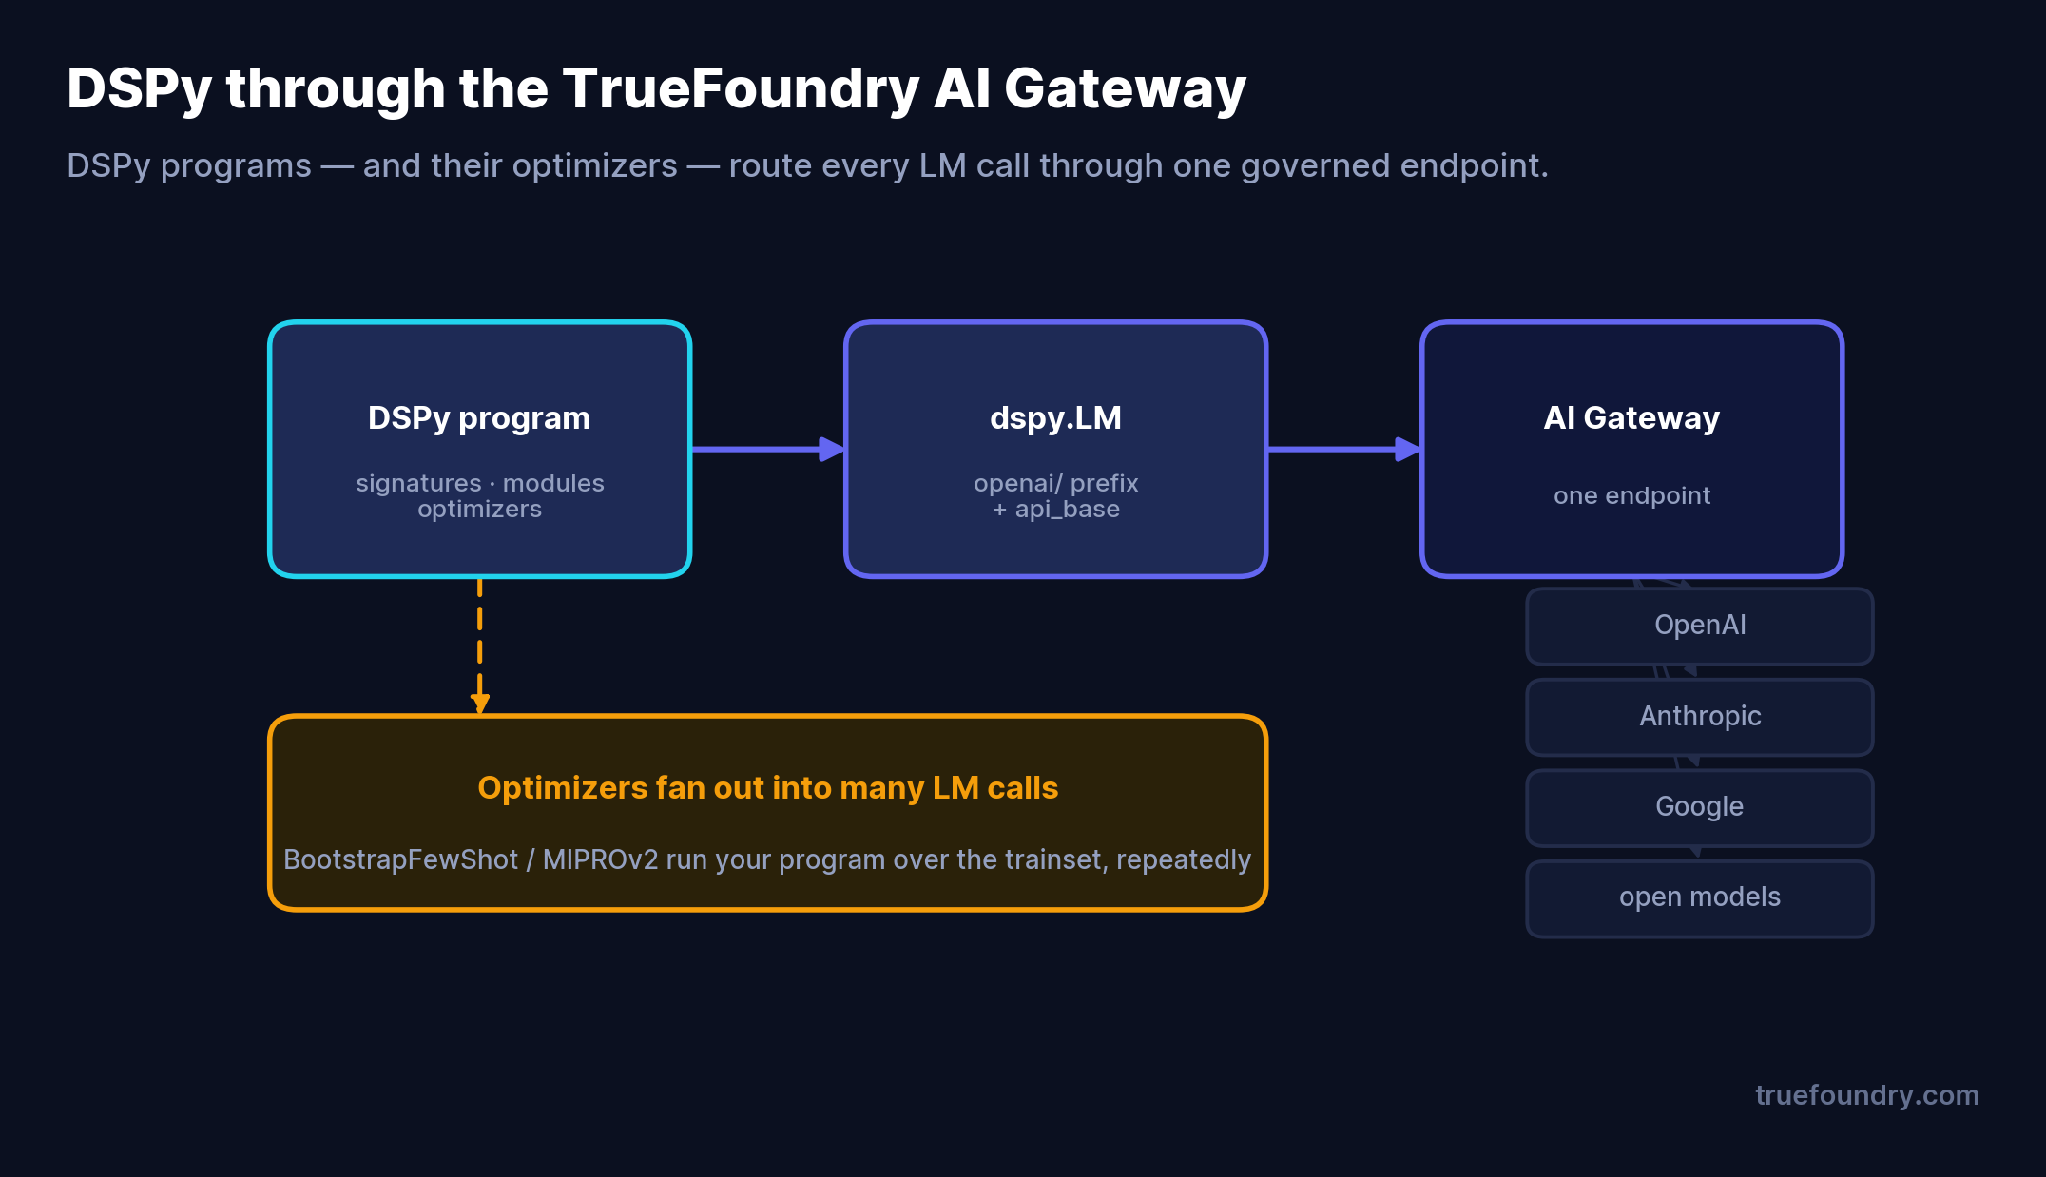
Je DSPy-code communiceert met dspy.LM; dspy.LM communiceert met de gateway; de gateway communiceert met de provider die je hebt opgegeven. Het vervangen van openai/anthropic-account/claude-4 door een OpenAI- of Gemini-model is slechts een aanpassing van een string, omdat de gateway deze allemaal normaliseert.
Hier is het getal dat er toe doet. Een enkele ChainOfThought-voorspelling kost één of twee LM-calls. Een optimizer is van een heel andere orde.
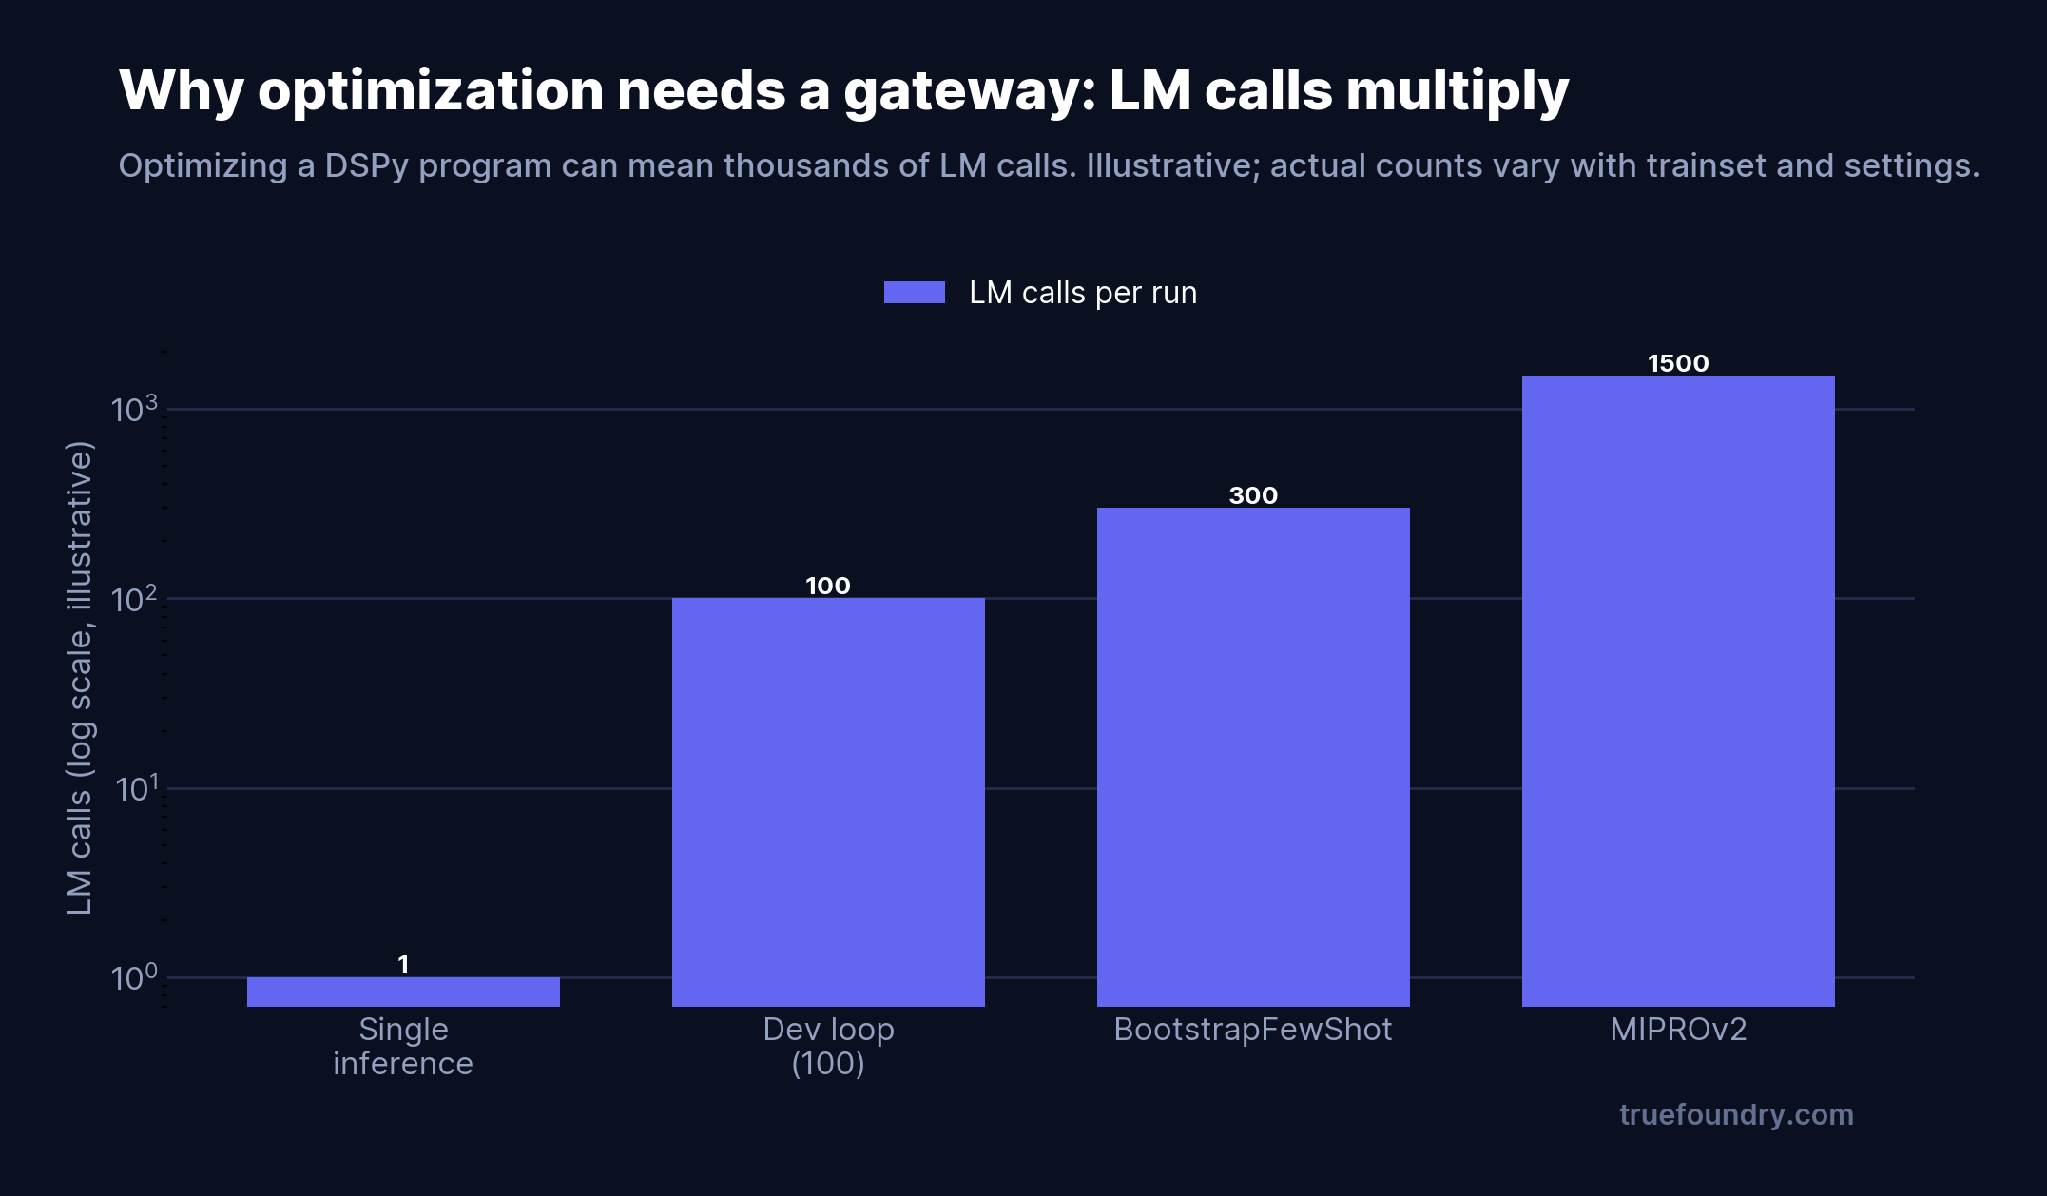
Wanneer je optimizer.compile() aanroept, voert DSPy je programma meerdere keren uit over de trainingsset — demonstraties bootstrappen, kandidaten evalueren en zoeken naar de beste configuratie. Een BootstrapFewShot-run kan honderden calls omvatten; MIPROv2 zelfs duizenden. Voer dat een paar keer uit terwijl je je metric verfijnt en je genereert aanzienlijke, piekerige en moeilijk te voorspellen uitgaven — het soort dat op het slechtste moment een rate limit van een provider overschrijdt en op de factuur verschijnt zonder specificatie van welke test de kosten heeft veroorzaakt.
Als je het model rechtstreeks aanroept, heb je hier geen enkele controle over. Via de gateway wel:
Ze optimaliseren met een directe provider-sleutel. De eerste grote compile() overschrijdt een rate limit of veroorzaakt een onverwachte rekening zonder duidelijke bron. Leid het verkeer via een gateway voordat je de optimalisatie opschaalt.
Ze vergeten caching tijdens het itereren. Het opnieuw uitvoeren van een optimalisatie tijdens het verfijnen van een metric leidt tot veel identieke calls. Zonder cache betaal je voor elke afzonderlijke call.
Ze hardcoden de provider. De kracht van DSPy ligt in het vergelijken van configuraties — maar als het model in elke module is ingebouwd, vereist het vergelijken van providers code-aanpassingen. De prefix openai/ gecombineerd met een gateway maakt hiervan een eenvoudige string.
Ze scheiden dev- en prod-uitgaven niet. Optimalisatieruns zijn experimenten; inference is productie. Zonder kostentoewijzing per run lopen deze over in één onverklaarbare post op de factuur.
Twee stappen. Installeer DSPy (pip install -U dspy), en haal vervolgens je gateway base URL en modelnaam op uit het uniforme codefragment in de TrueFoundry playground.
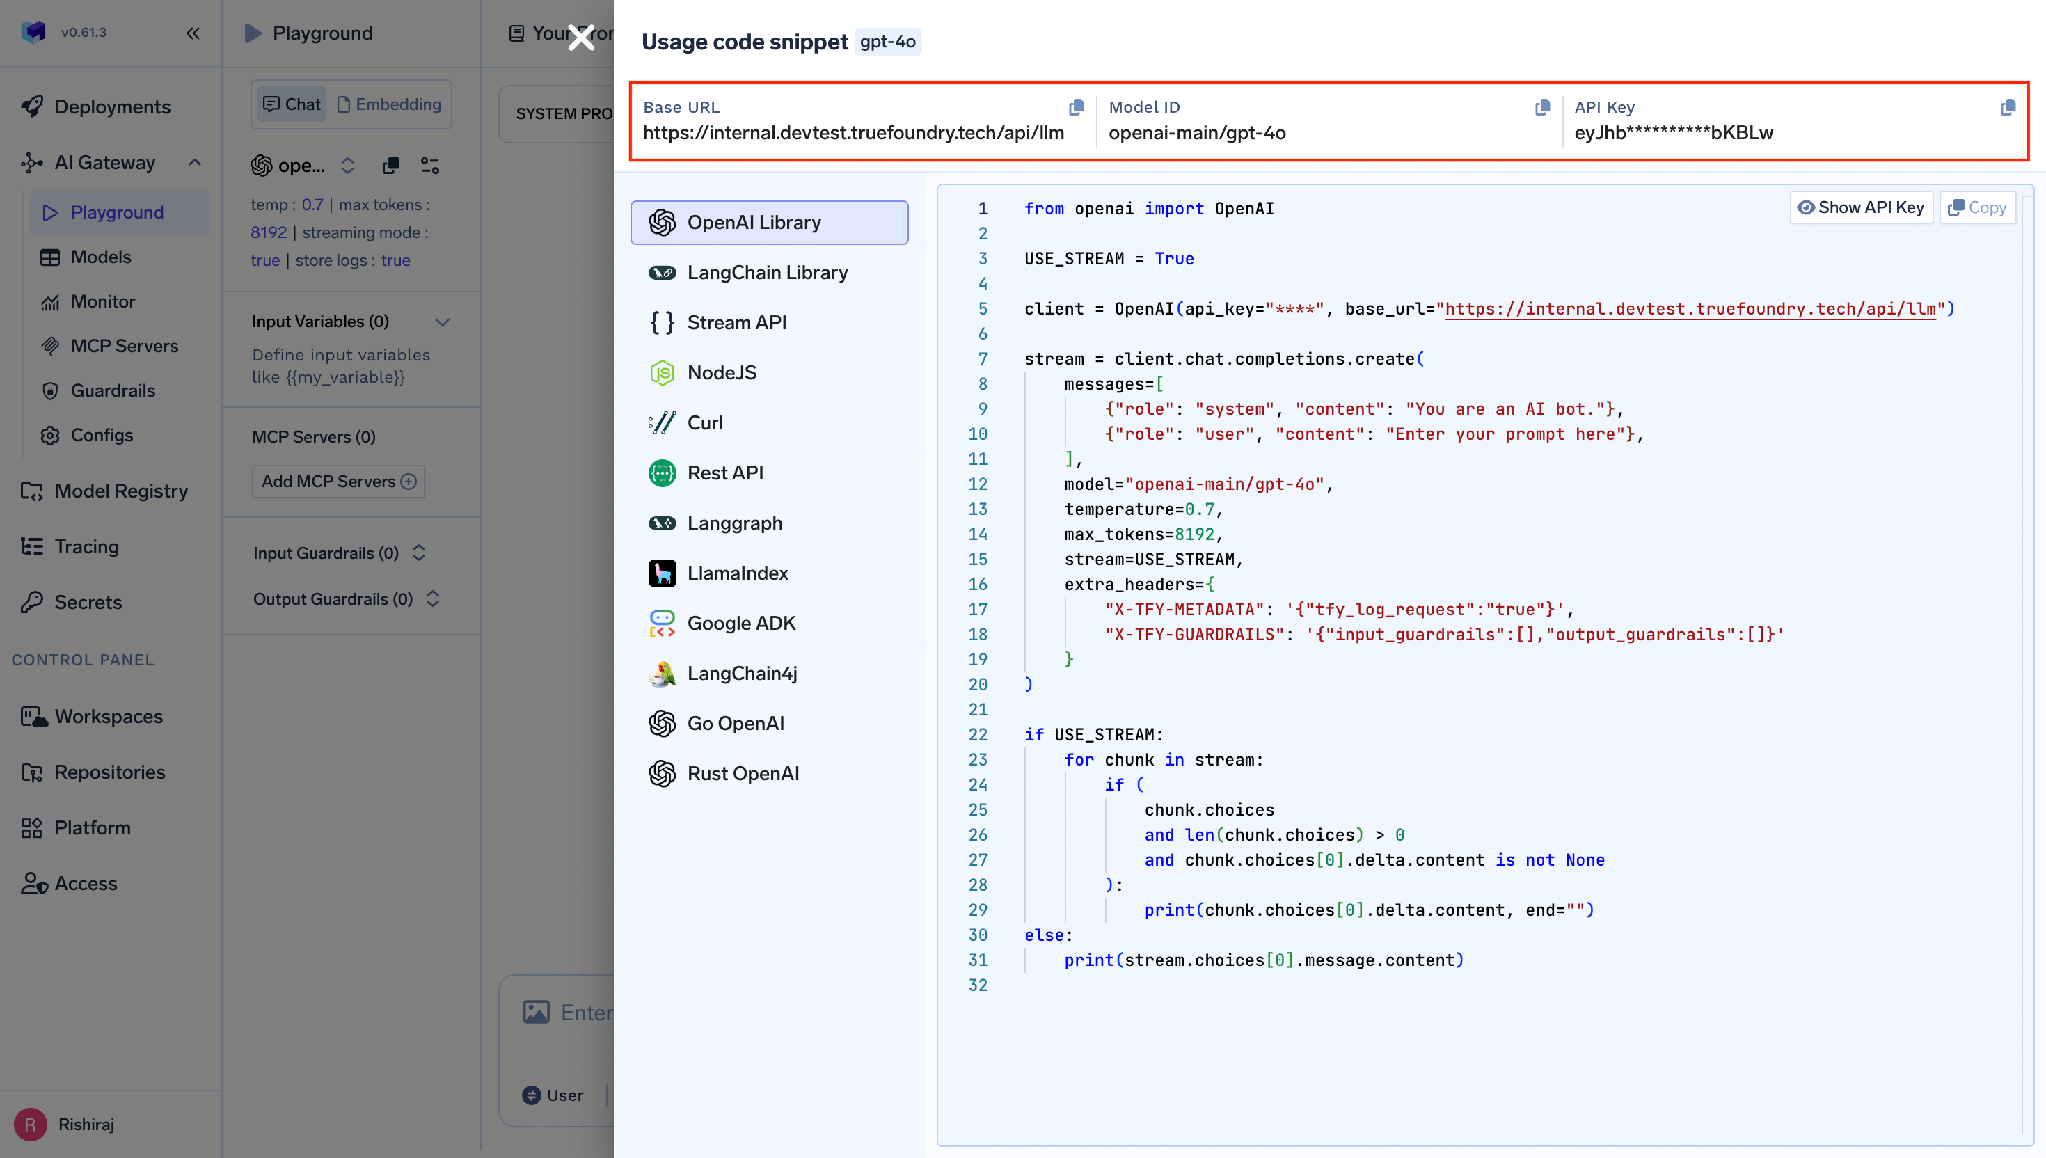
Configureer de LM zoals hierboven weergegeven en schrijf vervolgens normale DSPy-code. Een signature en module:
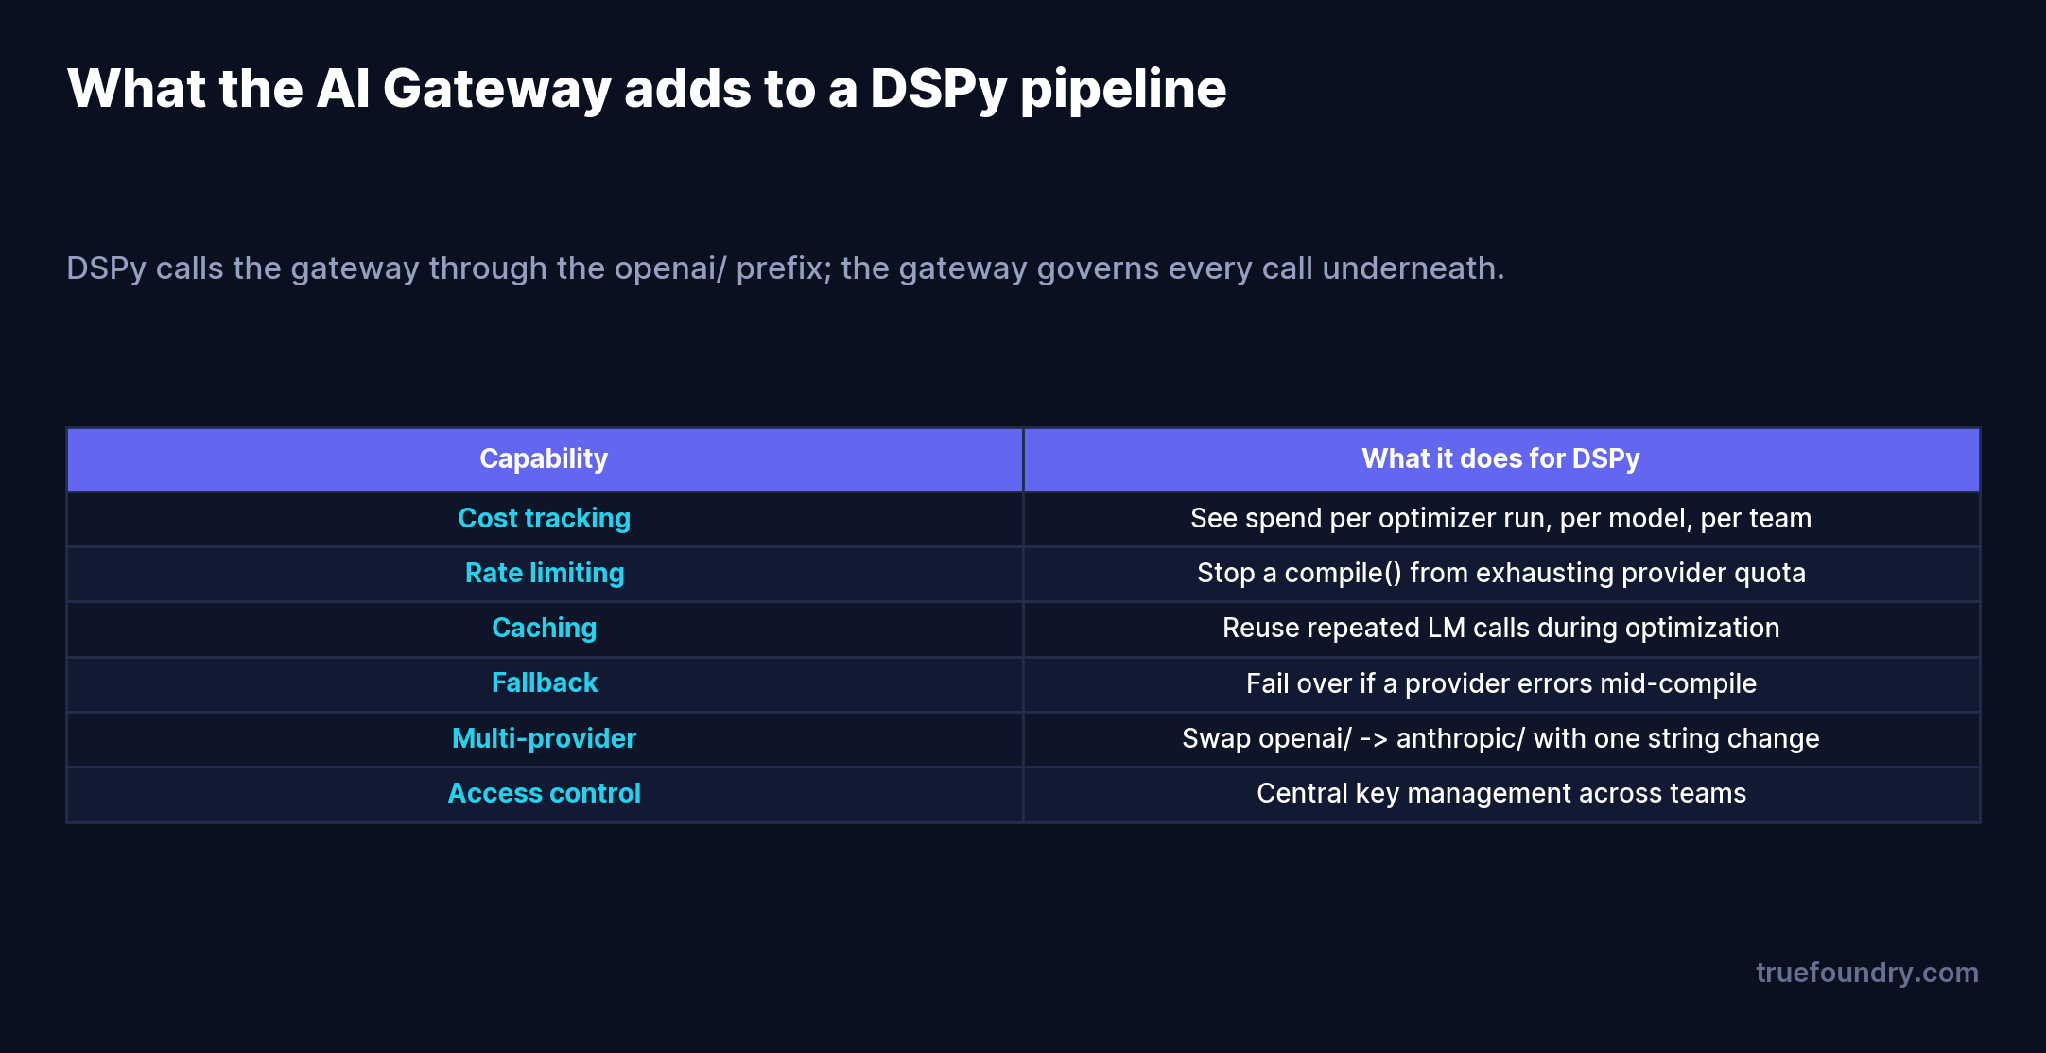
Elke call die compile() maakt, wordt nu gemonitord, rate-limited, gecached en beschermd door de fallback van de gateway — zonder enige aanpassing aan de DSPy-code zelf.
Een team verfijnt een RAG-module. Elke MIPROv2-run maakt ongeveer 1.500 LM-calls, met een gemiddelde van 3.000 input- en 400 output-tokens per call. Ze plannen 20 runs tijdens het itereren op de metric.
Bij een mid-tier model (bijvoorbeeld Claude Sonnet 5.5 tegen $2 / $10 per miljoen tokens) kost één run ongeveer (1.500 × 3.000 × $2 + 1.500 × 400 × $10) / 1e6 ≈ $15 aan input en output — oftewel $15 per run, of $300 voor 20 runs. Voer dezelfde optimalisatie uit op een goedkoper model voor de bootstrapping-fase en de kosten dalen scherp — maar dat weet je alleen, en kun je alleen bewijzen qua kwaliteit, doordat de gateway de kosten per run en per model heeft bijgehouden.
Zonder die specificatie is die $300 een enkele onverklaarbare post. Met specificatie wordt optimalisatie een gebudgetteerd, meetbaar onderdeel van de ontwikkeling — en is de beslissing om opnieuw te optimaliseren op een goedkoper model gebaseerd op data in plaats van onderbuikgevoel.
DSPy verandert de manier waarop je met LLM's bouwt — prompts worden parameters en een compiler verzorgt de afstemming. De verborgen prijs van die elegantie is het verkeer: optimizers maken veel meer LM-calls dan de code doet vermoeden, en die uitgaven zijn piekerig, onvoorspelbaar en gemakkelijk uit het oog te verliezen.
DSPy richten op de TrueFoundry AI Gateway is een aanpassing van twee regels die het gehele proces omzet in een beheerd en meetbaar traject — kosten per optimalisatierun, rate limits die je quota beschermen, caching die herhaalde calls vermindert, en fallback die een lange compilatie actief houdt. Je behoudt het programmeermodel van DSPy en krijgt de operationele controle die nodig is voor productie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



DSPy is a framework for building LM systems by programming them instead of hand-writing prompts. You define signatures and modules, then use optimizers to tune the prompts and few-shot examples against a metric.
Use the openai/ prefix in the model name and set api_base to your gateway URL in dspy.LM(...), then dspy.configure(lm=lm). DSPy routes through LiteLLM, so any OpenAI-compatible gateway works.
Because optimization generates large, bursty LM traffic. The gateway adds cost tracking, rate limiting, caching, and fallback across every call, and lets you switch models with a one-string change.
Nee. Alleen de LM-configuratie verandert. Uw signatures, modules en optimizers blijven ongewijzigd.
It depends on the optimizer, trainset size, and model. A MIPROv2 run can be thousands of LM calls. The gateway meters each run so you can see and budget the exact cost per sweep, per model, and per team.
Yes. TrueFoundry’s data plane runs in your VPC or on-prem, so DSPy’s prompts and optimization data stay in your environment.



Het laatste nieuws, artikelen en bronnen in je inbox



















