



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Prompt caching is de krachtigste hefboom voor kostenbesparing op Claude, maar ook de functie die teams het vaakst subtiel verkeerd toepassen — waarbij ze de write-premie betalen op elk verzoek en nooit profiteren van de read-korting. Het is geen functie die je zomaar aanzet; het is een prijsafweging die je correct moet instellen. Het goede nieuws is dat deze afweging wordt bepaald door twee getallen, en zodra je die kent, is de beslissing puur rekenwerk.
Dit artikel behandelt dat rekenwerk: wat een cache write en een cache read daadwerkelijk kosten vergeleken met een normale token, waar het break-evenpunt ligt, wanneer het niet rendeert, en hoe je het zo instelt dat de besparingen worden gemeten in plaats van aangenomen. Alle onderstaande vermenigvuldigingsfactoren zijn afkomstig uit Anthropic’s prompt caching documentatie, vanaf oktober 2026.
Caching hergebruikt een eerder verwerkte prompt-prefix, zodat Claude deze niet opnieuw hoeft te lezen. Je betaalt een premie om een prefix in de cache te schrijven, en krijgt vervolgens een fikse korting om deze bij latere verzoeken te lezen.
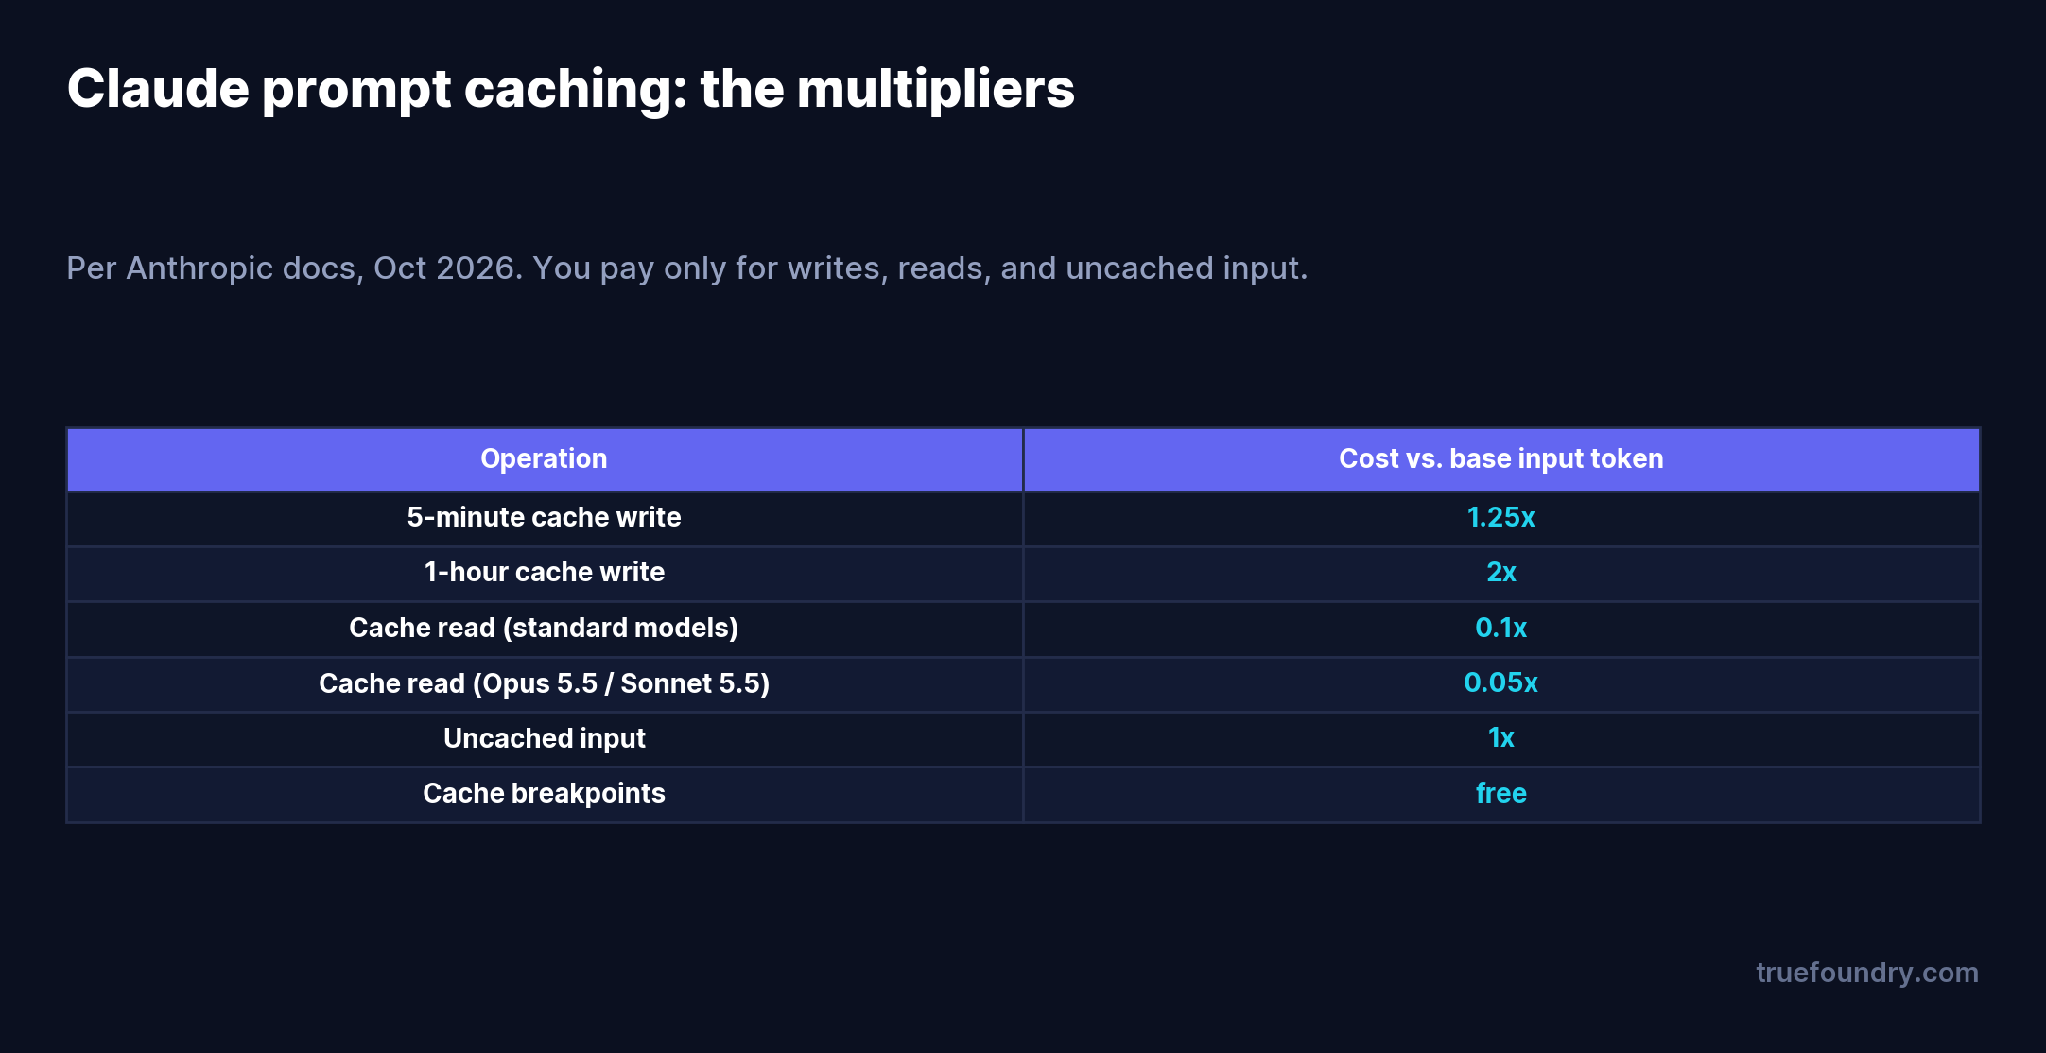
Een cache write van 5 minuten kost 1.25x van een normale input token. De write van 1 uur kost 2x. Een cache read kost 0.1x op standaardmodellen, en slechts 0.05x op Opus 5.5 en Sonnet 5.5 (0.025x op Fable 5.1 en Mythos 5.1). Cache breakpoints zelf zijn gratis — je betaalt alleen voor writes, reads en gewone ongecachete input. Concreet kost op Opus 5.5 (basis input $4 per miljoen tokens) een write van 5 minuten $5, een write van 1 uur $8, en een cache hit $0.20 per miljoen.
Hier is de volledige kostensituatie. Stel dat een statische prefix normaal 1 eenheid aan input zou kosten. Zonder caching kosten N verzoeken die allemaal die prefix bevatten N eenheden. Met 5-minuten caching schrijft het eerste verzoek de prefix (1.25 eenheden) en leest elk van de volgende N-1 verzoeken deze (elk 0.1 eenheden), wat neerkomt op 1.25 + 0.1(N-1) eenheden.
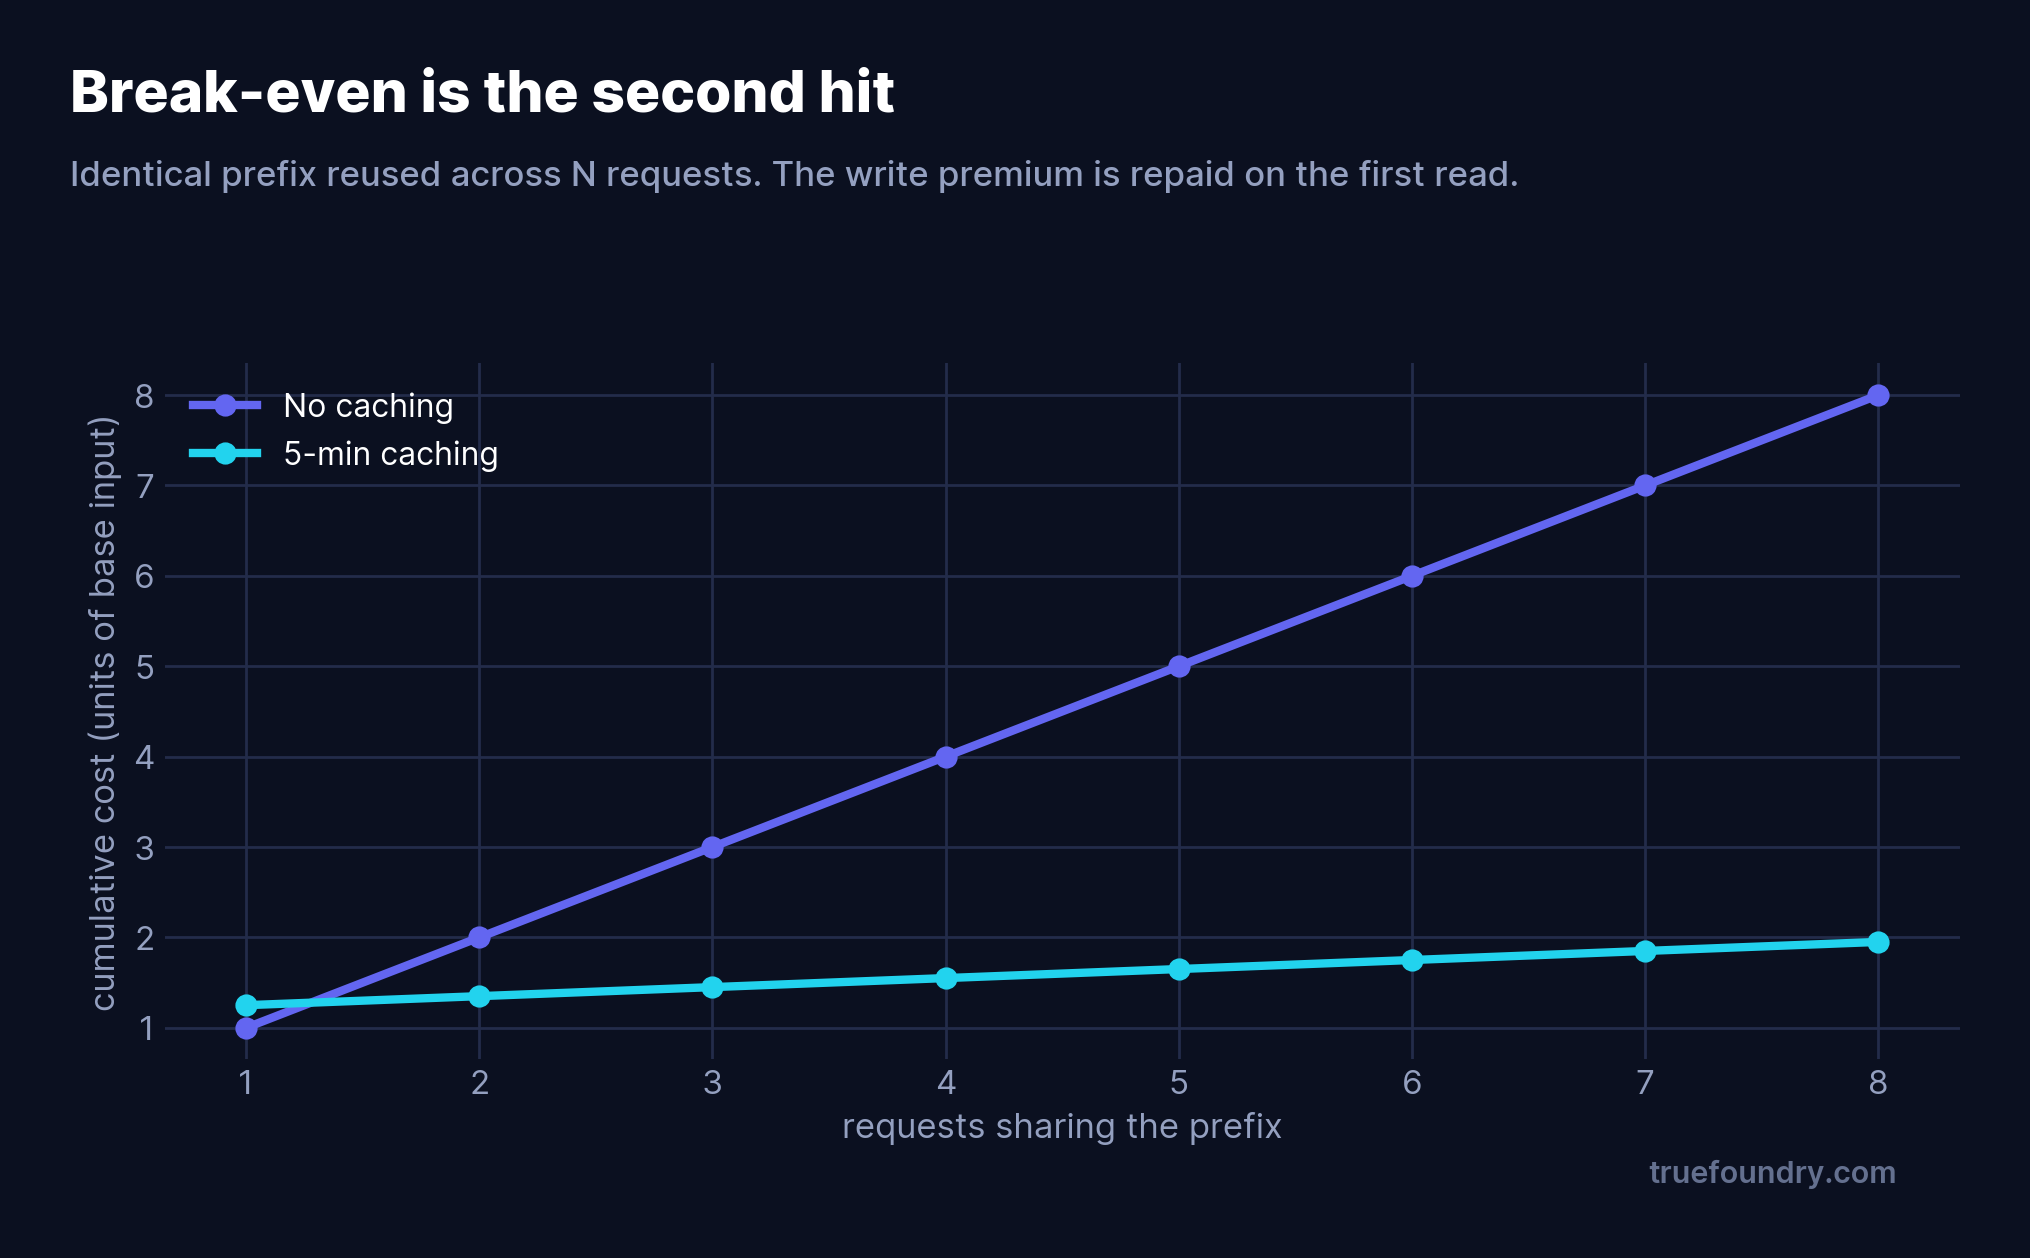
Als je deze aan elkaar gelijkstelt, kruisen de lijnen elkaar nog voordat het tweede verzoek is afgerond: de write-premie van 0.25 eenheden wordt al terugverdiend de eerste keer dat je de prefix leest, omdat die read 0.9 eenheden bespaart. De regel is dus simpel — als een gecachete prefix zelfs maar één keer wordt hergebruikt binnen de TTL, levert caching winst op, en het voordeel groeit snel bij elke extra hit. Een lange system prompt of RAG-context die honderden keren per uur wordt aangeroepen, is waar de korting van 90% zich opstapelt tot een aanzienlijke kostenverlaging.
Waar het niet rendeert: een prefix die precies één keer wordt gebruikt, verkeer dat zo schaars is dat items verlopen tussen verzoeken (gebruik in dat geval de 1-uur TTL), of een "prefix" die daadwerkelijk bij elke call verandert — wat ons bij de fouten brengt.
Het mislukkingspatroon heeft altijd dezelfde vorm: je schrijft de cache bij elk verzoek en leest deze bij geen enkel verzoek. Dit gebeurt omdat het breakpoint op een blok staat dat verandert.
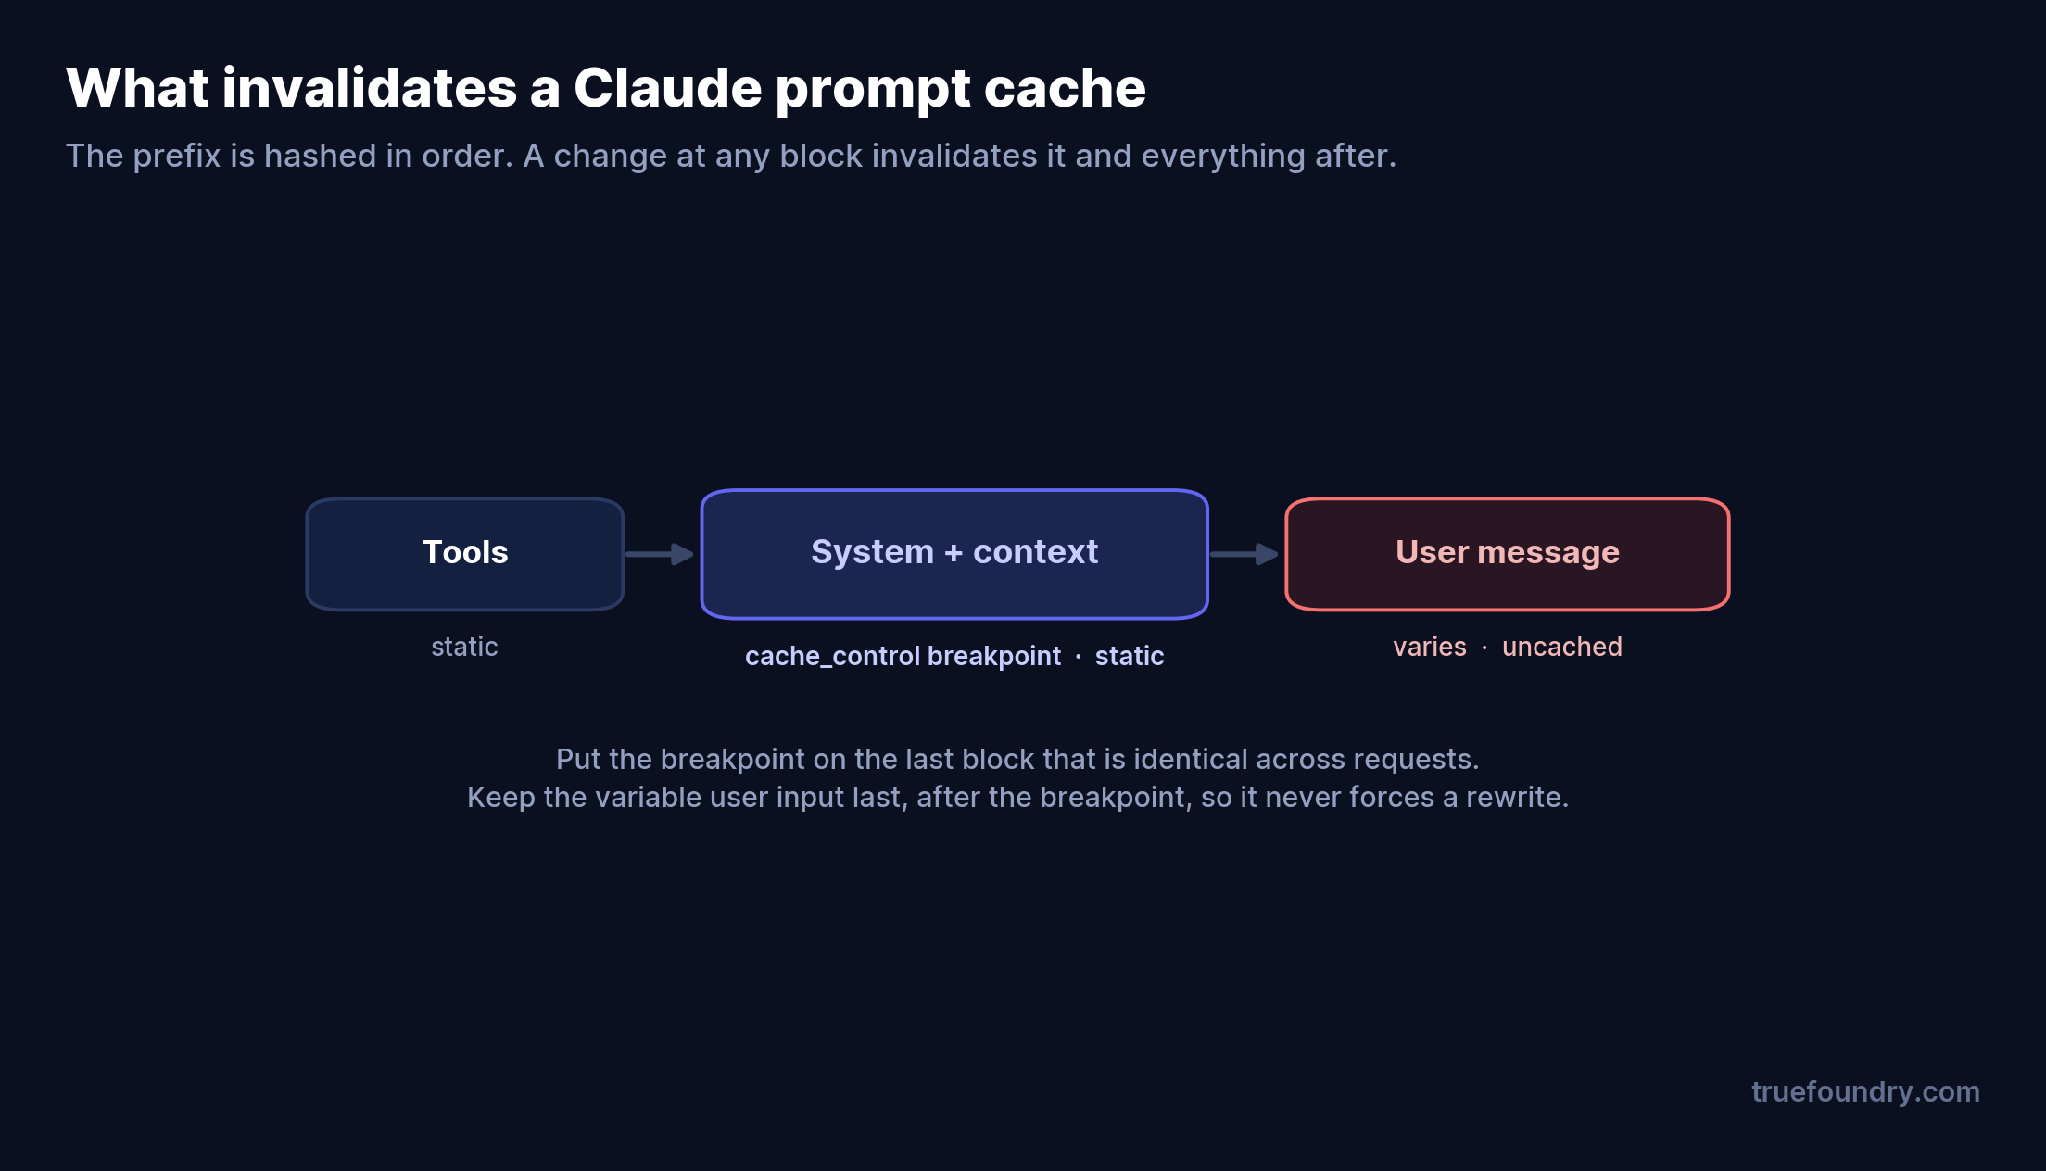
Een cache hit vereist een 100% identieke prefix tot en met het blok dat is gemarkeerd met cache_control — alle tekst en afbeeldingen, byte voor byte. Caching dekt de prefix in een vaste volgorde: tools, dan system, dan messages. Een wijziging op één niveau maakt dat niveau en alles daarna ongeldig: pas een tool-definitie aan en alle drie de niveaus missen; verander de system prompt en system plus messages missen; voeg een afbeelding toe of verwijder deze en de message-cache mist. Als je het breakpoint dus op het inkomende gebruikersbericht plaatst — dat elke keer anders is — genereer je bij elk verzoek een gloednieuwe hash, betaal je elke keer de 1.25x write en krijg je nooit de 0.1x read.
De oplossing is om het breakpoint op het laatste blok te plaatsen dat stabiel is over verzoeken heen, en alles wat variabel is erachter te houden:
Andere nuttige regels om te weten: caching treedt alleen in werking boven een token-minimum (512 tokens voor Opus 5.5, Sonnet 5.5, Haiku 5.5 en Fable 5.1; 1.024 of meer voor oudere modellen), kortere prompts worden stilzwijgend ongecachet verwerkt, je krijgt maximaal 4 breakpoints per verzoek, en de lookback zoekt slechts 20 blokken terug vanaf elk breakpoint. Controleer of het daadwerkelijk werkt door de usage-velden te lezen — totale input is cache_read_input_tokens + cache_creation_input_tokens + input_tokens, en als de eerste twee 0 zijn, is er niets gecachet.
Caching op de Anthropic API geldt per organisatie en is specifiek voor Claude. De meeste teams gebruiken echter niet alleen Claude — en prompt caching bestaat ook bij andere providers, met andere mechanismen. Het routen van Claude via de TrueFoundry AI Gateway geeft je één plek om caching toe te passen en te observeren: de eigen caching van de gateway voegt exacte en semantische caching toe bovenop de provider caching, en elke call wordt gemeten.
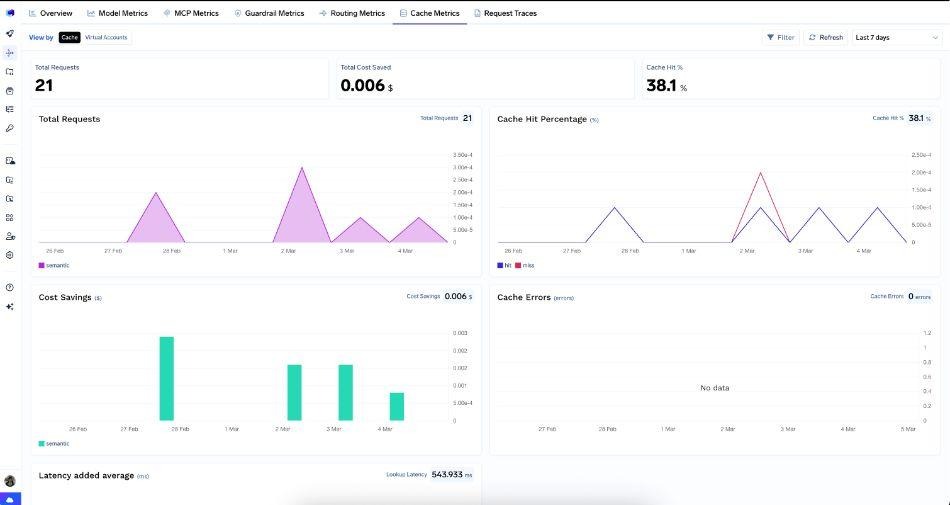
Die meting is waar het om draait. Prompt caching is een gok dat je prefix zal worden hergebruikt; de enige manier om te weten of die gok uitbetaalt, is door de hit rate en de bespaarde dollars te monitoren. Met die gegevens zichtbaar per model en per route, kun je breakpoints en TTL's afstemmen op echt verkeer in plaats van te hopen op een goed resultaat.
Ze plaatsen een breakpoint op het variabele blok. Een tijdstempel of het gebruikersbericht in de gecachete prefix betekent een write bij elke call en nooit een read. Cache de stabiele prefix; houd het variabele deel als laatste.
Ze vergeten de TTL. Het venster van 5 minuten ververst gratis bij elke read, maar bij schaars verkeer verloopt het. Als verzoeken meer dan 5 minuten uit elkaar binnenkomen, maar binnen een uur, gebruik dan de 1-uur TTL ({"type": "ephemeral", "ttl": "1h"}), zelfs tegen de 2x write.
Ze cachen onder het minimum. Onder de 512 tokens (op huidige modellen) wordt er niets gecachet en wordt er geen foutmelding gegenereerd. Controleer de usage-velden.
Ze nemen aan dat het helpt bij een eenmalige call. Eén verzoek, één gebruik — je betaalt de 1.25x premie voor niets. Caching is bedoeld voor prefixes die vele malen worden hergebruikt.
Een support-assistent stuurt bij elk ticket op Opus 5.5 een system prompt van 10.000 tokens (productdocumentatie plus instructies) mee. Ongecachet kosten die 10.000 tokens het volledige input-tarief voor alle 2.000 dagelijkse tickets. Gecachet schrijft het eerste ticket van elk 5-minutenvenster de prefix tegen 1.25x en leest elk volgend ticket deze tegen 0.05x — een reductie van ~95% op het grootste tokenblok in het verzoek. Het variabele deel (de tekst van het ticket) blijft na het breakpoint staan en wordt normaal gefactureerd. Er verandert niets aan de applicatie, behalve de positie van de cache_control-markering; de besparingen worden zichtbaar als een dalende input-kostenlijn in de metrieken van de gateway.
Prompt caching is niet ingewikkeld, maar het is onvergetelijk streng: dezelfde functie die je grootste tokenblok met 90% verlaagt, voegt stilzwijgend een premie van 25% toe aan elk verzoek als het breakpoint op de verkeerde plek staat. De twee getallen — 1.25x voor schrijven, 0.1x (of 0.05x) voor lezen — vertellen je precies wanneer het loont, en het antwoord is "bijna altijd, mits de prefix wordt hergebruikt en het breakpoint stabiel is."
Stel het in op de statische prefix, houd de variabele invoer als laatste, kies de TTL die past bij de onderbrekingen in je verkeer, en monitor de hit rate zodat de beslissing meetbaar blijft. Doe dat via een gateway en de besparingen zijn per verzoek zichtbaar, over elk model dat je draait.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



A 5-minute cache write costs 1.25x a normal input token, a 1-hour write 2x, and a cache read 0.1x — or 0.05x on Opus 5.5 and Sonnet 5.5. Breakpoints are free; you pay only for writes, reads, and uncached input.
As soon as a cached prefix is reused once within its TTL. The write adds a 25% premium on the first request, and the first read saves ~90%, so from the second hit you are ahead. It does not help a prefix used only once.
512 tokens on Opus 5.5, Sonnet 5.5, Haiku 5.5, and Fable 5.1; 1,024 or more on older models. Below the minimum the prompt is processed without caching and no error is returned.
Almost always because the breakpoint sits on a block that changes every request. A hit needs a 100% identical prefix; put the breakpoint on the stable system or context block and keep the variable user input after it.
Provider caches are provider-specific, but routing through the TrueFoundry AI Gateway lets you add exact and semantic caching uniformly and see hit rate and savings per model in one place.



Het laatste nieuws, artikelen en bronnen in je inbox



















