



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Haiku is het instapmodel van Anthropic — het type model dat wordt ingezet voor zware, tijdsgevoelige taken. Classificatie, extractie, routing, korte herschrijfopdrachten, formatting voor tool-calls en eerste concepten: werk waarbij een snel en goedkoop antwoord dat goed genoeg is, wint van een iets beter antwoord dat 20× meer kost en langer duurt.
Haiku 5.5 werd uitgebracht op 7 oktober 2026. Het belangrijkste nieuws is de prijsverlaging: Anthropic heeft het tarief per token met maximaal 90% verlaagd ten opzichte van Haiku 4.5, met behoud van de functionaliteiten op topniveau — een contextvenster van 1 miljoen tokens, 128K maximale output, prompt caching en de Batch API. Voor het eerst is de voordelige variant geen gestripte uitvoering.
Achter deze prijsverlaging schuilt echter meer. Er zit een staffeling in de tarievenkaart die uw rekening ongemerkt kan laten stijgen. De tokenkosten geven op zichzelf weinig inzicht in wat een specifieke taak daadwerkelijk kost. Deze review belicht beide aspecten.
Hier is de volledige tarievenkaart vergeleken met Haiku 4.5 en Sonnet 5.5, zodat de verschillen in beide richtingen helder zijn.
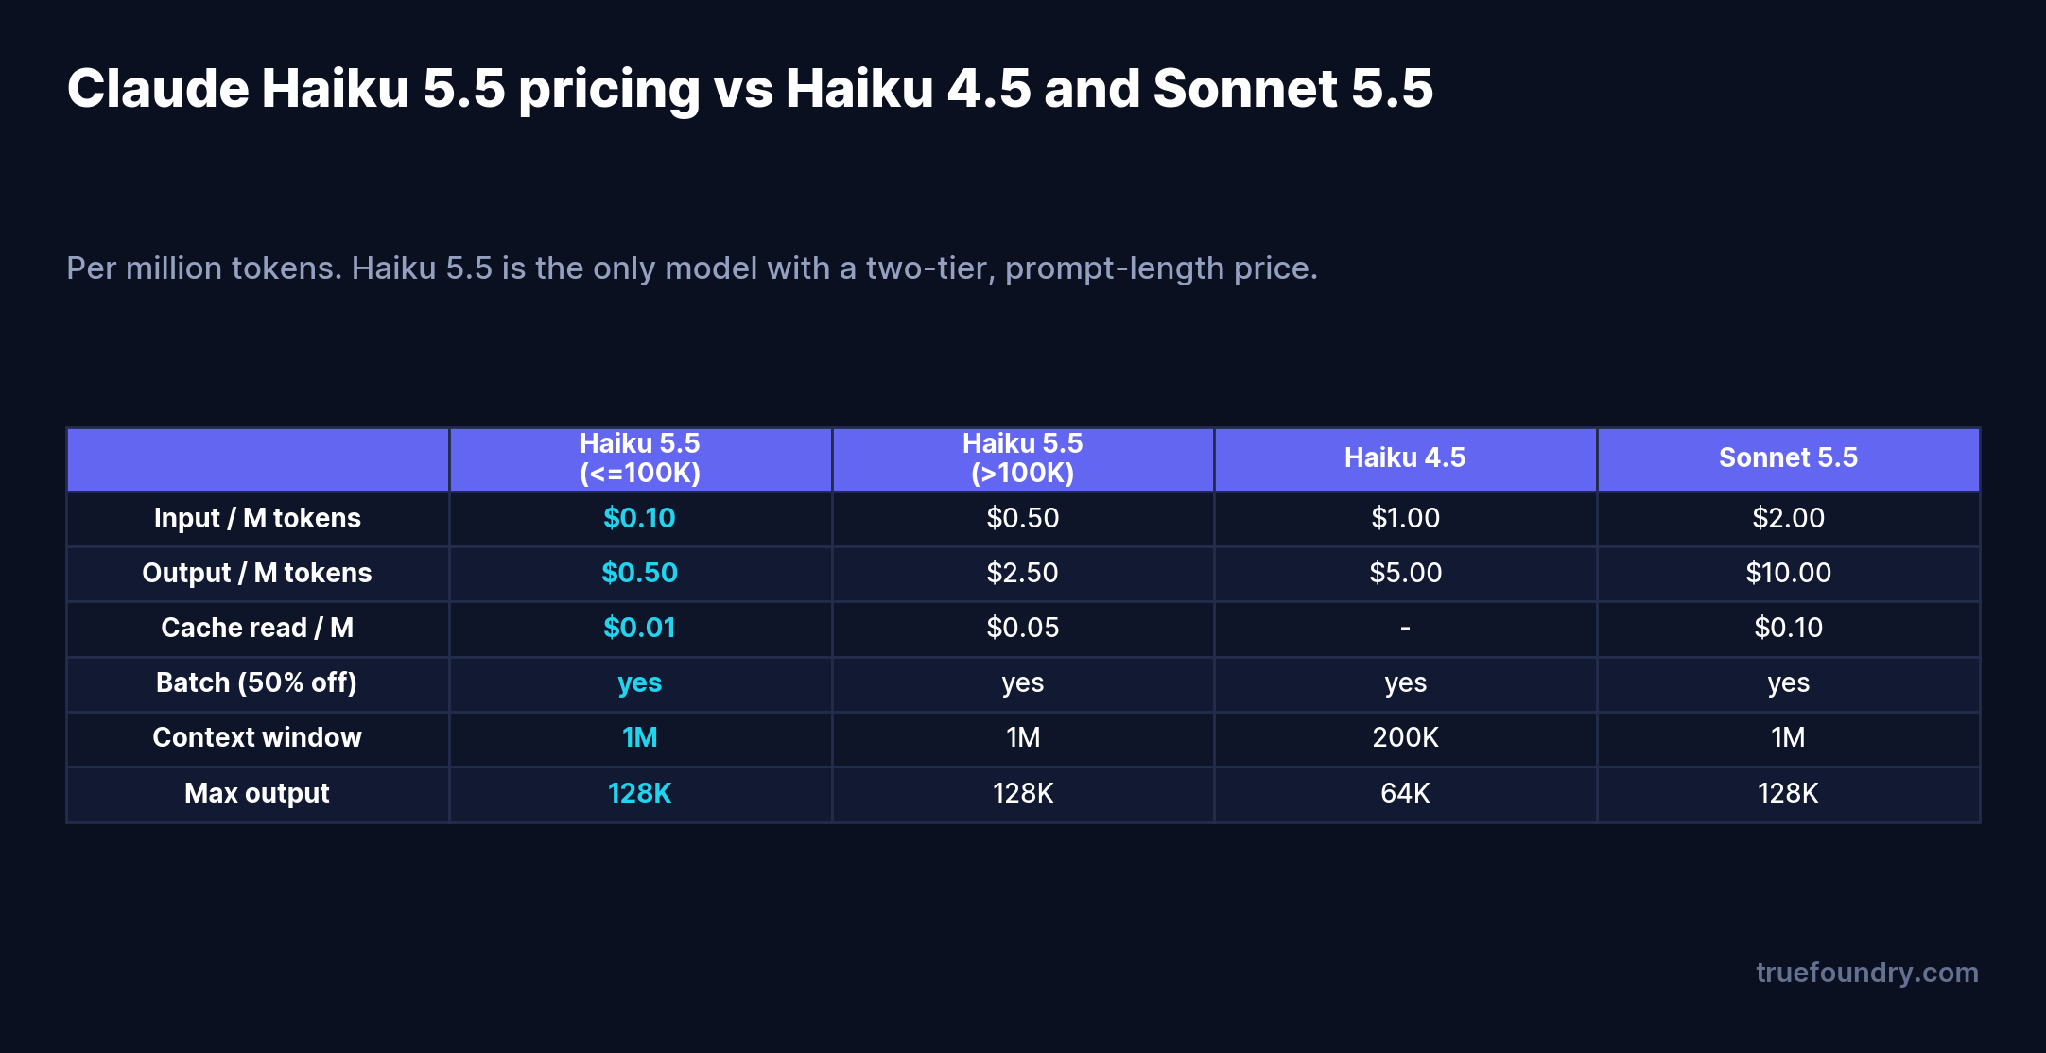
Drie zaken vallen op.
De inputprijs maakt het verschil. Met $ 0,10 per miljoen inputtokens kost Haiku 5.5 een tiende van Haiku 4.5 en een twintigste van Sonnet 5.5. Bij input-intensief werk — RAG, lange contexten, documentverwerking — vormt dit het grootste deel van de rekening, en dit is waar Haiku 5.5 het scherpst geprijsd is.
Caching en batching zorgen voor extra besparingen. Cache reads kosten $ 0,01 per miljoen tokens, waardoor een vaste system prompt of een hergebruikt document bij vervolgcalls vrijwel gratis is. De Batch API geeft nog eens 50% korting op werk dat asynchrone verwerking toelaat. Hoewel dit niet uniek is voor Haiku, versterken beide opties de totale besparing.
Alles boven 100K tokens valt qua prijs in een andere categorie. Dat is het addertje onder het gras, wat extra toelichting vereist.
Haiku 5.5 is het enige model in de reeks met een tarief dat afhankelijk is van de promptlengte via twee prijsstaffels. Tot 100K tokens in een enkele request betaalt u $ 0,10 / $ 0,50. Zodra een prompt de 100K overschrijdt, wordt het tarief $ 0,50 / $ 2,50 — vijf keer het inputtarief en vijf keer het outputtarief — en dit geldt voor de volledige prompt, niet alleen voor de tokens boven de grens.
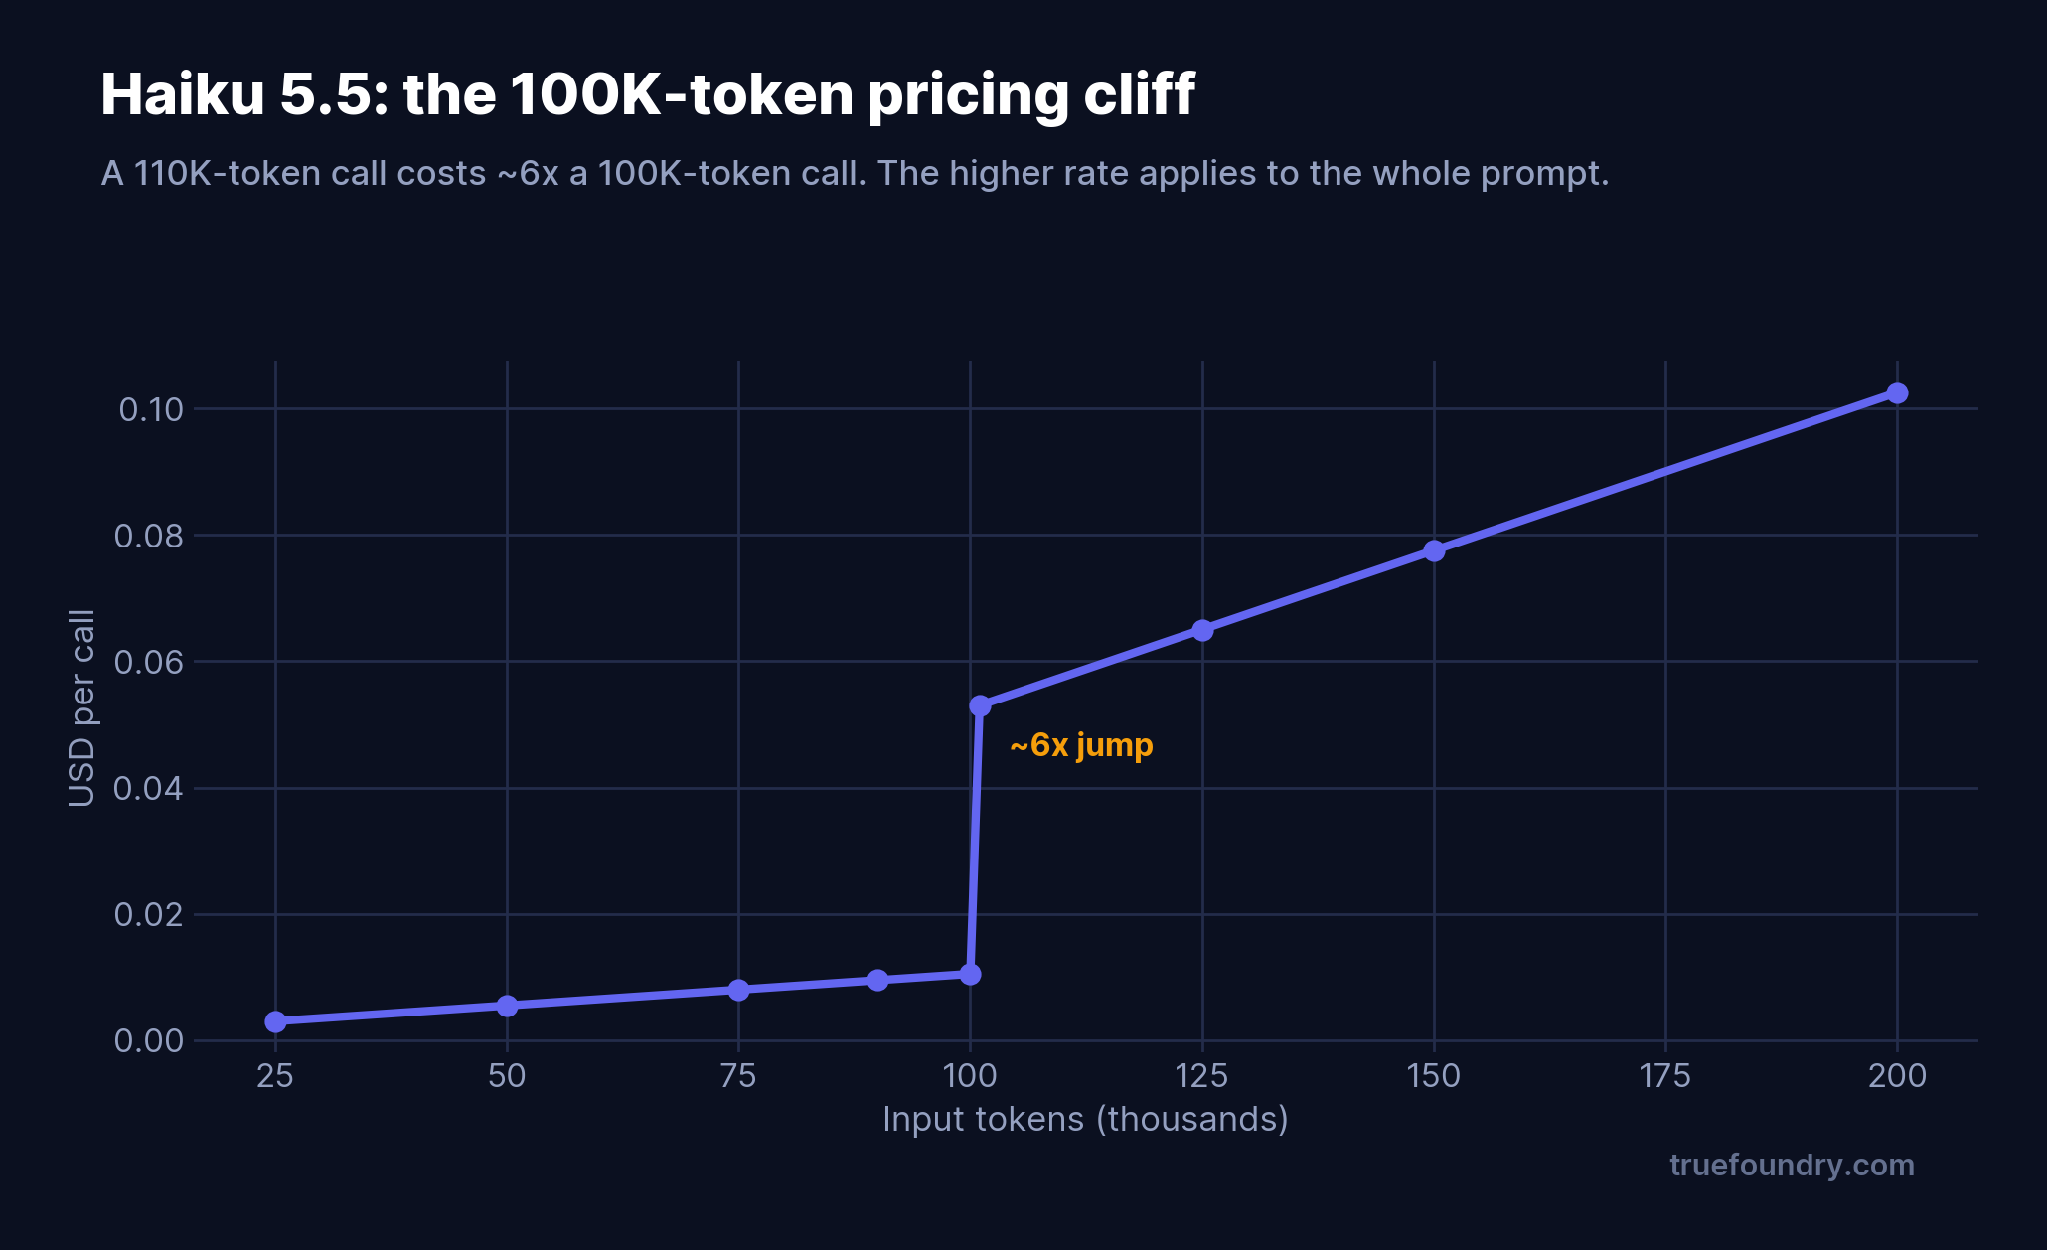
Het effect is een sprong, geen geleidelijke stijging. Een call van 90K tokens met 1K aan output kost ongeveer $ 0,0095. Verhoogt u dezelfde call naar 110K tokens, dan kost deze ongeveer $ 0,0575 — circa 6× meer voor 22% meer input. De inhoud van de taak veranderde niet; u bent enkel over een prijsgrens gegaan.
Voor de meeste toepassingen vormt dit geen probleem, omdat de meeste prompts ruim onder de 100K blijven. Drie specifieke patronen bevinden zich echter rond deze grens: RAG-pipelines met grote opgehaalde contexten, analyses van volledige documenten of codebases, en lange agentic chains die stap voor stap historie opbouwen. Als deze regelmatig de 100K overschrijden, daalt het prijsvoordeel ten opzichte van Sonnet van 20× naar ongeveer 4×, waardoor de keuze voor Haiku opnieuw gewogen moet worden. Het is essentieel om te weten wanneer uw dataverkeer deze grens overschrijdt — wat wederom een meetvraagstuk is.
De valkuil bij berichten als "$ 0,10 per miljoen tokens" is helder: u koopt geen losse tokens, u voert taken uit. En taken verschillen sterk in hun tokenverhoudingen.
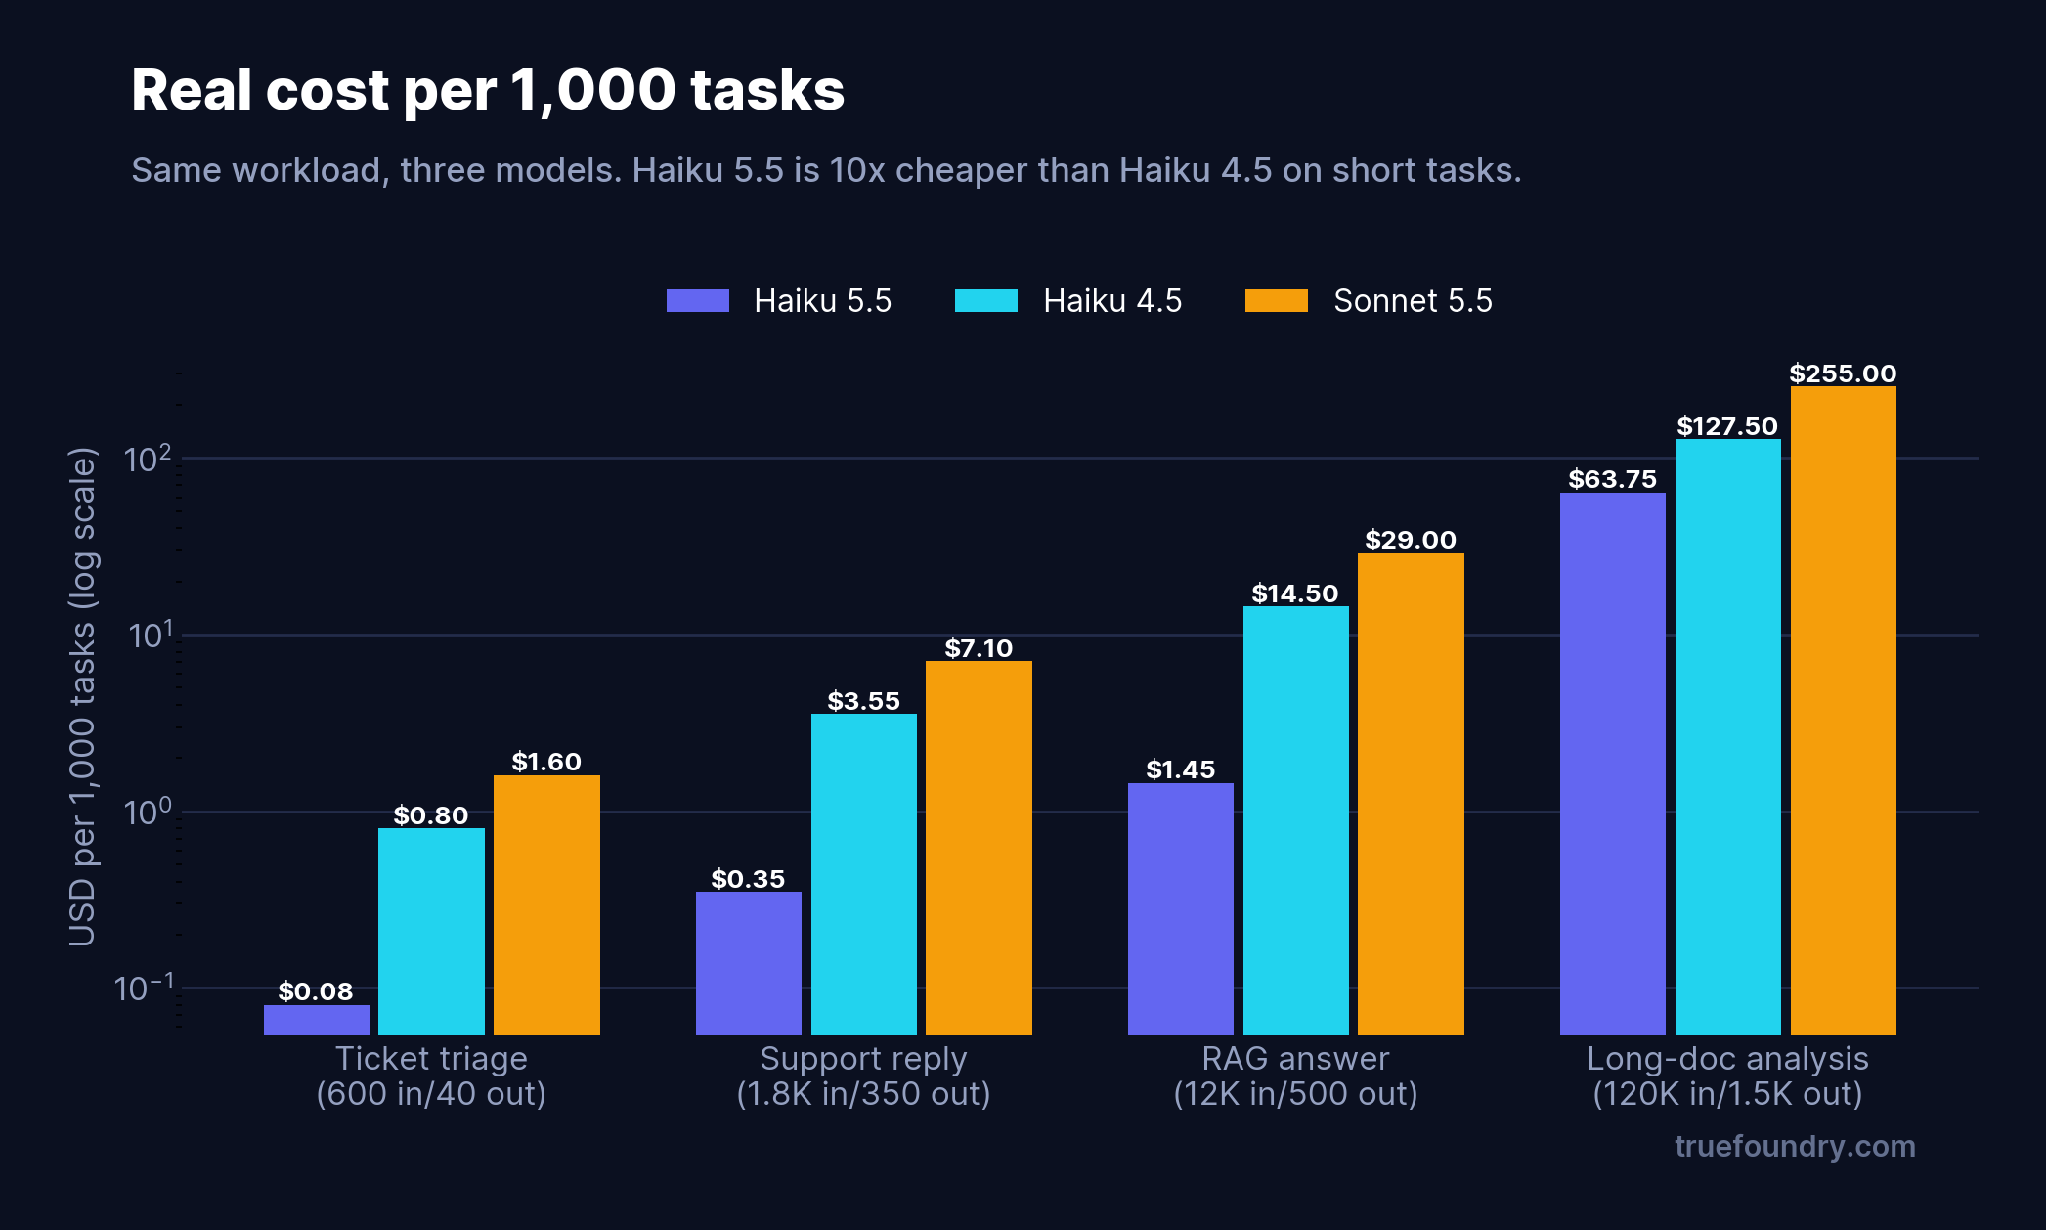
Vier representatieve taken, geprijsd op Haiku 5.5 in het standaardtarief (de lange documenttaak maakt gebruik van het >100K-tarief):
Dit toont een verschil van factor 800 op één enkel model, uitsluitend veroorzaakt door het type taak. Daarom is de vraag "welk model is het goedkoopst" niet de juiste. De juiste vraag is "wat kost mijn taak op dit model, bij mijn specifieke input/output-verhouding en volume" — en het antwoord verandert zodra uw prompts langer worden of uw output groeit.
Twee factoren bepalen de uitkomst: uw input/output-verhouding en het wel of niet overschrijden van de 100K-grens. Een samenvatter (grote input, kleine output) werkt heel anders dan een contentgenerator (kleine input, grote output), omdat outputtokens bij Haiku 5× duurder zijn dan inputtokens. Gemiddelde tarieven verhullen dit; metingen per taak maken het inzichtelijk.
Ze budgetteren uitsluitend op basis van het inputtarief. Output is bij Haiku 5× zo duur als input. Een interactieve agent die uitgebreide antwoorden genereert, kan aanzienlijk duurder uitvallen dan het inputvolume doet vermoeden. Stuur daarom op outputtokens, niet alleen op input.
Ze negeren de drempel tot de factuur binnenkomt. Een RAG-systeem dat door een groeiende kennisbank langzaam van gemiddeld 80K naar 110K context groeit, blijft technisch prima werken — maar wordt ongemerkt ~6× zo duur per call. Zonder inzicht per request valt dit pas op wanneer de financiële afdeling vragen stelt.
Ze vergelijken lijstprijzen in plaats van de gewogen kosten per taak. Het model dat op papier het voordeligst lijkt, kan bij uw specifieke mix van dataverkeer duurder uitvallen. De enige betrouwbare vergelijking is het meten van uw eigen taken.
Ze maken geen gebruik van caching. Een vaste system prompt die bij elke call opnieuw wordt meegestuurd is verspilling op $ 0,10/M als dit gecached $ 0,01/M kan kosten. Bij een hoog volume Haiku-verkeer heeft de cache-hitrate directe invloed op het budget.
De kern blijft gelijk: wat u niet per taak meet, kunt u niet sturen. De TrueFoundry AI Gateway bevindt zich voor elke model-call en registreert het verbruik, zodat "wat Haiku daadwerkelijk kost" direct inzichtelijk wordt op een dashboard.
Wanneer u een model toevoegt, koppelt de gateway hier een kostenstructuur aan. Public Cost haalt door de provider gepubliceerde tarieven op uit de open-source prijscatalogus van TrueFoundry (github.com/truefoundry/models), die automatisch wordt bijgewerkt — inclusief regiospecifieke tarieven en prijsstaffels, wat exact is hoe de 100K-drempel van Haiku verwerkt wordt. Met Private Cost kunt u gecontracteerde of aangepaste tarieven invoeren voor specifieke overeenkomsten en fine-tuned modellen.
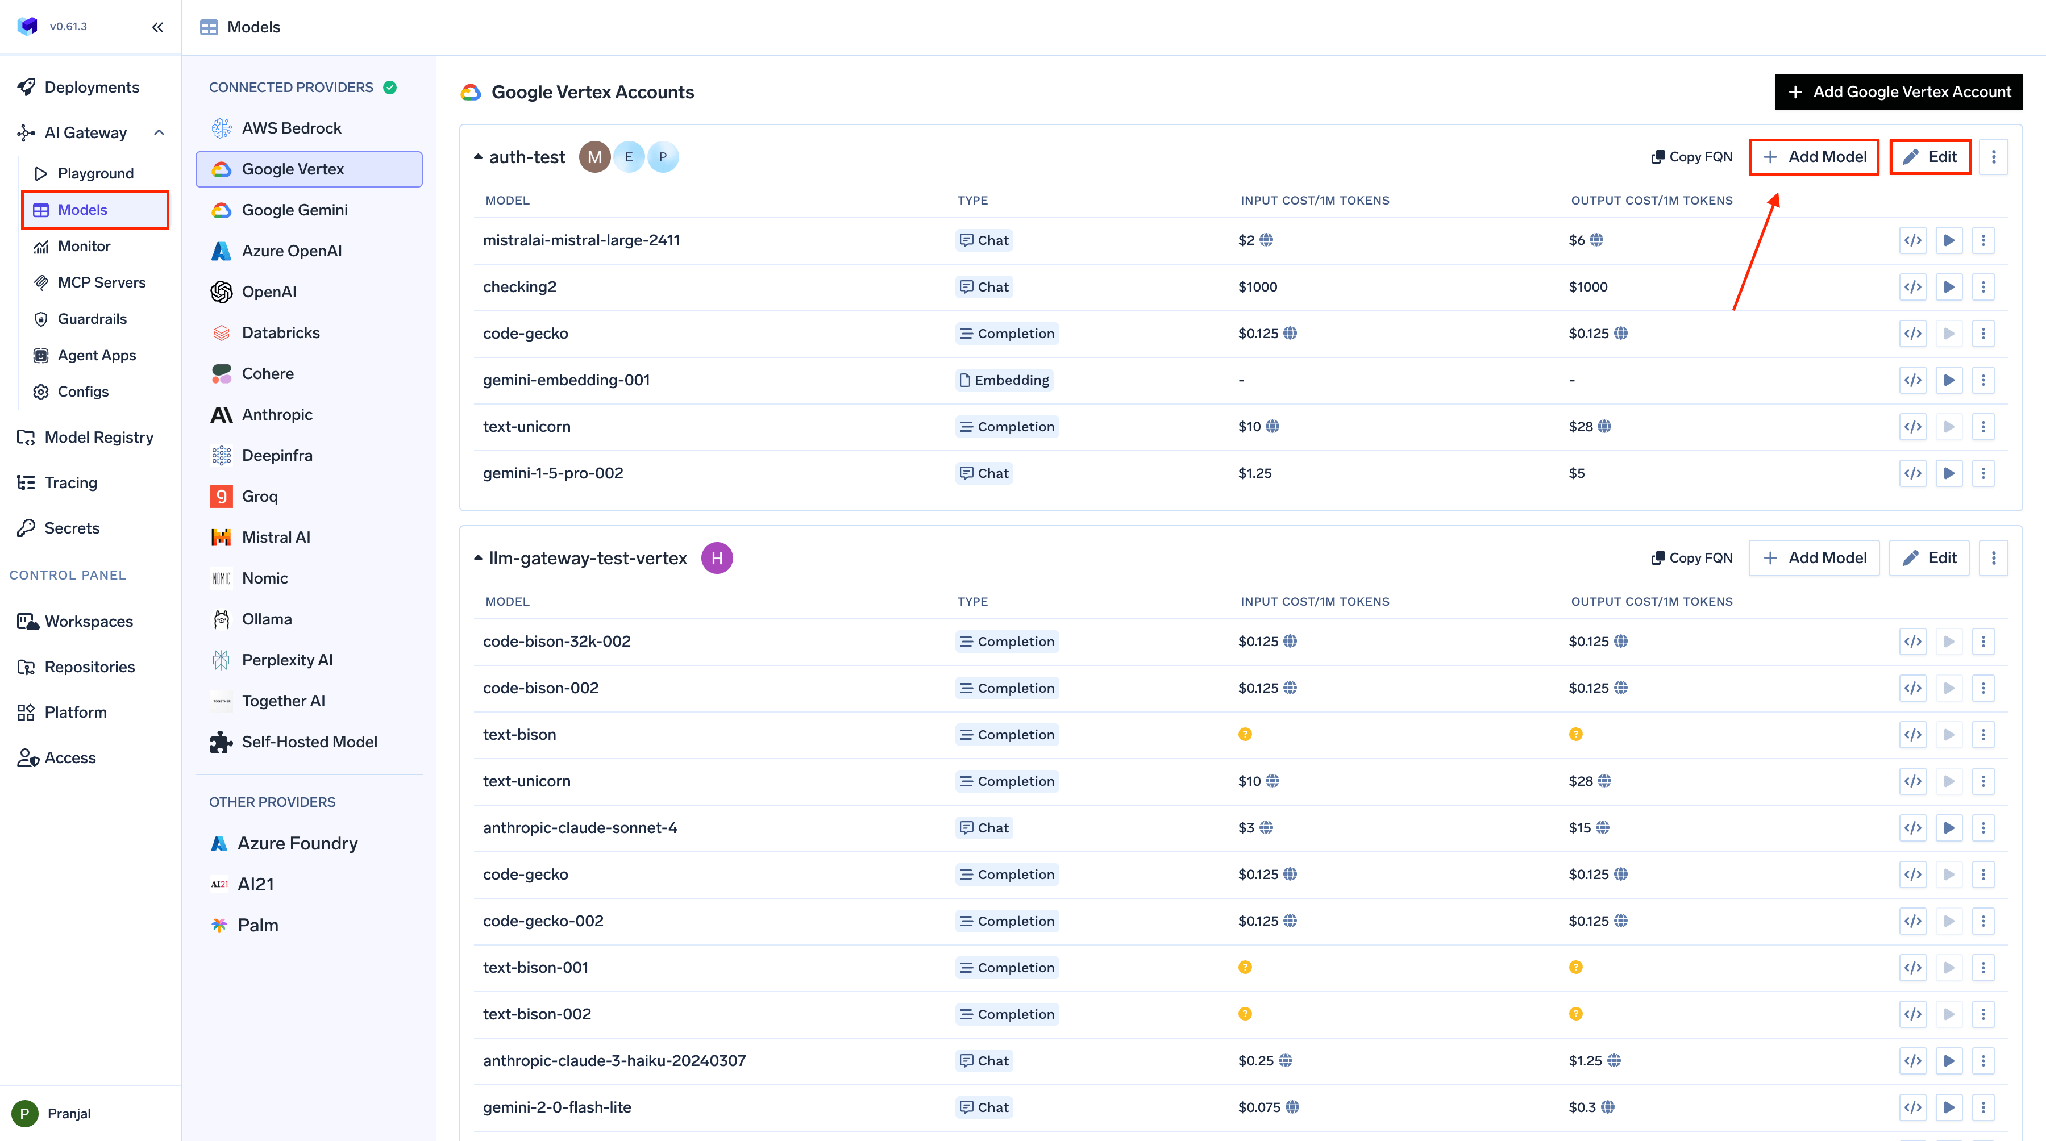
Omdat de catalogus rekening houdt met gestaffelde prijzen, wordt de overgang van Haiku van de $ 0,10-staffel naar de $ 0,50-staffel boven de 100K tokens correct per request geregistreerd, in plaats van berekend tegen een vast gemiddelde dat de kosten van lange contexten zou onderschatten.
Zodra er calls worden uitgevoerd, toont het Metrics-dashboard de totale uitgaven, de trend van de Cost of Inference en directe uitsplitsingen per model, gebruiker en team.
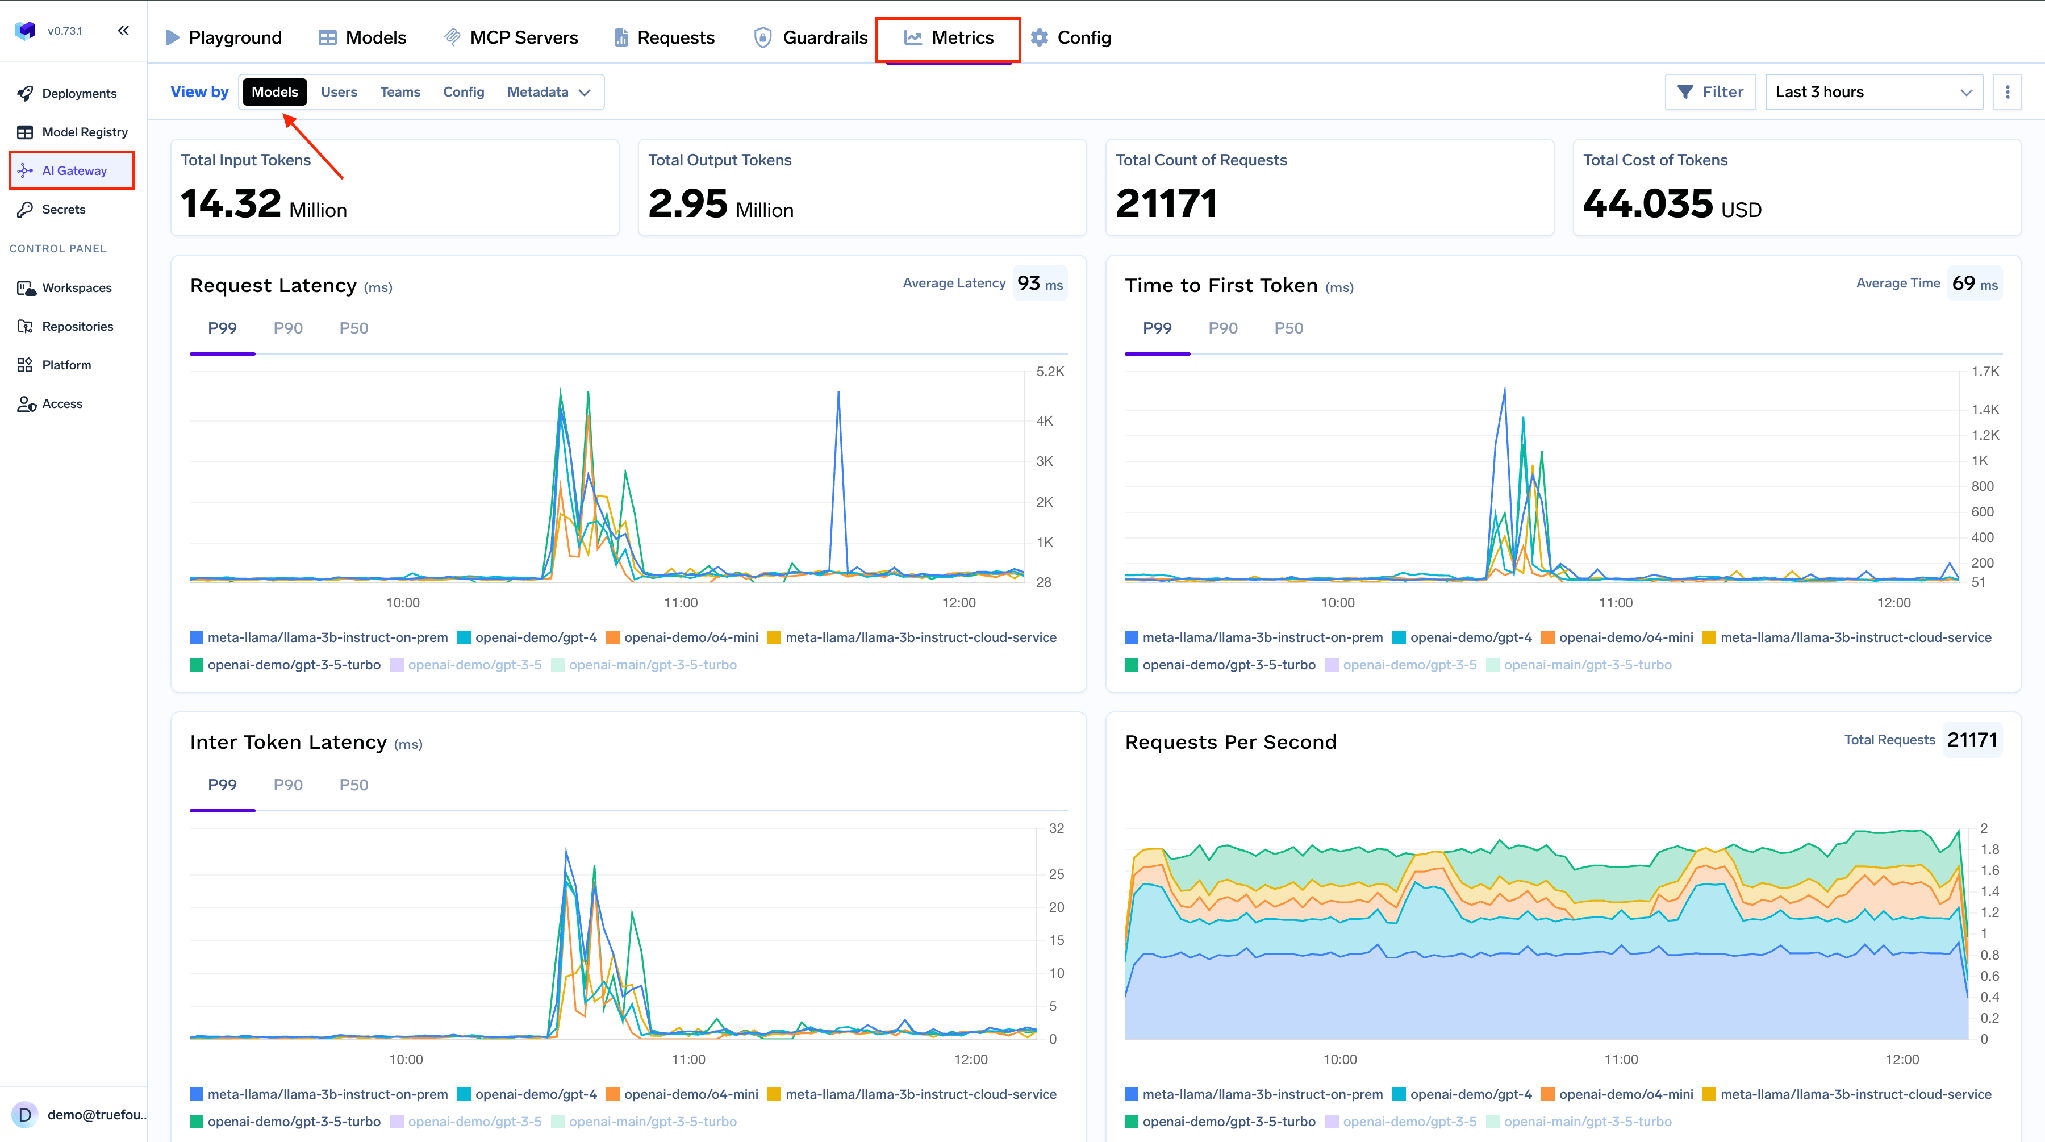
Het modeloverzicht laat zien wat Haiku deze maand kost vergeleken met Sonnet; de teampagina ondersteunt interne doorberekening; het gebruikersoverzicht maakt inzichtelijk welke individuele gebruiker verantwoordelijk is voor een groot deel van de kosten.
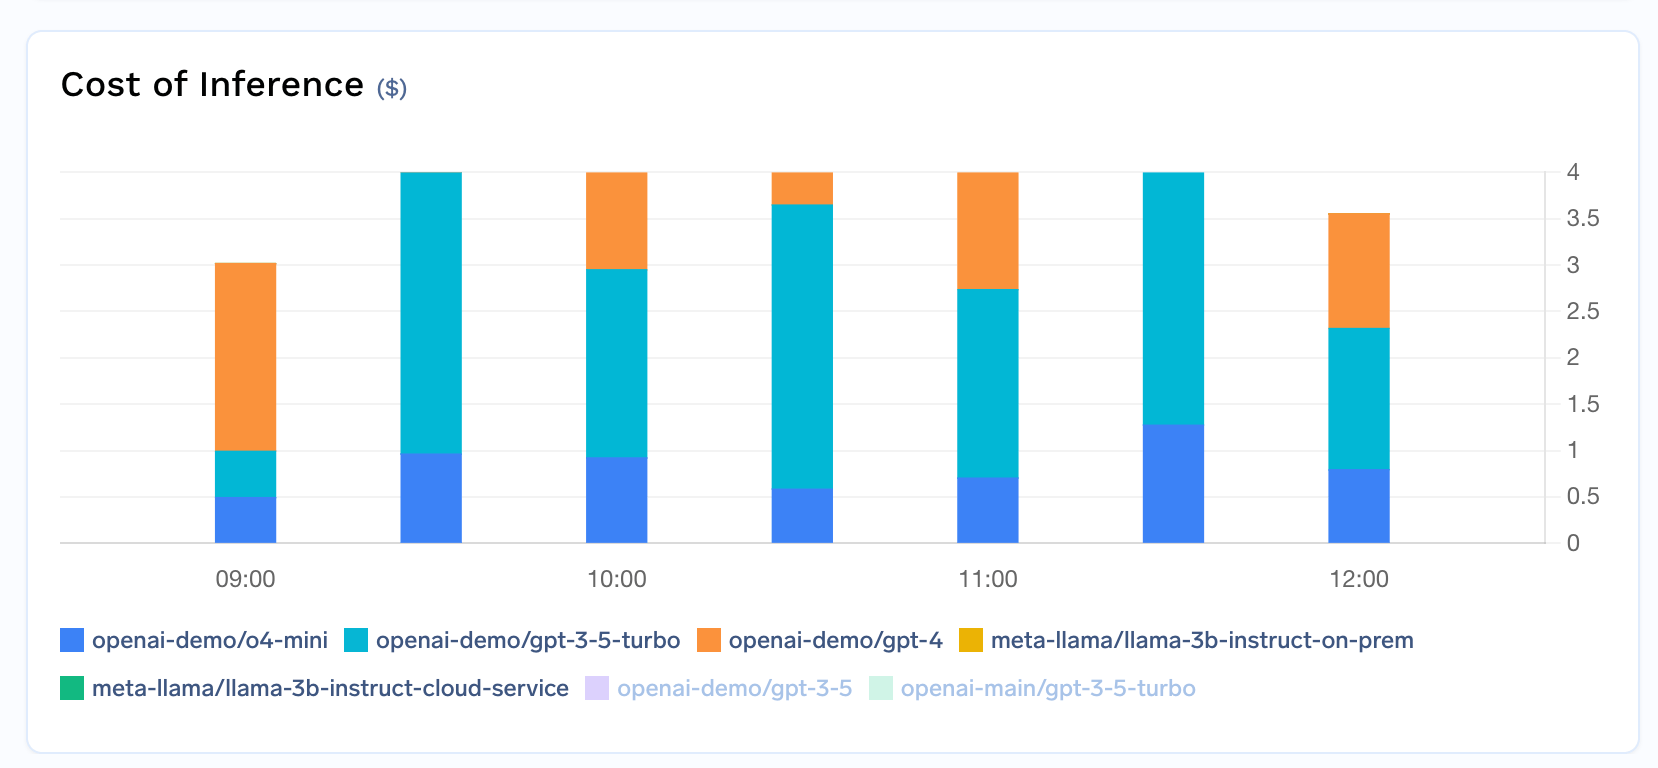
Naast de standaardoverzichten kunt u aangepaste metadata toevoegen — zoals application, environment, customer_id, cost_center — en kosten hierop groeperen. Virtual-account tags en aan teams gekoppelde tokens voegen deze metadata automatisch toe, wat zorgt voor kostentoewijzing per applicatie en per klant zonder dat de client-code aangepast hoeft te worden. Dit kan worden afgedwongen met een guardrail voor metadata-validatie die requests zonder vereiste sleutels weigert, waarna de ruwe gegevens geëxporteerd kunnen worden voor de financiële administratie.
Voor de technische details achter deze cijfers — zoals de tarieven voor gecachte tekst versus gecachte afbeeldingen, audio-facturatie en de verwerking van geannuleerde streams — biedt de documentatie voor kostenregistratie de volledige formules.
Een SaaS-bedrijf maakt gebruik van een klantenservice-assistent: 50.000 gesprekken per dag, met een gemiddelde van 1.800 inputtokens (system prompt + opgehaalde context + historie) en 350 outputtokens per antwoord.
Op Haiku 5.5 in de standaardstaffel komt dat neer op ongeveer $ 0,355 per 1.000 antwoorden, of circa $ 17,75 per dag — ongeveer $ 533 per maand. Hetzelfde verkeer op Sonnet 5.5 zou ongeveer $ 7,10 per 1.000 kosten, oftewel $ 355 per dag — $ 10.650 per maand. De modelkeuze maakt bij dezelfde werklast een factor 20 verschil.
Wanneer hier caching aan wordt toegevoegd: de system prompt en tool-definities beslaan ~1.200 van die 1.800 inputtokens en veranderen niet. Gecached tegen $ 0,01/M in plaats van $ 0,10/M nemen de inputkosten bij herhaalde calls sterk af. De cachestatistieken van de gateway tonen de exacte besparing in dollars en de hitrate, zodat de optimalisatie aantoonbaar resultaat oplevert.
Het gaat hierbij niet om de exacte getallen, maar om het principe dat elke knop om aan te draaien — modelkeuze, caching, de 100K-grens — per taak meetbaar is, en daardoor stuurbaar wordt.
Claude Haiku 5.5 laat zien dat een voordeliger model niet langer een compromis hoeft te zijn: een context en output op topniveau tegen een tiende van de prijs van de vorige generatie. De tarievenkaart is echter een uitgangspunt, geen eindpunt. De werkelijke kosten zijn een gewogen getal dat afhangt van de taakstructuur, de outputlengte, caching en het eventueel overschrijden van de 100K-grens — en dit beweegt mee met de groei van uw product.
Organisaties die efficiënt omgaan met AI-uitgaven, zijn de organisaties die kosten meten waar ze ontstaan: bij de gateway, per taak, per model en per team. Dat is het verschil tussen aannemen dat u een goedkoop model gebruikt, en zeker weten dat u kostenefficiënt werkt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



$0.10 per million input tokens and $0.50 per million output tokens for prompts up to 100K tokens. Above 100K, it is $0.50 input and $2.50 output, applied to the whole prompt. Cache reads are $0.01/M and the Batch API is 50% off.
Yes — substantially. Haiku 4.5 was $1.00 / $5.00 per million tokens, so Haiku 5.5’s standard tier is about 90% cheaper on the headline rate and roughly 75% cheaper to run on average across typical workloads.
Haiku 5.5 has two price tiers split at 100K tokens per prompt. Crossing 100K moves the entire prompt to the higher rate, so a 110K-token call costs about 6× a 100K-token one. It only affects long-context work.
Meter it at the gateway. TrueFoundry tracks cost per request, model, user, team, and custom metadata, so you see blended cost per task across your actual traffic instead of estimating from the rate card.
Yes. The TrueFoundry AI Gateway normalizes cost across providers, so Haiku, Sonnet, GPT, Gemini, and open models all appear in one dashboard with consistent per-task and per-team attribution.
Ja. Het dataverkeer van TrueFoundry draait in uw VPC of on-prem, zodat prompts en gebruiksdata binnen uw omgeving blijven, terwijl u toch uniforme kostentracking en governance krijgt.



Het laatste nieuws, artikelen en bronnen in je inbox



















