



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De helft van je Claude-factuur is mogelijk voor latentie die je niet gebruikt. Een groot deel van het productie-LLM-werk — het scoren van een dataset, het samenvatten van een achterstand aan documenten, het genereren van labels in embeddings-stijl, het uitvoeren van een eval-suite — heeft geen mens die op één enkele respons zit te wachten. Voor dat werk is het betalen van real-time prijzen het betalen van een toeslag voor snelheid die door niets wordt verbruikt. Claude’s Message Batches API bestaat om precies die toeslag terug te vorderen: dezelfde modellen, dezelfde kwaliteit, tegen 50% van de prijs, in ruil voor het accepteren van asynchrone levering.
Dit artikel gaat over wanneer die ruil de moeite waard is, wanneer niet, en hoe je batch op een schone manier uitvoert — inclusief via een gateway, zodat de batch-uitgaven in hetzelfde kostenoverzicht terechtkomen als al het andere. De onderstaande cijfers zijn afkomstig uit de Message Batches-documentatie van Anthropic, vanaf oktober 2026.
Batch is geen ander model of een pad van lagere kwaliteit. Het is dezelfde Claude, ingepland in plaats van onmiddellijk.
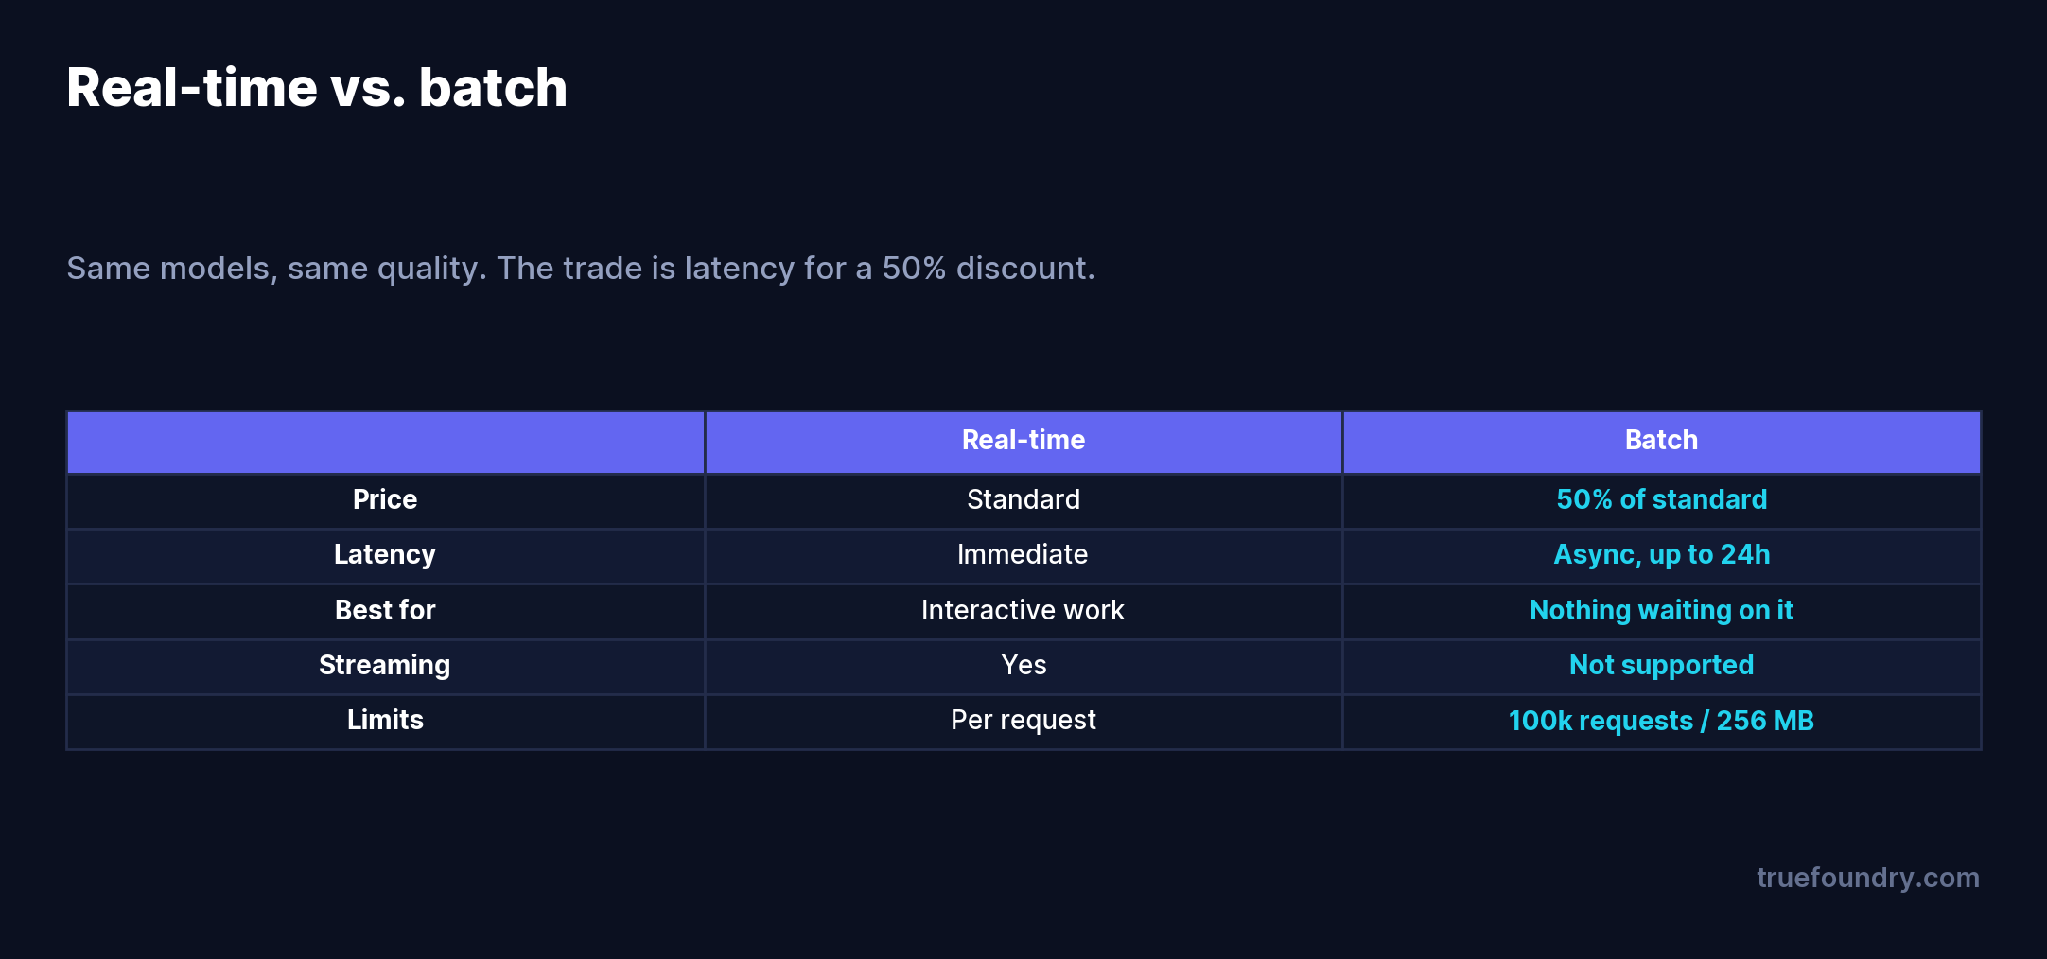
Batchgebruik wordt in rekening gebracht tegen 50% van de standaard API-prijzen. In ruil daarvoor wordt de batch asynchroon verwerkt: het systeem werkt er zo snel mogelijk doorheen (de meeste zijn binnen een uur voltooid) en je kunt de resultaten ophalen zodra elke request is voltooid of na 24 uur, afhankelijk van wat het eerst komt. Een batch die niet binnen 24 uur wordt voltooid, verloopt. Je dient een lijst met requests in, elk met een custom_id; je pollt totdat de processing_status van de batch beëindigd is; vervolgens stream je de resultaten en koppel je ze terug op basis van custom_id, omdat ze in willekeurige volgorde kunnen terugkomen.
De test is één vraag: wacht er iets op deze respons? Als er niets wacht, maak er dan een batch van.
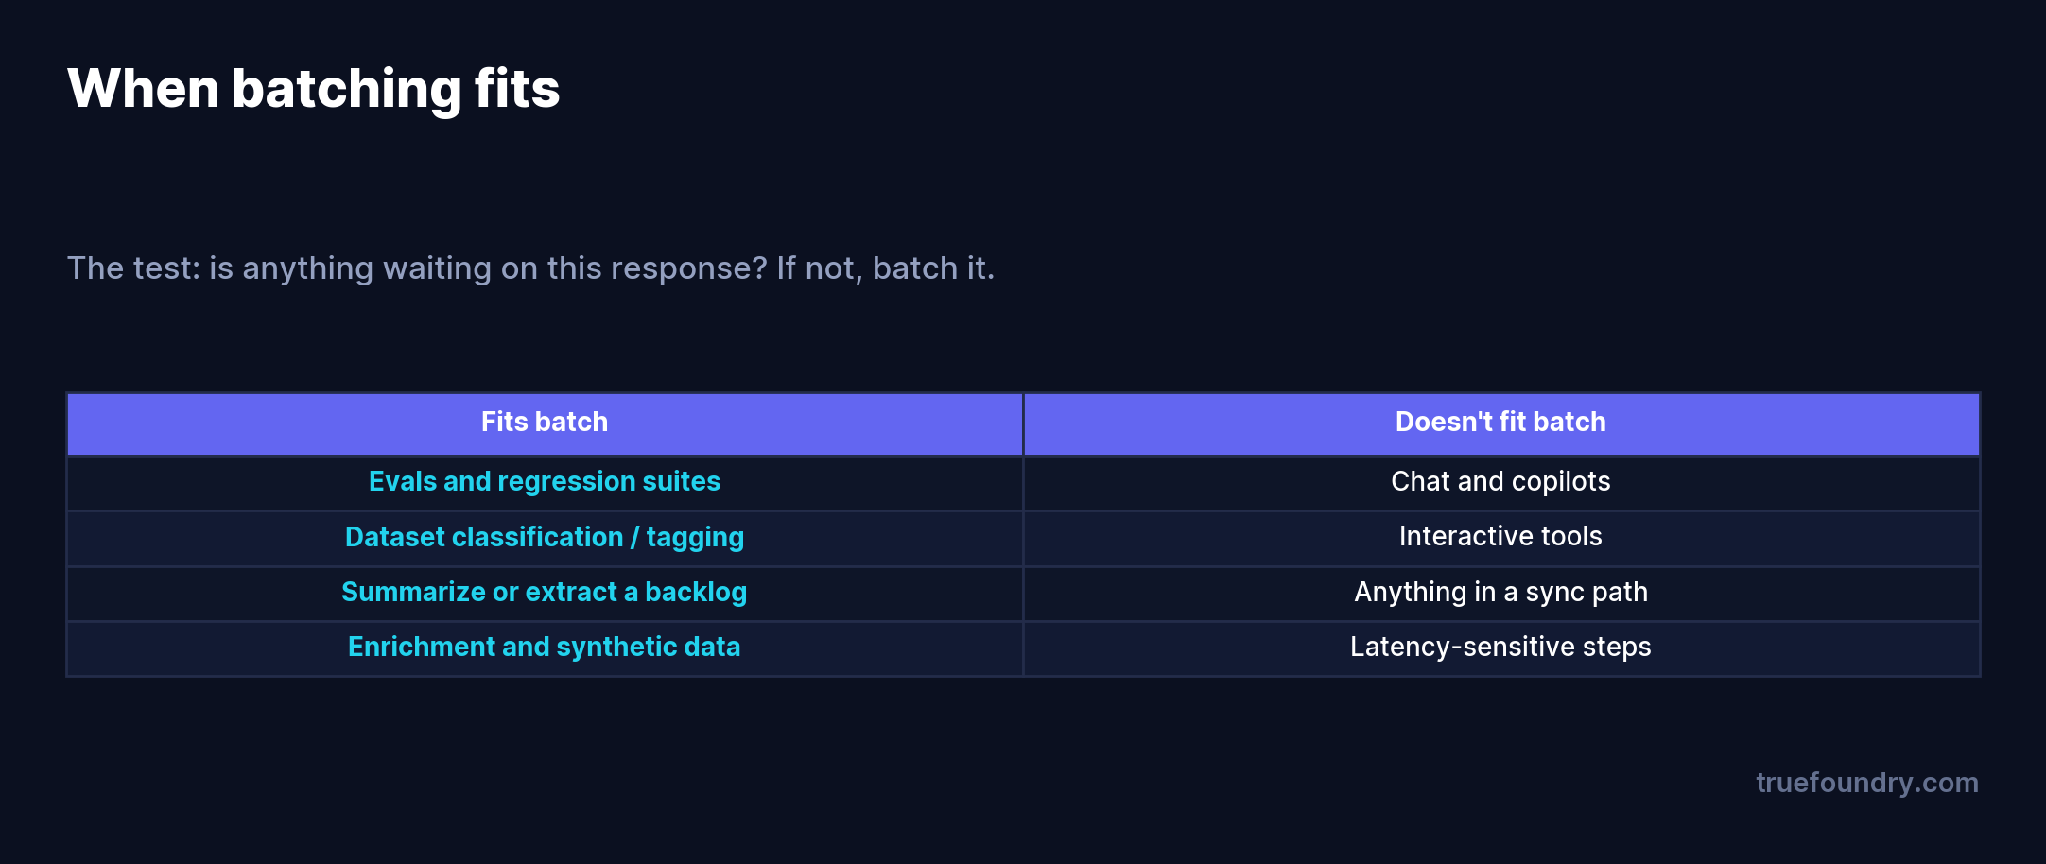
Goede toepassingen zijn de taken die volgens een schema of op een backlog draaien: evaluatie- en regressiesuites, het classificeren of taggen van een dataset, het samenvatten van of verwerken uit een documentencorpus, het verrijken van records, het genereren van synthetische data en het herverwerken van content na een promptwijziging. Slechte toepassingen zijn alles waarop een persoon of een agent is geblokkeerd: chat, copilots, interactieve tools en elke stap binnen een synchroon request-pad. De fout is om een latentiegevoelige functie door een batch te dwingen om de korting na te jagen — je bespaart 50% en levert een product op dat gebruikers een dag laat wachten.
Er is een middenweg die het noemen waard is: werk dat tolerant is voor minuten, maar niet voor uren. Batch is hier wisselvallig, want hoewel de meeste batches binnen een uur klaar zijn, is de garantie slechts 24 uur. Als een paar uur tail-latentie de workflow zou verstoren, behandel het dan als real-time.
De twee grootste kostenhefbomen van Claude versterken elkaar. Anthropic geeft duidelijk aan dat de kortingen voor prompt-caching en Message Batches stapelen — een batched request dat een gecachete prefix raakt, betaalt de helft van de prijs op een tokenblok dat al 90% goedkoper is.
Het adderetje onder het gras is de cache-TTL. Batched requests duren routinematig langer dan het standaard cachevenster van 5 minuten, waardoor items die vroeg zijn geschreven kunnen verlopen voordat latere requests in dezelfde batch ze lezen. Gebruik voor batch de cacheduur van 1 uur op de gedeelde prefix, houd de cachebare cache_control-blokken identiek voor elke request en structureer de batch zo dat requests zoveel mogelijk statische context delen. Cache hit-rates variëren in de praktijk sterk (Anthropic noemt 30% tot 98%, afhankelijk van de aard van het verkeer), dus zoals altijd: meet het in plaats van te veronderstellen.
Hier is een specifieke, eerlijke beperking die goed is om te weten. De batch-ondersteuning van de TrueFoundry AI Gateway voert batch-jobs uit via de OpenAI SDK voor OpenAI, Azure OpenAI, Microsoft Foundry, Bedrock en Vertex — maar niet het first-party batch-eindpunt van Anthropic. Er zijn dus twee schone manieren om Claude te batchen.
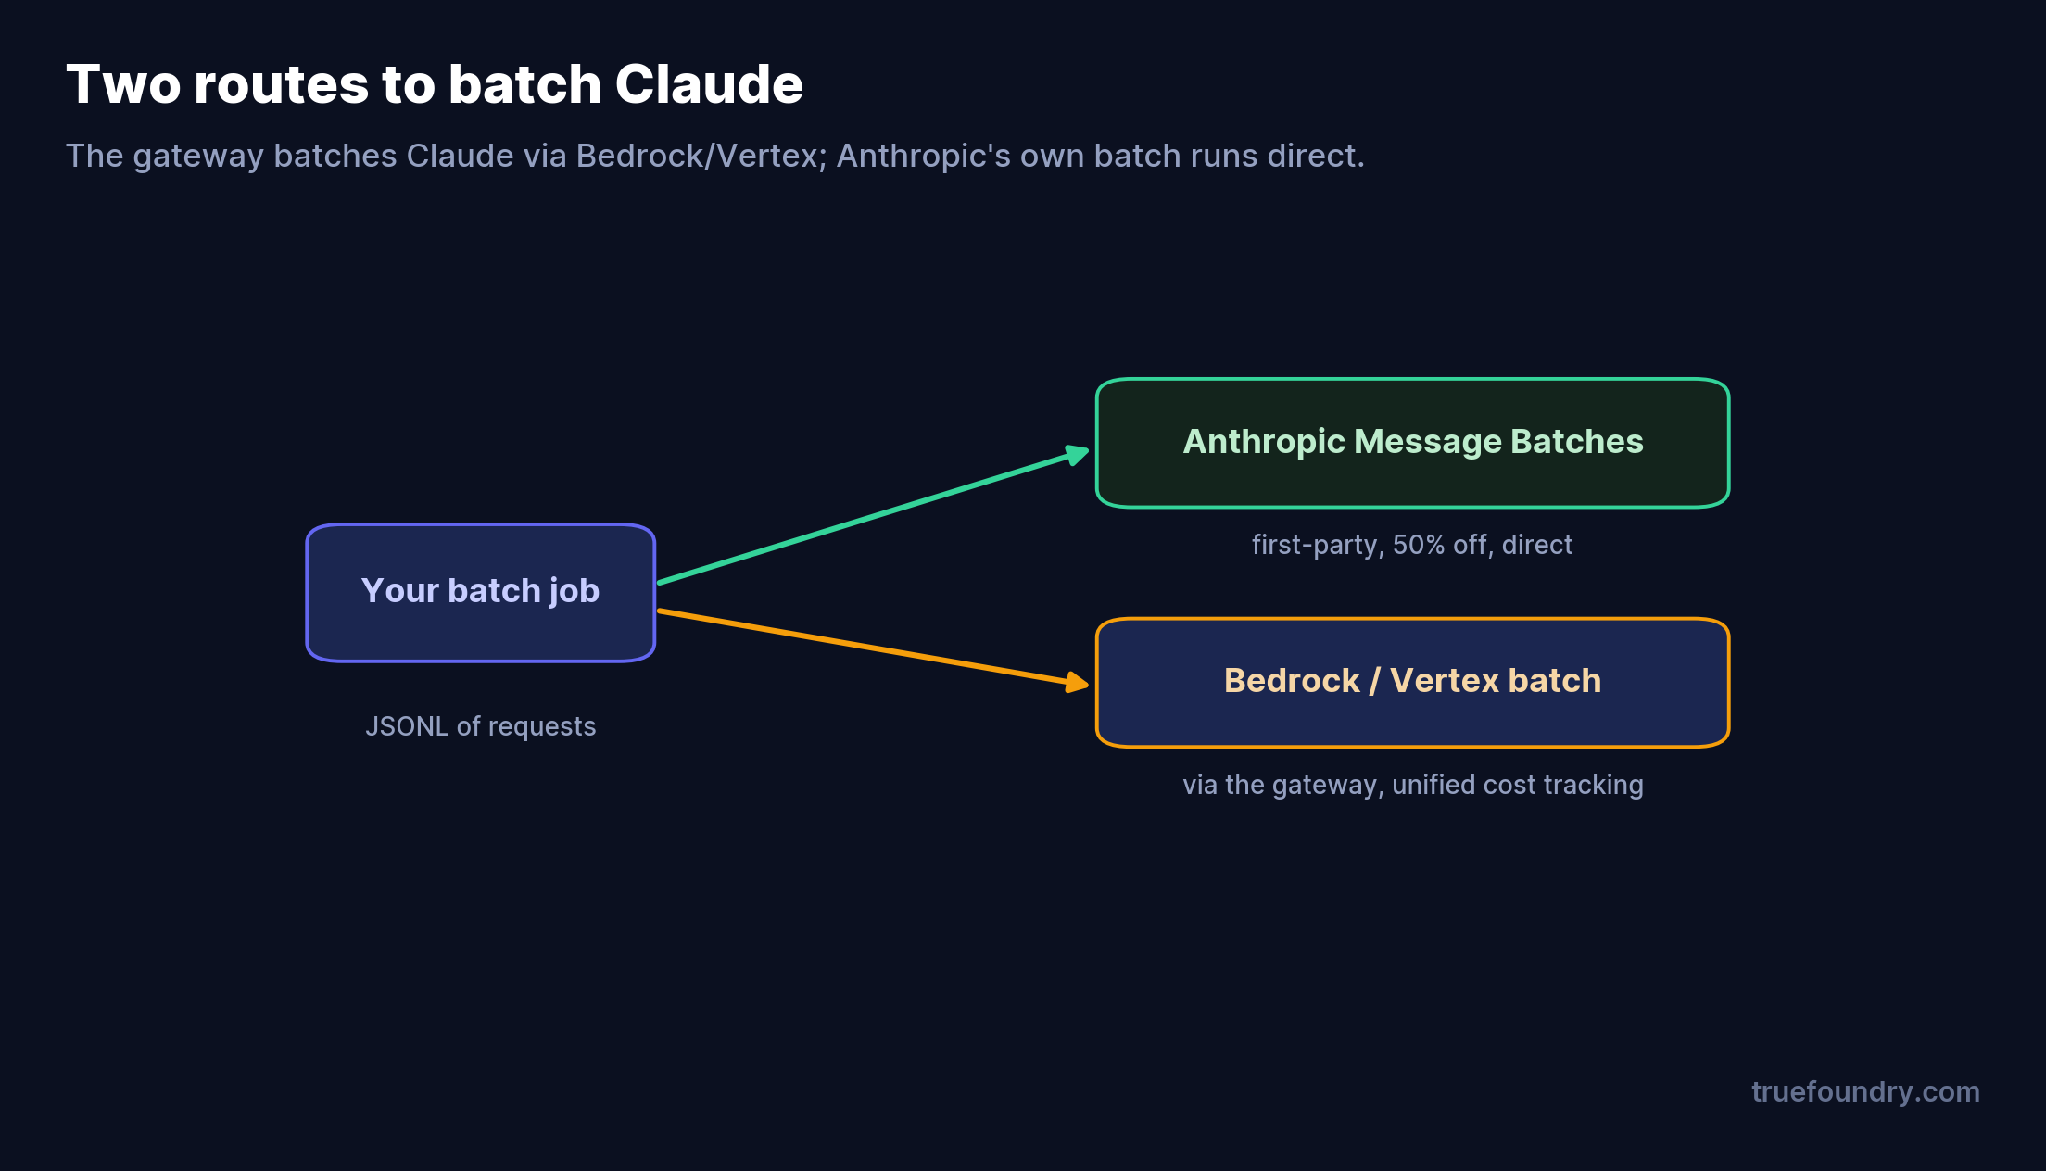
Route één: rechtstreeks via Anthropic's Message Batches API. Je krijgt de first-party korting van 50%, de limieten van 100.000 requests / 256 MB en een native caching-interactie. De gateway verzorgt nog steeds je real-time Claude-verkeer en kostenrapportage; de batch-job draait tegen Anthropic en je stemt de uitgaven daarvan af.
Route twee: Claude op Bedrock of Vertex, ge-batched via de gateway. Als je Claude al via Bedrock of Vertex gebruikt (gebruikelijk in gereguleerde omgevingen), dien je batch-jobs in via de batch-flow van de gateway — upload een JSONL-bestand, maak de job aan met een input_file_id, endpoint en completion_window, poll de status en haal de output_file_id op. Eén kanttekening uit de documentatie: virtuele modellen worden niet ondersteund voor batch, dus je geeft een echte catalogusmodel-ID door, en Bedrock past een standaard max_tokens van 4096 toe voor Claude Opus en Sonnet als je dit weglaat — stel dit expliciet in voor lange outputs.
Hoe dan ook, de winst van het via de gateway doen is hetzelfde: batch- en real-time Claude-uitgaven verschijnen op één plek, toegeschreven per team en model, zodat je daadwerkelijk kunt zien hoeveel de 50%-hefboom heeft bespaard.
Ze batchen interactief werk. De 50% korting is een product dat gebruikers laat wachten niet waard. Als er iets is geblokkeerd op de respons, is het real-time.
Ze negeren de 24-uurs tail. De meeste batches zijn binnen een uur klaar, maar de enige garantie is 24 uur en het verlopen daarna. Ontwerp voor de tail, niet het gemiddelde.
Ze slaan caching over in de batch. Batch- en cachekortingen stapelen zich op; als je caching uitschakelt bij een batch met een gedeelde prefix, laat je het grootste deel van de besparing liggen. Gebruik de TTL van 1 uur.
Ze verwachten Anthropic te batchen via de gateway. De gateway batched Claude via Bedrock of Vertex; voor een rechtstreekse Anthropic-batch roep je de Message Batches API aan en stem je de uitgaven af.
Batching is de eenvoudigste 50% die de meeste teams nooit pakken. De korting is geen addertje onder het gras of een minder model — het is de prijs van het opgeven van latentie die je toch niet gebruikte. Sorteer je Claude-workloads op basis van één vraag: wacht er iets op dit antwoord? Alles wat "nee" antwoordt — evals, backfills, classificatie, verrijking — hoort thuis in een batch, idealiter met een cache van 1 uur op de gedeelde prefix, zodat de twee kortingen stapelen.
Voer het rechtstreeks uit tegen Anthropic voor het first-party eindpunt, of via Bedrock of Vertex via de gateway als dat is waar je Claude zich al bevindt — en houd zowel batch- als real-time uitgaven in één kostenoverzicht zodat de besparing een getal is dat je kunt zien, en geen hoop.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Batch usage is billed at 50% of standard API prices, in exchange for asynchronous delivery — results are available when the batch finishes or after 24 hours, whichever comes first.
Most batches complete within an hour, but the only guarantee is 24 hours; a batch that does not finish by then expires. Treat anything that cannot tolerate hours of tail latency as real-time.
Up to 100,000 requests or 256 MB per batch, whichever comes first. Results are retained for 29 days. Streaming and Fast mode are not supported in batch.
Ja, en de kortingen stapelen. Omdat batches vaak langer duren dan het cachevenster van 5 minuten, gebruikt u de cache-TTL van 1 uur en houdt u de gecachete blokken identiek over verzoeken heen.
Through the gateway you can batch Claude on Bedrock or Vertex; for Anthropic’s first-party batch endpoint, call it directly while the gateway fronts your real-time traffic and cost reporting.



Het laatste nieuws, artikelen en bronnen in je inbox



















