Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
9,9
RAG bouwen met TrueFoundry en MongoDB Atlas
Bijgewerkt: November 10, 2026
Gepubliceerd: November 9, 2026
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting
De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Verwerkt 350+ RPS op slechts 1 vCPU — geen tuning nodig
Productieklaar met volledige enterprise-ondersteuning
Retrieval-Augmented Generation (RAG) combineert de krachten van retrieval-systemen en generatieve modellen om zeer relevante, contextbewuste resultaten te produceren. Het raadpleegt externe kennisbronnen—zoals databases of zoekindices—om relevante informatie op te halen, die vervolgens wordt verfijnd door een generatief model.
Waarom RAG?
Zeer relevante en contextbewuste resultaten.
Door dynamische en actuele kennis te integreren, overkomen RAG-systemen de beperkingen van statische pre-training in generatieve modellen, wat ze zeer effectief maakt voor toepassingen zoals het beantwoorden van vragen, kennisintensieve taken en gepersonaliseerde contentgeneratie.
Het modulaire karakter van RAG maakt optimalisatie in zowel de retrieval- als de generatiefase mogelijk, wat zorgt voor grotere flexibiliteit en schaalbaarheid in het systeemontwerp.
Cognita van TrueFoundry: RAG vereenvoudigen voor schaalbare toepassingen
Ondanks het potentieel kan het implementeren van RAG complex zijn, met name bij de modelselectie, data-organisatie en best practices. Bestaande tools vereenvoudigen prototyping, maar missen een open-source template voor schaalbare uitrol—en daar komt Cognita in beeld.
Cognita is een open-source RAG-framework dat het bouwen en uitrollen van schaalbare applicaties vereenvoudigt. Door RAG op te splitsen in modulaire stappen, garandeert het eenvoudig onderhoud, interoperabiliteit met andere AI-tools, aanpasbaarheid en compliance. Cognita biedt een balans tussen flexibiliteit en gebruiksvriendelijkheid, terwijl het schaalbaar blijft voor toekomstige ontwikkelingen.
Voordelen van Cognita
Een centrale, herbruikbare repository van parsers, loaders, embedders en retrievers.
Mogelijkheid voor niet-technische gebruikers om met de UI te werken - documenten uploaden en Q&A uitvoeren met behulp van modules die door het ontwikkelteam zijn gebouwd.
Volledig API-gestuurd - wat integratie met andere systemen mogelijk maakt.
Large Language Models (LLMs) voor eenvoudige interactie met generatieve modellen zoals OpenAI's GPT, Hugging Face-modellen of andere LLM API's.
Kant-en-klare integraties om eenvoudig verbinding te maken met Pinecone, Weaviate, ChromaDB of MongoDB Atlas Vector Search.
Het gebruik van MongoDB als vector database voor uw Retrieval-Augmented Generation (RAG)-applicatie kan voordelig zijn, afhankelijk van uw vereisten. Dit is waarom MongoDB een goede keuze kan zijn:
1. Natively ondersteunde Vector Search
MongoDB ondersteunt vector indexing via Atlas Vector Search. Dit maakt efficiënte similariteitszoekopdrachten mogelijk over hoogdimensionale data, wat essentieel is voor RAG-workflows. Belangrijkste voordelen:
Integratie met de Query Language van MongoDB: Combineert vector search met traditionele zoekopdrachten, wat zorgt voor een flexibelere en krachtigere query-opbouw.
Hoogwaardige zoekprestaties: Gebruikt Approximate Nearest Neighbor (ANN)-algoritmen zoals HNSW (Hierarchical Navigable Small World) voor schaalbare en snelle vector retrieval.
2. Geïntegreerd databeheer
RAG-applicaties vereisen vaak het beheer van zowel ongestructureerde data (bijv. tekst en embeddings) als gestructureerde data (bijv. metadata, gebruikersvoorkeuren).
MongoDB, als document database, stelt u in staat om embeddings samen met hun bijbehorende metadata in één enkel record op te slaan. Bijvoorbeeld:
Dit voorkomt de complexiteit van het beheren van embeddings in een afzonderlijk systeem.
3. Flexibiliteit en schaalbaarheid
Schema-loos ontwerp: De schemaflexibiliteit van MongoDB maakt het eenvoudig om te itereren op uw datamodel naarmate uw RAG-applicatie zich ontwikkelt.
Horizontale schaalbaarheid: MongoDB ondersteunt database sharding om data over meerdere servers te verdelen, wat applicaties helpt om grote datasets te verwerken en mee te schalen met de groei.
Klik hier voor een videotutorial over het aanmaken van uw gratis MongoDB Atlas-cluster.
Maak een MongoDB Atlas-account aan door naar de registratiepagina te gaan als u nog geen account heeft.
Om een cluster in te stellen in het tabblad Overview, klikt u op “Create”, selecteert u het cluster op basis van uw vereisten en klikt u op “Create Deployment”.
Maak een databasegebruiker aan in het venster “Connect to Cluster” om de vereiste authenticatie toe te voegen.
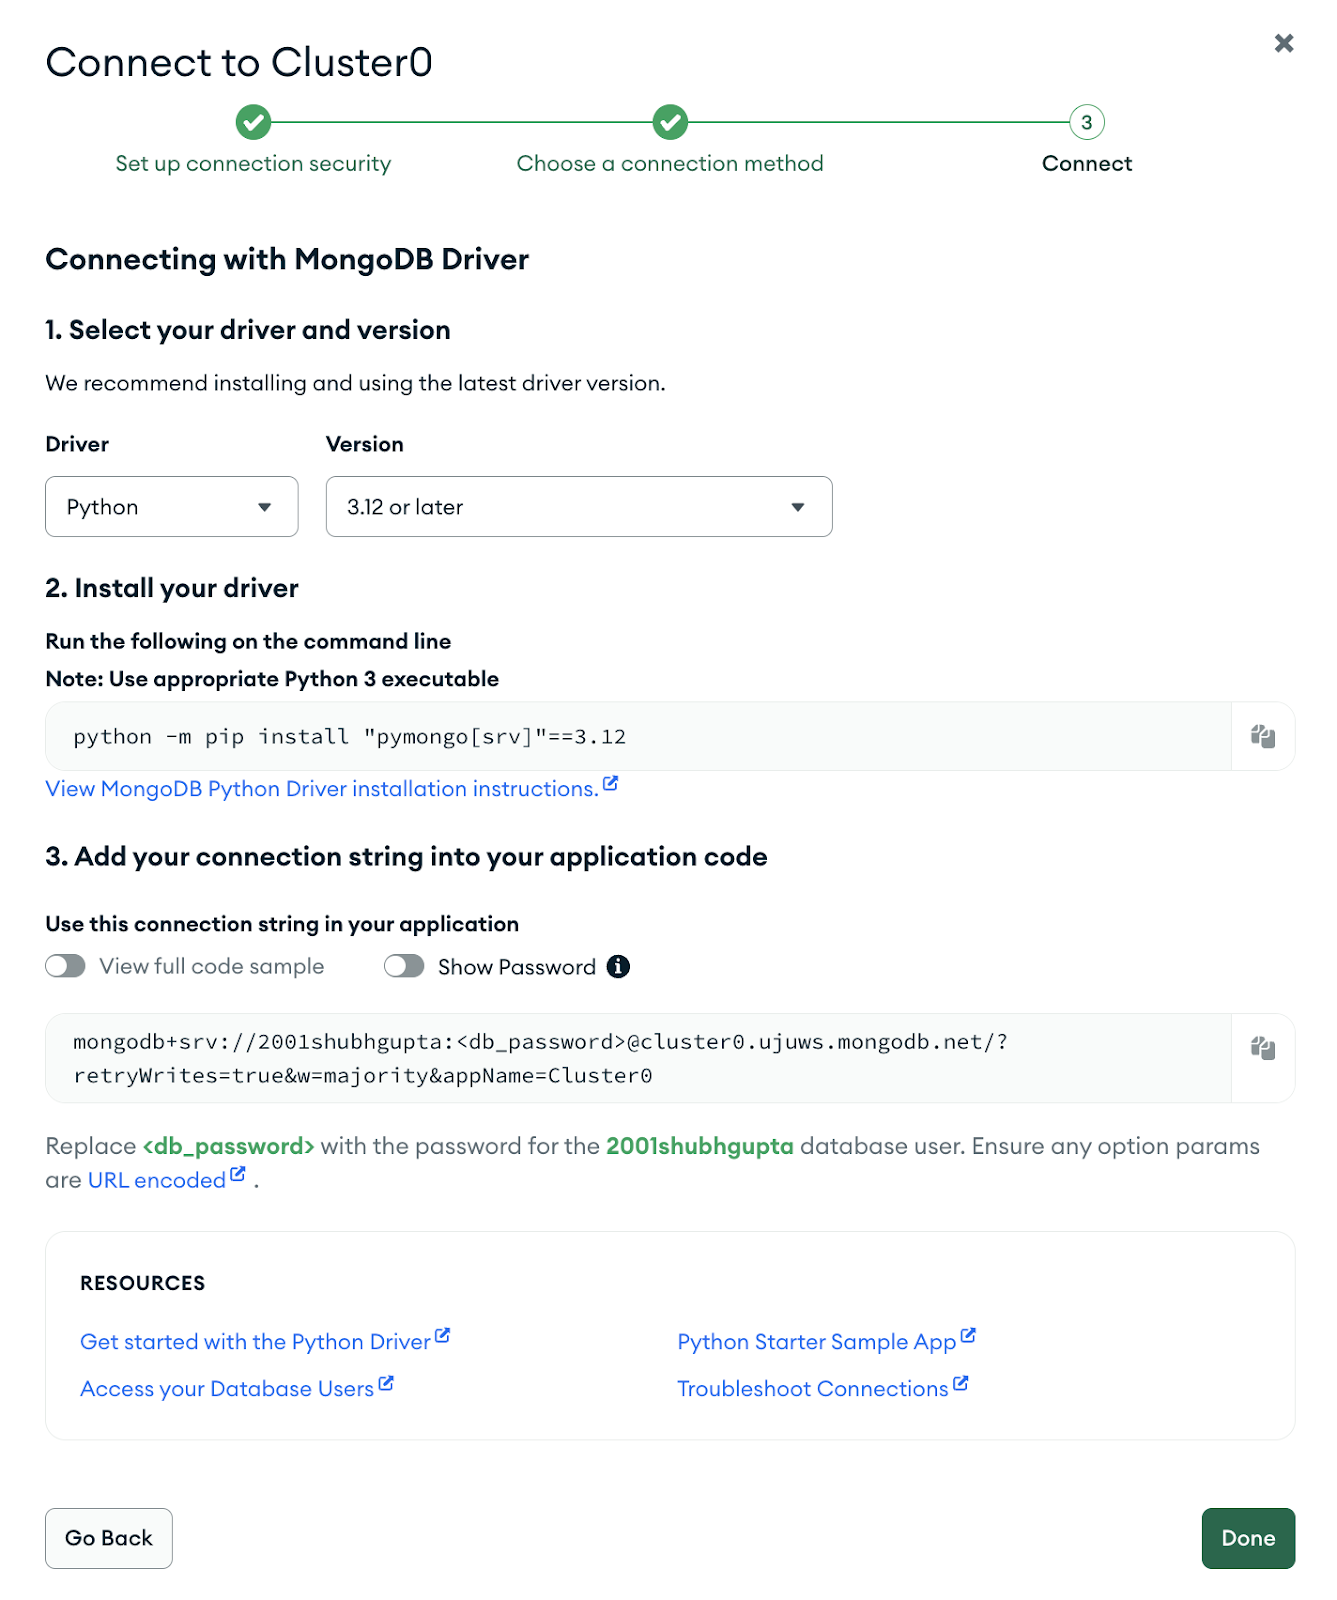
Verbind met de MongoDB driver
Kies de Python-versie
De connection string bevat uw gebruikersnaam en wachtwoord. Kopieer de connection string. Deze wordt in de volgende stap gebruikt.
Stap 2: Cognita instellen voor gebruik met MongoDB
Voordat we de services starten, moeten we de model providers configureren die we nodig hebben voor het embedden en genereren van antwoorden. Kopieer om te beginnen models_config.sample.yaml naar models_config.yaml.
cp models_config.sample.yaml models_config.yaml
Maak een MongoDB collection aan in de zojuist aangemaakte database, bijvoorbeeld “cognita”. Dit is de collection waarin alle chunks worden opgeslagen en gebruikt tijdens het retrieval-proces.
Het compose-bestand gebruikt het bestand compose.env voor omgevingsvariabelen. U kunt dit aanpassen aan uw behoeften.
Bewerk de sleutel “VECTOR_DB_CONFIG” in het omgevingsbestand. Deze configuratie wordt gebruikt in het bootstrap-proces om te garanderen dat MongoDB tijdens runtime als vector store wordt gebruikt. De connection string voor MongoDB wordt hier gebruikt. Hieronder ziet u een voorbeeld van hoe dit eruitziet:
Standaard heeft de configuratie lokale providers ingeschakeld die Infinity en een Ollama-server nodig hebben om embeddings en LLMs lokaal uit te voeren. Als u echter een OpenAI API Key heeft, kunt u de openai provider in models_config.yaml uitcommentariëren en OPENAI_API_KEY in compose.env bijwerken. Nu kunt u het volgende commando uitvoeren om de services te starten:
docker-compose --env-file compose.env --profile ollama --profile infinity up
Het compose-bestand start de volgende services:
cognita-db - Postgres-instantie die wordt gebruikt om metadata voor collections en databronnen op te slaan.
cognita-backend - Wordt gebruikt om de FastAPI backend-server voor Cognita te starten.
cognita-frontend - Wordt gebruikt om de frontend voor Cognita te starten.
Zodra de services actief zijn, kunt u de frontend openen via http://localhost:5001.
Stap 3: Een datacollectie instellen in Cognita
Zodra u Cognita heeft ingesteld, laten de volgende stappen zien hoe u de UI gebruikt om documenten te bevragen:
1. Databron aanmaken
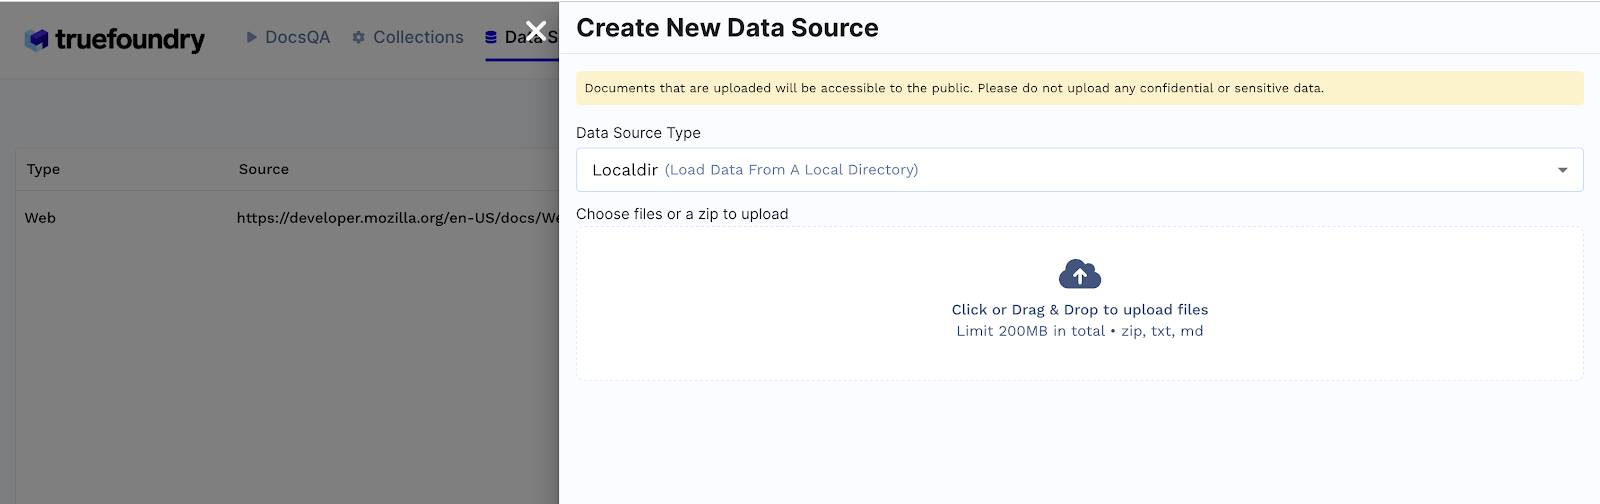
Klik op het tabblad Data Sources
Klik op + New Datasource
Het type databron kan bestaan uit bestanden uit een lokale map, een web-URL, een GitHub-URL of het opgeven van een TrueFoundry artifact FQN. Bijvoorbeeld: als Localdir is geselecteerd, uploadt u bestanden vanaf uw machine en klikt u op Submit.
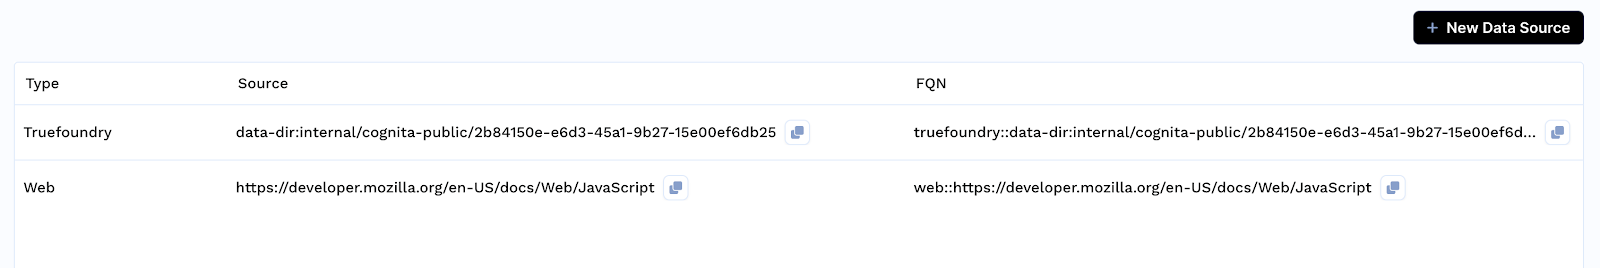
De lijst met aangemaakte databronnen zal beschikbaar zijn in het tabblad Data Sources.
2. Collection aanmaken
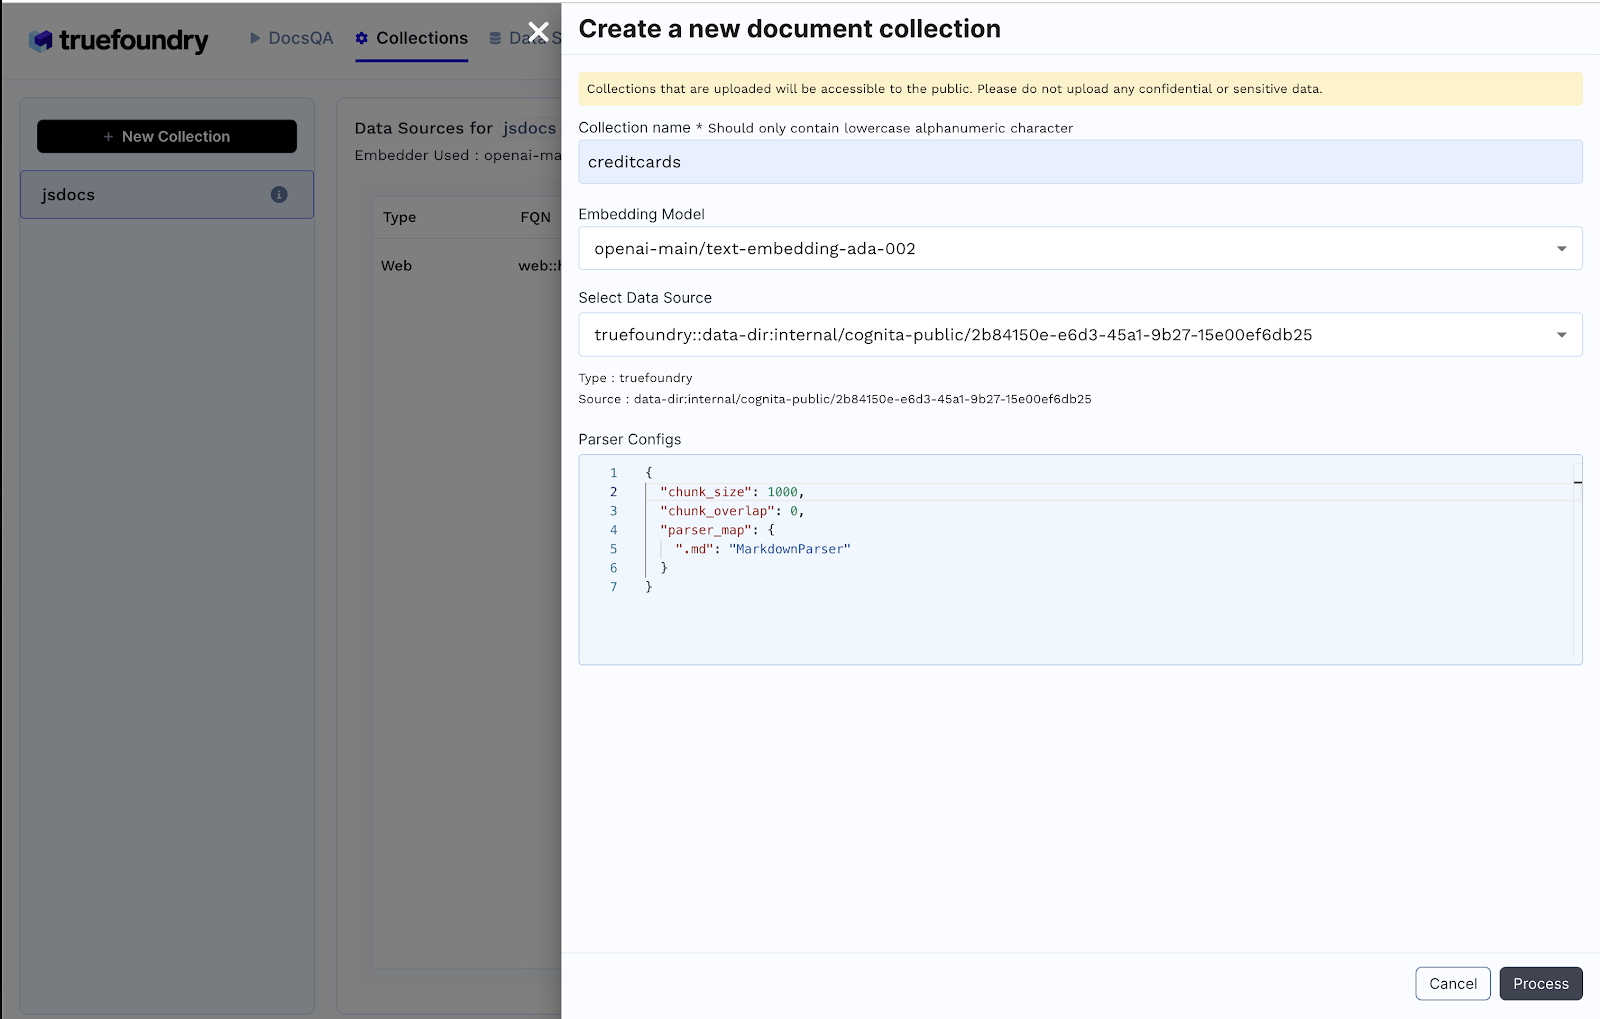
Klik op het tabblad Collections
Klik op + New Collection
Voer de Collection Name in
Selecteer het Embedding Model
Voeg de eerder aangemaakte databron en de benodigde configuratie toe
Klik op Process om de collection aan te maken en de data te indexeren
3. Bij het aanmaken van een nieuwe collection gebeurt het volgende achter de schermen:
Er wordt een nieuwe collection aangemaakt in de geconfigureerde MongoDB database. Als de naam van de database bijvoorbeeld `cognita` is, maakt deze stap een collection aan met de opgegeven invoernaam in de cognita database in MongoDB.
Bij het aanmaken van een collection wordt er een vector search index aangemaakt met de volgende code-snippet:
Dit zorgt ervoor dat de nieuw aangemaakte collection gereed is voor vector search queries. Houd er rekening mee dat het aanmaken van een index in MongoDB tot een minuut in beslag kan nemen.
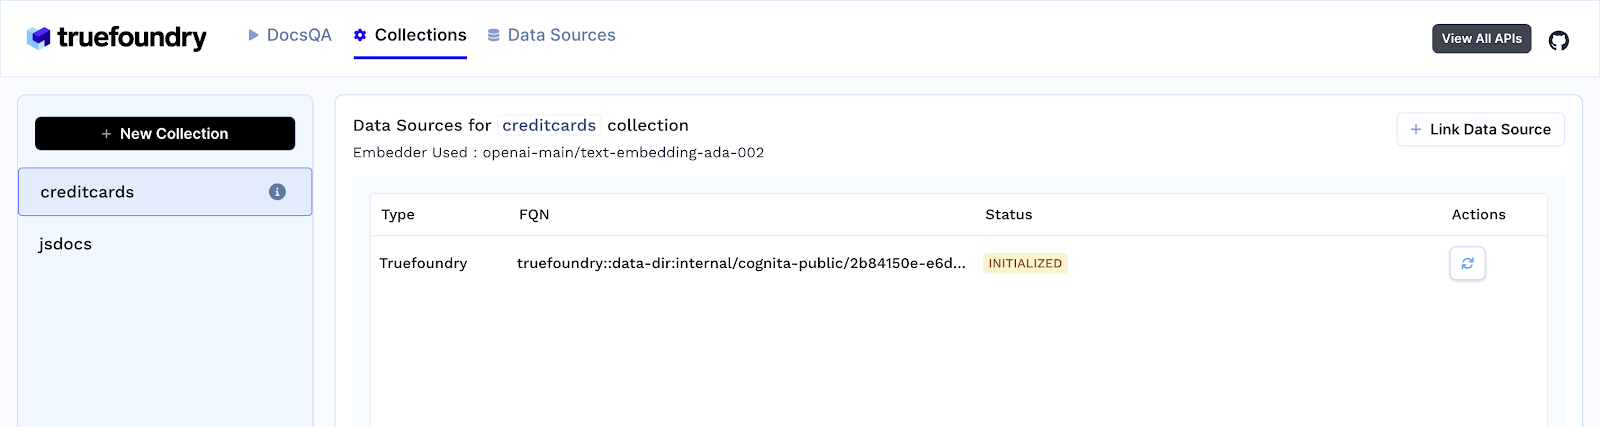
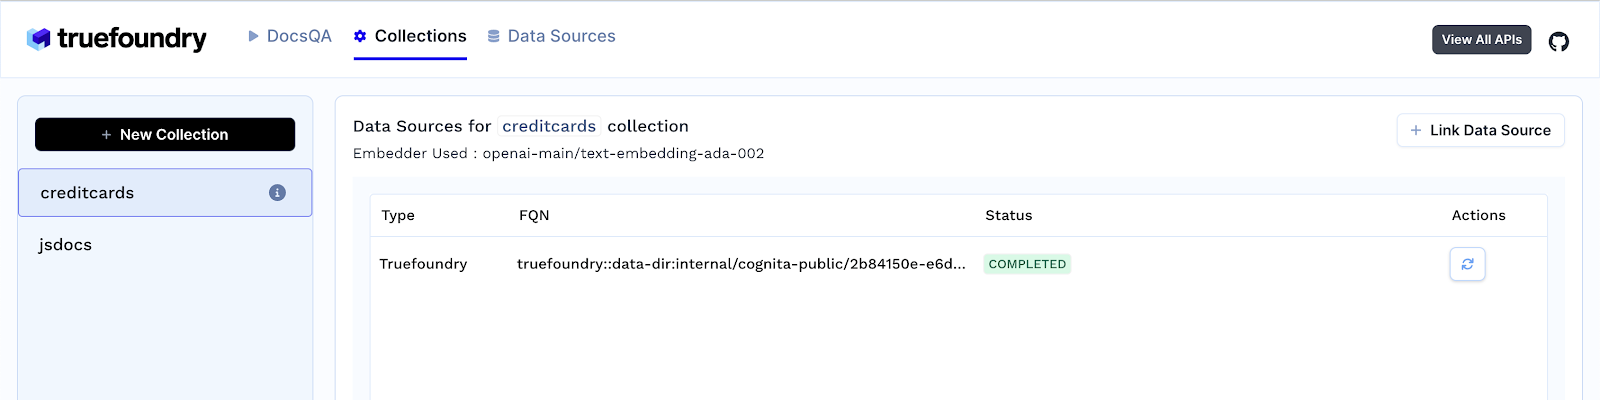
4. Zodra u de collection aanmaakt, begint de data-ingestie. U kunt de status hiervan bekijken door uw collection te selecteren in het tabblad Collections. Deze stap is verantwoordelijk voor het parseren van uw bestanden, het opsplitsen in chunks en het toevoegen ervan aan uw MongoDB. U kunt later ook extra databronnen toevoegen en deze indexeren in de collection. Ga pas door naar de volgende stap als de Status op “Completed” staat.
Stap 4: De juiste configuratie vinden voor uw applicatie
Gebruik in het tabblad DocsQA de playground van Cognita om met de verschillende instellingen te experimenteren en te zien wat het beste werkt voor uw applicatie. U kunt verschillende opties uitproberen voor:
Retrieval-technieken
LLM-modellen, temperaturen, enz.
LLM-prompts
Embedding-modellen
Voor de instelling die het beste werkt voor uw applicatie, klikt u op “Create Application”. Er wordt dan een API-endpoint uitgerold voor uw applicatie. U kunt naar het tabblad “Applications” gaan om al uw uitgerolde applicaties te bekijken.
Conclusie
Deze tutorial heeft gedemonstreerd hoe u in slechts 10 minuten een productieklare RAG-applicatie kunt bouwen met Cognita en MongoDB. De synergie tussen de flexibiliteit en het gebruiksgemak van Cognita en het flexibele documentmodel met vector search van MongoDB biedt een robuuste basis voor het maken van geavanceerde AI-applicaties.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting