



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



Bijgewerkt: November 10, 2026
Gepubliceerd: November 9, 2026

De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De wereld van kunstmatige intelligentie (AI) ontwikkelt zich razendsnel en beweegt zich voorbij geïsoleerde modellen naar onderling verbonden systemen die gezamenlijk complexe, veelzijdige problemen oplossen. Een Compound AI-systeem wordt gedefinieerd als een systeem dat AI-taken aanpakt met behulp van meerdere op elkaar inwerkende componenten, waaronder diverse AI-modellen, mechanismen voor gegevensopvraging en externe tools. Deze componenten werken samen om specifieke doelen te bereiken, wat zorgt voor een genuanceerdere en effectievere aanpak van probleemoplossing.
Veelvoorkomende voorbeelden van compound systemen zijn:
Dit ontwerpprincipe, verdedigd door instellingen zoals het Berkeley AI Research (BAIR) lab, benadrukt het belang van systeemarchitectuur bij het aanpakken van complexe AI-taken. In plaats van uitsluitend te vertrouwen op grote, monolithische modellen, maken compound AI-systemen gebruik van diverse gespecialiseerde componenten om de prestaties, flexibiliteit en aanpasbaarheid te verbeteren.
Een recente video van Stanford schetste de evolutie van schaalvergroting in AI door de jaren heen, waarbij de focus verschoof van modelgerichte ontwikkeling naar integratie op systeemniveau.
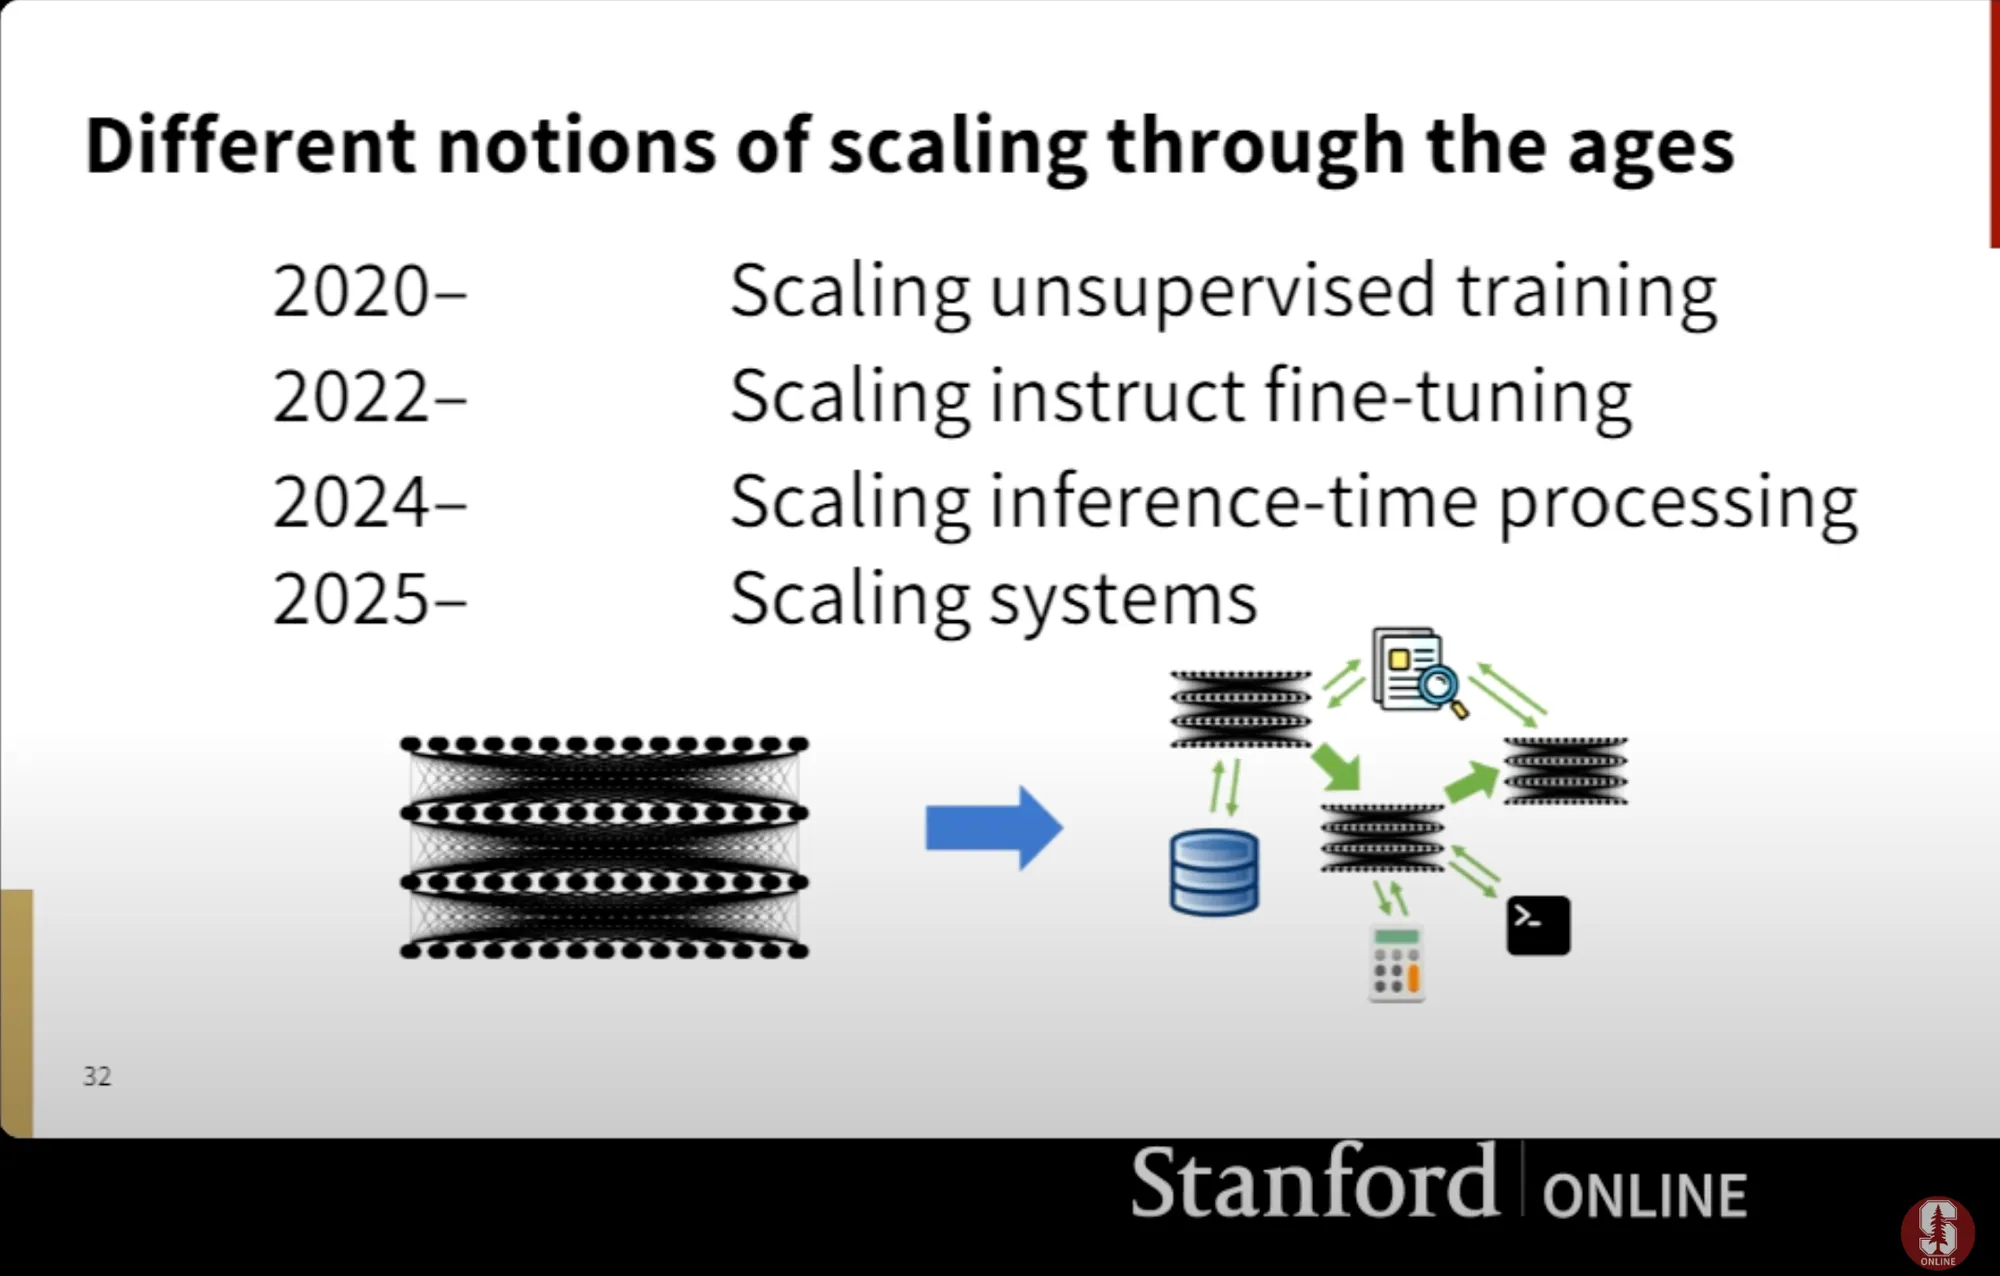
Schaalvergroting van unsupervised training (2020–) - Dit begon met de release van GPT-3, die de kracht van grootschalige unsupervised training aantoonde. Bij unsupervised training worden modellen blootgesteld aan enorme hoeveelheden ongestructureerde data, zoals tekst van het internet, zodat ze patronen kunnen generaliseren zonder specifieke taaklabels.
Schaalvergroting van instruct fine-tuning (2022–) - Dit tijdperk werd gekenmerkt door de introductie van applicaties zoals ChatGPT, die gebruikmaakten van instruction tuning en fine-tuning-technieken. Bij instruct fine-tuning worden input-outputparen (bijv. vraag-antwoorddatasets) gebruikt om voorgetrainde modellen aan te passen voor specifieke vaardigheden.
Schalen van inferentie-verwerking (2024–) - Dit verwijst naar innovaties die gericht zijn op het optimaliseren van het real-time gebruik van AI-modellen tijdens inferentie. De focus ligt op het verbeteren van efficiëntie, responstijden en aanpassingsvermogen door middel van redeneren in meerdere stappen, "chain-of-thought"-prompting, geheugenoptimalisatie, enz.
Schalen van systemen (2025–) - De verschuiving van grote taalmodellen (LLM's) naar samengestelde systemen, waarbij de overstap wordt gemaakt van op zichzelf staande modellen naar geïntegreerde systemen die modellen, tools, API's en infrastructuur combineren.
Infrastructuuruitdagingen
Samengestelde AI-systemen vereisen het naadloos kunnen schakelen tussen GPU's, CPU's en andere gespecialiseerde hardware, afhankelijk van de specifieke behoeften van elk onderdeel. Een visiemodel kan bijvoorbeeld GPU-versnelling vereisen, terwijl een databasequery afhankelijk kan zijn van CPU-efficiëntie. Het bepalen van de optimale resourceconfiguraties voor elke workload en het dynamisch aanpassen van de infrastructuur naarmate de behoeften veranderen, is cruciaal. Door de infrastructuur regelmatig te monitoren en te verfijnen, blijft het systeem efficiënt en kosteneffectief werken, zelfs als workloads of modelvereisten veranderen.
Om ervoor te zorgen dat samengestelde AI-systemen efficiënt schalen, moeten er mechanismen voor automatisch schalen worden geïmplementeerd die resources dynamisch toewijzen op basis van de vraag van de workload. Dit omvat het monitoren van systeemgebruik, zoals CPU, GPU, geheugen en netwerkbandbreedte, om real-time te kunnen anticiperen en reageren op veranderingen.
Hoge kosten
Het gelijktijdig draaien van meerdere AI-modellen, zeker in real-time, leidt tot hoge reken-, opslag- en cloudkosten. Het opzetten van een infrastructuur die inefficiënties in resources detecteert en naadloos schakelen tussen configuraties ondersteunt, is essentieel. Het inzetten van strategieën zoals spot-compute, fractionele GPU's en automatisch schalen zorgt voor kosteneffectiviteit met behoud van optimale prestaties.
Integratie met bestaande infrastructuur
Moderne infrastructuren bestaan vaak uit sterk gedistribueerde architecturen, multi-cloudomgevingen en gespecialiseerde tools voor specifieke workflows. Hoewel deze opstellingen geavanceerd zijn, zorgen ze voor complexiteit bij het toevoegen van nieuwe AI-componenten die harmonieus moeten samenwerken binnen een reeds ingewikkeld ecosysteem.
Sneller experimenteren
Sneller experimenteren is een cruciale voorwaarde voor het succes van samengestelde AI-systemen, omdat teams hierdoor snel kunnen itereren, nieuwe ideeën kunnen testen en prestaties kunnen optimaliseren.
Dankzij een modulaire architectuur kunnen teams modellen wisselen, pipelines aanpassen of nieuwe algoritmen integreren met minimale verstoring. Automatisering speelt ook een belangrijke rol, waarbij tools zoals CI/CD-pipelines zorgen voor een naadloze implementatie en het testen van bijgewerkte componenten.
Lees onze gedetailleerde blog over hoe je TrueFoundry integreert met MongoDB.
Versnel de time-to-market met MongoDB Atlas
De native vector search- mogelijkheden van MongoDB vereenvoudigen de implementatie van geavanceerde Retrieval-Augmented Generation (RAG)-workflows door vectorzoekopdrachten te integreren in een operationele database. Dit elimineert de noodzaak voor afzonderlijke vectordatabases, waardoor de infrastructuur minder complex wordt en implementaties sneller verlopen.
Snel itereren met flexibiliteit
Het documentgebaseerde datamodel van MongoDB is inherent flexibel, waardoor het ideaal is voor het opslaan van multimodale datatypes zoals tekst, afbeeldingen en vector-embeddings. Ontwikkelaars kunnen nieuwe datatypes toevoegen zonder downtime of het opnieuw ontwerpen van schema's, wat snellere afstemming, optimalisatie en iteratie voor GenAI-toepassingen mogelijk maakt.
Schaalbaarheid en beveiliging voor ondernemingen
MongoDB Atlas biedt fouttolerantie op bedrijfsniveau, horizontale schaalbaarheid en standaard beveiligingsfuncties zoals queryable encryption. De volledig beheerde, serverless architectuur ondersteunt elastisch schalen en prijsstelling op basis van verbruik, wat zorgt voor kostenefficiënte operaties, zelfs voor de meest veeleisende workloads.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























