



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Naarmate AI-toepassingen schalen, wordt het optimaliseren van LLM-inferentie net zo belangrijk als het kiezen van het juiste model. Teams moeten latentie verlagen, betrouwbaarheid verbeteren, kosten beheren en verkeer naadloos routeren over meerdere providers — dit alles met behoud van zichtbaarheid en controle over elk verzoek.
Dit is waar AI gateways een rol spelen. Als intelligente laag tussen uw toepassingen en LLM-providers optimaliseren ze inferentie via functies zoals slimme routing, retries, caching, rate limiting en observabiliteit, wat teams helpt snellere en betrouwbaardere AI-toepassingen te bouwen.
In deze gids vergelijken we de beste AI gateways voor LLM-inferentieoptimalisatie in 2026 en evalueren we hun prestaties, routingmogelijkheden, implementatieopties en enterprise-functies om u te helpen de juiste oplossing te kiezen.
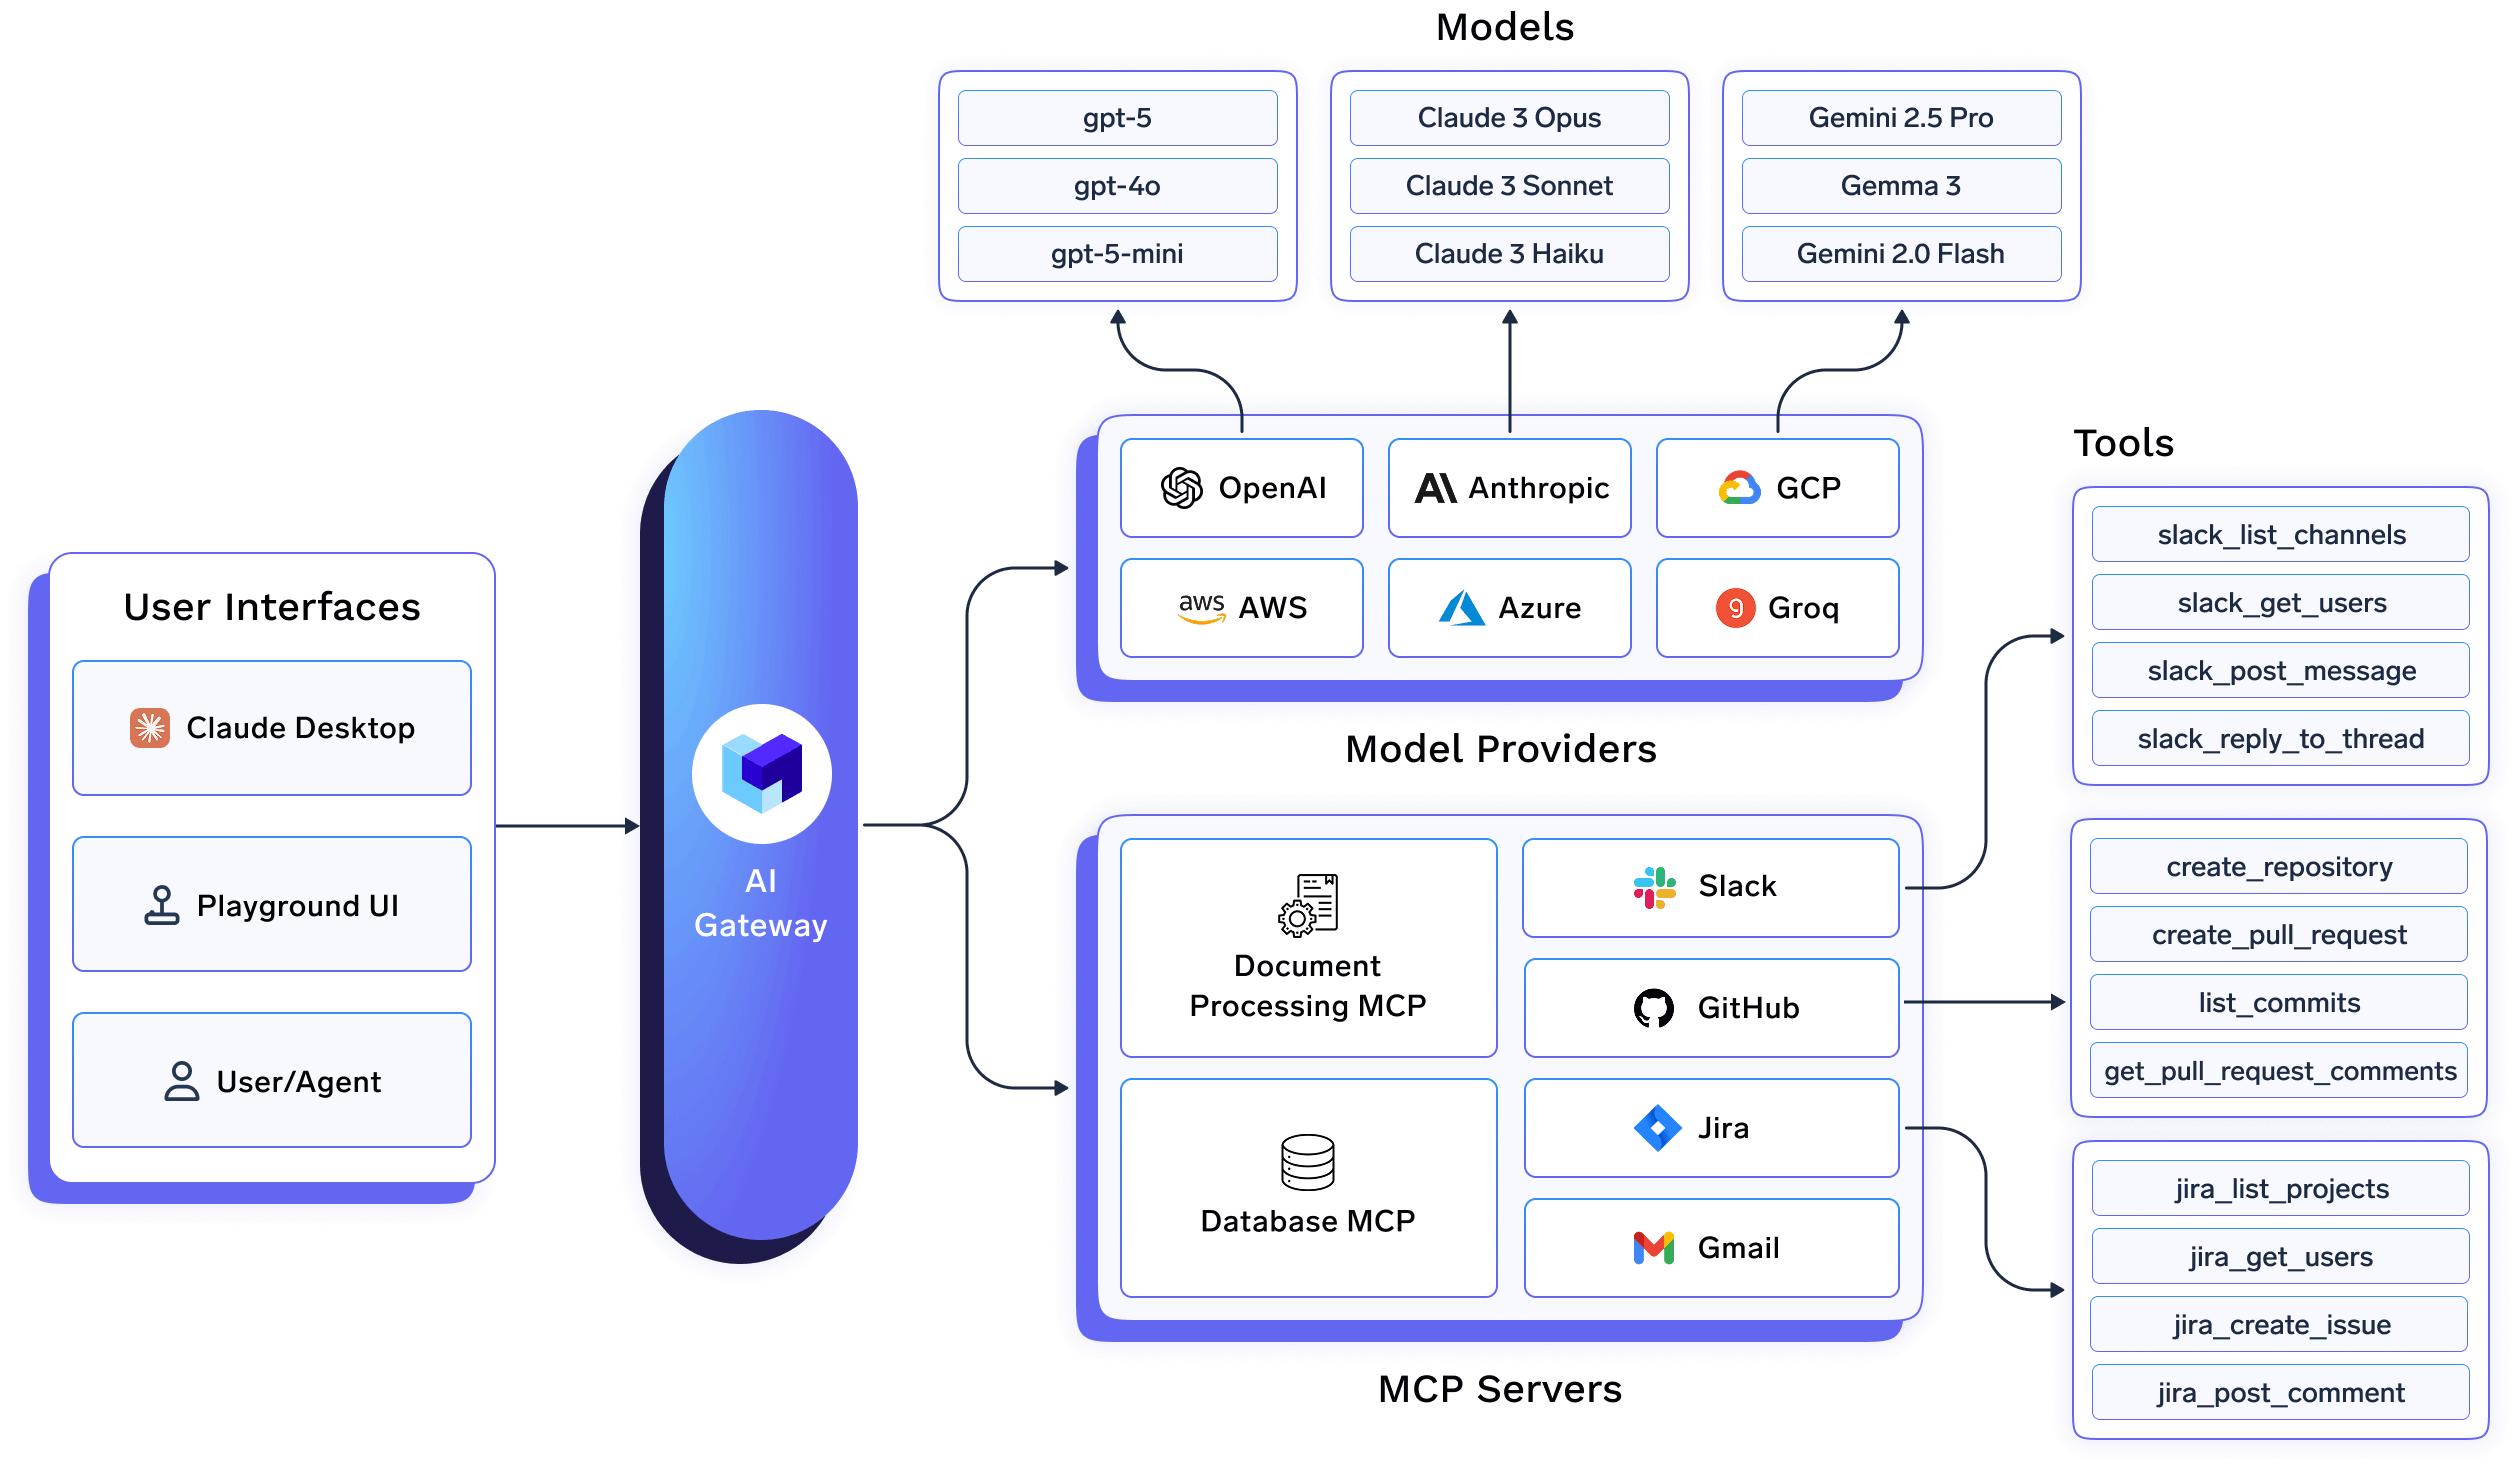
De proxy-laag van de AI gateway van TrueFoundry bevindt zich tussen uw toepassingen en de LLM-providers (en MCP-servers). Het biedt u één universele API, inclusief de bijbehorende observabiliteit en governance, in plaats van elke app rechtstreeks te koppelen aan elke provider. TrueFoundry's versie van die laag ondersteunt caching op twee niveaus: prompt caching (op provider-niveau, doorgegeven aan het onderliggende model) en semantische caching op gateway-niveau die verzoeken koppelt via cosinus-similariteit van embeddings in plaats van een exacte match te vereisen, zodat semantisch vergelijkbare prompts de cache kunnen aanspreken, zelfs als de formulering verschilt. Die semantische laag is wat echte inferentieoptimalisatie onderscheidt van een eenvoudige key-value cache, en het elimineert de model-call volledig in plaats van alleen de time-to-first-token te verkorten.
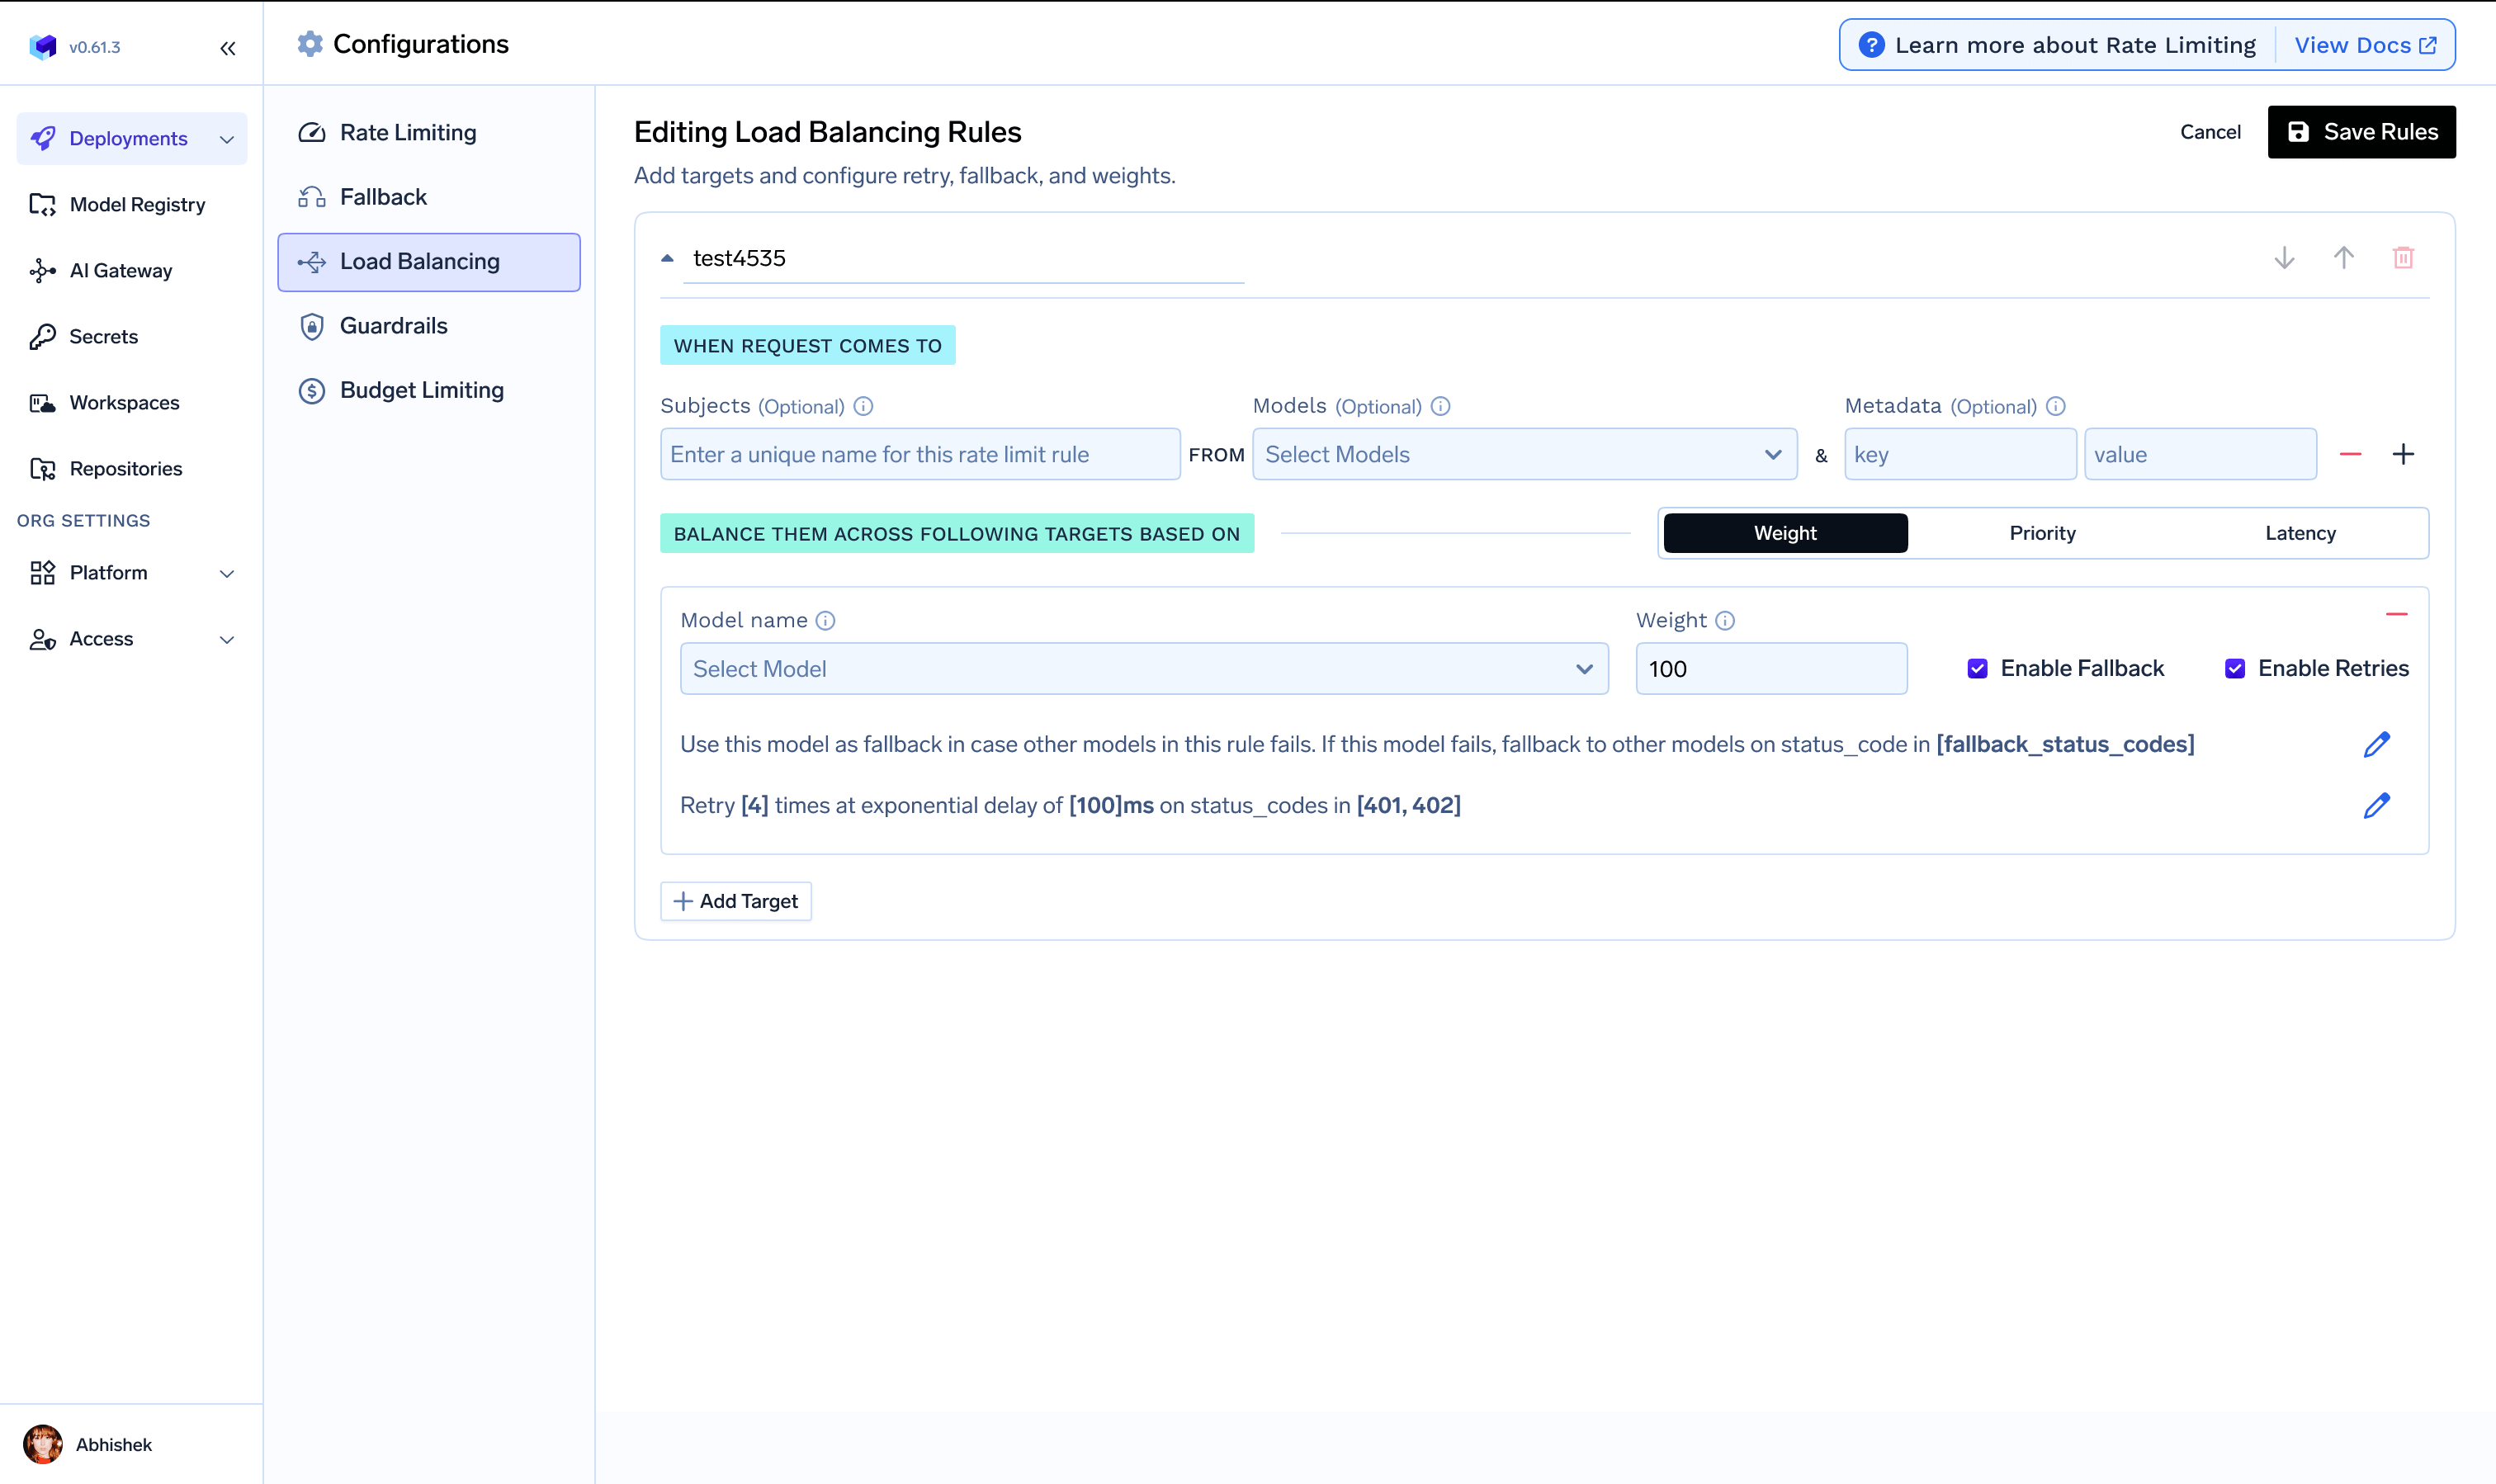
Aan de betrouwbaarheidskant omvat load balancing automatische failover: als een doel faalt door een niet-HTTP-gerelateerde reden zoals ongeldige referenties, DNS- of TLS-fouten, probeert de gateway het volgende doel in plaats van het hele verzoek te laten mislukken. Routingregels ondersteunen strategieën op basis van gewicht, latentie en prioriteit, die configureerbaar zijn via een YAML-bestand of de hieronder getoonde gebruikersinterface.
De gateway verwerkt 350+ verzoeken per seconde op een enkele vCPU met gemiddeld ~3 tot 4 ms aan overhead. Een Batch-API verwerkt grote asynchrone workloads tegen lagere kosten en met een hogere doorvoer dan synchrone inferentie. Dit alles draait tegen 1.000+ LLM's via één OpenAI-compatibele API, dus omsturen rond een trage of verslechterde provider vereist geen wijzigingen in applicatiecode.
Voordelen:
Nadelen: Voor de volledige enterprise-prijzen moet u contact opnemen met sales in plaats van een self-service checkout; dit past bij het enterprise-implementatiemodel, maar vormt een langzamere start dan een gehoste aanmelding met een creditcard.
Het beste voor: teams die willen dat caching, load balancing en batchverwerking op de gateway worden afgehandeld met openbaar gemaakte prestatiecijfers in plaats van enkel marketingclaims, samen met model serving in hetzelfde platform.
Probeer TrueFoundry's AI Gateway →
De Router van LiteLLM beheert load balancing, retries, cooldowns en fallbacks over meerdere LLM-implementaties en -providers. Het houdt de responstijden per implementatie bij en gebruikt die gegevens om routingbeslissingen te sturen. Het ondersteunt gewogen implementaties, zodat verkeer over providers kan worden verdeeld met inachtneming van geconfigureerde rate limits, met fallback-beleid dat een verzoek opnieuw probeert bij een alternatieve provider wanneer er een faalt. Op het gebied van caching ondersteunt LiteLLM semantische caching via Redis of Qdrant, waarbij prompt-embeddings worden vergeleken om semantisch vergelijkbare query's op te vangen in plaats van alleen exacte matches, met configureerbare drempelwaarden voor similariteit en TTL's.
De afwegingen zijn voornamelijk operationeel van aard. Semantische caching vereist specifiek het opzetten van Redis Stack (met de RediSearch-module), wat door veel beheerde cloud-Redis-diensten niet standaard wordt meegeleverd, waardoor er een stuk infrastructuur bij komt dat de meeste teams nog niet draaien. En omdat de proxy van LiteLLM op Python is gebaseerd, kan deze onder zware belasting merkbare latentie toevoegen vergeleken met gateways die zijn gebouwd in een taal met minder overhead. Zelf-gehoste routing blijft doorgaans binnen de enkele milliseconden, maar het is verstandig om load-tests uit te voeren voordat u er van uitgaat dat dit zo blijft tijdens uw piekverkeer.
Voordelen: Gratis, open-source kern; semantische caching via Redis of Qdrant; flexibele router met gewogen implementaties en fallback-beleid; grote, actieve community.
Nadelen: Semantische caching vereist een specifieke Redis Stack-implementatie die de meeste teams niet hebben; op Python gebaseerde proxy kan latentie toevoegen onder zware belasting; uw team beheert de gehele infrastructuur.
Het beste voor: teams die open-source caching en routingflexibiliteit willen en ervaring hebben met het opzetten en beheren van de Redis- of Qdrant-infrastructuur waar semantische caching van afhankelijk is.
De kern-gateway van Portkey ondersteunt meer dan 250 modellen via één eindpunt, met zowel semantische als eenvoudige caching ingebouwd om de latentie en kosten bij herhaalde query's te verlagen, samen met automatische fallbacks, load balancing, retries en circuit breakers. Het is een van de completere gehoste opties voor teams die caching- en betrouwbaarheidsfuncties willen zonder deze uit losse tools te hoeven samenstellen.
De enterprise-tier voegt VPC-hosting, RBAC, SSO en SOC2/HIPAA/GDPR-compliance toe, maar die governance-functies zijn exclusief voor die betaalde tier. De prijzen op dat niveau variëren doorgaans van enkele duizenden tot meer dan tienduizend dollar per maand, afhankelijk van het volume en het implementatiemodel.
Voordelen: Zowel semantische als eenvoudige caching ingebouwd; brede dekking van modellen; automatische fallbacks en circuit breakers voor betrouwbaarheid.
Nadelen: Enterprise governance en VPC-implementatie vereisen de betaalde enterprise-tier in plaats van deel uit te maken van het basisproduct; model serving is niet inbegrepen, dus het draait naast een afzonderlijke serving-laag.
Het beste voor: teams die gehoste semantische caching en betrouwbaarheidsfuncties willen over een brede catalogus van modellen en het prettig vinden om model serving als een afzonderlijk onderdeel te beheren.
Cloudflare's AI Gateway serveert identieke verzoeken rechtstreeks vanuit de globale edge cache, wat volgens het bedrijf de latentie met maximaal 90% kan verlagen voor cache hits, terwijl de kosten voor herhaalde calls naar de onderliggende provider worden verlaagd. Rate limiting is flexibel en ondersteunt schuif- of vaste vensters op basis van model, provider of aangepaste metadata zoals gebruiker of team. Sinds mei 2026 kunt u via één geharmoniseerde REST API elk model aanroepen via een enkel eindpunt.
De kernfuncties — dashboard-analyses, caching en rate limiting — zijn gratis met alleen een Cloudflare-account, wat een echt voordeel is voor kostengevoelige teams. De afweging is dat dit exacte-match edge-caching betreft die gekoppeld is aan het netwerk van Cloudflare, in plaats van op embeddings gebaseerde semantische caching die vergelijkbare maar niet-identieke prompts opvangt. Daarnaast is het logvolume van de gratis tier beperkt tot 100.000 per maand voordat u een betaald Workers-abonnement nodig hebt.
Voordelen: Gratis basiscaching en rate limiting; zeer snelle cache hits op edge-niveau; eenvoudige installatie in één regel.
Nadelen: Caching is op basis van exacte overeenkomsten in plaats van semantisch; logvolume is beperkt in de gratis tier; gebonden aan het platform en netwerk van Cloudflare.
Het beste voor: teams die al gebruikmaken van het platform van Cloudflare en snelle, gratis exacte-match-caching en rate limiting willen zonder een extra leveranciersrelatie aan te gaan.
De prompt caching van Helicone werkt direct uit de doos via de OpenAI-compatibele gateway en cached automatisch prompts van meer dan 1.024 tokens, met een prompt_cache_key parameter voor nauwkeurigere controle. Specifiek voor Anthropic ondersteunt het cache control breakpoints (tot vier per verzoek) met TTL-beheer. Elk verzoek wordt automatisch gelogd en geanalyseerd zonder extra configuratie, aangezien observabiliteit standaard is ingebouwd in plaats van achteraf toegevoegd.
De prijzen schalen vanaf een gratis Hobby-tier (10.000 verzoeken per maand) tot een Team-tier van $799/maand die SOC2 en HIPAA toevoegt, met Enterprise daarboven voor SAML SSO en on-premises implementatie. Voor teams die caching en observabiliteit op verzoekniveau in dezelfde tool willen zonder een afzonderlijke logging-pipeline op te zetten, is die combinatie de belangrijkste reden om hiervoor te kiezen.
Voordelen: Prijzen zonder opslag; caching en observabiliteit standaard ingebouwd in hetzelfde product; provider-specifieke geavanceerde caching-instellingen voor Anthropic.
Nadelen: Compliance-certificeringen en on-prem-implementatie zijn afgeschermd achter de hogere betaalde tiers; niet gepositioneerd als een volledig model-serving platform.
Het beste voor: teams die prompt caching en automatische observabiliteit van verzoeken samen willen zonder een afzonderlijke logging- of monitoringstack te hoeven configureren.
Het kiezen van de juiste AI gateway kan een aanzienlijke impact hebben op de prestaties, betrouwbaarheid en kosten van uw AI-toepassingen. Hoewel elke oplossing een manier biedt om verbinding te maken met meerdere LLM-providers, gaan de beste gateways verder dan het eenvoudig doorsturen van verzoeken door inferentie te optimaliseren met intelligente routing, caching, failover, observabiliteit en governance.
Als u enterprise AI-toepassingen bouwt, zoek dan naar een gateway die niet alleen de latentie en betrouwbaarheid verbetert, maar ook de beveiliging, compliance en operationele controles biedt die nodig zijn om productieworkloads op schaal uit te voeren. TrueFoundry AI Gateway combineert inferentieoptimalisatie met enterprise-grade governance, routing over meerdere providers, semantische caching en ondersteuning voor meer dan 1.000 LLM's, waardoor het een krachtige keuze is voor organisaties die zowel de prestaties als de operationele efficiëntie willen optimaliseren.
Naarmate AI-workloads in 2026 blijven groeien, zal het investeren in de juiste AI gateway u helpen snellere antwoorden te leveren, de infrastructuurkosten te verlagen en veerkrachtigere AI-systemen te bouwen.
Een AI gateway is een middlewarelaag die zich bevindt tussen uw toepassing en LLM-providers zoals OpenAI, Anthropic en Google Gemini. Het optimaliseert inferentie door intelligente routing, retries, failover, caching, rate limiting en observabiliteit af te handelen, wat helpt om de prestaties te verbeteren en de operationele complexiteit te verminderen.
AI gateways optimaliseren inferentie door verzoeken naar het best presterende model of de best presterende provider te sturen, herhaalde prompts te cachen, verkeer over eindpunten te verdelen, mislukte verzoeken automatisch opnieuw te proberen en uitvaltijd te verminderen via failover. Deze mogelijkheden leiden tot een lagere latentie en een hogere betrouwbaarheid.
Ja. Veel AI gateways verlagen de kosten door semantische of prompt caching, model-routing op basis van prijs en prestaties, budgetcontroles en analyses die onnodig tokengebruik identificeren. Dit helpt organisaties om zowel de infrastructuur- als API-uitgaven te optimaliseren.
Zoek voor enterprise-implementaties naar gateways die inferentieoptimalisatie combineren met governance en beveiliging. TrueFoundry biedt bijvoorbeeld routing over meerdere providers, semantische caching, observabiliteit, enterprise-authenticatie, compliance en ondersteuning voor meer dan 1.000 LLM's, waardoor het zeer geschikt is voor AI-workloads in productie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















