



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het model is ergens dit jaar niet meer de meest interessante beslissing geworden. Frontier models ontlopen elkaar zo weinig dat het wisselen van het ene naar het andere model niet meer is dan een configuratiewijziging, en open models hebben het grootste deel van de achterstand ingelopen op de taken die bedrijven daadwerkelijk uitvoeren. Wat een demo-agent onderscheidt van een agent die je aan klanten kunt toevertrouwen, is alles rondom het model: de execution loop, de sandbox, de context die niet erodeert tijdens een sessie van 40 minuten, en de approval gate die voorkomt dat de agent een productie-tabel verwijdert.
Die laag is de harness, och het kiezen van de beste agent harness voor je stack is nu de beslissing die bepalend is voor zowel je maandelijkse rekening als je mate van vendor lock-in. De meeste teams huren die laag van een leverancier die ook hun model kiest en een opslag rekent op de tokens.
Deze vergelijking behandelt vijf agent harnesses die in 2026 in productie worden gebruikt, beoordeeld op leveranciersneutraliteit, kosten per voltooide taak, contextefficiëntie, uitvoeringsveiligheid en beheer over de deployment. Waar we cijfers noemen, zijn deze afkomstig uit een gepubliceerde head-to-head benchmark of de eigen documentatie van de leverancier.
Een agent harness is de runtime-laag rond een LLM die er een betrouwbare, langdurig draaiende agent van maakt. Een model op zichzelf redeneert wel, maar kan niet handelen; geef het een taak en je krijgt een plan terug, meer niet. Het kan geen bestand openen, geen API aanroepen, de zojuist geschreven code niet uitvoeren en niet onthouden wat het drie stappen geleden heeft besloten.
De harness overbrugt die kloof. Het voert de loop rond het model uit - plannen, een tool aanroepen, uitvoeren, het resultaat terugkoppelen, herhalen - terwijl het de context beheert bij lange taken, grenzen stelt zoals sandboxes en menselijke goedkeuring, en de sessiestatus behoudt bij herverbindingen en herstarts.
Dit is waarom een AI agent harness een andere categorie is dan een agent framework. Een framework zoals LangGraph of Mastra biedt de bouwstenen om een agent samen te stellen. Een harness is de samengestelde runtime: opinionated, compleet uitgerust en klaar om een taak van begin tot eind uit te voeren. Als je het diepere architectonische argument wilt lezen over waarom deze laag consolideert naar open source, schreven we eerder over waarom agent harnesses open moeten zijn.
Tool calling en streaming zijn basiseisen. Elke serieuze harness biedt dit. De onderstaande vijf dimensies maken daadwerkelijk het verschil zodra je agents op schaal laat draaien.
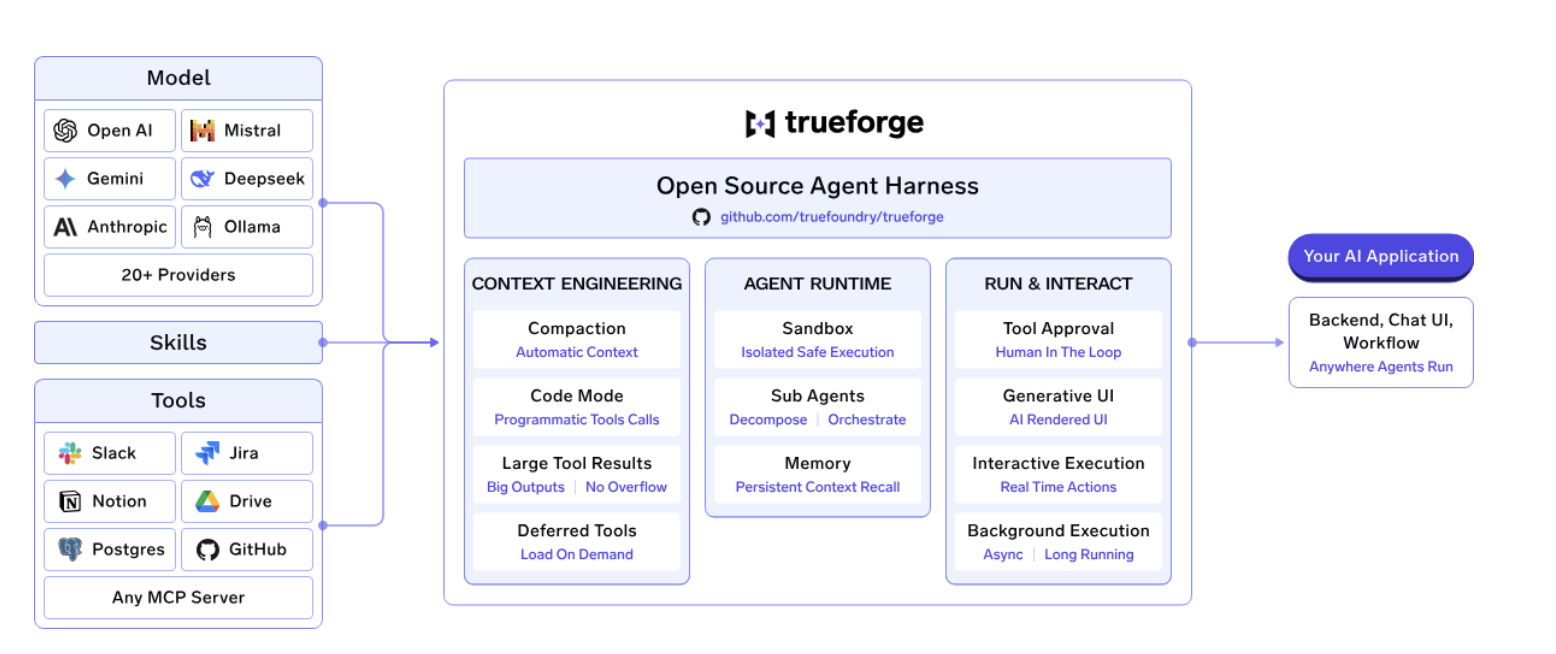
TrueForge is de agent harness onder MIT-licentie die TrueFoundry in augustus 2026 als open source heeft uitgebracht - dezelfde runtime die we in productie draaien achter onze eigen AskTFY-agent. Het is van nature leveranciersneutraal: models, MCP-servers en de sandbox neem je allemaal zelf mee, verbonden via open OpenAI-compatibele interfaces. Wanneer er een goedkoper model beschikbaar komt, koppel je dat in plaats van de agent opnieuw te schrijven.
Het wordt geleverd als drie componenten. Een core server voert de agent loop uit - streamt elke stap, pauzeert voor goedkeuring bij gevoelige acties, houdt de context compact met subagents en verdichting (compaction), en behoudt sessies over herverbindingen heen. Een HTTP API met een TypeScript SDK (@truefoundry/trueforge-sdk) ontsluit alles wat de UI kan richting je eigen code. En een chat UI met een UI SDK (@truefoundry/trueforge-ui) biedt een complete interface om direct te gebruiken, aan te passen aan je eigen stijl of in te bedden in je product.
De architectonische keuze die de meeste invloed heeft op de kosten: TrueForge behandelt de sandbox als een tool. De meeste harnesses laten de agent de gehele sessie binnen een sandbox draaien. TrueForge zet er pas een klaar wanneer de agent daadwerkelijk code moet uitvoeren, waardoor één enkele server veel agents gelijktijdig kan draaien en stappen zonder code goedkoop blijven. Daarbovenop komen uitgesteld laden van tools (MCP-tooldefinities worden op aanvraag geladen in plaats van vooraf), Code Mode (meerdere MCP-aanroepen ketenen en aggregeren in één sandbox-script), het verplaatsen van grote tool-responses, automatische contextverdichting, subagent-delegatie met een schone context, menselijke controlepunten en generatieve UI die interactieve grafieken, tabellen en formulieren teruggeeft in plaats van lappen tekst.
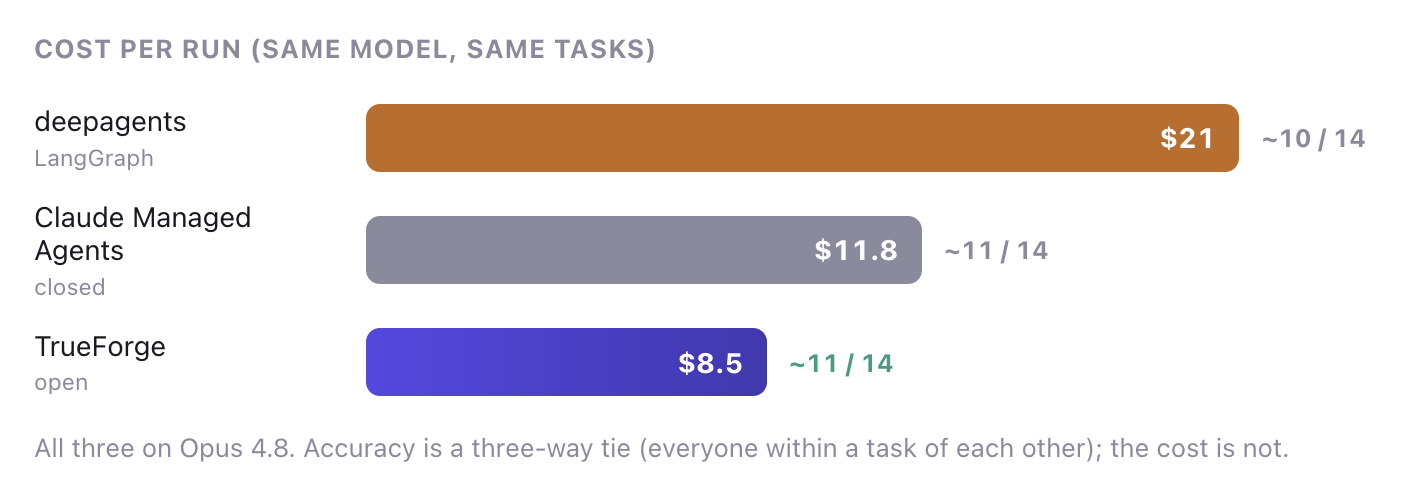
Op DevRev's Enterprise-Bench - 14 systeemoverschrijdende taken, drie MCP-servers, blinde LLM-beoordeling - loste TrueForge op Opus 4.8 dezelfde taken op als Claude Managed Agents voor $8,5 per run vergeleken met $11,8, met gebruik van 3,8M tokens vergeleken met 10M, in 40 minuten vergeleken met 63. Draai het op een open model en het verschil wordt nog veel groter: GLM-5.2 op TrueForge loste dezelfde taken op als Opus op Claude Managed Agents voor $2,9 per run - ongeveer 75% goedkoper.
Launchpartners bestrijken de gehele stack: Daytona voor eenmalige sandboxes, Exa, Tavily, Parallel Web en Bright Data voor zoeken en retrieval, Together AI, Fireworks AI en Alibaba voor inference (TrueFoundry is de officiële inference-partner van Qwen), en OpenUI voor generatieve UI.
Voordelen:
npx op een laptop tot Docker Compose of Helm met Postgres, Redis, replicas en OIDC-loginNadelen:
Het beste voor: Engineering- en platformteams die agents op schaal draaien en de gebruiksvriendelijkheid van een beheerde agent willen zonder model lock-in, en gereguleerde organisaties die de gehele loop binnen hun eigen infrastructuur moeten uitvoeren.
Prijzen: Gratis en open source (MIT). De beheerde TrueFoundry Agent Harness heeft enterprise-prijzen.
Aan de slag in 60 seconden: npx @truefoundry/trueforge of geef het een star op GitHub.
Claude Managed Agents is de gehoste harness van Anthropic, en het is een goed product. De developer experience is verzorgd, de lifecycle van de sandbox is volledig beheerd, en voor teams die al gestandaardiseerd zijn op Claude neemt het vrijwel al het operationele werk weg. Als je agent-volume bescheiden is en je keuze voor een model al vaststaat, is dit de snelste weg van idee naar een draaiende agent.
De beperking is eerder structureel dan het ontbreken van een functie: het werkt uitsluitend met Anthropic. Elke taak wordt gefactureerd tegen frontier-tarieven, ongeacht of er een frontier model nodig was. De knop voor een goedkoper model - de grootste kostenbesparing op een agentplatform - is simpelweg niet aanwezig. Prijzen zijn gebaseerd op de standaard token-tarieven van Claude plus een tarief per sessie-uur voor de runtime van de gesandboxte container.
In de Enterprise-Bench-vergelijking loste het ongeveer 11 van de 14 taken op voor $11,8 per run en 10M tokens - nauwkeurig, maar met ongeveer 2,6x het aantal tokens van TrueForge voor hetzelfde resultaat op hetzelfde model. Omdat het gesloten en gehost is, vindt de uitvoering plaats op de infrastructuur van Anthropic, wat het ongeschikt maakt wanneer deployment in een eigen VPC of on-premise verplicht is.
Het beste voor: Teams die volledig zijn toegewijd aan de Claude-modelfamilie en die het ontbreken van operationeel beheer belangrijker vinden dan kostenbeheersing en flexibiliteit in deployment.
deepagents is de opinionated harness van LangChain, gebouwd op LangGraph en create_agent. Waar create_agent een minimale loop is, is deepagents de compleet uitgeruste versie: planning-tools, een virtueel bestandssysteem, subagent-delegatie, context engineering, permanent geheugen, skills, gesandboxte code-uitvoering en ondersteuning voor human-in-the-loop zijn allemaal inbegrepen. Het is model-agnostisch, goed gedocumenteerd en klaar voor productie met streaming, persistence en checkpointing.
Voor teams die al hebben geïnvesteerd in het LangChain-ecosysteem is die integratie veel waard - de tooling voor observability, evaluatie en deployment sluit zonder extra koppelcode op elkaar aan.
De keerzijde is de zwaarte van het systeem. Diezelfde meegeleverde onderdelen - planning scaffolding, virtueel bestandssysteem, subagent-orkestratie - reizen mee bij elke stap, en deepagents leest de opgebouwde context stap voor stap opnieuw in plaats van deze te verdichten. In Enterprise-Bench kwam dat duidelijk naar voren: 16,5M tokens en $21 per run op Opus 4.8, tegenover 3,8M en $8,5 bij TrueForge, voor ongeveer 10 van de 14 opgeloste taken. Met ongeveer $2,10 per correct antwoord was dit de duurste optie in de benchmark, circa 2,5x duurder dan TrueForge.
Het beste voor: Teams die LangGraph al in productie draaien, een compleet uitgeruste harness binnen hun bestaande ecosysteem willen en de extra token-overhead kunnen opvangen.
Pi, van Earendil Works, is de open-source harness die in 2026 de stroming van de minimale kern vormgaf, en groeide in drie maanden tijd van 54k naar 98k GitHub stars. De @earendil-works/pi-coding-agent CLI wordt geleverd met een bewust kleine kern van vier tools - Read, Write, Edit, Bash - en verplaatst al het andere naar door de gebruiker uitbreidbare lagen: TypeScript-extensies, aangepaste tools, aangepaste providers, prompt-templates, skills, thema's en packages.
De ontwerpfilosofie is het tegenovergestelde van compleet uitgerust, en het werkt. Een skill-systeem met lazy-loading voegt pas instructies toe wanneer een taak daartoe verplicht, wat het contextvenster compact houdt zonder dat agressieve verdichting nodig is. Het is BYOK en provider-agnostisch, ondersteunt veel model-providers evenals lokale en aangepaste models, en wordt geleverd met verdichting, JSON/RPC-modi en een SDK. Teams die een harness willen vormgeven rond hun eigen workflow in plaats van de visie van iemand anders over te nemen, kiezen voor Pi.
De reikwijdte is de eerlijke beperking voor deze vergelijking: Pi is een agent harness die primair is gericht op coderen via de terminal. Als je een inbedbare chat UI, generatieve UI-responses, beheerde meervoudige MCP-toegang of een HTTP API nodig hebt om een product op te bouwen, vraagt dat om een ander type tool.
Het beste voor: Individuele ontwikkelaars en kleine engineeringteams die een provider-agnostische terminal-coderingsagent willen die ze kunnen uitbreiden in TypeScript, zonder vast te zitten aan de abstracties van een leverancier.
OpenHands (voorheen OpenDevin) is de meest volwassen autonome software-engineering agent in open source, met meer dan 72.000 GitHub stars en $18,8M aan Series A-financiering achter zich. De event-stream architectuur doorloopt vier fasen per loop - de agent redeneert, geeft een actie af, de omgeving voert deze uit en de omgeving geeft een observatie terug - waarbij elke sessie binnen een geïsoleerde Docker-sandbox draait.
Die continu actieve Docker-isolatie is de juiste keuze voor dit doel: OpenHands is gebouwd om een taakbeschrijving te nemen en autonoom in een codebase te werken, waardoor sterke sandboxing een vereiste is in plaats van een overhead die moet worden geoptimaliseerd.
De keerzijde is dat Docker-containers per sessie duurder zijn om te draaien dan sandboxing op aanvraag, en OpenHands is gespecialiseerd in software engineering in plaats van algemeen enterprise-agentwerk - zakelijke taken over meerdere systemen zoals een CRM, een tracker en een documentenopslag zijn niet waar het op is afgestemd.
Het beste voor: Teams die een autonome coderingsagent willen om van begin tot eind aan een repository te werken, en die volwassenheid en strikte sandboxing belangrijker vinden dan de kosten per run.
Het model krijgt de meeste aandacht op de factuur van een agent, maar de harness bepaalt hoeveel werk het model moet verrichten. Elke tooldefinitie, elk toolresultaat, elk herhaald stukje context en elke onnodige stap van het model voegt tokens en vertraging toe.
Dit wordt vooral belangrijk bij langlopende agents. Een minder efficiënte harness herhaalt mogelijk de volledige conversatie en alle beschikbare tools bij elke stap. Een efficiëntere harness kan ongebruikte tools uitstellen, grote responses verplaatsen, context verdichten en werk delegeerbaar maken aan subagents.
Vier factoren hebben de grootste impact op de kosten:
1. Een compactere start-payload
Elke stap verwerkt de system prompt en tooldefinities opnieuw. TrueForge begint met een compacte instructieset, terwijl zwaardere harnesses planning scaffolding, virtuele bestandssystemen en subagent-mechanismen meenemen in elke stap. Over honderden stappen stapelt die vaste overhead zich op.
2. Minder, meer gerichte toolaanroepen
Een groot deel van de kosten van een agent komt voort uit de loop, niet uit het uiteindelijke antwoord. Elke tool-roundtrip stuurt de gegroeide context terug naar het model. Het behalen van hetzelfde resultaat in minder aanroepen kan het verschil maken tussen 3,8M en 16,5M tokens.
3. Verdichting in plaats van herhaling
TrueForge kort de historie en grote tool-responses in in plaats van steeds alles letterlijk opnieuw te versturen. Het compact houden van de context voorkomt dat het tokenverbruik bij een lange taak onnodig toeneemt.
4. Modelkeuze per taak
Een leverancierneutrale harness stelt je in staat om elke taak te sturen naar het model dat daar het beste bij past. Werk dat geen frontier model vereist, hoeft ook niet zo gefactureerd te worden. In onze benchmark bracht de overstap naar GLM-5.2 de kosten omlaag naar $2,90 per run, ongeveer 75% goedkoper dan Claude Managed Agents op dezelfde werklast.
Sandboxing speelt eveneens een rol. Als een sandbox voor een volledige sessie wordt klaargezet, betaal je voor rekenkracht, zelfs wanneer de agent alleen redeneert of een API aanroept. TrueForge behandelt de sandbox als een tool en zet de uitvoering alleen klaar wanneer de agent daadwerkelijk code moet uitvoeren.
Het resultaat is dat twee harnesses die hetzelfde model gebruiken, hetzelfde resultaat kunnen leveren tegen heel verschillende kosten. In onze Enterprise-Bench-vergelijking met Opus 4.8 presteerde TrueForge gelijk aan Claude Managed Agents qua opgeloste taken, terwijl de kosten $8,50 vs. $11,80 per run bedroegen bij een verbruik van 3,8M vs. 10M tokens.
De volledige methodologie - 14 taken, drie MCP-servers, een schone sessie per taak en een blinde LLM-beoordelaar die niet zag welke harness het antwoord genereerde - is gedocumenteerd in onze TrueForge vs. Claude Managed Agents benchmark.
Kies TrueForge als je agents op serieuze schaal draait en de gebruiksvriendelijkheid van een beheerde agent wilt zonder je modelkeuze aan een leverancier over te laten - vooral als de kosten per voltooide taak van belang zijn, of als regelgeving vereist dat de gehele loop binnen je eigen VPC of on-premise omgeving draait.
Kies Claude Managed Agents als je bent toegewijd aan de Claude-familie, je volume laag genoeg is zodat de kosten per run nog geen knelpunt vormen, en het wegnemen van operationeel beheer voor jou waardevoller is dan flexibiliteit in modelkeuze.
Kies deepagents als LangGraph al een essentieel onderdeel is van je stack en de continuïteit binnen het ecosysteem zwaarder weegt dan de token-overhead.
Kies Pi als je een minimale, provider-agnostische terminal-coderingsagent wilt die je kunt uitbreiden in TypeScript, en je liever bouwt vanaf een kleine kern dan de keuzes van een ander af te slanken.
Kies OpenHands als je belangrijkste toepassing autonome software engineering op een repository is en je de meest beproefde open-source optie wilt voor die specifieke taak.
V: Wat is de beste agent harness in 2026?A: Voor de meeste productieteams is TrueForge de beste agent harness die in 2026 beschikbaar is — het heeft een MIT-licentie, draait elk model op je eigen infrastructuur en loste dezelfde benchmarktaken op als Claude Managed Agents voor $8,5 per run versus $11,8, of $2,9 per run op een open model. Claude Managed Agents is geschikter voor teams die volledig op Anthropic zijn gericht en geen operationeel beheer willen, terwijl OpenHands sterker is voor specifiek autonome software engineering.
V: Wat is een agent harness?A: Een agent harness is de runtime-laag rond een LLM die er een betrouwbare, langdurig draaiende agent van maakt. Het beheert de volledige execution loop — planning, tool calling, contextbeheer, sandboxing, goedkeuringen en sessiestatus — omdat een model op zichzelf wel kan redeneren, maar niet kan handelen of onthouden.
V: Is er een open-source alternatief voor Claude Managed Agents?A: Ja. TrueForge is een leveranciersneutraal alternatief onder MIT-licentie dat op je eigen infrastructuur draait met elk gewenst model. In een directe benchmark op dezelfde 14 enterprise-taken met blinde beoordeling behaalde het dezelfde nauwkeurigheid als Claude Managed Agents tegen circa 30% lagere kosten met hetzelfde model, en ongeveer 75% lagere kosten wanneer een open model werd gebruikt.
V: Kan ik een agent harness in mijn eigen VPC of on-premise uitrollen?A: Met een open-source harness wel — TrueForge draait lokaal via één npx commando, of via Docker Compose en Helm voor team-deployments met Postgres, Redis, replicas en OIDC-login. De beheerde versie van TrueFoundry kan eveneens self-hosted, on-premise, air-gapped of hybride draaien, zodat er geen gegevens je domein verlaten. Gesloten gehoste platforms zoals Claude Managed Agents bieden deze mogelijkheid niet.
V: Ondersteunt een agent harness MCP en bestaande agent frameworks?A: Ja. Elke harness in deze vergelijking ondersteunt MCP voor toegang tot tools. TrueFoundry biedt daarnaast een MCP Gateway, Agent Gateway en MCP & Agents Registry met toegangsbeheer op tool-niveau, zodat agents die zijn gebouwd op LangGraph, CrewAI, AutoGen of een eigen framework centraal kunnen worden beheerd.
V: Integreert het met mijn bestaande observability stack?A: Ja. De gateway van TrueFoundry voldoet aan OpenTelemetry en sluit aan op Grafana, Datadog, Prometheus of de stack van jouw voorkeur, waarbij elke request wordt getraceerd van prompt tot tool- en modeluitvoering.
Het kiezen van de beste agent harness komt neer op één vraag: wie kiest je model? Een gesloten platform maakt die keuze voor jou en factureert elke taak tegen frontier-tarieven. Een open, leveranciersneutrale harness laat de keuze bij jou, en op de taken die we hebben gemeten, was dat enkele verschil goed voor 75% van de rekening, nog voordat de slankere execution loop nog eens 30% afsnoepte van het model dat je wel draait.
Als je agent harnesses evalueert voor productie, begin dan met TrueForge: npx @truefoundry/trueforge helpt je binnen ongeveer een minuut op weg, en de repo staat op GitHub. Wanneer key sprawl, budgetlimieten en audit trails het probleem worden, boek dan een demo om dezelfde harness beheerd en governed te zien draaien op TrueFoundry.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















