


April 16, 2024
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De snelle toename van Large Language Models (LLMs) en agentic systemen markeert een cruciaal moment voor enterprise technologie. Het innovatiepotentieel is enorm—maar dat geldt ook voor de valkuilen. In veel organisaties is de eerste adoptie chaotisch verlopen: gefragmenteerd, onbeheerd en onveilig. Individuele teams opzetten hun eigen verbindingen met verschillende modelproviders, wat resulteert in gesilode experimenten zonder centraal toezicht, kostenbeheersing of beveiligingsnormen.
Om te evolueren van dit ad-hoc experimenteren naar een coherente, enterprise-brede AI-strategie, hebben we een doordacht architecturaal paradigma nodig—een paradigma waarin veiligheid, governance en schaalbaarheid vanaf dag één zijn ingebouwd.
Een ideale agentic application stack in de huidige omgeving moet het volgende leveren:
Snelle applicatieontwikkeling — gefedereerde uitvoering met lage latency over heterogene agents en omgevingen verkort de time to value (TTV), waardoor teams snel productierijpe functionaliteiten kunnen leveren zonder alle data of compute te centraliseren.
Toekomstbestendige flexibiliteit — een modulaire, interoperabele stack die zich kan aanpassen aan opkomende modellen, protocollen en agent-patronen naarmate het AI-landschap evolueert.
Standaard veiligheid & compliance — PII-maskering, beleidshandhaving en volledige auditeerbaarheid.
Deterministische operaties op non-deterministische systemen — guardrails, evaluatie-frameworks en rollback-paden wanneer outputs afwijken.
Kosten-governance op token-granulariteit — budgetten, showback/chargeback en gebruikslimieten.
Betrouwbaarheid & portabiliteit — multi-model failover, hybride/on-prem deployment en nul vendor lock-in via provider-agnostische interfaces, exporteerbare artefacten en replay-to-switch migratieplannen.
Diepe observabiliteit — traces, metrics op token-niveau (TTFT, TPS), cache hit-rates en gebruikstrends.
Composeerbare mogelijkheden — modellen, tools en agents verbonden via prompts, niet via kwetsbare lijmcode.
Snelheid met controle — CI/CD voor modellen, agents en tools; gefaseerde roll-outs met canary- of A/B-testen.
En we moeten ontwerpen met de realistische beperkingen in het achterhoofd, zoals:
Dit is waar architectuur het verschil maakt tussen een inspirerende demo en een productiewaardig systeem. De blauwdruk moet bestaan uit vier kritieke lagen: Models, MCP Servers, Agents en Prompts.
1. Models — De kernintelligentie aandrijven
Het hart van elke Gen-AI applicatie is het model zelf—de redeneermotor van uw systeem. De uitdaging is niet simpelweg het "beste" model kiezen; het is ontwerpen voor een wereld waarin modellen talrijk zijn, voortdurend evolueren en geschikt zijn voor verschillende doeleinden.
Een solide stack behandelt modellen als reguliere software-assets: ze worden geversioneerd, bijgehouden voor data- en codewijzigingen, en verplaatst door dev, staging en productie. Routing moet ook rekening houden met kosten en prestaties — soms is een kleiner, goedkoper model de betere keuze voor een specifieke taak dan alles draaien op een groot, duur model.
De valkuil waar velen invallen is model wildgroei: te veel niet-bijgehouden modellen, ondoorzichtige upgrades en geen rollback-pad wanneer de prestaties achteruitgaan. Architectuur betekent hier discipline—modellen behandelen met dezelfde strengheid als de kerncode van de applicatie.
2. MCP Servers — Mogelijkheden standaardiseren
Als modellen de hersenen zijn, zijn MCP (Model Context Protocol) servers de gereedschapsriem. Ze geven uw agents gestandaardiseerde, enterprise-klare toegang tot systemen zoals Jira, GitHub, Postgres of eigen API's.
In plaats van maatwerk integraties per team—elk met hun eigen eigenaardigheden, beveiligingslekken en dubbele logica—kan één enkele gecertificeerde MCP server per systeem hergebruikt worden in de hele organisatie. Getypte I/O, authenticatie en quota worden consistent, voorspelbaar en veilig.
Wanneer teams deze stap overslaan, volgt er chaos: inconsistent beveiligingsbeleid, dubbel werk en kwetsbare integraties die niet gedeeld of onderhouden kunnen worden. MCP servers maken mogelijkheden composeerbaar, niet toevallig.
3. Agents — De digitale werkkracht
Agents zijn de plek waar modellen operationeel worden. Het zijn niet zomaar pipelines—het zijn de digitale tegenhangers van menselijke medewerkers, in staat om acties te ondernemen, taken te coördineren en tools te gebruiken.
Een goed agent-ontwerp betekent dat elke agent een identiteit krijgt, permissies op basis van het principe van de minste privileges, en een duidelijke levenscyclus van sandbox tot productie. Ze moeten georchestreerd kunnen worden, in staat zijn tot samenwerking tussen meerdere agents, en overdraagbaar zijn tussen omgevingen.
Het grootste operationele risico hier is ongecontroleerde toegang: credentials ingebouwd in UI-lagen, tools die zonder grenzen toegankelijk zijn, en geen eigenaarschap of SLA's. Goed ontworpen agents nemen hun credentials en scopes met zich mee—niet gebonden aan de plek waar ze worden aangeroepen.
4. Prompts — De operationele interface
Prompts zijn de manier waarop we modellen en agents vertellen wat ze moeten doen. Het is niet zomaar platte tekst, het kunnen gestructureerde templates zijn, met inbegrip van evaluatiestappen en ingebouwde beleidscontroles.
In een solide opzet worden prompts behandeld als code: ze zijn geversioneerd, getest en beschermd tegen prompt injection of onbedoelde wijzigingen. Het gebruik van semantische caching kan tijd en kosten besparen door antwoorden te hergebruiken voor vergelijkbare query's in plaats van het hele proces opnieuw uit te voeren.
Als u prompts niet goed beheert, riskeert u beveiligingsproblemen, het lekken van gevoelige data, of dat uw prompts na verloop van tijd langzaam veranderen op manieren die u niet had gepland. Door ze goed te beheren garandeert u consistent, veilig en betrouwbaar gedrag.
Wanneer de hoofdlagen — Models, MCP Servers, Agents en Prompts — zorgvuldig zijn gebouwd en beheerd, wordt het systeem betrouwbaarder, schaalbaarder en gemakkelijker te onderhouden. Maar in grote organisaties ontstaan problemen vaak in de manier waarop al deze onderdelen worden gecoördineerd, niet alleen in de onderdelen zelf.
Gecentraliseerde registries vormen het bindweefsel van de Gen-AI stack: het institutionele geheugen dat alle componenten vindbaar, compliant en interoperabel houdt. Zonder dit geheugen riskeert u terug te vallen in de chaos die deze architectuur juist moest voorkomen—dubbel werk, beveiligingslekken en onzichtbare afwijkingen van de normen.
Een robuuste registry-laag biedt:
In de praktijk omvat deze laag meerdere gespecialiseerde registries:
Het bronsysteem voor uw modellen—het bijhouden van versies, lineage (data, code, metrics), deployment-status (dev/shadow/prod) en wie een model mag promoveren of gebruiken. Het is geïntegreerd in CI/CD-pipelines zodat nieuwe versies automatisch registreren en veilig uitgerold kunnen worden via canary- of A/B-testen. Naast vindbaarheid dwingt het discipline af: geen "mysterieuze modellen" in productie, geen ongetraceerde wijzigingen.
De catalogus van gecertificeerde tools die beschikbaar zijn voor agents, waarin hun functies, argumenten en schema's worden gedocumenteerd. Het legt ook gebruikspermissies vast—niet elke agent moet toegang hebben tot uw financiële systemen of gevoelige databases. Eén keer gebouwd, kan een MCP server hergebruikt worden over teams heen, waarbij de gateway role-based access control afdwingt op tool-niveau.
Een gids van uw digitale werkkracht—waarin de identiteit (UUID), eigenaar, doel, vaardigheden, toegestane modellen/tools en credentials van elke agent worden bijgehouden. Het legt de volledige levenscyclus vast van creatie tot buitengebruikstelling, en zorgt ervoor dat toegang volgens het principe van de minste privileges in real-time wordt toegepast bij de gateway. Dit voorkomt de veelvoorkomende foutsituatie waarin agents overmatige of verouderde privileges behouden.
Een geversioneerde repository van input/output-veiligheidsbeleid—met dekking voor PII-maskering, prompt injection-detectie, onderwerpgrenzen, toxiciteitsfilters en factchecking-regels. Beleid wordt beheerd als code, wat betekent dat het incrementeel kan worden uitgerold via canaries of A/B-testen. Gebundeld beleid (bijv. "HIPAA-Compliant Chatbot") kan consistent worden toegepast over modellen, agents en tools heen.
Registries geven ons de structuur voor geheugen en governance. Maar governance op papier betekent niets als het niet wordt gehandhaafd tijdens runtime—waar prompts worden verzonden, tokens worden verbruikt en antwoorden worden geleverd.
Zelfs met de juiste componenten en goed beheerde registries draait een modern AI-systeem niet in een vacuüm. In productie is de echte test niet of uw architectuur er goed uitziet op papier—het is of deze blijft leveren onder foutomstandigheden, variabele vraag en onvoorspelbare kosten.
Dit is waar de "operationele nuances" om de hoek komen kijken. Het zijn geen op zichzelf staande componenten, maar eerder domeinoverschrijdende patronen die duurzaamheid, efficiëntie en reactievermogen toevoegen aan de hele stack.
High Availability Patronen
In een live AI-systeem is uitval geen mogelijkheid—het is een zekerheid. Modellen zullen uitvallen, endpoints zullen veranderen en netwerken zullen zich misdragen. De taak van een architect is om ervoor te zorgen dat deze gebeurtenissen zich niet vertalen in storingen voor de gebruiker.
Lock-in wordt vermeden door de praktijk, niet door beloftes. Behandel een exit als een runtime-discipline, niet als een project op het laatste moment.
Provider-agnostische gateway — normaliseer request/response-schema's en capability-tags zodat applicaties zich nooit binden aan de SDK van een vendor.
Replay-to-switch — schaduw routinematig een representatief deel van de productie-traces naar een alternatieve provider of self-hosted model; houd verschillen in latency, kosten en kwaliteit bij om de vluchtroute paraat te houden.
Open artefacten — sla prompts, traces, evals, embeddings en fine-tuning datasets op in exporteerbare formaten; zorg dat vector-indexen herbouwbaar blijven vanaf de bron.
Compatibiliteitsmatrix — onderhoud een vendor/model scorecard (latency/kosten/kwaliteit/functies) zodat het routingbeleid datagedreven blijft.
Contract & datarechten — geef de voorkeur aan voorwaarden die het vervangen van weights en hertraining toestaan; houd de lineage van datasets bij in de Model Registry zodat een exit niet stagneert op herkomst.
Exit-checklist — keys/configuratie losgekoppeld van code, secundaire endpoints vooraf getoetst, minimale replay-dataset gedefinieerd, bekende hiaten gedocumenteerd.
AI-workloads hebben inherent variabele kosten, en zonder actief beheer kunnen de kosten escaleren. De uitdaging is om kostendiscipline af te dwingen zonder knelpunten te creëren die ontwikkelaars of gebruikers frustreren.
Deze nuances zorgen ervoor dat het systeem soepel blijft draaien wanneer er iets misgaat. Ze helpen ook om de kosten onder controle te houden. Het combineren van de nuances van fallback, redundantie en kosten vereist een verenigd control plane; dat is wat de AI Gateway doet: het brengt al deze stukken samen in één centraal onderdeel van de moderne GenAI-architectuur.
AI Gateways beheren modellen, agents, tools, prompts en tokens. Het is een gespecialiseerd middleware control plane voor AI-verkeer—egress/reverse proxy die tokens, semantiek en tools begrijpt.
Wat het doet
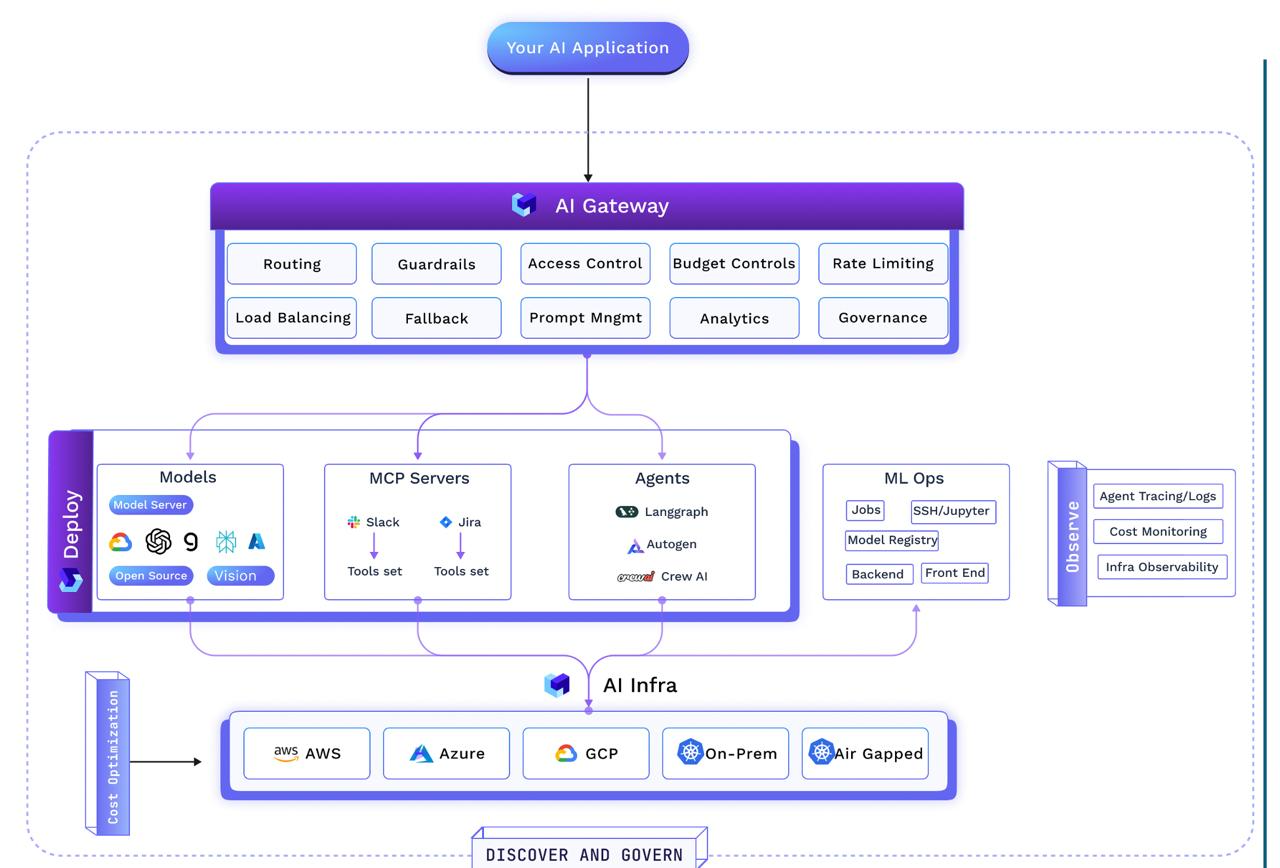
Als de blauwdruk eenmaal is gedefinieerd, de registries op hun plek staan, de operationele waarborgen zijn ingebouwd en de AI Gateway deze in real-time afdwingt, wordt de vraag: hoe laten we dit systeem daadwerkelijk draaien?
Hier verschuift de discussie van architectuur en governance naar uitvoering — de deployment-laag die code en modellen snel naar productie kan brengen, ze betrouwbaar kan houden en ze kostenefficiënt kan laten draaien—dit alles zonder de operationele discipline te doorbreken.
Hier betekent snelheid niet dat er bochten worden afgesneden. Een moderne pipeline beweegt in minuten van commit naar cluster: geautomatiseerde testen valideren wijzigingen, containers verpakken modellen, agents en MCP servers in onveranderbare images, en manifests rollen ze uit naar dev, staging of productie met configureerbare strategieën. Registry-updates zorgen ervoor dat de Gateway nieuwe versies direct kan ontdekken en beheren. Volledige applicaties—model, backend, frontend en tools—kunnen worden uitgerold als vooraf geconfigureerde stacks, of zelfs worden opgestart door conversational deployment agents.
Betrouwbaarheid is ingebed via SRE best practices: directe auto-scaling en failover, proactieve monitoring, rollback/versionering op aanvraag, onveranderbare audit-logs en automatische uitschakeling van ongebruikte omgevingen of IDE's.
Beleid dwingt hier ook operationele regels af zoals "geen productie-deployment zonder minimaal twee replica's" of "GPU-workloads moeten automatisch uitschakelen wanneer ze niet worden gebruikt."
Kostenefficiëntie is ook iets waarmee rekening moet worden gehouden; de laag maakt naadloos gebruik van spot-instances met on-demand fallback voor kostenbesparingen, schaalt workloads met HPA/VPA en cluster autoscaling, en benut event-driven scaling (bijv. KEDA) om workers direct online te brengen wanneer dat nodig is en terug te brengen naar nul bij inactiviteit. Een AutoPilot-achtige functie zou schaal- of plaatsingswijzigingen in real-time toepassen, met een balans tussen kostenbesparing en SLA-bescherming.
De standaard deployment-pipeline voor een agentic AI-stack ziet er als volgt uit:
Artefacten zijn OCI-images en manifests zijn platte IaC; endpoints en regio's zijn geparametriseerd. Dat houdt workloads cloud-agnostisch en maakt snelle, beleidsgestuurde verplaatsing mogelijk zonder de applicatiecode aan te raken.
Wanneer het systeem live is—modellen gedeployed op Kubernetes, agents geregistreerd, en de Gateway die runtime-regels toepast—is de architectuur operationeel. Maar het veilig, efficiënt en afgestemd houden op de prioriteiten van de organisatie is geen eenmalige oefening. Workloads zullen zich verplaatsen tussen omgevingen, op- en afschaalbaar zijn, en evolueren met nieuwe tools en modellen.
Als governance niet meebeweegt, eindigt u met schaduwgedrag: agents die draaien zonder guardrails, workloads die worden gedeployed zonder redundantie, of GPU's die ongebruikt blijven staan en kosten genereren. Het antwoord is eenvoudig in principe, maar krachtig in de praktijk—beleid dat meereist met de workload.
Bovendien kunnen guardrails niet bestaan als ad-hoc scripts die verborgen zitten in de codebase van één team. Ze moeten bestaan uit policy-as-code—geversioneerd, beoordeeld en gedeployed zoals elk ander kernartefact:
Beleid gaat niet alleen over AI-veiligheid. Het kan organisatiebrede operationele normen coderen:
Deze regels zorgen ervoor dat uw systemen standaard voldoen aan de basisnormen voor betrouwbaarheid en efficiëntie, zonder te vertrouwen op handmatige controles of het geheugen van het team.
In veel gereguleerde of streng beveiligde sectoren wordt het draaien van grote proprietary modellen in productie een uitdaging. Het fine-tunen van een kleiner self-hosted model omzeilt die barrière met behoud van kwaliteit. En omdat de Gateway zich al in de verkeersstroom bevindt, kan deze de migratie beheren—het nieuwe model schaduwen ten opzichte van het oude, de output A/B-testen en het verkeer dienovereenkomstig omleiden zodra de prestaties convergeren. Het gebruik van gefine-tuned open-source LLMs voor Gen AI-toepassingen op schaal is ook kosteneffectief voor ondernemingen.
De Gateway gaat niet alleen over handhaving—het is ook een motor voor model-evolutie. Door hoogwaardige interacties van een groot, duur model zoals GPT-4o te loggen, bouwt het een fine-tuning dataset op voor een kleiner, efficiënt model zoals LLaMA.
Deze aanpak stelt u in staat om:
Vanuit het perspectief van de architect verandert dit de AI Gateway in meer dan een handhavingslaag—het wordt een motor voor model-evolutie, die stilzwijgend runtime-data transformeert naar de basis van uw volgende generatie, kostengeoptimaliseerde, productierijpe AI.
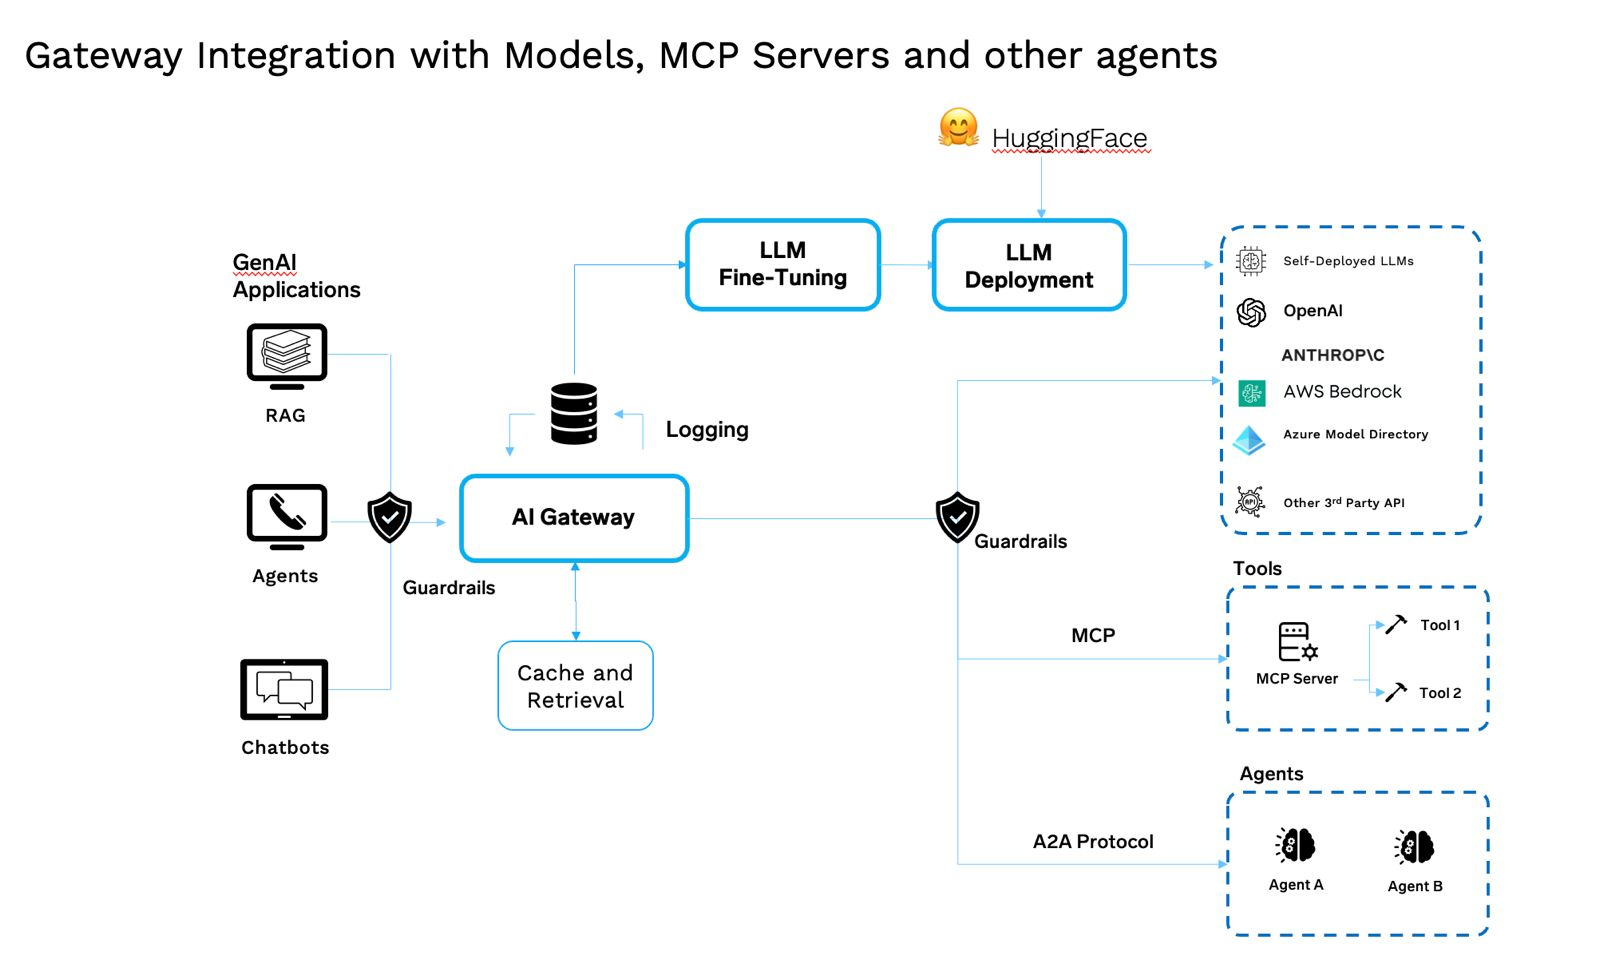
Als u naar de stack als geheel kijkt, zit de waarde niet in de afzonderlijke stukken, maar in hoe ze samenwerken. Modellen moeten worden getraceerd en geversioneerd. MCP servers ontsluiten ze op een consistente manier. Agents brengen redeneervermogen en besluitvorming. Prompts geven ze duidelijke instructies. Registries zorgen ervoor dat u weet wat er draait en waar. Operationeel beleid houdt de zaken veilig en kosteneffectief. Kubernetes geeft u de schaal en betrouwbaarheid om het allemaal te draaien.
De AI Gateway staat daarbovenop om deze bewegende delen te coördineren, maar de echte kracht komt voort uit de integratie — elke laag is verbonden, beheerd en observeerbaar. Dat is wat een verzameling tools verandert in een systeem waar ondernemingen daadwerkelijk op kunnen vertrouwen en bouwen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























