



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Wanneer teams LLM-applicaties en AI-agents naar productie brengen, worden kosten snel een van de lastigste problemen om te overzien. In tegenstelling tot traditionele cloud-workloads worden AI-kosten gedreven door gebruikspatronen die dynamisch, niet-deterministisch en vaak verborgen zijn achter meerdere abstractielagen.
Eén enkel gebruikersverzoek kan leiden tot meerdere modelaanroepen, retries, tool-aanroepen en agent-loops. Kleine wijzigingen in prompts, routinglogica of agentgedrag kunnen het tokenverbruik en de kosten aanzienlijk verhogen, vaak zonder duidelijke signalen totdat de factuur arriveert.
Dit is waarom AI cost observability cruciaal is in productiesystemen. Het gaat verder dan alleen het bijhouden van aantallen tokens of facturen van providers. AI cost observability richt zich op het toewijzen van kosten aan de werkelijke onderdelen van AI-systemen, zoals verzoeken, prompts, agents, tools en gebruikers, terwijl teams in staat worden gesteld om kostenproblemen vroegtijdig te detecteren en te beheersen.
In deze blog leggen we uit wat AI cost observability in de praktijk betekent, waarom AI-kosten moeilijk te volgen zijn en hoe teams gateway-gebaseerde architecturen gebruiken om LLM-uitgaven in productie te monitoren en te beheren.
AI cost observability is het vermogen om de kosten van AI-workloads in real-time te meten, toe te wijzen en te analyseren over modellen, agents en workflows heen.
In productiesystemen omvat dit doorgaans:
In de praktijk reikt dit verder dan eenvoudige facturatiedashboards naar een gestructureerde LLM cost tracking solution, waarin tokenverbruik, retries, routingbeslissingen en agentgedrag rechtstreeks gekoppeld zijn aan de werkelijke applicatieworkflows.
In tegenstelling tot traditionele monitoring van infrastructuurkosten, moet AI cost observability werken op het applicatie- en inferentieniveau. Cloudbilling-tools kunnen teams vertellen hoeveel ze in totaal hebben uitgegeven, maar ze leggen niet uit waarom de kosten zijn gestegen of welk deel van het systeem dit heeft veroorzaakt.
Effectieve AI cost observability geeft teams de benodigde context om vragen te beantwoorden zoals:
Door kosten op dit niveau inzichtelijk te maken, kunnen teams AI-uitgaven behandelen als een operationele metriek in plaats van als een verrassingsuitgave.
AI-kosten zijn niet zozeer moeilijk te volgen omdat de prijzen ondoorzichtig zijn, maar omdat kosten een voortvloeisel zijn van systeemgedrag. In productieomgevingen worden LLM-gebruikspatronen gevormd door routinglogica, retries, agents en tool-aanroepen, die allemaal op een niet-evidente manier met elkaar wisselwerken.
Verschillende factoren maken AI cost observability een uitdaging voor teams.
De meeste LLM-providers rekenen af op basis van tokens, maar het tokenverbruik is zeer gevoelig voor gedrag tijdens runtime. Kleine wijzigingen in prompts, contextgrootte of outputbeperkingen kunnen het aantal tokens aanzienlijk verhogen. Omdat deze wijzigingen vaak plaatsvinden op de applicatie- of promptlaag, zijn ze moeilijk te detecteren met alleen facturatiegegevens op providerniveau.
Productiesystemen vertrouwen zelden op één enkel model. Teams routen verzoeken over meerdere modellen en providers om een balans te vinden tussen kosten, latency en kwaliteit. Zonder een gecentraliseerd overzicht raken kostengegevens gefragmenteerd over verschillende providers, wat het lastig maakt om uitgaven holistisch te vergelijken of te optimaliseren.
Fouten zijn duur in AI-systemen. Retries en fallback-logica kunnen de kosten op de achtergrond vermenigvuldigen, vooral wanneer verzoeken opeenvolgend door meerdere modellen gaan. Zonder observability op verzoekniveau missen teams deze verborgen kostenvermenigvuldigers vaak totdat ze zichtbaar worden in de totale factuur.
Systemen die op agents zijn gebaseerd, vergroten de kostencomplexiteit. Een enkele agent-run kan meerdere modelaanroepen, planningsstappen en tool-aanroepen omvatten. Als een agent in een loop raakt of tools overmatig gebruikt, kunnen de kosten snel escaleren. Het bijhouden van dit gedrag vereist inzicht in hoe agents stap voor stap worden uitgevoerd.
Cloudcost-tools en providerdashboards rapporteren het gebruik op account- of projectniveau. Ze wijzen de kosten niet toe aan specifieke prompts, agents, gebruikers of workflows. Hierdoor is het voor platformteams moeilijk om budgetten af te dwingen of voor applicatieteams om hun eigen gebruik te optimaliseren.
In de praktijk betekenen deze uitdagingen dat problemen met AI-kosten vaak laat worden opgemerkt en reactief worden aangepakt. Dit is waarom teams die productie-AI-workloads draaien, cost observability nodig hebben die is ingebouwd in de AI Gateway en het uitvoeringspad, waar alle verzoeken doorheen lopen.
Om AI-uitgaven in productie te beheersen, hebben teams meer nodig dan alleen een totale maandfactuur. Ze moeten begrijpen waar de kosten vandaan komen en waarom. Cost observability bouwt voort op LLM observability door tokenverbruik en uitgaven te koppelen aan prompts, agents en workflows. Effectieve AI cost observability splitst de uitgaven op in dimensies die aansluiten bij hoe AI-systemen daadwerkelijk worden gebouwd en beheerd.
De meest waardevolle kostendimensies zijn onder andere:
Dit is de basis. Het bijhouden van de kosten per verzoek helpt teams te begrijpen hoe duur individuele gebruikersinteracties zijn en hoe die kosten zich in de loop van de tijd ontwikkelen. Pieken duiden hier vaak op een toenemende promptomvang, retries of routingwijzigingen.
In systemen met meerdere modellen hebben verschillende modellen heel verschillende kostenprofielen. Teams hebben inzicht nodig in hoeveel uitgaven naar elk model en elke provider gaan, en hoe routingbeslissingen de totale kosten beïnvloeden. Dit is essentieel voor het maken van weloverwogen keuzes tussen kwaliteit, latency en uitgaven.
Prompts zijn van directe invloed op het tokenverbruik. Door kosten per prompt en promptversie bij te houden, kunnen teams zien welke prompts duur zijn en of recente wijzigingen de uitgaven hebben verhoogd of verlaagd. Dit wordt extra belangrijk wanneer prompts worden gedeeld over meerdere applicaties of agents.
Bij agent-gebaseerde systemen moet de kostentoewijzing verder gaan dan individuele modelaanroepen. Teams moeten begrijpen hoeveel een volledige agent-run of workflow van begin tot eind kost, inclusief planningsstappen, tool-aanroepen en retries. Dit helpt om inefficiënt agentgedrag vroegtijdig te herkennen.
Voor interne platforms en enterprise-implementaties maakt het toewijzen van kosten aan gebruikers of teams verantwoording en budgettering mogelijk. Deze dimensie is vaak vereist om gebruikslimieten af te dwingen of om kosten intern door te berekenen.
Door deze dimensies in samenhang te observeren, kunnen teams overstappen van reactieve kostenanalyses naar proactieve kostenbeheersing.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |

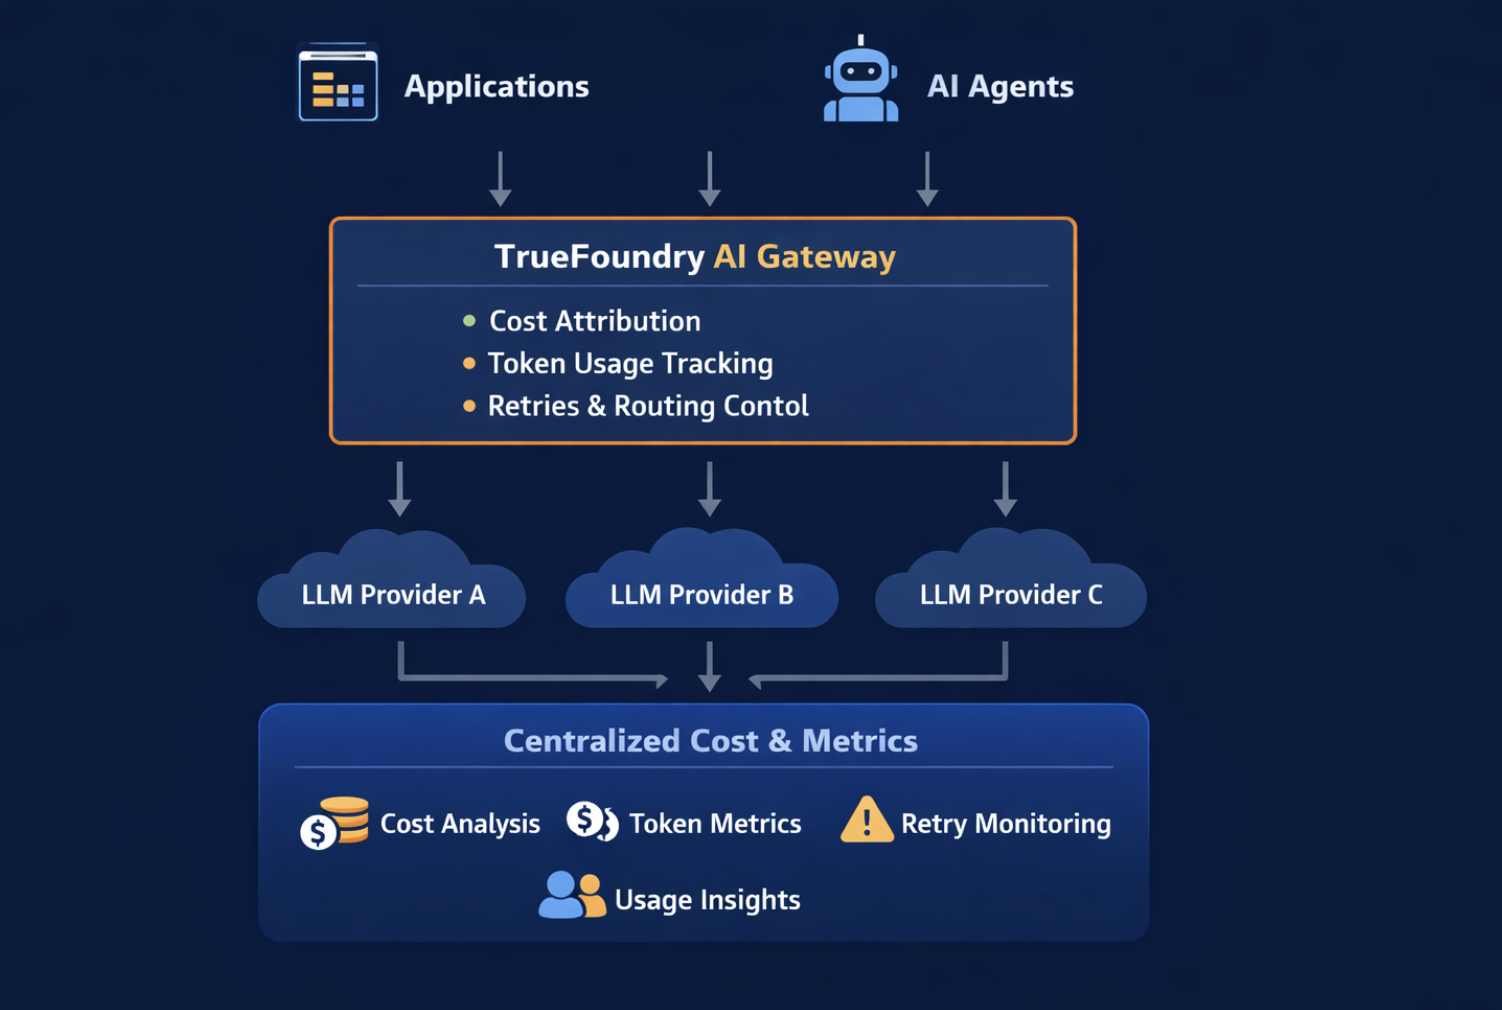
AI cost observability werkt het beste wanneer het wordt geïmplementeerd op een centraal onderscheppingspunt, waar alle verzoeken, routingbeslissingen en retries zichtbaar zijn. Dit is waarom AI Gateways een cruciale rol spelen.
Een AI Gateway bevindt zich tussen applicaties of agents en model-providers. Omdat elk verzoek hier doorheen stroomt, kan de gateway:
Zonder een gateway zijn kostengegevens gefragmenteerd over SDK's, services en providerdashboards. Met een gateway worden kosten een essentieel signaal dat geanalyseerd en opgevolgd kan worden voordat de uitgaven escaleren.
In TrueFoundry biedt de AI Gateway dit centrale controlepunt, waardoor het mogelijk wordt om AI-kosten voor modellen, agents en workflows op een eenduidige manier te monitoren en te beheren.
Agent-gebaseerde systemen vergroten zowel de kracht als de kosten van AI-workloads. In tegenstelling tot applicaties die werken op basis van een enkel verzoek, voeren agents workflows met meerdere stappen uit die planning, redenering, retries en toolgebruik kunnen omvatten. Dit maakt het kostengedrag moeilijker te voorspellen en belangrijker om nauwlettend in de gaten te houden.
Een enkele agent-run kan het volgende omvatten:
Zonder de juiste observability kunnen deze interacties de kosten ongemerkt vermenigvuldigen. Agent-loops, slecht begrensde prompts of overmatig toolgebruik blijven vaak onopgemerkt totdat de totale uitgaven aanzienlijk stijgen.
AI cost observability voor agents vereist inzicht op het uitvoeringsniveau van de agent, niet alleen op het niveau van de modelaanroep. Teams moeten begrijpen:
Dit is waar een gateway-gebaseerde architectuur bijzonder waardevol wordt. Door agentverzoeken op de gateway op te vangen, kunnen teams de kosten over de gehele levenscyclus van een agent-run toewijzen, in plaats van elke modelaanroep op zichzelf te beoordelen.
In TrueFoundry integreren agent-implementaties met de AI Gateway, waardoor teams de kosten over alle stappen en workflows van agents heen kunnen monitoren. Dit stelt platform- en applicatieteams in staat om inefficiënt agentgedrag vroegtijdig te detecteren en beperkingen op te leggen voordat de kosten uit de hand lopen.

In TrueFoundry is AI cost observability direct geïmplementeerd op het niveau van de AI Gateway en de agent-uitvoeringslaag, waar alle modelverzoeken, routingbeslissingen en retries zichtbaar zijn. Dit biedt een eenduidig en consistent overzicht van de kosten voor modellen, prompts, agents en workflows.
Omdat elk verzoek via de gateway verloopt, kan TrueFoundry:
Deze gecentraliseerde aanpak verandert kosten van een passieve metriek in een operationeel signaal. Teams kunnen waarschuwingen instellen voor afwijkende uitgaven, budgetten afdwingen op de routinglaag en kostenbewuste keuzes maken bij het selecteren van modellen of fallback-strategieën.
Voor teams die productie-AI-workloads draaien, zorgt dit ervoor dat de kosten voorspelbaar, verklaarbaar en beheersbaar blijven, zelfs als systemen complexer worden met meer agents, modellen en workflows.
AI-kosten worden moeilijk te beheren zodra LLM-applicaties naar productie gaan. Kosten worden niet langer gedreven door een enkele modelaanroep, maar door een combinatie van prompts, routingbeslissingen, retries, agents en toolgebruik. Zonder behoorlijk inzicht ontdekken teams kostenproblemen vaak pas nadat de uitgaven al zijn opgelopen.
AI cost observability lost dit op door van kosten een essentieel signaal te maken. Door uitgaven toe te wijzen aan verzoeken, modellen, prompts, agents en workflows, kunnen teams niet alleen begrijpen wát ze uitgeven, maar ook wáárom. Dit inzichtniveau is essentieel om AI-systemen betrouwbaar en op schaal te laten draaien.
Gateway-gebaseerde architecturen spelen een centrale rol bij het mogelijk maken van deze transparantie. Door verzoeken op één enkel controlepunt op te vangen, kunnen teams AI-uitgaven op een consistente manier monitoren, analyseren en beheren over verschillende providers en uitvoeringspaden heen. In TrueFoundry stelt deze aanpak platform- en applicatieteams in staat om inefficiënties vroeg op te sporen, budgetten te handhaven en kosten af te wegen tegen prestaties naarmate AI-workloads groeien.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















