



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
In traditionele softwaresystemen zijn storingen meestal expliciet. Een functie geeft een foutmelding, een service crasht of een verzoek krijgt een timeout. Debuggen is grotendeels deterministisch. AI-agents veranderen dit model fundamenteel.
Agents zijn ontworpen om niet-deterministisch te zijn. Ze redeneren over tussenstappen, kiezen dynamisch tools en passen hun gedrag tijdens de uitvoering aan. Deze autonomie maakt krachtige workflows mogelijk, maar introduceert ook nieuwe foutmodi die moeilijker te detecteren en te debuggen zijn.
Wanneer een agent in productie faalt, crasht deze zelden direct. In plaats daarvan kan hij in een loop raken, de verkeerde tool selecteren of een onjuiste beslissing nemen op basis van onvolledige of verouderde context. Deze storingen komen vaak alleen aan het licht als een verminderde outputkwaliteit, hogere latency of onverwachte kosten, zonder enig duidelijk foutsignaal.
Voor teams die agents in productie draaien, maakt dit traditionele monitoring ontoereikend. Agent observability is vereist om te begrijpen hoe agents zich gedragen tijdens runtime, foutmodi vroegtijdig te identificeren en deze systemen schaalbaar en betrouwbaar te beheren.
Als traditionele observability gaat over het controleren van de hartslag van een systeem, is AI agent observability meer als het lezen van de gedachten ervan. In een standaardtoepassing volgen we de datastroom via vaste codepaden. Maar een agent heeft geen vast pad. Hij bouwt zijn eigen weg terwijl hij draait. Dit betekent dat we een nieuwe reeks lenzen nodig hebben om te zien wat er onder de motorkap gebeurt.
Echte observability voor agents gaat verder dan eenvoudige uptime en richt zich op vier specifieke pijlers: traces, tool-calls, beslissingsstappen en storingen.
Zonder een trace zie je misschien dat een agent drie dollar heeft uitgegeven en twintig seconden nodig had om een vraag te beantwoorden, maar je weet niet waarom. Met een goed gestructureerde trace kun je de gehele sessie hersen spelen (replayen). Je kunt precies zien waar de agent begon, waar hij van het pad afraakte en hoe hij uiteindelijk tot een conclusie kwam.
Standaard monitoringtools zijn gebouwd voor een wereld waarin code een reeks voorspelbare "als-dit-dan-dat"-statements is. In die wereld is een fout een harde stop en een succes een voltooide taak. Maar wanneer u overstapt op autonome agents, worden de grenzen tussen succes en mislukking wazig. U kunt een systeem hebben dat volgens uw dashboard technisch gezien "gezond" is, terwijl het tegelijkertijd uw gebruikers in de steek laat.
Traditionele observability leunt doorgaans op twee hoofdpijlers: logs en metrics. Beide schieten tekort wanneer ze worden toegepast op de dynamische aard van agentic workflows.
Ruwe applicatielogs zijn geweldig voor het opsporen van een gecrashte server of een database-timeout. Een agent die aan het denken is, produceert echter niet noodzakelijkerwijs een error-log. Het produceert een stroom van redeneringen.
Voorbeeldscenario: Een agent krijgt de taak om een specifiek document in een grote database te vinden, maar krijgt een licht ambigu zoek-tool. De agent kan in een recursieve lus terechtkomen: zoeken, het resultaat niet vinden, en dan opnieuw zoeken met een kleine variatie.
Vanuit een traditioneel logging-perspectief kan elk van die API-calls een 200 OK-status retourneren. Uw logs laten duizenden succesvolle hits zien, hoewel de agent in werkelijkheid vastzit en uw budget erdoorheen jaagt. Zonder het "waarom" achter de calls zijn de ruwe logs slechts ruis.
Traditionele metrieken richten zich op indicatoren op hoog niveau zoals CPU-gebruik, geheugen en request latency. Hoewel deze nog steeds belangrijk zijn, zijn ze in essentie contextblind.
In een standaard API is een piek in latency bijna altijd een slecht teken. In een agentic systeem kan een hoge latency juist een teken van succes zijn.
Als een agent een bijzonder complexe query tegenkomt en besluit om vijf extra reasoning-stappen te nemen om nauwkeurigheid te garanderen, zal de latency pieken, maar de kwaliteit van het resultaat zal verbeteren.
Omgekeerd kan een lage latency betekenen dat de agent het te vroeg opgaf of een oppervlakkig, gehallucineerd antwoord gaf. Zonder een manier om performancemetrieken te correleren met de interne logica en het besluitvormingspad van de agent, kunnen de cijfers op je dashboard juist misleidend zijn. Om een agent echt te begrijpen, moet je de "reasoning span" zien die de metrieken verbindt met het specifieke doel dat de agent probeerde te bereiken.
Om agents effectief te beheren, moeten we stoppen met kijken naar het geaggregeerde beeld en beginnen met kijken naar de sequentie. Omdat een agent in feite een reeks "loops" is, zijn de metrieken die er toe doen diegene die de gezondheid van elke loop beschrijven en hoe deze zich verhouden tot het einddoel.
Als je verder wilt gaan dan basis-uptime, zijn dit de vier belangrijkste signalen waar jouw observability-stack prioriteit aan moet geven.
In een agentic workflow kan een enkele user prompt vijf of zes interne reasoning-stappen triggeren. Een step-level trace legt de gedachte vast die het model in elke fase had. Dit omvat de specifieke prompt die naar de LLM is gestuurd, de raw output en, cruciaal, de metadata zoals token-gebruik en waarschijnlijkheidsscores.
Door de lineage van deze stappen te observeren, kun je precies aanwijzen waar de logica begint af te wijken.
Als een agent bijvoorbeeld de taak heeft om een rapport te genereren, maar vastkomt te zitten in stap drie door herhaaldelijk te proberen een tabel opnieuw te formatteren, maakt de step-level trace deze logische wrijving direct zichtbaar. Zonder dit zie je alleen een langdurig request dat uiteindelijk een time-out geeft.
Agents zijn slechts zo snel als de tools die ze gebruiken. Wanneer een agent een database of een search API aanroept, wordt de responstijd van die tool opgeteld bij de totale uitvoeringstijd van de agent. Observability-tools moeten tool latency als een afzonderlijke metriek bijhouden.
Als een agent 30 seconden nodig heeft om te reageren, moet u weten of de vertraging werd veroorzaakt doordat het LLM aan het "nadenken" was of door een trage API van derden.
Het monitoren van de latency van tools stelt u in staat om specifieke SLA's in te stellen voor uw externe integraties. Als een specifieke zoektool consistent 10 seconden vertraging toevoegt, kunt u besluiten deze te vervangen door een snellere vector database of de onderliggende query van de tool te optimaliseren.
In complexe systemen kan een kleine fout in een vroege stap escaleren tot een volledige mislukking aan het einde. Dit staat bekend als error propagation. Als een Data Retrieval-tool bijvoorbeeld een verkeerd geformatteerd JSON-object retourneert, kan de agent in de volgende stap proberen te "redeneren" op basis van die slechte data, wat leidt tot een gehallucineerd eindantwoord.
Observability voor agents betekent het traceren van hoe een fout op span-niveau de rest van de trace beïnvloedt. Je moet het exacte moment kunnen zien waarop een tool een fout meldde en hoe de agent probeerde te herstellen. Heeft hij het opnieuw geprobeerd? Is hij gecontroleerd teruggevallen op een alternatief? Of is hij blindelings doorgegaan met een gecorrumpeerde context?
In tegenstelling tot een standaard chatbot, waarbij een verzoek relatief vaste kosten heeft, zijn de kosten van een agent uiterst variabel. De ene run kost misschien vijf cent, terwijl de volgende run, getriggerd door dezelfde prompt maar met meer redeneerstappen, twee dollar kan kosten.
Het bijhouden van "kosten per run" is de enige manier om de unit economics van je AI-functionaliteit te begrijpen. Deze metriek aggregeert de gebruikte tokens over elke modelaanroep en de kosten van elke tool-aanroep in één enkele sessie.
Door deze kosten te correleren met de tevredenheid van de gebruiker of het succes van de taak, kun je "hoge kosten, lage waarde"-patronen identificeren en je orchestratielogica optimaliseren om efficiënter te worden.
Dit is het evaluatiekader
| Criteria | Wat moet je evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Tracen & correlatie van verzoeken | |||
| End-to-end verzoek-tracing | Kan elk verzoek getraceerd worden van de applicatie naar de gateway naar de provider of tool met behulp van een correlatie-ID? | Must have | ✅ Ondersteund: OTEL-compliant traces met correlatie-IDs. |
| Vastleggen van prompt en respons | Worden volledige prompts, responsen, systeemberichten, en tool-aanroepen vastgelegd met configureerbare redactie? | Must have | ✅ Ondersteund: volledige prompt- en responsregistratie met PII-redactie. |
| Metadata-verrijking | Worden gebruiker-, team-, applicatie-, omgeving-, model- en provider-tags aan elke trace gekoppeld? | Must have | ✅ Ondersteund: metadata-verrijking bij elk verzoek. |
| Trace-zoeken en -filtering | Kunnen traces worden doorzocht en gefilterd op elke combinatie van metadata, latency-band, foutcode of model? | Must have | ✅ Ondersteund: zoeken in volledige tekst en metadata in alle traces. |

Het debuggen van agents op de applicatielaag wordt snel onpraktisch naarmate workflows in complexiteit toenemen. De uitvoering van agents beslaat vaak meerdere modellen, tools en services, wat leidt til gefractioneerde telemetrie.
Een AI Gateway biedt een gecentraliseerde observability-laag door plaats te nemen tussen applicaties, modellen en tools. Omdat alle interacties via de gateway verlopen, kan deze een compleet en consistent beeld van het gedrag van de agent vastleggen.
Deze aanpak verandert observability van een vrijblijvende logging-oefening in een gestructureerde, systeembrede functionaliteit.
De gateway fungeert als een universeel onderscheppingspunt voor alle agent-interacties. Prompts, modelresponsen, tool-aanroepen en retry's worden opgevangen en genormaliseerd naar een consistent formaat.
Dit neemt de noodzaak weg om logs van meerdere services of providers handmatig te correleren. Ongeacht welk model of welke tool een agent gebruikt, de uitvoeringsgegevens worden centraal verzameld en kunnen als één enkele workflow worden geanalyseerd.
Door correlatie-identificatoren in te voegen op de gateway-laag, kunnen alle gebeurtenissen met betrekking tot een enkele agent-uitvoering worden gegroepeerd in een hiërarchische trace.
Hierdoor kunnen teams een run van een agent bekijken als een gestructureerde reeks stappen, in plaats van losstaande verzoeken. Geünificeerde traces maken het mogelijk om exact te identificeren welke specifieke modelaanroep, tool-aanroep of redeneerstap een regressie in kwaliteit, latency of kosten heeft veroorzaakt.
Een van de moeilijkste problemen bij het debuggen van agents is het begrijpen van de relatie tussen de intentie van het model en het gedrag van de tool.
Omdat de gateway beide kanten van de interactie observeert, kan deze het volgende correleren:
Zichtbaarheid over deze lagen heen stelt teams in staat om te bepalen of fouten voortkomen uit slechte prompting, modelbeperkingen of problemen aan de kant van de tool, wat gerichte verbeteringen mogelijk maakt.
Belangrijkste metrieken voor het evalueren van een Gateway
| Criteria | Wat moet je evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latency | Voegt <10ms p95 overhead toe voor time-to-first-token? | Must Have | ✅ Ondersteund |
| Dataresidentie | Houdt logs binnen je regio (EU/US)? | Afhankelijk van use case | ✅ Ondersteund |
| Op latency gebaseerde routing | Routet automatisch om op basis van real-time latency/storingen? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
TrueFoundry vertaalt de complexiteit van agent-gedrag naar een gestructureerde, enterprise-ready observability suite. Door te fungeren als een centraal controlepaneel via zijn AI Gateway, stelt het teams in staat om agents te monitoren, analyseren en debuggen over diverse frameworks zoals CrewAI, Langroid, OpenAI Agents SDK en Strands Agents.
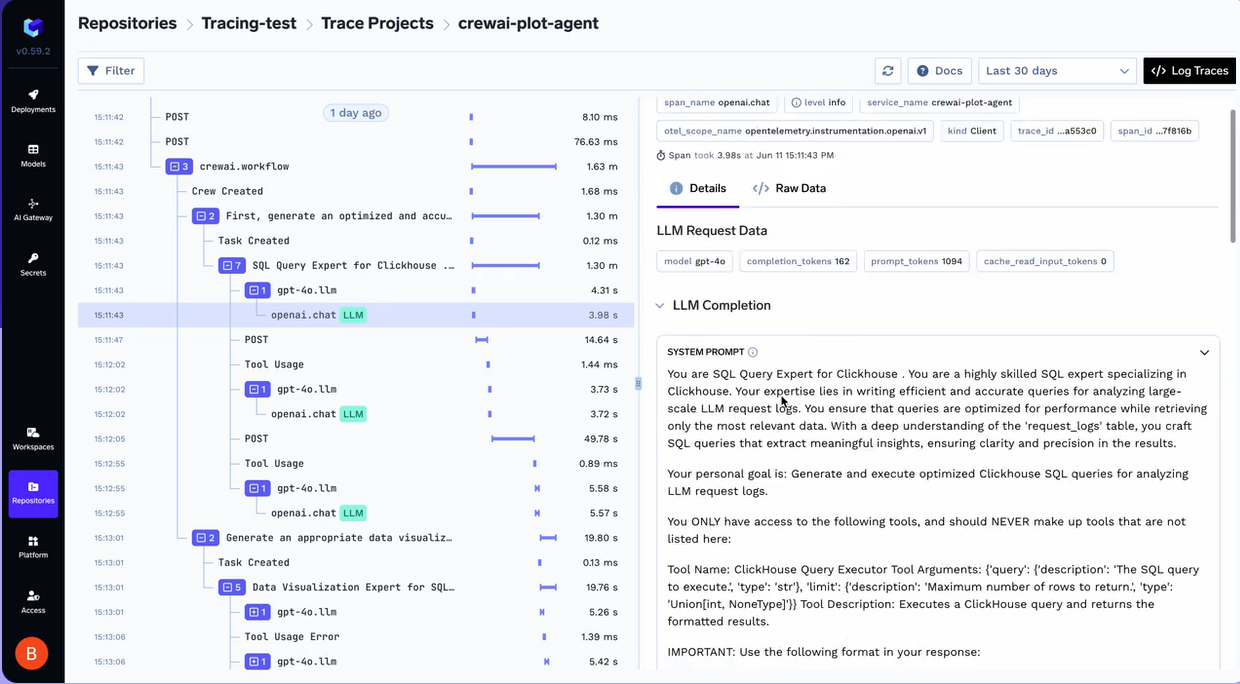
TrueFoundry biedt hoogwaardige zichtbaarheid in elke stap die een agent zet. Door gebruik te maken van de Traceloop SDK maakt het platform gedetailleerde trace-correlatie mogelijk over complexe agent-workflows. Dit gaat verder dan eenvoudige logging; het stelt je in staat om de hiërarchische relatie te zien tussen de initiële prompt van een gebruiker en de daaropvolgende keten van modelaanroepen en tool-uitvoeringen.
Om te beginnen met tracing, initialiseer je eenvoudigweg de SDK in je applicatiecode.
TrueFoundry ontrafelt het "latency-mysterie" in agentic systemen door gedetailleerde prestatiegegevens bij te houden. Het dashboard biedt een compleet overzicht van:
Governance en kostenbeheer zijn rechtstreeks geïntegreerd in de observability-stack. TrueFoundry biedt gedetailleerde overzichten van input- en output-tokens, waarbij de kosten per model automatisch worden berekend op basis van de actuele tarieven van providers.
Teams kunnen Gebruikspatronen analyseren om hun meest actieve gebruikers te identificeren, te zien hoe verzoeken worden verdeeld over verschillende modellen en uitgaven per team bij te houden voor interne verrekeningen. Met ingebouwde ondersteuning voor Rate Limiting en budgetbeheer zorgt TrueFoundry ervoor dat je agents binnen hun operationele grenzen blijven. Dit voorkomt de bekende "verrassingsrekening" en behoudt tegelijkertijd de betrouwbaarheid die nodig is voor enterprise-productie.
Het draaien van AI-agents in productie vereist een verschuiving van traditionele monitoring naar diepgaande observability. Omdat agents dynamisch redeneren, handelen en zich aanpassen, zijn hun fouten vaak logisch van aard in plaats van technisch.
Door observabiliteit te centraliseren bij de AI Gateway en inzicht te bieden op uitvoeringsniveau in reasoning, tools en kosten, kunnen teams ondoorzichtig agentgedrag omzetten in iets wat meetbaar en beheersbaar is. Met de juiste observabiliteit worden agents betrouwbare onderdelen van productiesystemen in plaats van onvoorspelbare black boxes.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















