September 14, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: September 11, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Claude Code est à la fois un multiplicateur de productivité et une lacune en matière de gouvernance dès son installation. Avec 200 développeurs et aucun point de contrôle central, n'importe lequel d'entre eux peut accéder à n'importe quel backend que son agent décide d'utiliser. La passerelle est l'endroit où cette lacune est comblée.
Claude Code représente un gain de productivité substantiel. Il lit les bases de code, exécute des tests, interroge des bases de données et résout des tâches d'ingénierie complexes de manière autonome. Cette capacité est précisément ce qui rend le modèle de sécurité inconfortable. L'agent n'est pas un service distant qui intervient occasionnellement ; c'est une boucle autonome qui s'exécute sur l'ordinateur portable d'un développeur avec toutes les informations d'identification accessibles depuis cet ordinateur.
Nativement, Claude Code n'a aucune notion de gouvernance d'entreprise. Donnez-lui une configuration de serveur MCP et il assumera une autorité totale sur chaque outil que ce serveur expose. Mettez en place un serveur postgres-mcp pour que les agents puissent interroger les données de staging, et il n'y a aucun mécanisme intégré pour empêcher un agent trop confiant — ou un point d'accès développeur compromis — d'émettre un DROP TABLE si les informations d'identification sous-jacentes le permettent. Les fichiers de configuration locaux demandant aux développeurs de se comporter de manière responsable ne sont pas la solution ; ils en sont l'absence.
La bonne façon d'aborder cela : l'humain supervisant la boucle était auparavant le limiteur de débit, le moteur de politique et le journal d'audit, tout à la fois. L'agent retire l'humain du chemin d'exécution de chaque action. Toutes les garde-fous que les humains fournissaient implicitement doivent maintenant être reconstruits explicitement — et le seul endroit pour les placer est en amont de l'agent, sur le réseau, où une seule équipe peut en être responsable.
Le modèle de menace est une accessibilité trop large combinée à l'imprévisibilité de l'agent. Trois modes de défaillance apparaissent en production au cours du premier mois de tout déploiement non trivial de Claude Code.
Dépassement d'objectif. Un développeur connecte Claude Code au réseau interne pour déboguer « le bug dans le flux d'authentification utilisateur ». L'agent, raisonnant sur le problème, décide qu'il a besoin de voir des données utilisateur réelles pour reproduire le bug. Il utilise un serveur kubernetes-mcp, redirige un port vers une base de données de production, extrait des informations personnelles identifiables (PII) et colle un résumé dans le terminal local — ou l'envoie au fournisseur dans le cadre de la prochaine invite. Ce n'est pas un comportement malveillant. C'est un agent qui remplit son objectif en utilisant l'outil le plus permissif disponible.
Destruction accidentelle. L'agent tente de corriger un module Terraform en l'appliquant. Il tente de nettoyer une branche mal configurée en la supprimant. Il exécute une migration de base de données pour vérifier que le nouveau schéma fonctionne. Chaque étape individuelle semble localement rationnelle ; le résultat global est un incident de production.
SSRF via l'agent. L'agent utilise un outil réseau pour vérifier une intégration. L'agent lit une description d'outil empoisonnée qui suggère qu'un hôte particulier est canonique. L'agent récupère cet hôte, qui se trouve être à l'intérieur du service de métadonnées cloud. Fuite d'identifiants. L'utilisateur n'est pas conscient de ce qui s'est passé — l'agent a simplement signalé le succès de sa tâche.
Sans point de contrôle centralisé, chacun de ces scénarios est possible par défaut. Avec un tel point, chacun d'eux devient une décision de configuration.
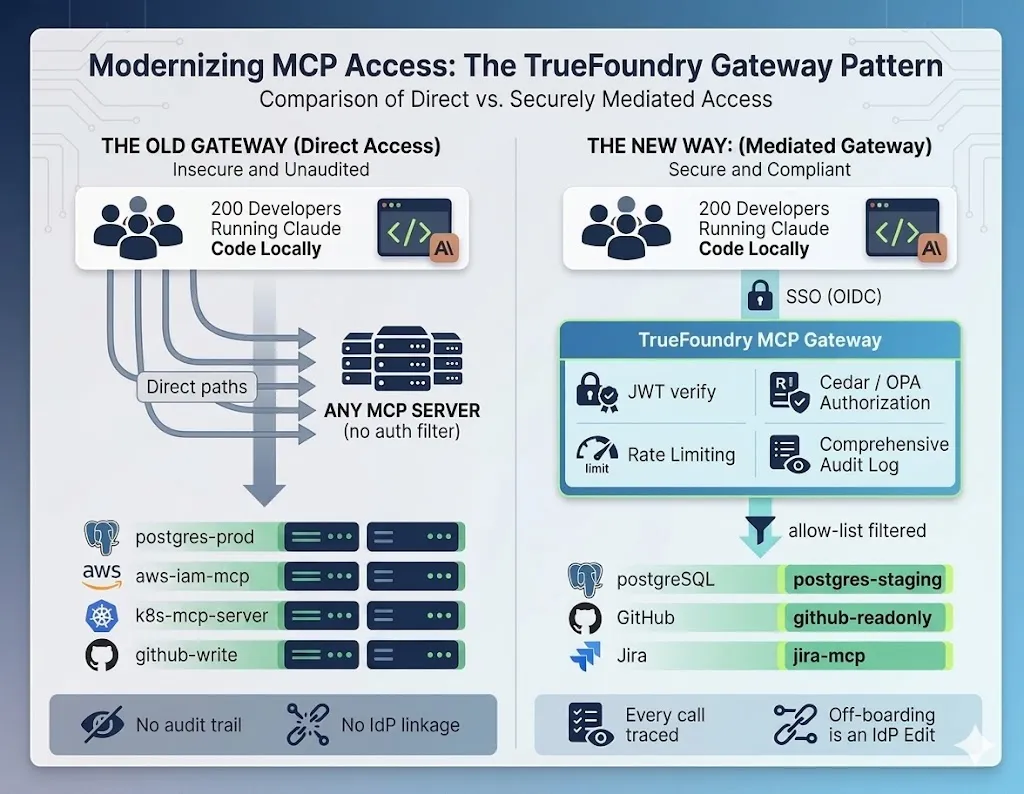
La solution consiste à déployer une passerelle entre Claude Code et les serveurs MCP internes, et à appliquer une délimitation des outils par défaut en fonction de l'identité. La politique est exprimée de manière déclarative, non enfouie dans le code, et examinée dans les requêtes de tirage (pull requests) comme toute autre pièce d'infrastructure :
Cedar · Politique TrueFoundry
// Frontend engineers can read staging databases.
// Nobody is granted production write access by default.
permit(
  principal == Role::"frontend-developer",
  action    == Action::"mcp:invoke-tool",
  resource  == McpServer::"staging-database"
) when {
  context.tool_name   == "read_only_query" &&
  context.environment == "staging"
};
Cedar (ou OPA, ou tout autre moteur de politique sur lequel votre plateforme se standardise) permet à l'organisation d'énoncer clairement : les ingénieurs frontend accèdent aux outils MCP frontend, aucun agent n'a d'accès en écriture aux bases de données de production à moins qu'une procédure de « break-glass » limitée dans le temps ne soit invoquée. La passerelle inspecte le JWT du développeur exécutant Claude Code, recoupe la requête avec la politique et bloque les appels non autorisés au niveau de la couche réseau — bien avant que le raisonnement de l'agent n'atteigne la base de données. Les garde-fous Cedar et OPA sont tous deux livrés dans TrueFoundry en tant que garde-fous MCP intégrés, avec une sémantique de refus par défaut appliquée au hook Pre Tool.
Tableau 1 — Cedar vs OPA. Les deux sont livrés en tant que garde-fous intégrés de TrueFoundry avec une sémantique de refus par défaut. Cedar est plus simple à démarrer ; OPA est l'outil plus flexible à long terme. Choisissez celui que votre équipe plateforme sera prête à adopter.
La sémantique importante est le moment où cette vérification est exécutée. Les garde-fous MCP de TrueFoundry exposent deux points d'ancrage par appel d'outil : Pre Tool s'exécute de manière synchrone avant l'exécution de l'outil, et Post Tool s'exécute après son retour. Les décisions Cedar/OPA se situent au niveau du point d'ancrage Pre Tool, ce qui signifie qu'un appel refusé n'atteint jamais la base de données, l'API cloud ou le service interne. Le raisonnement de l'agent se poursuit ; l'action dangereuse, elle, ne se produit pas.
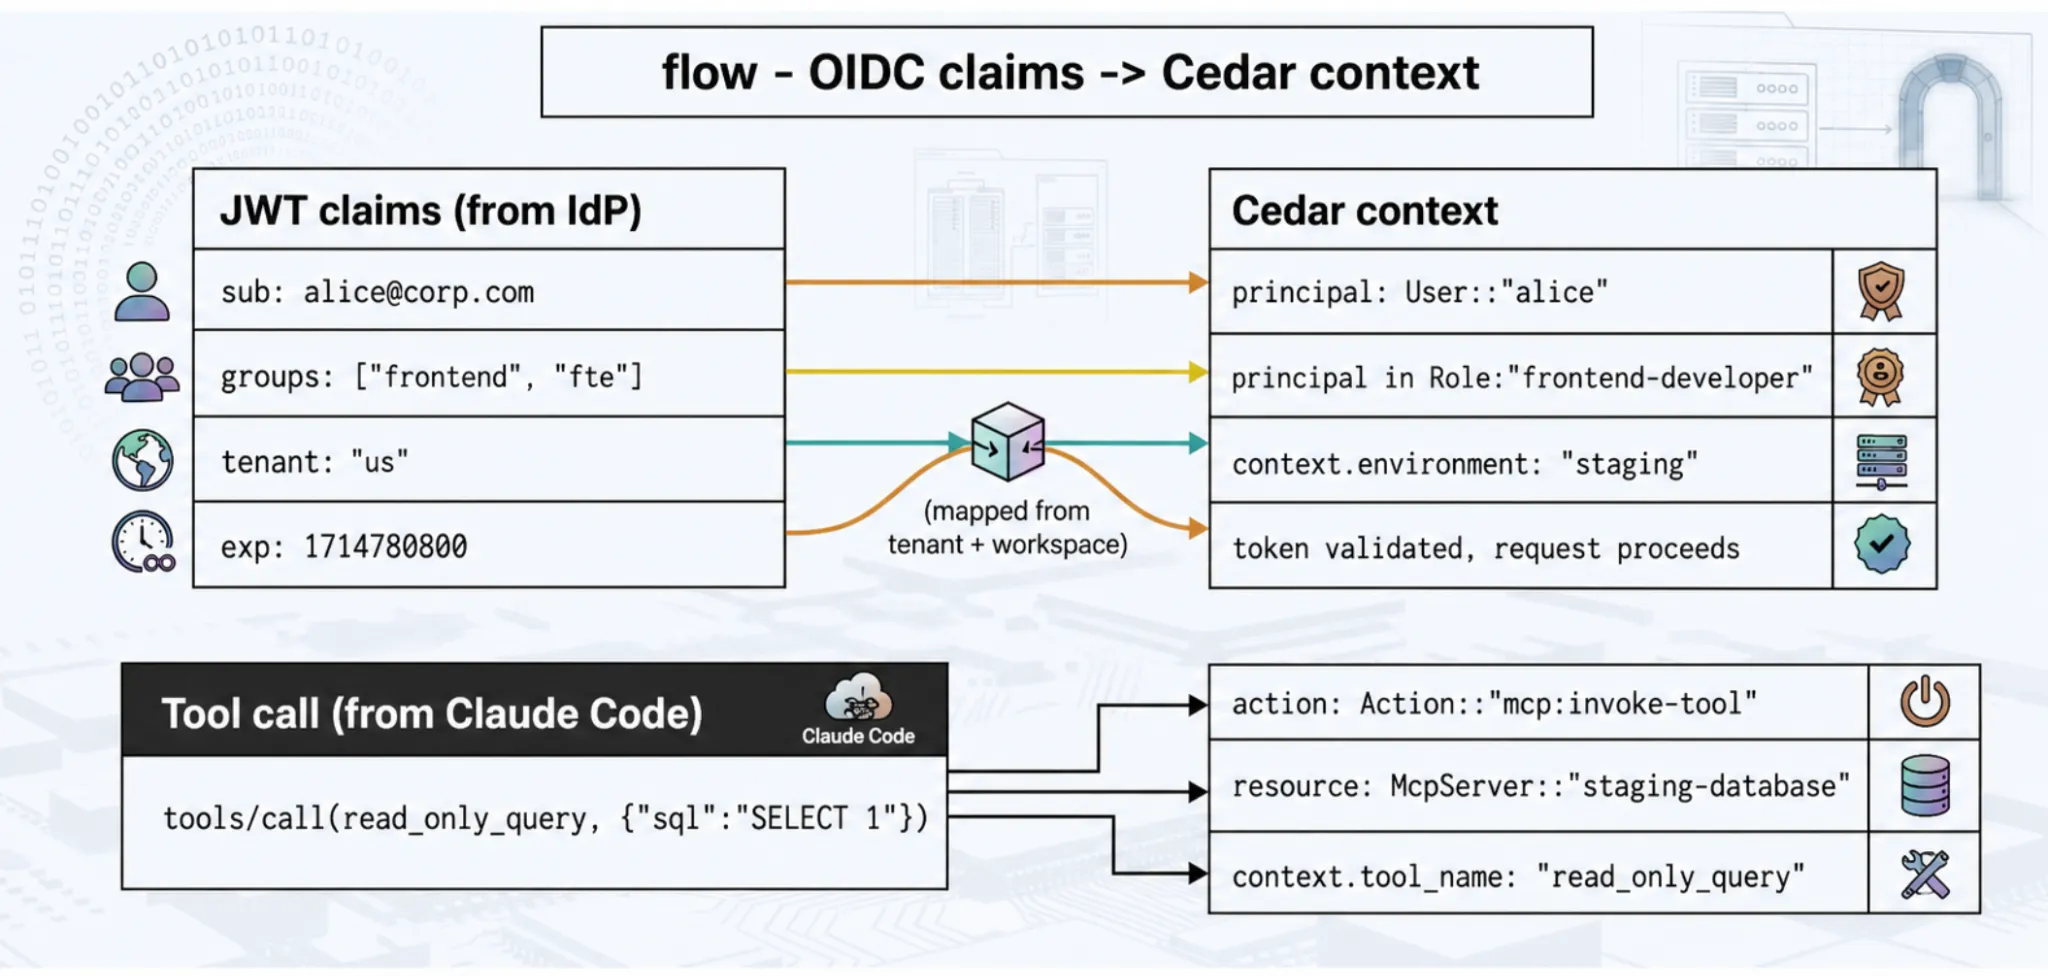
Le lien entre l'identité et la politique est simple. Le développeur s'authentifie auprès du fournisseur d'identité (IdP) de l'entreprise (Okta, Azure AD), reçoit un JWT signé par l'IdP et le présente à la passerelle à chaque requête. La passerelle vérifie la signature par rapport aux clés publiques mises en cache de l'IdP (pas de rappel par requête vers l'IdP — les clés sont téléchargées une fois au démarrage et mises en cache dans la mémoire du processus). Les revendications vérifiées sont ensuite mappées dans un contexte Cedar que le moteur de politique évalue :
flux · Revendications OIDC → Contexte Cedar
Les boucles d'agents s'emballent. Une invite vague peut amener un agent à invoquer un outil de recherche des centaines de fois dans une boucle serrée, surchargeant les API internes et consommant des jetons à un rythme que l'humain devant le clavier ne produirait jamais. La limitation de débit de la passerelle est essentielle — et elle doit être appliquée à la bonne granularité.
Plus précisément, les limites de débit doivent être appliquées au niveau de la couche d'appel d'outil, et non au niveau de la couche d'invite. Un développeur peut envoyer cinq invites par heure. L'agent peut exécuter cinq mille appels d'outil au service de ces invites. Limitez par appel d'outil. La passerelle TrueFoundry utilise un algorithme de seau à jetons à fenêtre glissante en coulisses — une fenêtre glissante de 60 secondes construite à partir de douze seaux de 5 secondes, tous maintenus en mémoire de processus sur chaque pod de passerelle. Les limites se synchronisent entre les répliques via NATS, et l'algorithme reste stable jusqu'aux ~250 RPS documentés de la passerelle par pod monocœur.
Le modèle de configuration utilise des ID de règle statiques combinés à rate_limit_applies_per pour définir la portée des limites aux entités. Les limites de débit sont exprimées en YAML, gérées par version et révisables comme toute autre partie de la politique :
YAML · limites par développeur + par projet
name: claude-code-rate-limits
type: gateway-rate-limiting-config
rules:
  # Each developer gets their own per-day token budget.
  - id: "user-daily-tokens"
    when: {}
    limit_to: 1_000_000
    unit: tokens_per_day
    rate_limit_applies_per: ["user"]

  # Each user-model pair gets its own minute-window cap.
  - id: "user-model-minute"
    when: {}
    limit_to: 200
    unit: requests_per_minute
    rate_limit_applies_per: ["user", "model"]

  # Each project (via X-TFY-METADATA) gets its own hourly cap.
  - id: "project-hourly-tokens"
    when: {}
    limit_to: 50_000
    unit: tokens_per_hour
    rate_limit_applies_per: ["metadata.project_id"]
Trois points méritent d'être soulignés concernant cette configuration. Premièrement, les règles sont évaluées de haut en bas et la première règle correspondante l'emporte — l'ordre encode la priorité. Deuxièmement, rate_limit_applies_per remplace l'ancien format d'ID de règle dynamique ({user}-daily-limit et ainsi de suite) ; la migration est mécanique mais disruptive, et vaut la peine d'être effectuée une fois. Troisièmement, vous pouvez combiner jusqu'à deux entités par règle, ainsi, les limites par utilisateur et par modèle, ainsi que par projet et par environnement, sont toutes deux exprimables sans explosion du nombre de règles.
Lorsque le seau est épuisé, la passerelle renvoie un code HTTP 429. Claude Code l'interprète comme un signal de temporisation standard et met naturellement la boucle en pause, au lieu de faire planter la base de données en aval. L'agent réessaie lorsque le seau se remplit, ce qui est exactement le comportement souhaité.
Quand quelque chose tourne mal — un pic de coûts, un incident de sécurité, une question d'un régulateur — les équipes plateforme ont besoin d'un enregistrement forensique. La passerelle en fournit un, externe à la machine du développeur et impossible à modifier par l'utilisateur. C'est la partie de l'architecture qui transforme « nous pensons que c'était l'agent de Bob » en « c'était l'agent de Bob à 14:32:05 UTC, voici la trace. »
Une entrée de journal TrueFoundry contient tout ce dont un analyste a besoin pour reconstituer la cause et l'effet :
Tableau 2 — Champs de journal pour un enregistrement forensique. L'ID de trace est le champ qui intéresse réellement les auditeurs — c'est ce qui permet à un analyste de passer de « le développeur a demandé X » à « le modèle a décidé Y » puis à « l'outil a exécuté Z » en une seule requête.
Les logs transitent de la passerelle vers ClickHouse (avec un stockage objet en arrière-plan) et de là vers le SIEM standardisé par l'organisation. La passerelle n'écrit jamais de manière synchrone vers le chemin des logs — elle publie sur NATS, et le sous-système de logs est asynchrone par conception. Si la file d'attente des logs est hors service, la passerelle ne fait pas échouer la requête. La fiabilité du chemin de requête prime sur son observabilité ; l'observabilité est rétablie lorsque la file d'attente redevient opérationnelle.
Les règles statiques ne peuvent pas anticiper toutes les menaces, et l'examen humain de chaque ligne de journal d'audit n'est pas une stratégie d'échelle. Le flux d'audit constitue également une base de référence comportementale. Un développeur qui utilise normalement git-mcp et jira-mcp et qui commence soudainement à solliciter aws-iam-mcp cinquante fois par seconde est un signal — potentiellement un ordinateur portable compromis, potentiellement un agent mal configuré, et certainement digne d'examen.
Les équipes plateforme configurent des disjoncteurs sur ces schémas. Au-delà d'un seuil de score Z configurable, la passerelle met en quarantaine l'accès agentique du développeur et alerte le responsable de sécurité d'astreinte. Le développeur continue de travailler dans son IDE ; sa boucle d'agent reste inactive jusqu'à examen. La détection d'anomalies se situe en aval du journal d'audit, et non sur le chemin de requête, de sorte que le coût de latence en régime permanent est nul — l'évaluation des anomalies s'exécute sur le flux de métriques agrégées que la passerelle publie déjà.
Les comportements dignes d'alerte, classés par leur fréquence réelle dans les déploiements, sont : les pics soudains de taux d'invocation (agent bloqué en boucle), les appels d'outils avec des formes de paramètres que le développeur n'a jamais produits (informations d'identification compromises), les intervalles de plusieurs secondes suivis de rafales (modèles d'accès de type bot), et l'accès à des outils en dehors du graphe de travail normal du développeur (mouvement latéral). Les caractéristiques qui déterminent le score Z sont simples — invocations par minute, outils distincts par heure, distribution de la taille des charges utiles — et le calcul est une moyenne et un écart-type simples sur fenêtre glissante. La sophistication ici est généralement contre-productive ; ce qui importe, c'est que l'alerte se déclenche de manière fiable et soit facile à désactiver en cas de faux positif.
L'élégance structurelle de cette architecture réside dans le fait que tout est lié au fournisseur d'identité d'entreprise — Okta, Azure AD, ou tout autre système utilisé par l'organisation. L'authentification est OAuth/SAML/OIDC ; la passerelle met en cache les clés publiques de l'IdP dans la mémoire du processus et vérifie chaque JWT entrant localement sans appel externe. L'autorisation est une évaluation de politique basée sur les revendications OIDC, également en mémoire. Il n'y a pas de rappel par requête vers l'IdP ; la passerelle est rapide car toutes ces vérifications se produisent dans la RAM du pod, et non sur le réseau.
Lorsqu'un développeur change d'équipe, ses appartenances aux groupes sont modifiées dans l'IdP. Étant donné que la passerelle évalue dynamiquement les politiques par rapport aux revendications OIDC récentes, le code Claude du développeur perd immédiatement l'accès aux serveurs MCP sensibles, sans aucune modification de configuration locale. Le départ d'un employé devient une simple modification dans l'IdP. Les changements de rôle, les transferts d'équipe et les résiliations de contrat se propagent de la même manière. La passerelle est le point de jonction où l'identité d'entreprise rencontre la boucle d'agent, et c'est à ce point que la gouvernance devient opérationnellement gérable au lieu de rester une aspiration permanente.
Claude Code sera déployé dans votre entreprise — si ce n'est pas ce trimestre, ce sera le prochain. La question est de savoir s'il sera déployé via un point de jonction que votre équipe plateforme contrôle, ou via un millier de fichiers de configuration individuels que votre équipe plateforme ne contrôle pas. Il n'y a qu'une seule de ces réponses qui résiste à un audit.
L'accès permanent à la production est le mauvais choix par défaut ; une élévation de privilèges limitée dans le temps est la bonne approche. Le modèle qui fonctionne en production : une règle Cedar/OPA distincte qui accorde à un ingénieur senior un rôle élevé pendant 30 minutes lorsqu'il soumet une demande justifiée via un flux d'approbation (un bot Slack, un incident PagerDuty, un ticket JIRA). L'élévation est elle-même enregistrée via la passerelle, le rôle expire automatiquement, et le journal d'audit capture à la fois la demande et les actions effectuées sous ce rôle. La passerelle n'a pas de code "break-glass" spécial — c'est le même flux de revendication JWT vers le contexte Cedar, juste avec un rôle différent et une durée d'expiration imposée par l'IdP.
La passerelle renvoie un code 403 structuré avec l'ID de la règle qui a refusé l'appel. Cet ID de règle est l'adresse d'une conversation : il pointe vers le fichier Cedar/OPA dans le dépôt de la plateforme, qui est révisable via une pull request normale. Si la politique est erronée, la correction se fait par une PR. Si la politique est correcte, le développeur dispose de la preuve dont il a besoin pour demander une exception via un canal distinct. Il n'y a pas d'interrupteur de contournement côté développeur par conception — cet interrupteur est précisément ce que la passerelle est censée éliminer.
Les invites d'autorisation locales de Claude Code sont utiles pour l'expérience utilisateur mais ne constituent pas une frontière de sécurité — elles résident sur la machine du développeur et peuvent être désactivées ou acceptées automatiquement. La passerelle se situe en dessous de ces invites et contrôle l'invocation réelle de l'outil. Les deux couches se complètent : les invites offrent au développeur une vérification de bon sens ; la passerelle fournit à l'organisation une politique. Considérez les invites comme une défense en profondeur, et non comme la couche porteuse.
Les politiques devraient refléter la structure des groupes de l'IdP plutôt que d'énumérer chaque paire (utilisateur, outil). Regroupez les développeurs en rôles dans l'IdP — développeur frontend, développeur backend, SRE, contractuel — et écrivez des politiques basées sur ces rôles. Les nouvelles recrues héritent de l'accès dès le premier jour via leur appartenance au groupe ; le départ d'un employé est une seule modification dans l'IdP. Le nombre de règles de politique devrait augmenter avec le nombre de catégories de serveurs MCP / d'outils, et non avec le nombre de développeurs.
Elle se trouve sur le chemin de requête, il est donc impératif de la concevoir pour une haute disponibilité. Le plan de la passerelle est sans état, s'exécute sous forme de multiples répliques et continue de servir avec la dernière configuration connue si le plan de contrôle est brièvement inaccessible. La nouvelle configuration est réconciliée via NATS et republiée intégralement toutes les 10 minutes comme filet de sécurité. Dans les déploiements en production, exécutez au moins trois répliques de passerelle à travers les zones de disponibilité et placez-les derrière un équilibreur de charge HTTP normal ; le mode de défaillance contre lequel vous devez concevoir est « un pod redémarre pendant une panne du plan de contrôle », et non « tous les pods redémarrent simultanément », ce qui est suffisamment rare pour être acceptable.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception