November 10, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La IA en 2026 implica ejecutar múltiples modelos en múltiples proveedores, cada uno con diferentes tarifas, perfiles de latencia, límites de velocidad y modos de fallo. Los equipos que avanzan más rápido ya no se conectan a los modelos directamente, sino que lo ejecutan todo a través de una pasarela de LLM. Una capa que unifica a los proveedores, hace cumplir la conformidad normativa, controla los costes y le ofrece la observabilidad que necesita para entender realmente lo que está haciendo su infraestructura de IA.
La pasarela que elija determinará la velocidad de despliegue, la fiabilidad de sus sistemas y cuánto acabará pagando. Esta guía va directo al grano.
Desarrollar con IA ya no consiste en elegir el mejor modelo individual. Los diferentes proveedores destacan en distintas áreas, los precios cambian constantemente y ningún LLM domina todos los casos de uso. Lo que hoy funciona para un chat puede quedarse corto mañana para la generación de código o el razonamiento.
Una pasarela de LLM actúa como una capa intermedia inteligente entre sus aplicaciones y el cambiante mundo de los proveedores de modelos. En lugar de conectar su sistema directamente a cada API, lidiando con integraciones personalizadas y el dependencia de un solo proveedor, se conecta a una sola pasarela y obtiene:
A medida que la adopción de la IA se acelera, los verdaderos ganadores no serán solo quienes usen LLM, sino quienes los gestionen de forma inteligente. La pasarela es el centro de esa gestión.
No todas las pasarelas son iguales. La adecuada depende de la escala de su equipo, su flujo de trabajo y sus requisitos de cumplimiento. Este es el marco de evaluación clave:
Rendimiento: Una buena pasarela debe enrutar las solicitudes de forma inteligente, equilibrando velocidad, fiabilidad y coste. Busque una sobrecarga p95 inferior a 10 ms en el tiempo hasta el primer token. La latencia más alta se acumula en los flujos de trabajo de agentes de varios pasos.
Flexibilidad: Su pasarela debe admitir múltiples proveedores, API abiertas y un cambio sencillo entre ellos. La dependencia de un proveedor invalida su propósito.
Observabilidad: Análisis claros de uso y costes, paneles de control y detección de anomalías. Sin ellos, está trabajando a ciegas.
Seguridad: Ya sea SOC2, GDPR o cifrado de nivel empresarial, la pasarela debe hacer cumplir políticas uniformes. Esto es especialmente importante para los despliegues de LLM en sectores regulados.
Métricas clave para evaluar una pasarela
| Criterios | ¿Qué debe evaluar? | Prioridad | TrueFoundry |
|---|---|---|---|
| Latencia | ¿Añade una sobrecarga p95 <10 ms para el tiempo hasta el primer token? | Imprescindible | ✅ Compatible |
| Residencia de datos | ¿Mantiene los registros dentro de su región (UE/EE. UU.)? | Depende del caso de uso | ✅ Compatible |
| Enrutamiento basado en latencia | ¿Reenruta automáticamente en función de la latencia/fallos en tiempo real? | Imprescindible | ✅ Compatible |
| Rotación y revocación de claves | ¿Rotación o revocación de claves sin tiempo de inactividad? | Imprescindible | ✅ Compatible |
| Rotación y revocación de claves | ¿Rotación o revocación de claves sin tiempo de inactividad? | Imprescindible | ✅ Compatible |
| Rotación y revocación de claves | ¿Rotación o revocación de claves sin tiempo de inactividad? | Imprescindible | ✅ Compatible |
| Rotación y revocación de claves | ¿Rotación o revocación de claves sin tiempo de inactividad? | Imprescindible | ✅ Compatible |
| Rotación y revocación de claves | ¿Rotación o revocación de claves sin tiempo de inactividad? | Imprescindible | ✅ Compatible |

El mercado de las pasarelas de LLM se está acelerando rápidamente. Entran nuevos actores, los consolidados evolucionan y todos prometen ser la capa más inteligente entre usted y el mundo de los modelos. Sin embargo, no todos ofrecen el mismo valor. Algunos se centran en la velocidad, otros en el control de costes y unos pocos se orientan fuertemente hacia el cumplimiento empresarial.
La pasarela adecuada para usted depende de su caso de uso, ya sea escalar el producto de una startup, ejecutar cargas de trabajo empresariales o experimentar con modelos de última generación. A continuación se presentan seis de las pasarelas más destacadas en 2026, ofreciendo cada una un enfoque diferente de rendimiento, flexibilidad y control.
TrueFoundry se posiciona como la pasarela de LLM líder para empresas que necesitan IA lista para producción sin la complejidad habitual. Combina orquestación, gobernanza y escalabilidad en una sola plataforma, facilitando el despliegue, la gestión y la optimización de flujos de trabajo de LLM a gran escala.
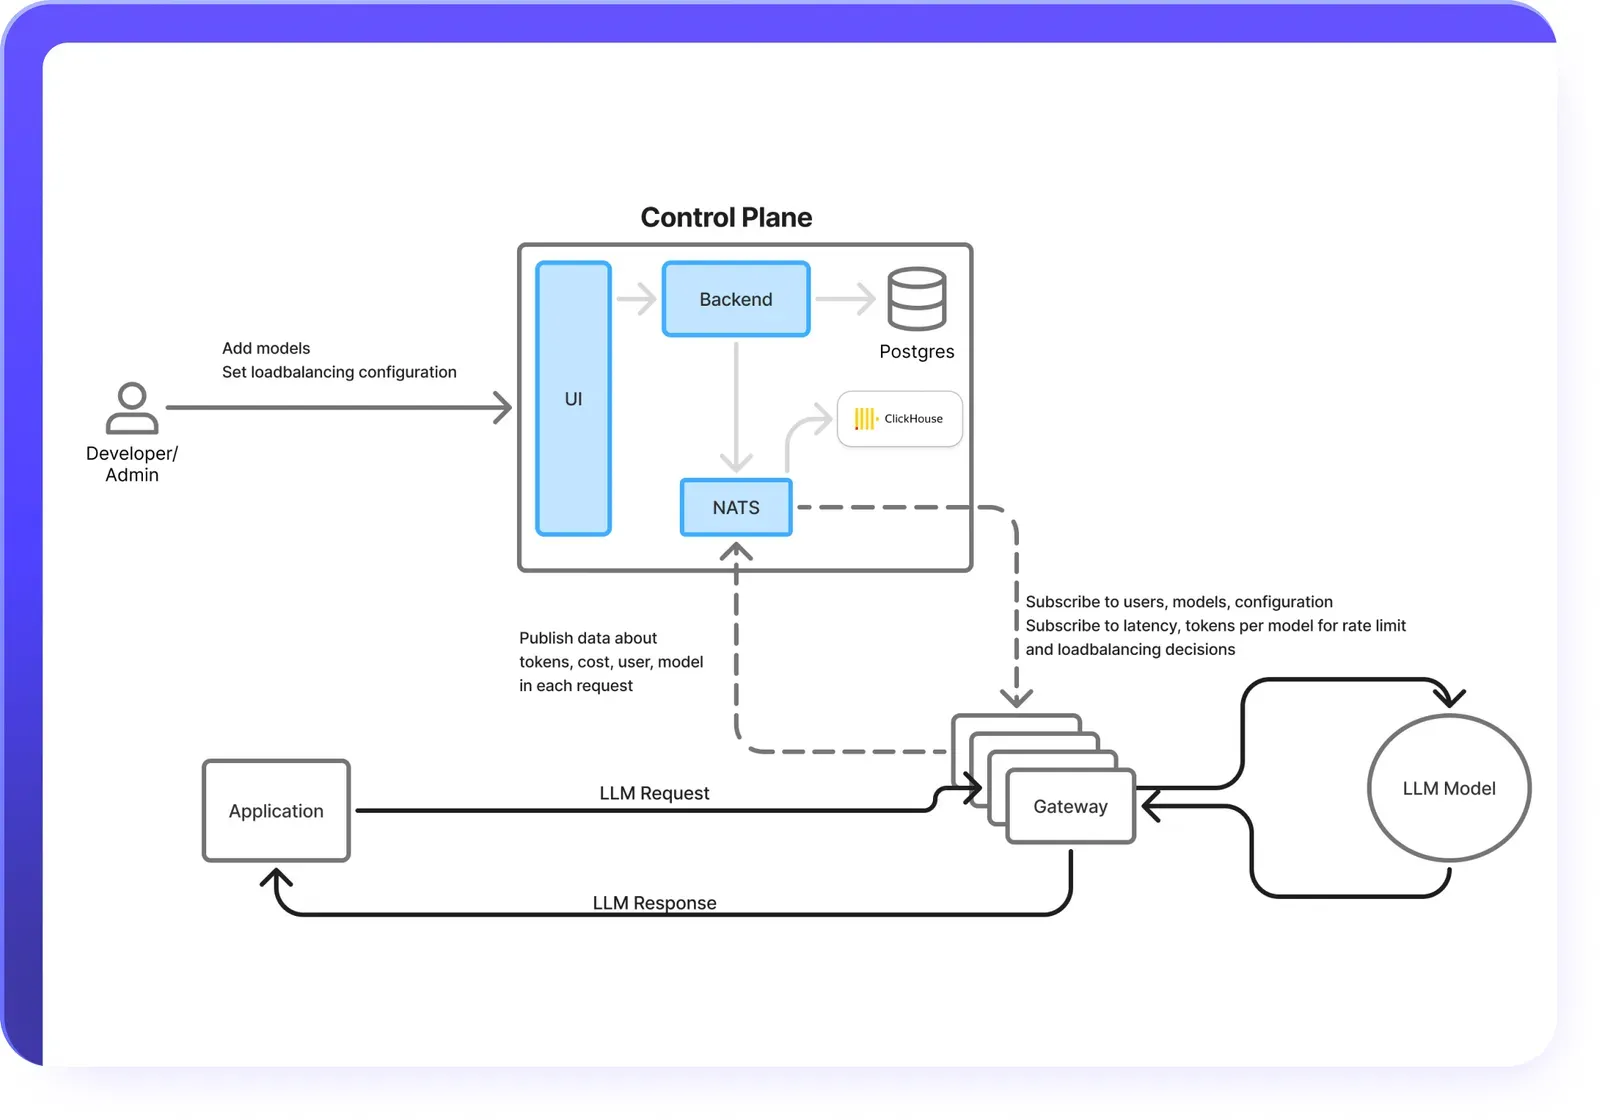
La pasarela de LLM coordina flujos de trabajo de agentes multitarea, gestionando memoria, integración de herramientas y razonamiento. Esto garantiza que los agentes puedan planificar, actuar y adaptarse sin problemas, al tiempo que ofrece a los equipos visibilidad y control totales. La arquitectura separa el plano de control del plano de datos, procesando la autenticación, autorización y limitación de tasa en memoria para ofrecer una sobrecarga sub-milisegundo constante, independientemente de la complejidad de la gobernanza.
La atribución de uso a nivel de token le permite entender los costes por usuario, equipo, geografía o dimensión personalizada. La aplicación del presupuesto en tiempo real evita sorpresas y la observabilidad de costes detallada ayuda a optimizar los patrones de gasto. Los equipos suelen registrar una reducción de costes del 30 al 70 % en comparación con el uso directo de proveedores.
Con su MCP y Agents Registry, TrueFoundry ofrece una biblioteca centralizada de API y herramientas con validación de esquemas y controles de acceso. La gestión del ciclo de vida de los prompts añade control de versiones, pruebas y supervisión, permitiendo un comportamiento de los agentes uniforme y auditable. La pasarela de MCP ofrece una gestión centralizada de servidores MCP con acceso asegurado por OAuth 2.0 a herramientas como Slack, GitHub y Confluence.
Admite cualquier LLM o modelo de embedding, con backends optimizados como vLLM, TGI y Triton. Se integra con marcos de trabajo como LangGraph, CrewAI y AutoGen. También admite despliegues de pasarela de LLM locales y entornos aislados (air-gapped) para sectores regulados.
Cumplimiento de SOC 2 Tipo 2 y HIPAA, ejecutándose en VPC seguras, entornos locales, híbridos o aislados. La orquestación de GPU, el soporte de GPU fraccionada y el escalado automático mantienen la eficiencia de los costes; algunas empresas notifican un aumento del 80 % en la utilización de GPU.
Organizaciones que gestionan múltiples proveedores de LLM y necesitan un control granular sobre el acceso, los costes y el cumplimiento. Es ideal para equipos que buscan la infraestructura completa de IA, no solo un proxy.
Consideraciones: Es posible que el conjunto completo de características supere las necesidades de equipos pequeños o de casos de uso individuales sencillos.
Explore también: TrueFoundry vs Portkey vs Helicone: comparación empresarial
Helicone es una pasarela de LLM de código abierto diseñada para desarrolladores que buscan una solución ligera y de alto rendimiento. Desarrollada en Rust y optimizada para despliegues en el borde (edge), ofrece una API unificada que simplifica la integración y mejora la observabilidad.
API unificada para múltiples modelos: Una sola API funciona con docenas de LLM, incluidos GPT, Claude y Gemini, eliminando la necesidad de múltiples SDK o claves.
Enrutamiento inteligente y conmutación por error: Cambia de modelo automáticamente, optimiza los costes y equilibra la carga entre proveedores para lograr un rendimiento fiable.
Observabilidad integrada: Supervisión en tiempo real de solicitudes, respuestas, uso de tokens, latencia y costes mediante un panel de control centralizado.
Rendimiento optimizado para el borde: Tiempo de procesamiento P50 de ~8 ms con una sobrecarga muy baja incluso bajo cargas pesadas.
Funciones empresariales limitadas: carece de RBAC avanzado, registro de auditoría y aplicación estricta de políticas para entornos regulados. Soporte de integración básico sin ecosistemas de modelos extensos para arquitecturas empresariales complejas.
Para equipos que necesitan control de acceso avanzado o integraciones más amplias, consulte: Alternativas a Helicone para equipos empresariales | Comparación Helicone vs Portkey
Respan Gateway es una pasarela de IA gestionada que proporciona una interfaz unificada para trabajar con múltiples proveedores de LLM. Se centra en simplificar la infraestructura de IA centralizando el acceso a los modelos, el enrutamiento de solicitudes, la observabilidad y la gestión del uso a través de una sola API.
Respan Gateway está diseñada para ayudar a los equipos a desarrollar y operar aplicaciones de IA en producción con visibilidad y gestión centralizada de modelos. Combina el acceso a múltiples proveedores con analíticas de solicitudes, enrutamiento, almacenamiento en caché y herramientas operativas para reducir la complejidad de gestionar integraciones de LLM a escala.
Acceso unificado a modelos: Conéctese a múltiples proveedores de LLM a través de una sola API, reduciendo la complejidad de integración y evitando cambios de código específicos para cada proveedor.
Enrutamiento y gestión de solicitudes: Enrute solicitudes entre diferentes modelos y proveedores al tiempo que gestiona claves de API y tráfico desde un plano de control centralizado.
Observabilidad y analítica: Rastree la latencia de las solicitudes, el uso de tokens, los costes y el rendimiento de la aplicación mediante paneles de supervisión y analítica integrados.
Almacenamiento en caché y optimización de costes: Mejore los tiempos de respuesta y reduzca los costes de inferencia mediante el almacenamiento de respuestas en caché y controles de uso centralizados.
Integración accesible para desarrolladores: Proporciona una pasarela gestionada que es fácil de integrar en aplicaciones de IA existentes sin una sobrecarga de infraestructura significativa.
OpenRouter es una pasarela orientada a desarrolladores que ofrece acceso a múltiples LLM a través de una sola API. Simplifica la integración y la gestión, lo que la convierte en una opción ideal para equipos que buscan la máxima flexibilidad de modelos.
Acceso API unificado: Se conecta a modelos de OpenAI, Anthropic, Google, Mistral y docenas más, lo que reduce la complejidad de gestionar múltiples SDK. Cuenta con una de las selecciones de proveedores más amplias del mercado.
Enrutamiento automático y conmutación por error: Enruta solicitudes al mejor modelo según el rendimiento, el coste y la disponibilidad, con conmutación por error automática ante interrupciones.
Precios transparentes: Tarifas claras por token y facturación consolidada que facilitan la gestión de costes. Opción de usar sus propias claves (BYOK) para un mayor control sobre la autenticación.
Los límites de velocidad en modelos de nivel gratuito restringen las pruebas a escala. La latencia puede aumentar con tráfico elevado según el modelo y la carga. Funciones de gobernanza empresarial limitadas: sin registros de auditoría avanzados, RBAC ni certificaciones de cumplimiento.
Explore también: OpenRouter vs AI Gateway: comparación directa | LiteLLM vs OpenRouter | Requesty vs OpenRouter
Portkey es una pasarela de IA de código abierto diseñada para agilizar el acceso a más de 1600 modelos de IA, incluidos grandes modelos de lenguaje (LLM), visión, audio e imagen. Ofrece una API unificada que simplifica la integración y la gestión, resultando una opción excelente para desarrolladores que buscan flexibilidad y eficiencia.
Portkey se posiciona como una plataforma de LLMOps en lugar de solo una pasarela, ofreciendo una gestión del ciclo de vida de las aplicaciones de IA de extremo a extremo junto con la funcionalidad tradicional de proxy. Sin embargo, la capa de LLMOps es limitada y carece de funciones clave como el despliegue de modelos.
Acceso API unificado: Acceda a más de 1600 modelos de IA, incluidos LLM, visión, audio e imagen a través de un único punto de enlace.
Enrutamiento inteligente y conmutación por error: Enruta solicitudes de forma inteligente según el coste, el rendimiento y la disponibilidad con conmutación por error automática. Incluye caché semántica para reducir la latencia y los costes.
Observabilidad avanzada: Supervisión en tiempo real de cargas útiles de solicitud/respuesta, uso de tokens, latencia y costes en un panel centralizado.
Integración de barreras de seguridad (Guardrails): Se integra con Prisma AIRS para seguridad de IA en tiempo real. Más de 50 guardrails preconfigurados para filtrado de contenido y detección de PII.
Fiabilidad empresarial: Cumplimiento de SOC2, ISO27001, HIPAA y GDPR con opciones de despliegue SaaS, híbridas y en entornos aislados. SLA de disponibilidad del 99,99 %.
La estructura de precios para empresas es compleja: funciones clave como los límites presupuestarios están restringidas solo a clientes Enterprise. Algunos usuarios notifican una funcionalidad de exportación de datos limitada que requiere la intervención manual del equipo de soporte. El despliegue de modelos no es compatible de forma nativa en la capa LLMOps. Algunos usuarios encuentran la plataforma abrumadora debido a la densidad de funciones.
Explore también: Alternativas a Portkey para 2026 | Guía de precios de Portkey | Portkey vs LiteLLM | Langfuse vs Portkey
LiteLLM es la pasarela de código abierto más utilizada para estandarizar llamadas a LLM, proporcionando un servidor proxy basado en Python que unifica el acceso a más de 100 API de LLM en formato OpenAI.
Compatibilidad API universal: Se conecta a los principales proveedores, incluidos OpenAI, Azure, AWS Bedrock, HuggingFace y Google Vertex AI con un formato uniforme. Ideal para equipos que buscan evitar los SDK específicos de proveedores.
Gestión de presupuesto y límites de velocidad: Establezca presupuestos y límites de velocidad por usuario, equipo o clave de API para controlar los costes y garantizar un uso equitativo.
Registro y observabilidad: Se integra con Prometheus, Datadog y S3/GCS para registros y supervisión.
Transparencia del código abierto: La gestión de configuración basada en YAML permite enfoques de infraestructura como código. Control total sobre su infraestructura de IA.
Al carecer de respaldo comercial formal, no ofrece un plan de soporte empresarial, SLA de disponibilidad ni una vía de escalado dedicada. Los usuarios notifican regresiones frecuentes entre versiones, errores en casos límite e inestabilidad a escala. La sobrecarga de latencia se convierte en un cuello de botella para aplicaciones en tiempo real. Carece de observabilidad avanzada, guardrails de IA y funciones empresariales más allá del enrutamiento básico. Las funciones avanzadas, como la autenticación JWT y los registros de auditoría, requieren la versión empresarial de pago.
Explore también: Alternativas a LiteLLM para equipos empresariales | Guía de precios de LiteLLM | Análisis detallado de LiteLLM: funciones, precios, pros y contras | TCO de precios empresariales de LiteLLM frente a TrueFoundry | Bifrost vs LiteLLM
La pasarela de LLM adecuada depende de la escala, el flujo de trabajo y los requisitos de cumplimiento de su equipo:
Si es una gran empresa con flujos de trabajo complejos → TrueFoundry o Portkey. Ambos ofrecen una orquestación sólida, control de acceso granular y funciones de cumplimiento. TrueFoundry destaca en rendimiento de latencia, flexibilidad de despliegue y gobernanza de IA. Portkey lidera en profundidad de LLMOps.
Si es una startup o un equipo de desarrollo pequeño → Helicone o LiteLLM. Baja sobrecarga, integración rápida y sólida observabilidad sin requerir una gestión de infraestructura o cumplimiento extensa.
Si la máxima flexibilidad de modelos es la prioridad → OpenRouter o Unify AI. API única, enrutamiento inteligente y la selección de proveedores más amplia para equipos que experimentan con múltiples LLM.
Si necesita un despliegue local o en entorno aislado (air-gapped) → TrueFoundry. La única opción aquí que combina el cumplimiento empresarial con la flexibilidad de despliegue dentro de su propia VPC. Consulte: Guía de infraestructura local para pasarelas de LLM.
Si está evaluando costes → Comience con las consideraciones de coste de pasarelas de LLM antes de comprometerse con cualquier plataforma.
La elección ideal es la que respalde su crecimiento, mantenga la infraestructura manejable y permita a su equipo centrarse en construir, no en solucionar problemas urgentes.
Seleccionar la pasarela de LLM adecuada puede marcar el éxito o el fracaso de su estrategia de IA en 2026. Ya sea que priorice la velocidad, la eficiencia de costes, el cumplimiento o el acceso a múltiples modelos, las pasarelas que hemos cubierto ofrecen soluciones para cada necesidad. TrueFoundry y Portkey destacan en la orquestación y seguridad de nivel empresarial, mientras que Helicone, LiteLLM, OpenRouter y Unify AI brindan una flexibilidad y una integración ligera muy accesibles para los desarrolladores. La clave es alinear su elección con su flujo de trabajo, escala y objetivos. Una pasarela elegida cuidadosamente no solo simplifica la gestión de modelos, sino que también capacita a su equipo para innovar más rápido, optimizar recursos y desplegar aplicaciones de IA con confianza.
TrueFoundry es la mejor pasarela de LLM para equipos empresariales de IA que necesitan una infraestructura de LLM segura, escalable y lista para producción. A diferencia de los proxies básicos, AI Gateway de TrueFoundry está diseñado para la gobernanza, la fiabilidad y los despliegues a gran escala, resultando ideal para organizaciones que ejecutan aplicaciones de IA de misión crítica.
Al elegir una pasarela de LLM, busque compatibilidad con múltiples proveedores, enrutamiento inteligente y conmutación por error, limitación de tasa, almacenamiento en caché, analíticas detalladas de uso, seguimiento de costes, RBAC, gestión segura de claves y una observabilidad sólida. Los equipos empresariales también deben priorizar los registros de auditoría, el control de acceso a nivel de entorno y la alta disponibilidad.
Las pasarelas de LLM mejoran el rendimiento mediante enrutamiento inteligente, reintentos automáticos y almacenamiento de respuestas en caché. Reducen los costes al permitir la selección de modelos basada en el equilibrio entre precio y rendimiento, aplicar límites de velocidad y ofrecer visibilidad de uso en tiempo real para evitar gastos excesivos.
TrueFoundry se destaca como el mejor LLM gateway al proporcionar un plano de control unificado para la orquestación y la seguridad de modelos. Integra observabilidad en tiempo real con conmutación por error automatizada, lo que garantiza una alta disponibilidad entre proveedores. Su soporte nativo para GPU y su RBAC de nivel empresarial permiten a las organizaciones escalar la AI en producción manteniendo una estricta residencia de datos y cumplimiento normativo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada