October 26, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
تعتمد التطبيقات التي تستخدم النماذج اللغوية الكبيرة على مزودي نماذج الذكاء الاصطناعي في كل طلب استنتاج. وعلى الرغم من أن شركات مثل OpenAI وAnthropic وGoogle تقدم خدماتها، إلا أنه لا يوجد مزود للنماذج اللغوية الكبيرة يضمن خلو الخدمة تماماً من قيود المعدل، أو الانقطاعات، أو طفرات التأخير. لذا، يمكن لأي مشكلة لدى المزود أن تعطل تطبيقات وسير عمل النماذج اللغوية الكبيرة.
بدون مسار تبديل تلقائي، قد يفشل الطلب، أو يتجاوز أهداف الاستجابة، أو يؤدي إلى تجربة مستخدم غير متسقة. يعمل هذا النمط على توجيه الطلبات المتأثرة عبر نموذج أو مزود آخر عندما لا يلبي المسار الأولي المتطلبات المحددة. وهذا يحافظ على استمرارية الخدمة دون كشف أعطال البنية التحتية لمستخدمي التطبيق.
يعد التنفيذ الموثوق أمراً بالغ الأهمية كلما استخدمت أنظمة الإنتاج نماذج أو مناطق أو مزودين متعددين. يمكن لـ بوابة النماذج اللغوية الكبيرة (LLM Gateway) مركزية التوجيه، والمرونة، وتطبيق السياسات خلف واجهة واحدة. تساعد هذه البنية فرق الإنتاج على تجنب تضمين منطق الاسترداد الخاص بكل مزود في كل تطبيق على حدة.
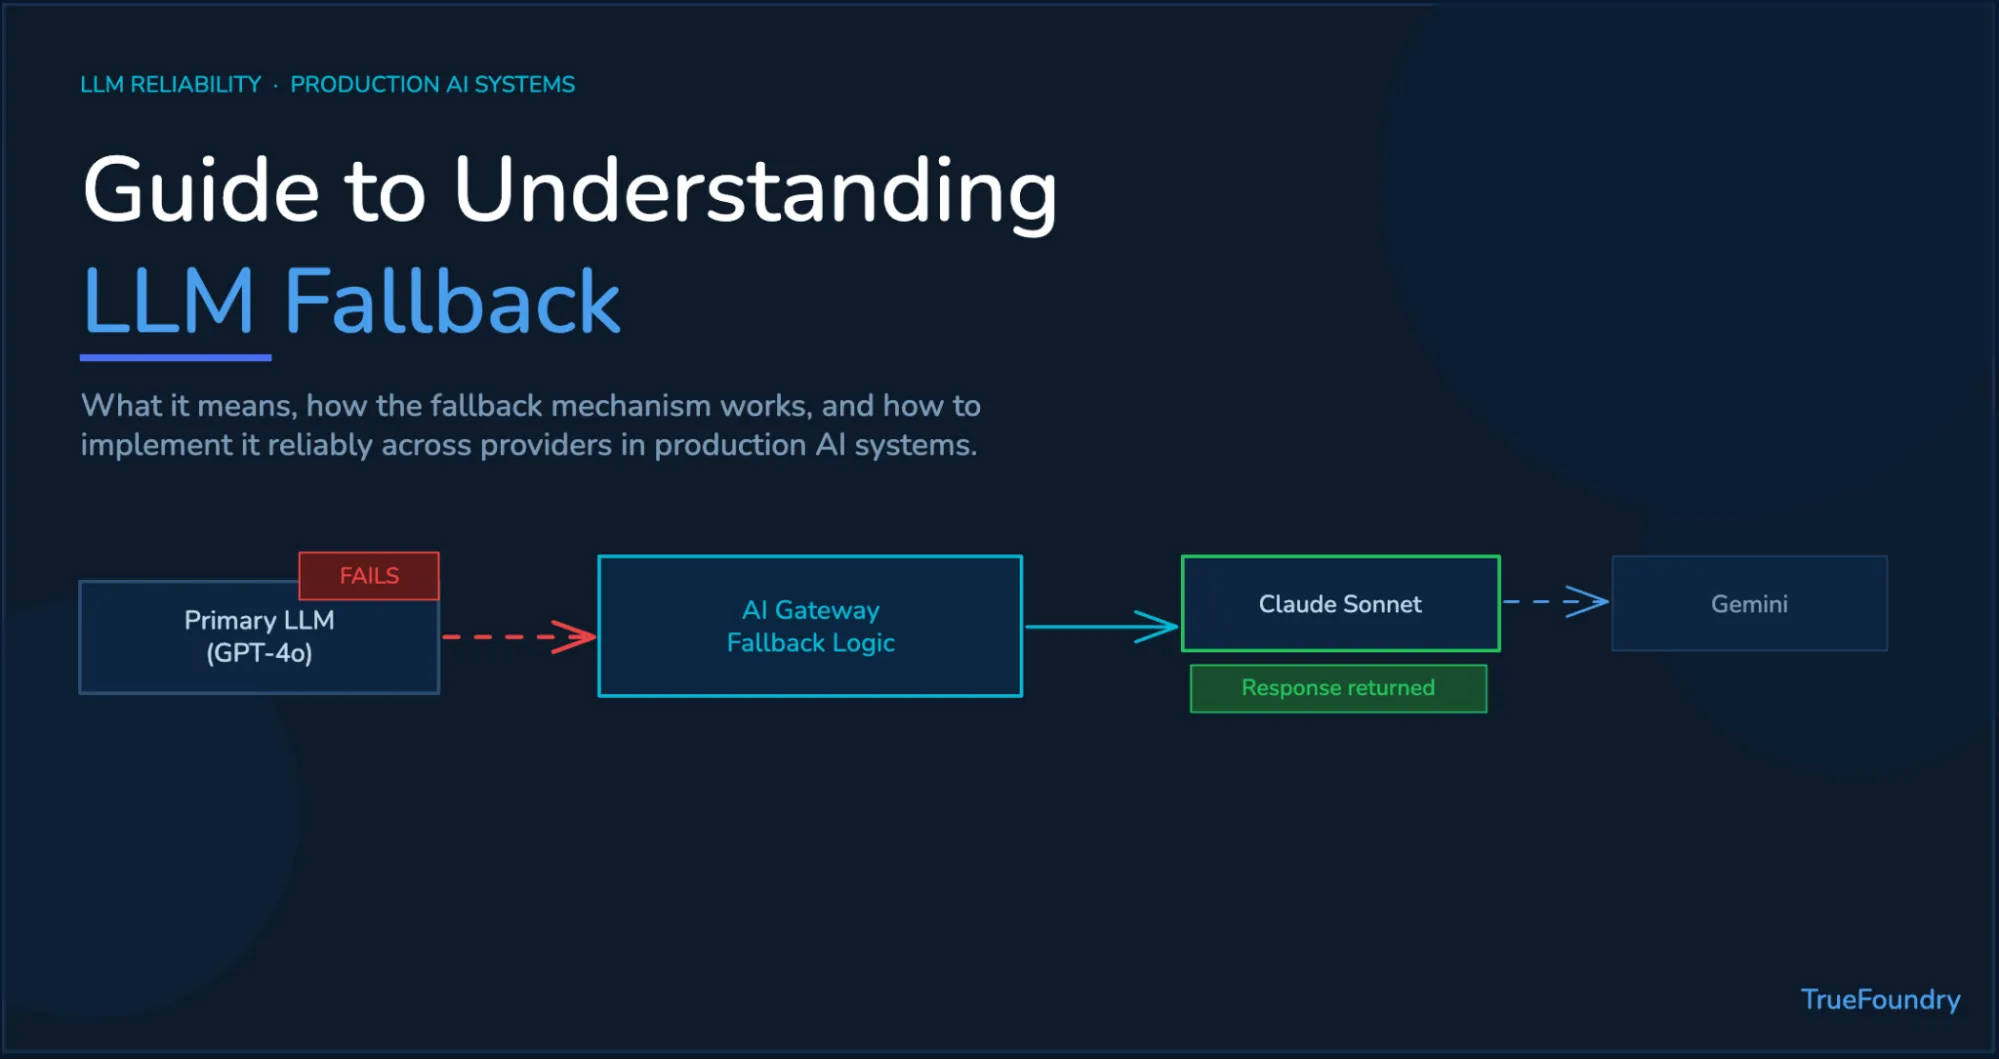
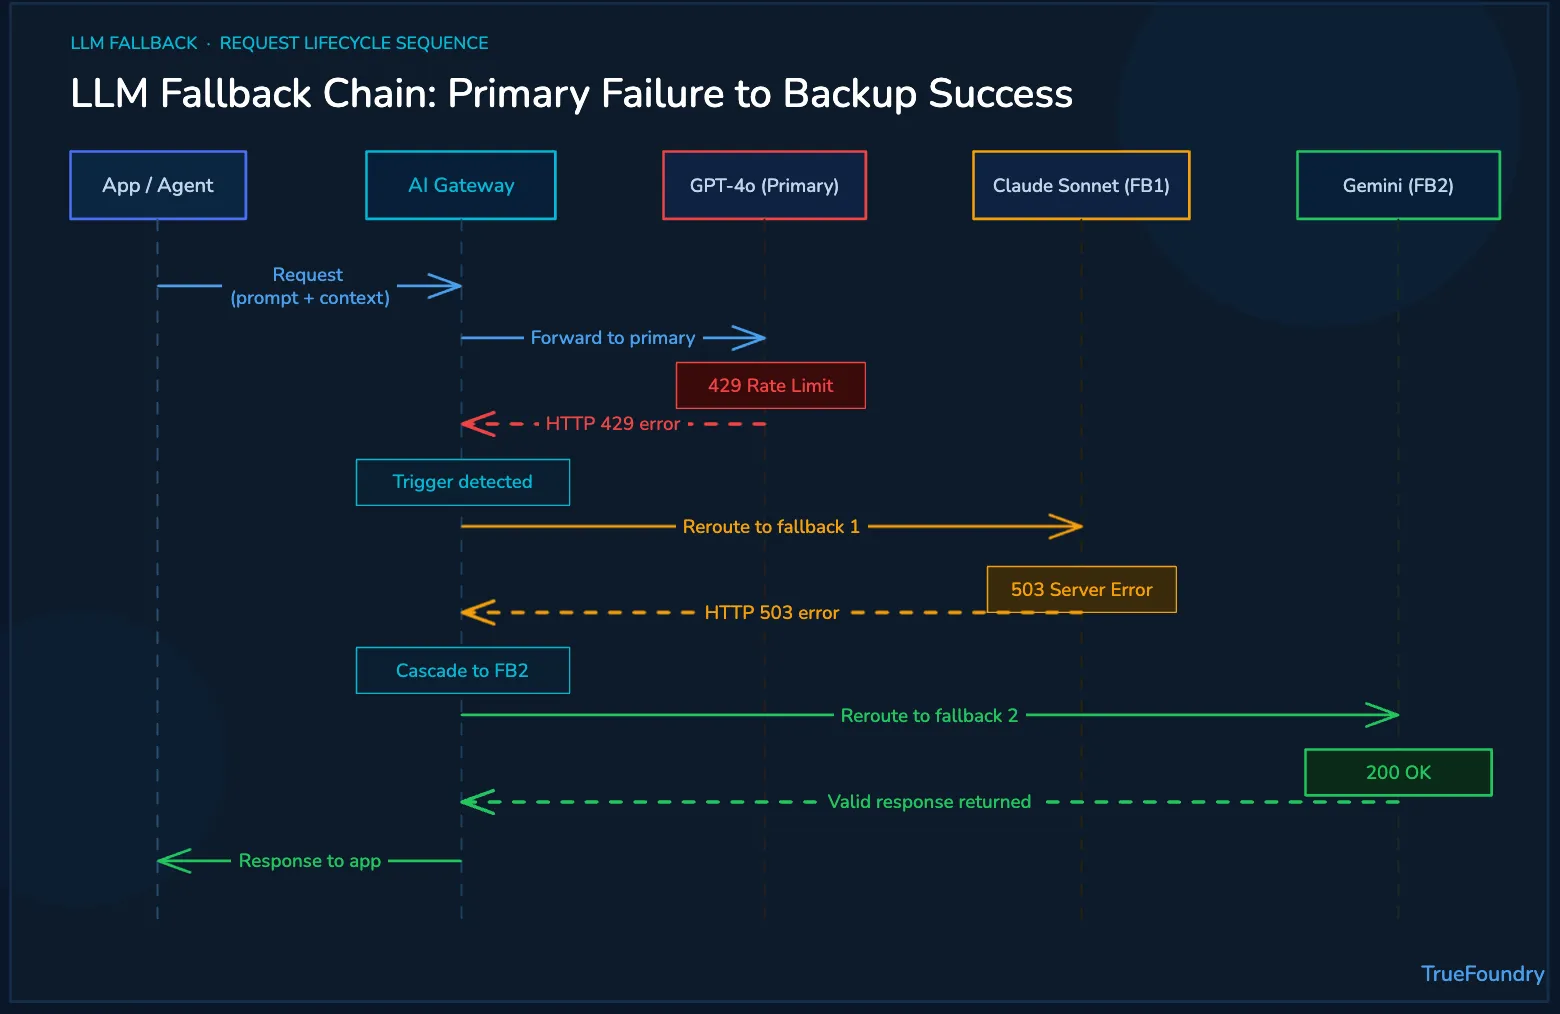
نمط الموثوقية هذا يقوم بإعادة توجيه الطلب تلقائياً عندما يفشل النموذج الأساسي في تلبية متطلبات التوفر أو التأخير أو الجودة المحددة. قد تشمل مسببات التبديل استجابة HTTP 429، أو خطأ في الخادم، أو خطأ في الشبكة، أو تجاوز المهلة المحددة. بعد ذلك، ينتقل الطلب إلى نموذج تبديل مناسب عبر مسار بديل.
يتجاوز معنى التبديل التلقائي للنماذج اللغوية الكبيرة مجرد استرداد الأخطاء المعزولة؛ فهو يمثل طبقة مرونة ضمن بنية الوصول إلى النماذج. يقلل هذا النهج من الاعتماد على مزود واحد للنماذج اللغوية الكبيرة، مع مساعدة التطبيقات على البقاء متاحة أثناء فترات عدم استقرار المزود.
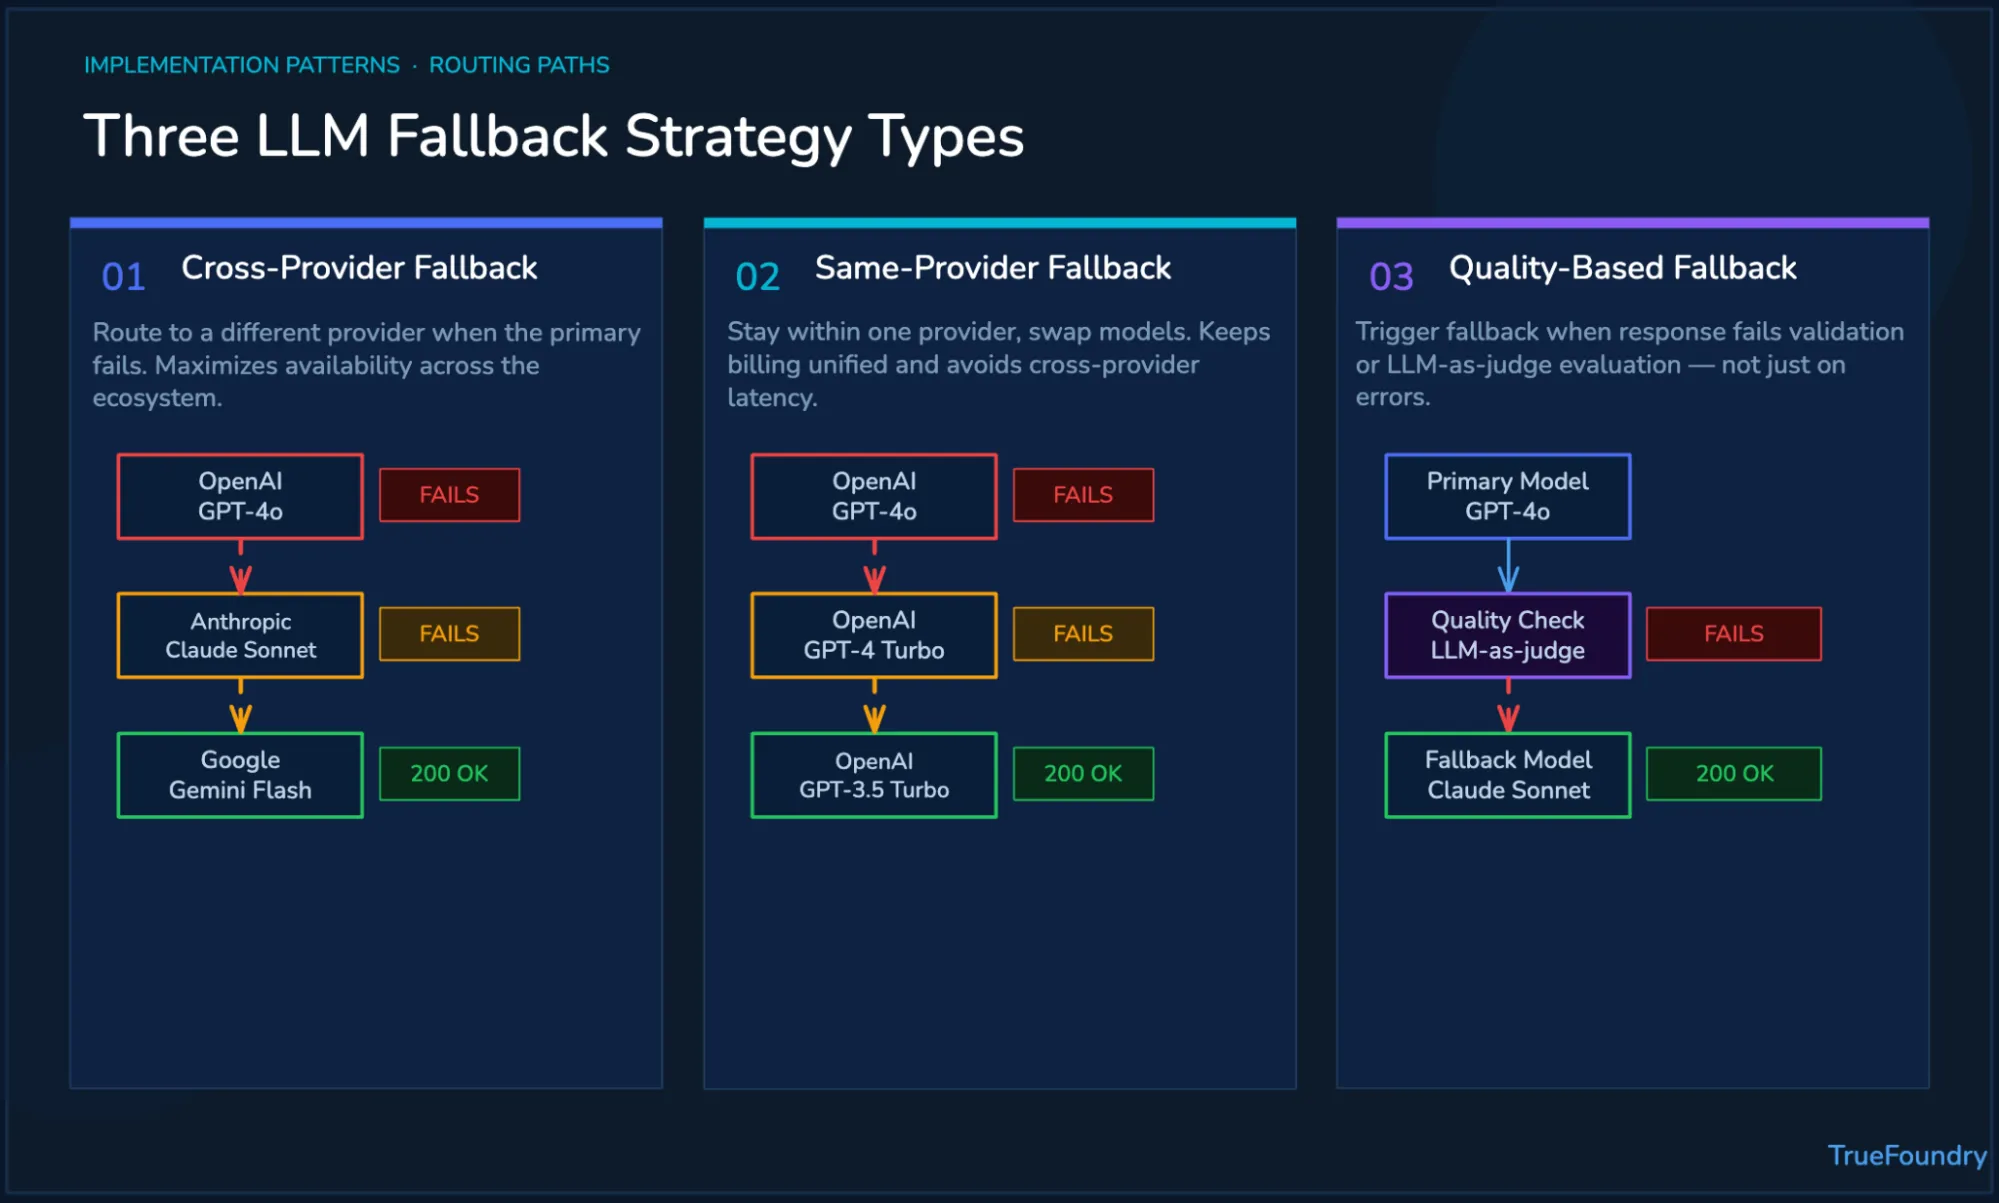
يمكن أن يعمل التبديل التلقائي عبر مزودين أو نماذج أو مناطق أو عتبات جودة مختلفة. كما يمكن لنموذج واحد أن يتحول إلى نشر آخر ضمن نفس المزود. يجب أن يحافظ التصميم المختار على التوافق عبر المطالبات (Prompts)، والرموز (Tokens)، ونوافذ السياق، ودعم الأدوات، وتنسيقات الاستجابة.
تتبع آلية التبديل التلقائي للنماذج اللغوية الكبيرة تسلسلاً محكماً بعد فشل الطلب. يقوم الموجه (Router) بتقييم المسبب، وقراءة سلسلة التبديل المكونة، واختيار الهدف التالي المؤهل. بعد ذلك، تنتقل المطالبة الأصلية والسياق وإعدادات التوليد عبر مسار التبديل المختار.
يجب أن تعالج عمليات إعادة المحاولة الإخفاقات المؤقتة قبل تغيير مزودي الخدمة. تستخدم السياسات المحدودة التراجع الأسي، والتشويش، وتوجيهات الاستجابة قبل إعادة التوجيه. توصي OpenAI بالتراجع العشوائي، بينما توثق Anthropic حدود المعدل، ومهلات الانتظار، والاستجابات عند التحميل الزائد.
تعالج آليات التراجع، وتجاوز الفشل، وإعادة المحاولة مشكلات مترابطة عبر نطاقات تشغيل مختلفة. يتعامل التراجع مع إخفاقات الطلبات الفردية، بينما يعيد تجاوز الفشل توجيه حركة المرور الأوسع أثناء فترات التعطل المستمرة. أما إعادة المحاولة فتكرر الطلب على نفس نقطة النهاية قبل أن يتلقاه هدف آخر.
تعمل هذه الأنماط الشائعة عادةً معاً ضمن بنيات مرنة. يمكن لعمليات إعادة المحاولة المحدودة حل الأخطاء قصيرة المدى دون الحاجة إلى تغيير مزودي الخدمة. موازنة حمل نماذج اللغة الكبيرة توزع حركة المرور العادية، بينما يحمي تجاوز الفشل استمرارية العمل أثناء الانقطاعات المستمرة. ويتولى التراجع معالجة الإخفاقات المتبقية على مستوى الطلب.
تدعم استراتيجيات التراجع المختلفة التوفر، والجودة، والتكلفة، واستقلالية المزود. تتطلب كل استراتيجية شروط تشغيل واضحة وقدرات نموذج متوافقة. يجب على الفرق مقارنة زمن الاستجابة المتوقع، وجودة المخرجات، وحدود السياق، ودعم الأدوات قبل تحديد أولويات المسار.
يجب أن يتسم تحديد معدل الطلبات بالفعالية والتنسيق مع كل استراتيجية بدلاً من التسبب في إعادة توجيه غير منضبطة. وتعمل أدوات التحكم في معدل الطلبات على تطبيق حصص محددة عبر المستخدمين والنماذج والتطبيقات والبيئات. توثق جوجل استجابات HTTP 429 عندما تتجاوز أعباء عمل Gemini الحصص المطبقة.
يبدو بناء منطق احتياطي داخل كود التطبيق أمراً سهلاً في مراحل التطوير الأولى، لكن التعقيد يزداد عندما يشمل الإعداد عدة مزودين وإصدارات نماذج وبيئات مختلفة. فكل حزمة تطوير برمجيات (SDK) تكشف عن أخطاء وقيم افتراضية وهياكل استجابة وسلوكيات إعادة محاولة مختلفة.
قد تقيم الفرق منصات مثل Portkey أو Bifrost أو Vercel عند مقارنة خيارات البوابة. وأياً كانت المنصة المختارة، تتطلب أفضل الممارسات عمليات إعادة محاولة محدودة، وتوجيهاً واعياً بحالة النظام، وبيانات اعتماد آمنة، واسترداداً قابلاً للقياس. يجب أن تُظهر مراقبة النماذج اللغوية الكبيرة (LLM) زمن الاستجابة، والأخطاء، وتكرار اللجوء للآلية الاحتياطية، ومعدل النجاح النهائي.
يُعد بوابة TrueFoundry للذكاء الاصطناعي مركزاً موحداً للوصول إلى النماذج، وتوجيه الطلبات، وضوابط الموثوقية، والمراقبة. يدعم تكوين التوجيه العالمي موازنة الأحمال، والتحويل التلقائي، وقواعد إعادة المحاولة من طبقة تحكم واحدة. يمكن للتطبيقات استخدام واجهة برمجة تطبيقات (API) واحدة دون الحاجة لإعادة بناء منطق الاسترداد لكل مزود على حدة.
تدعم المنصة سلاسل توجيه عبر مزود أساسي وأهداف بديلة. وتتولى عمليات إعادة المحاولة التلقائية معالجة أخطاء المزود المؤقتة قبل إعادة التوجيه. كما تساهم المراقبة المستمرة للحالة في تقليل تأخير الاسترداد أثناء حدوث أي اضطرابات.
بالنسبة لوكلاء الذكاء الاصطناعي، تتولى بوابة الوكلاء (Agent Gateway) إدارة التنفيذ متعدد الخطوات. بينما تقوم بوابة MCP بالتحكم في الوصول عبر أدوات المؤسسة المتصلة. ومعاً، توفر هذه البوابات الحماية للنظام بأكمله في حال تعذر الوصول إلى أحد مسارات النماذج.
ابنِ تطبيقات ذكاء اصطناعي مرنة باستخدام بوابة TrueFoundry للذكاء الاصطناعي. وحّد عمليات التوجيه، وإعادة المحاولة، والمراقبة، والتحويل التلقائي بين النماذج اللغوية الكبيرة (LLM) عبر مختلف المزودين. احجز عرضاً توضيحياً مجانياً اليوم للبدء.
يُعد نظام النسخ الاحتياطي (Fallback) للنماذج اللغوية الكبيرة متطلباً معمارياً للتطبيقات الموثوقة التي تستخدم نماذج خارجية. فقد يفرض مقدمو الخدمات قيوداً أو يواجهون أعطالاً مؤقتة أثناء التشغيل، لذا ينبغي للتطبيقات استيعاب هذه الظروف دون نقل كل اضطراب إلى المستخدمين.
لا يزال التنفيذ على مستوى التطبيق ممكناً، لكن التعقيد يزداد في البيئات التي تعتمد على نماذج متعددة. يمكن للبوابة (Gateway) مركزة قواعد إعادة المحاولة، وترتيب النسخ الاحتياطي، وفحوصات السلامة، وبيانات الاعتماد، والمراقبة. يعمل هذا النهج على تحسين المرونة مع الحفاظ على استقلالية كود التطبيق عن سلوكيات كل مزود على حدة.
يجب على الفرق تحديد المشغلات، والتحقق من توافق النماذج، ومراقبة كل مسار بعد النشر. كما ينبغي عليهم اختبار سلاسل النسخ الاحتياطي عند استنفاد الخيارات وسلوكيات التعافي قبل توسيع نطاق حركة المرور في بيئة الإنتاج. TrueFoundry توفر لوحة تحكم موحدة لإدارة قرارات الوصول إلى النماذج.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد