August 31, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Published: October 12, 2026
Blazingly fast way to build, track and deploy your models!
مع انتقال نماذج اللغة الكبيرة من مرحلة التجريب إلى الإنتاج، تعيد الفرق التفكير في كيفية إدارة حركة مرور الذكاء الاصطناعي وتأمينها ومراقبتها. ما كان يبدو في السابق مجرد تكامل بسيط لواجهة برمجة تطبيقات (API) أصبح الآن يتضمن المطالبات والرموز وتوجيه النماذج وإعادة المحاولات وتتبع التكاليف ومخاوف الموثوقية، وهي أمور لم تُصمم البنية التحتية التقليدية للتطبيقات للتعامل معها أبدًا.
تبدأ العديد من فرق الهندسة هذه الرحلة من خلال توسيع بوابات واجهة برمجة التطبيقات (API) المألوفة مثل كونج، بالاستفادة من أنماط التوجيه والمصادقة وتحديد المعدل الحالية. مع تزايد استخدام نماذج اللغة الكبيرة (LLM)، تظهر بوابات الذكاء الاصطناعي الأصلية مثل بورتكي تدخل الصورة، مقدمةً تجريدات مصممة خصيصًا للمطالبات والنماذج وإمكانية المراقبة على مستوى الرمز المميز.
يهدف كلا النهجين إلى حل مشكلات حقيقية لكنهما ينبعان من نقاط انطلاق مختلفة جوهريًا. كونج متجذر في إدارة واجهات برمجة تطبيقات HTTP والخدمات المصغرة، بينما تم تصميم بورتكي خصيصًا لسير عمل تطبيقات نماذج اللغة الكبيرة (LLM). تصبح الاختلافات بين هذه الفلسفات ذات أهمية متزايدة مع توسع أنظمة الذكاء الاصطناعي عبر الفرق والبيئات وحالات الاستخدام في الإنتاج.
في هذه المقالة، نقارن بين كونج وبورتكي من حيث البنية، وإمكانية المراقبة، والحوكمة، وجاهزية المؤسسات. سننظر في المكان الأنسب لكل أداة، وأين تبدأ القيود في الظهور، وما الذي يجب على فرق المنصات مراعاته مع تحول الذكاء الاصطناعي إلى جزء أساسي من مكدس البنية التحتية الخاص بهم.
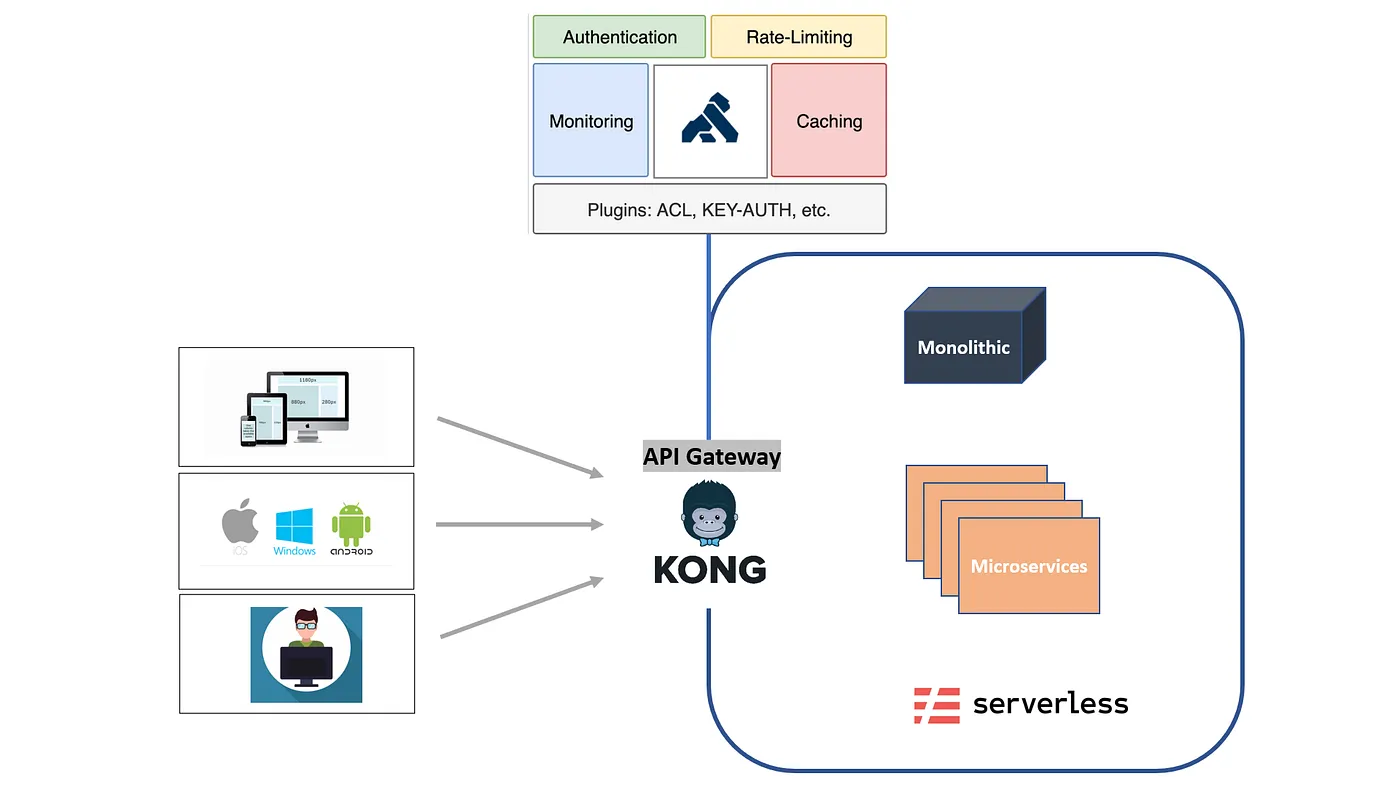
كونج هي بوابة واجهة برمجة تطبيقات (API) معتمدة على نطاق واسع، مصممة لإدارة وتأمين وتوجيه حركة مرور HTTP عبر الخدمات المصغرة. تُستخدم عادةً كطبقة دخول في البنى القائمة على Kubernetes وتشتهر بالتعامل مع أمور مثل المصادقة، وتحديد المعدل، وتوجيه حركة المرور، وإمكانية المراقبة على مستوى الطلب.
من الناحية المعمارية، تم تحسين كونج لـ الأنظمة التي تعتمد على واجهة برمجة التطبيقات (API) أولاً. تدور تجريداته الأساسية حول نقاط النهاية والخدمات والمسارات والمكونات الإضافية، مما يجعله مناسبًا بقوة لبيئات الواجهة الخلفية التقليدية والخدمات المصغرة حيث تكون الطلبات عديمة الحالة وقابلة للتنبؤ وموحدة.
مع قيام الفرق بتقديم نماذج اللغة الكبيرة (LLM)، غالبًا ما يكون Kong هو الأداة الأولى التي يتم إعادة توظيفها لإدارة حركة مرور الذكاء الاصطناعي - حيث يتم التعامل مع استدعاءات نماذج اللغة الكبيرة (LLM) كنقطة نهاية API أخرى. وهذا يعمل مبدئيًا من أجل:
ومع ذلك، فإن حركة مرور نماذج اللغة الكبيرة (LLM) تقدم خصائص لا تتوافق بشكل واضح مع واجهات برمجة التطبيقات التقليدية.
مع تزايد استخدام الذكاء الاصطناعي بما يتجاوز التجارب البسيطة، تصبح هذه الثغرات واضحة بشكل متزايد، خاصة في البيئات متعددة الفرق أو الحساسة للتكلفة.
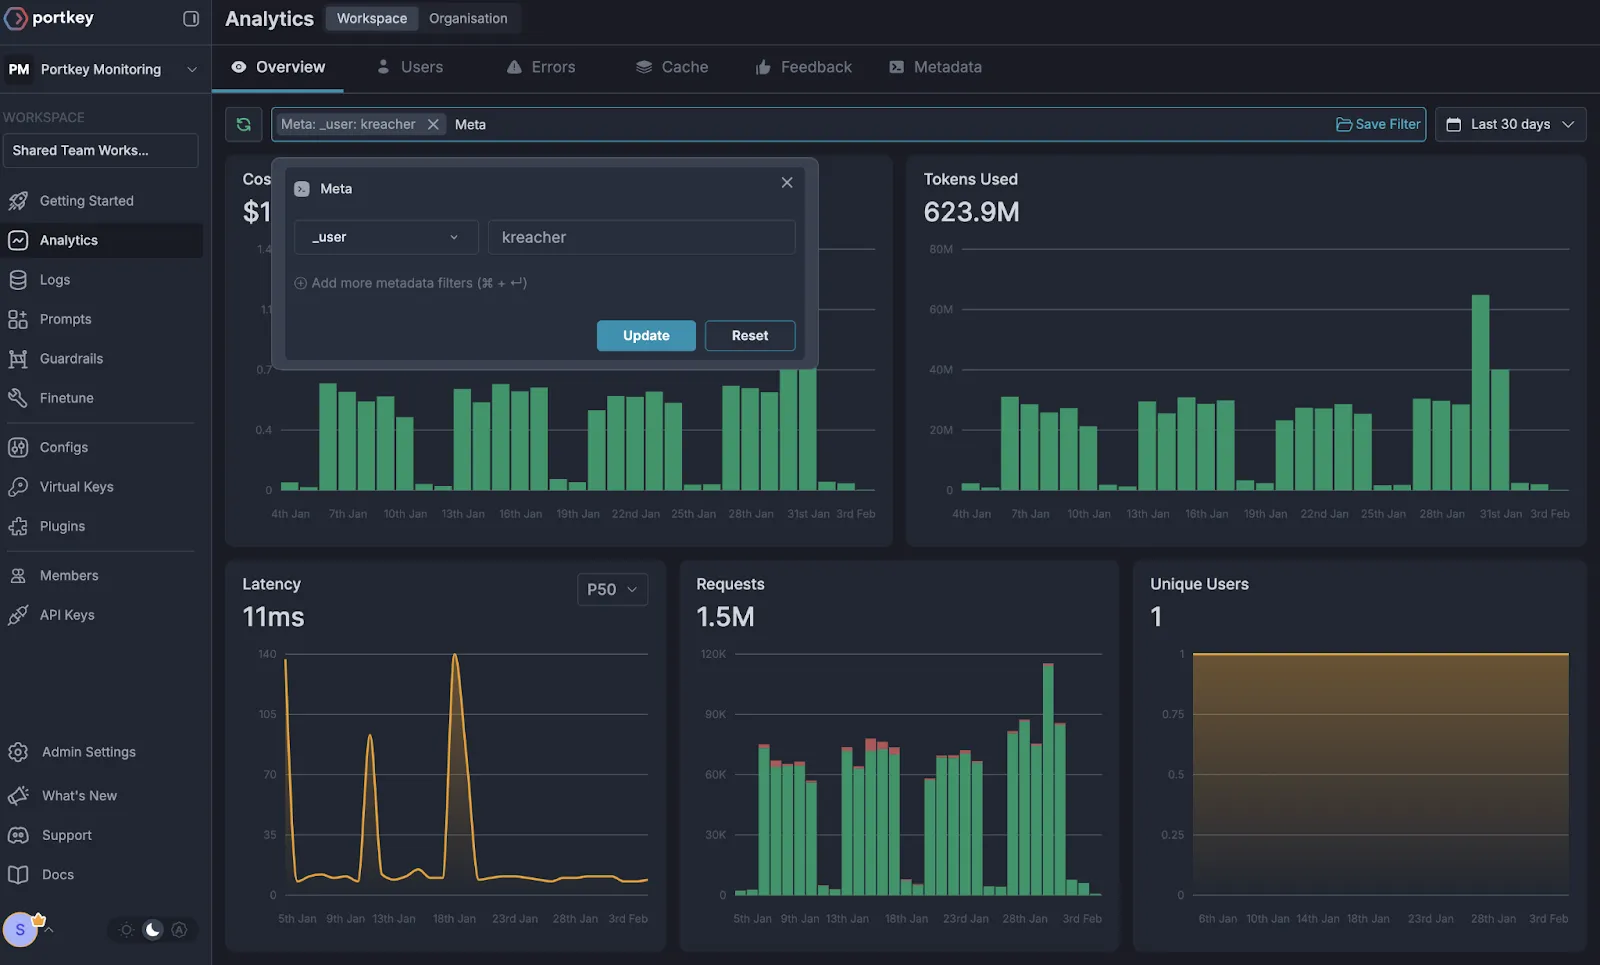
بورتكي هو بوابة مصممة للذكاء الاصطناعي خصيصًا للتطبيقات المبنية على نماذج اللغة الكبيرة. فبدلاً من التعامل مع استدعاءات نماذج اللغة الكبيرة كطلبات واجهة برمجة تطبيقات عامة، يقدم بورتكي تجريدات تتوافق مع كيفية عمل تطبيقات الذكاء الاصطناعي فعليًا - المطالبات، والنماذج، والرموز، والمزودين.
في جوهره، يعمل بورتكي كطبقة وسيطة بين تطبيقات الذكاء الاصطناعي ومزودي نماذج اللغة الكبيرة المتعددين. وهو يمكّن المطورين من التبديل بين النماذج، وتوجيه حركة البيانات، ومراقبة الاستخدام دون ربط كود التطبيق بإحكام بواجهة برمجة تطبيقات مزود معين.
مقارنة ببوابات واجهة برمجة التطبيقات مثل Kong، فإن بورتكي هو مصمم ليكون واعياً بنماذج اللغة الكبيرة. وهي تدرك أن:
وهذا يجعل Portkey خيارًا قويًا للفرق التي تقوم ببناء وتطوير التطبيقات المدعومة بنماذج اللغة الكبيرة (LLM)، خاصة في بيئات الإنتاج المبكرة أو المتوسطة.
مع توسع استخدام نماذج اللغة الكبيرة (LLM) عبر الفرق والبيئات، تظهر بعض القيود:
تصبح هذه القيود مهمة عندما ينتقل الذكاء الاصطناعي من كونه ميزة تطبيق إلى قدرة مؤسسية مشتركة.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
بينما كونغ و بورتكي يمكن لكليهما التعامل مع أعباء عمل الذكاء الاصطناعي، إلا أنهما مبنيان على افتراضات معمارية مختلفة تمامًا. فهم هذا الاختلاف أمر بالغ الأهمية لفرق المنصات التي تقرر كيفية توسيع نطاق الذكاء الاصطناعي بما يتجاوز تطبيقًا واحدًا.
كونغ خيار جيد إذا:
في هذا الإعداد، يعمل كونغ كـ امتداد مؤقت للبنية التحتية الحالية لواجهة برمجة التطبيقات (API).
يناسب بورتكي جيدًا عندما:
يتألق Portkey في طبقة التطبيق، خاصة لفرق منتجات الذكاء الاصطناعي سريعة التطور.
كلاهما Kong و Portkey يعالجان تحديات حقيقية في بنية الذكاء الاصطناعي، لكنهما يفعلان ذلك على مستويات مختلفة ومحدودة في نهاية المطاف. تتضح هذه القيود مع تطور الذكاء الاصطناعي من مجرد ميزة تطبيق واحدة إلى قدرة مؤسسية مشتركة تمتد عبر فرق وبيئات وحدود تنظيمية متعددة.
صُمم Kong لحوكمة طلبات واجهة برمجة التطبيقات (API)، وليس سلوك الذكاء الاصطناعي. فالمطالبات والرموز المميزة واختيار النموذج وتنفيذ الوكيل كلها مبهمة بالنسبة للبوابة.
يقدم Portkey ضوابط تراعي نماذج اللغة الكبيرة (LLM)، لكن الحوكمة تظل إلى حد كبير مقتصرة على التطبيق.
ومع ذلك، تحتاج فرق الذكاء الاصطناعي للمؤسسات إلى إجابات لأسئلة مثل:
لا يوفر كل من Kong ولا Portkey حوكمة الذكاء الاصطناعي على مستوى المؤسسة كميزة أساسية.
تتأثر تكاليف الذكاء الاصطناعي بمجموعة من العوامل:
ليس لدى Kong أي رؤية حول محركات التكلفة الخاصة بالذكاء الاصطناعي هذه.
يعرض Portkey مقاييس على مستوى الرموز، لكن تحديد مصدر التكلفة يصبح أكثر صعوبة مع انتشار الاستخدام عبر فرق وتطبيقات وبيئات متعددة.
بدون تحديد المصدر على مستوى البنية التحتية، تواجه فرق المنصة والمالية صعوبة في الإجابة على سؤال أساسي: من ينفق ماذا، ولماذا؟
تتطلب أنظمة الذكاء الاصطناعي الإنتاجية فصلاً صارماً بين:
لم يُصمم Kong مع مراعاة عزل بيئة الذكاء الاصطناعي.
يعمل Portkey على تحسين سير عمل التطبيقات بدلاً من فرض حدود بيئية صارمة.
بالنسبة للمؤسسات في الصناعات الخاضعة للتنظيم، يصبح هذا النقص في العزل عائقًا سريعًا أمام النشر.
يجب أن تلبي عمليات نشر الذكاء الاصطناعي للمؤسسات متطلبات مثل:
يجب فرض هذه القيود على مستوى البنية التحتية، لا أن تُدمج في تعليمات برمجية للتطبيق أو تُعالج يدويًا بواسطة الفرق.
يتعامل Kong مع حركة مرور الذكاء الاصطناعي على أنها طلبات HTTP عامة.
يفترض Portkey استخدامًا يعتمد على السحابة أولاً وعلى مستوى التطبيق.
لم يتم تصميم أي من النهجين من أجل عمليات نشر الذكاء الاصطناعي التي تضع الامتثال أولاً.
لم يعد الذكاء الاصطناعي في بيئة الإنتاج يقتصر على استدعاءات المطالبة والاستجابة المتزامنة. تتضمن الأنظمة الواقعية:
البوابات التي تركز فقط على حركة مرور واجهة برمجة التطبيقات (API) أو توجيه المطالبات تفشل في إدارة دورة الحياة الكاملة لأعباء عمل الذكاء الاصطناعي.
مع نضوج تبني الذكاء الاصطناعي، تتوصل الشركات إلى نفس الإدراك: البوابات وحدها لا تكفي. يتطلب تشغيل الذكاء الاصطناعي في بيئة الإنتاج طبقة بنية تحتية توحد الوصول، والنشر، والمراقبة، والحوكمة، والامتثال. لهذا السبب تتجاوز المؤسسات في النهاية بوابات واجهة برمجة التطبيقات (API) وبوابات تطبيقات نماذج اللغة الكبيرة (LLM) نحو منصات البنية التحتية الأصلية للذكاء الاصطناعي والمصممة لتناسب حجم الشركات الكبيرة
قيود Kong و Portkey تنبع من نفس السبب الجذري: فقد صُممت كلاهما لحل مشاكل على مستوى البوابة، وليس مشاكل البنية التحتية للذكاء الاصطناعي على مستوى المؤسسة.
مع تحول الذكاء الاصطناعي إلى قدرة مشتركة وحاسمة للإنتاج، تحتاج المؤسسات إلى أكثر من مجرد توجيه حركة المرور أو تجريد المطالبات. إنها تحتاج إلى منصة تتعامل مع حوكمة الذكاء الاصطناعي، ونشره، وإمكانية مراقبته، وأمنه كاهتمامات بنية تحتية من الدرجة الأولى. وهنا تبرز ترو فاوندري تنفرد.
تُبنى ترو فاوندري على فكرة أن أعباء عمل الذكاء الاصطناعي يجب أن تُدار مثل أي نظام إنتاجي حاسم آخر، ولكن باستخدام أساسيات متأصلة في الذكاء الاصطناعي. فبدلاً من العمل فقط في مسار الطلب، تعمل ترو فاوندري كـ مستوى تحكم موحد للذكاء الاصطناعي.
بشكل عام، تجمع ترو فاوندري بين:
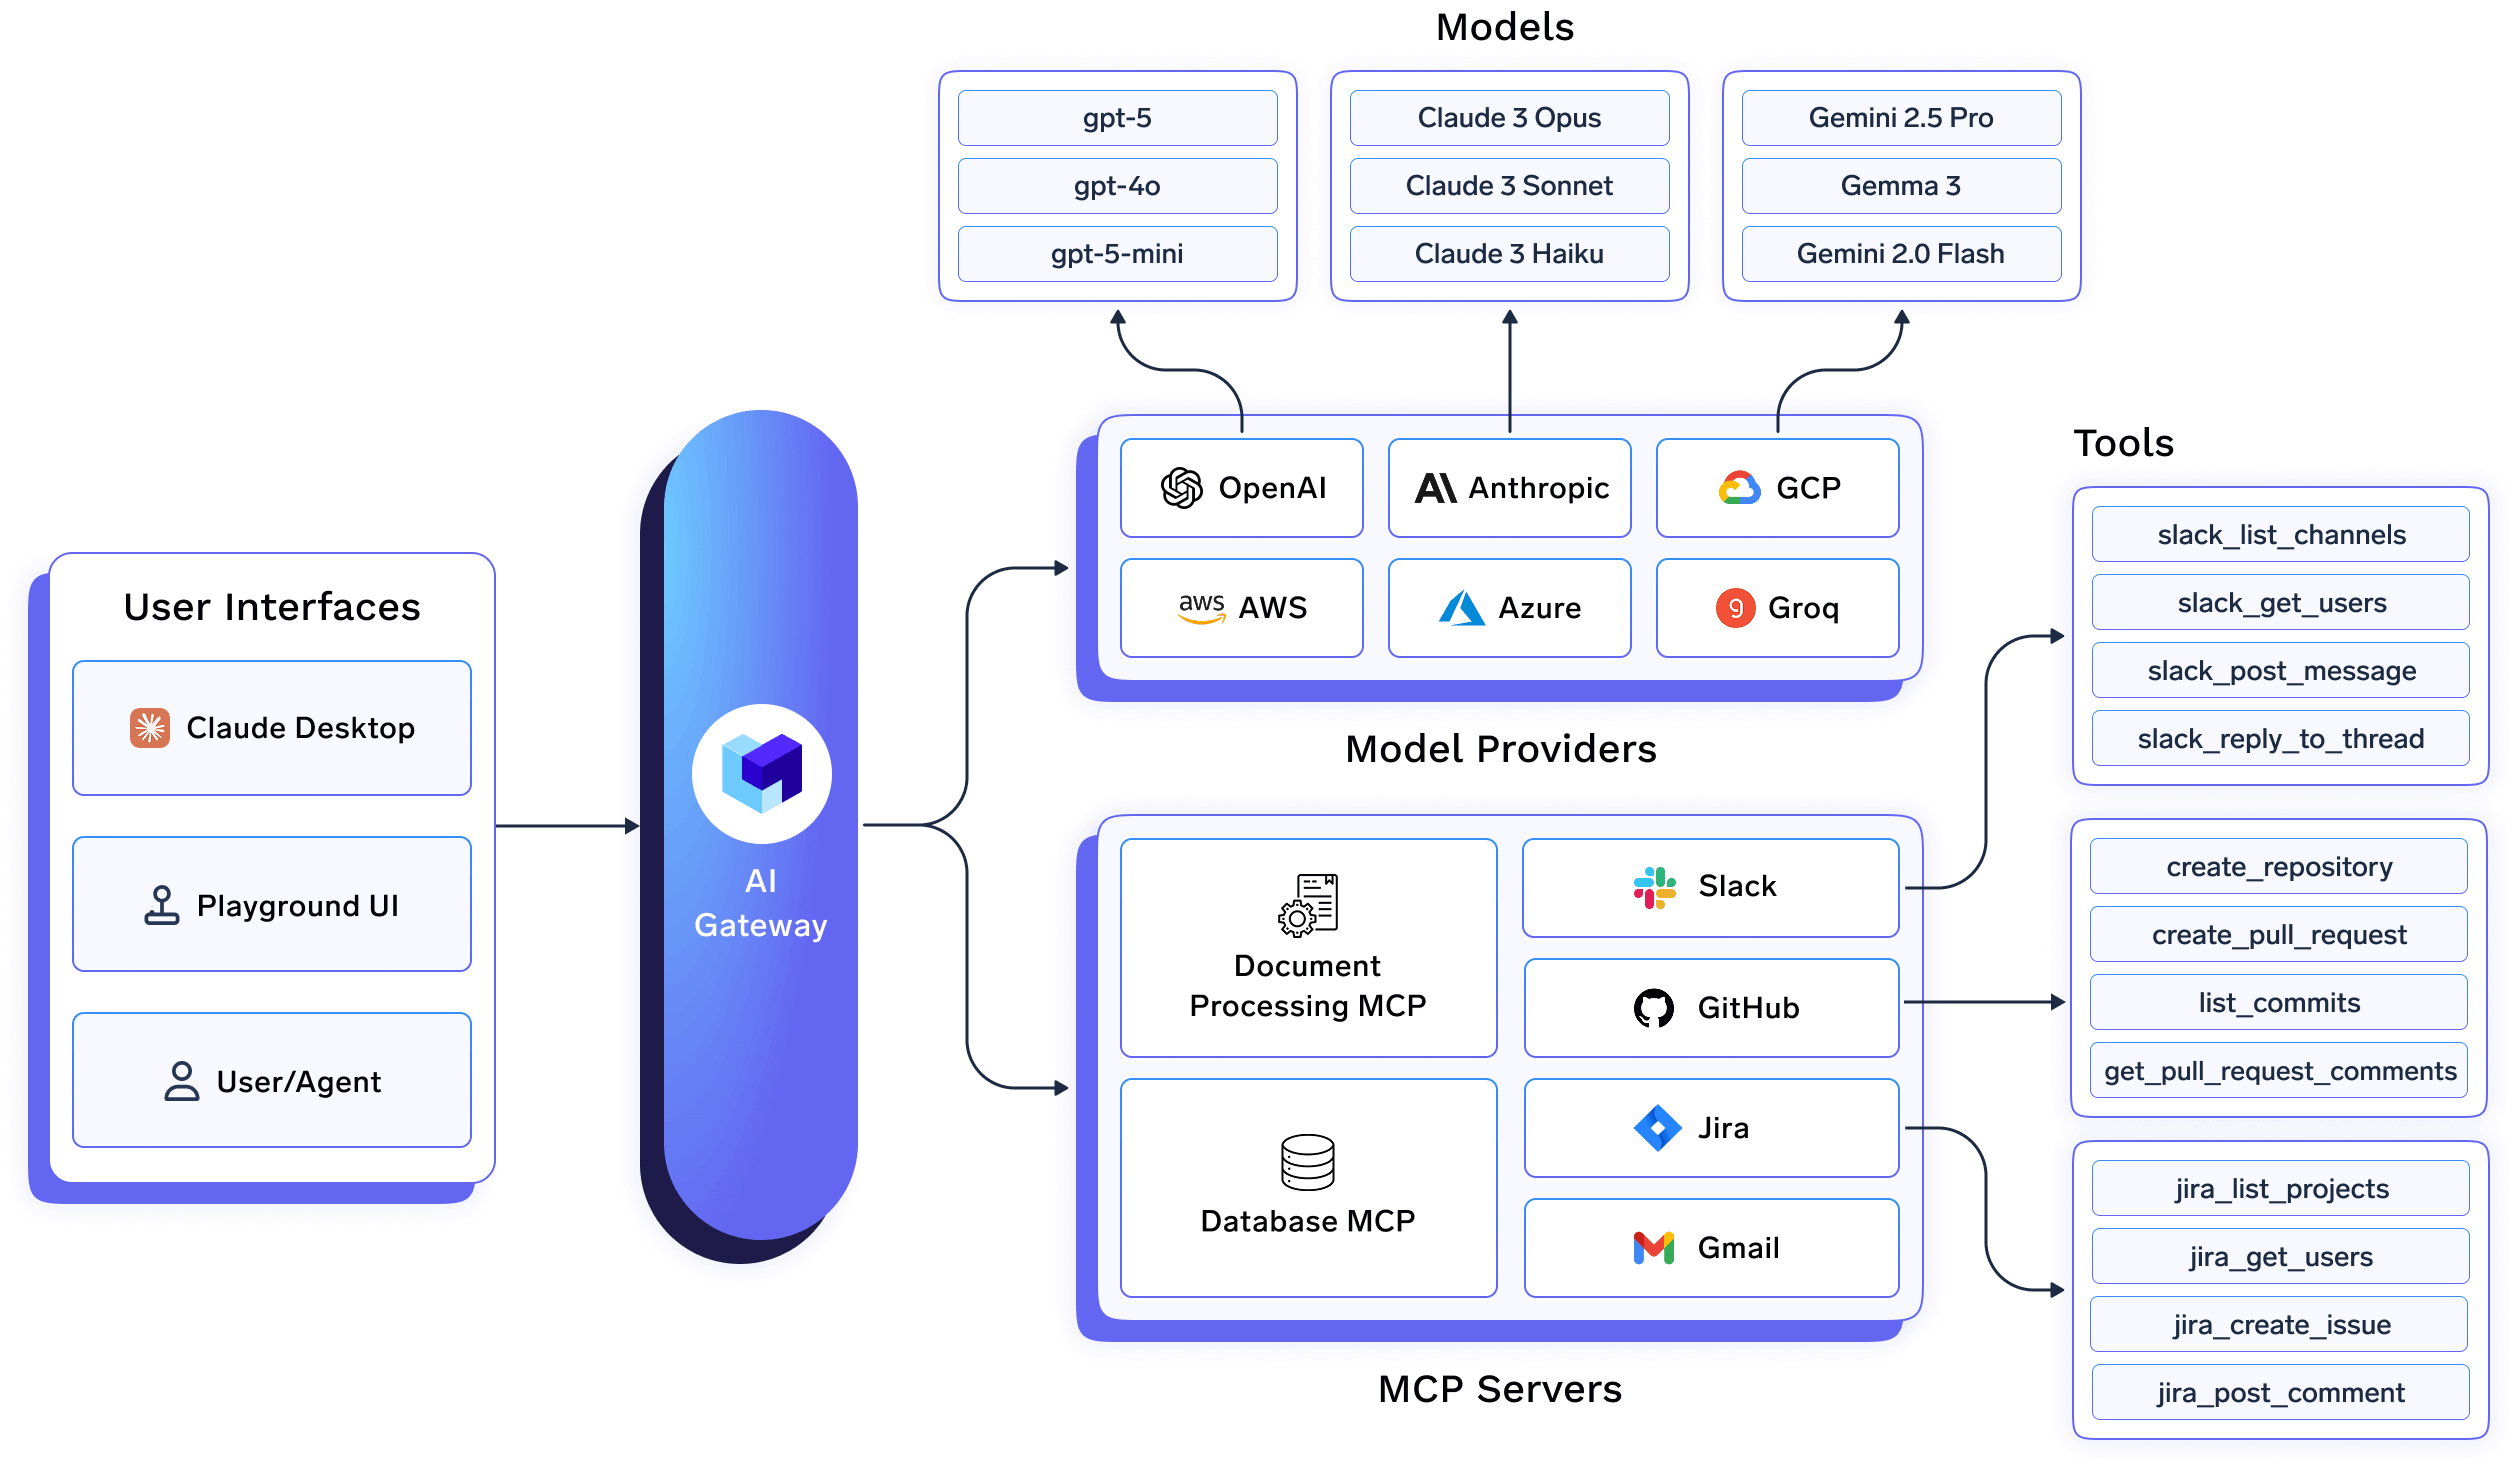
في العديد من مكدسات الذكاء الاصطناعي، يُعامل استخدام نماذج اللغة الكبيرة (LLM) كمشكلة تكامل واجهة برمجة التطبيقات (API): يتم توجيه الطلبات ومصادقتها وتسجيلها، ولكن كل ما يتجاوز حدود الطلب يُترك للتطبيقات الفردية. تتبع TrueFoundry نهجًا مختلفًا من خلال التعامل مع أعباء عمل الذكاء الاصطناعي – الخدمات والمهام والوكلاء – على أنها كائنات بنية تحتية ذات دورة حياة وملكية وحدود تشغيلية.
بدلاً من مجرد تحديد ما إذا كان يجب السماح بطلب ما، تتحكم TrueFoundry في مكان تشغيل أنظمة الذكاء الاصطناعي، وكيفية تنفيذها، وتحت أي قيود، بدءًا من النشر وحتى وقت التشغيل. هذا التحول من توجيه الطلبات إلى التحكم في دورة الحياة هو ما يمكّن الحوكمة المتسقة مع توسع استخدام الذكاء الاصطناعي.
عمليًا، يظهر هذا في عدة أبعاد حاسمة.
في البنى المعمارية التي تركز على البوابات، سياسات الوصول عادةً ما تكون مضمنة في رمز التطبيق، أو تكوين حزمة تطوير البرامج (SDK)، أو قواعد البوابة لكل خدمة. يصبح هذا هشًا بسرعة مع تزايد الفرق والخدمات والبيئات.
تفرض TrueFoundry سياسات الوصول والاستخدام على مستوى مساحة العمل والبيئة. يتم تحديد نطاق النماذج والوكلاء والأدوات لتناسب بيئات مثل التطوير، والاختبار المرحلي، والإنتاج، مع تطبيق الأذونات والضوابط بشكل متسق عبر جميع أعباء العمل المنشورة في تلك البيئة.
نظرًا لأن السياسات مرتبطة بالبيئات بدلاً من التطبيقات الفردية:
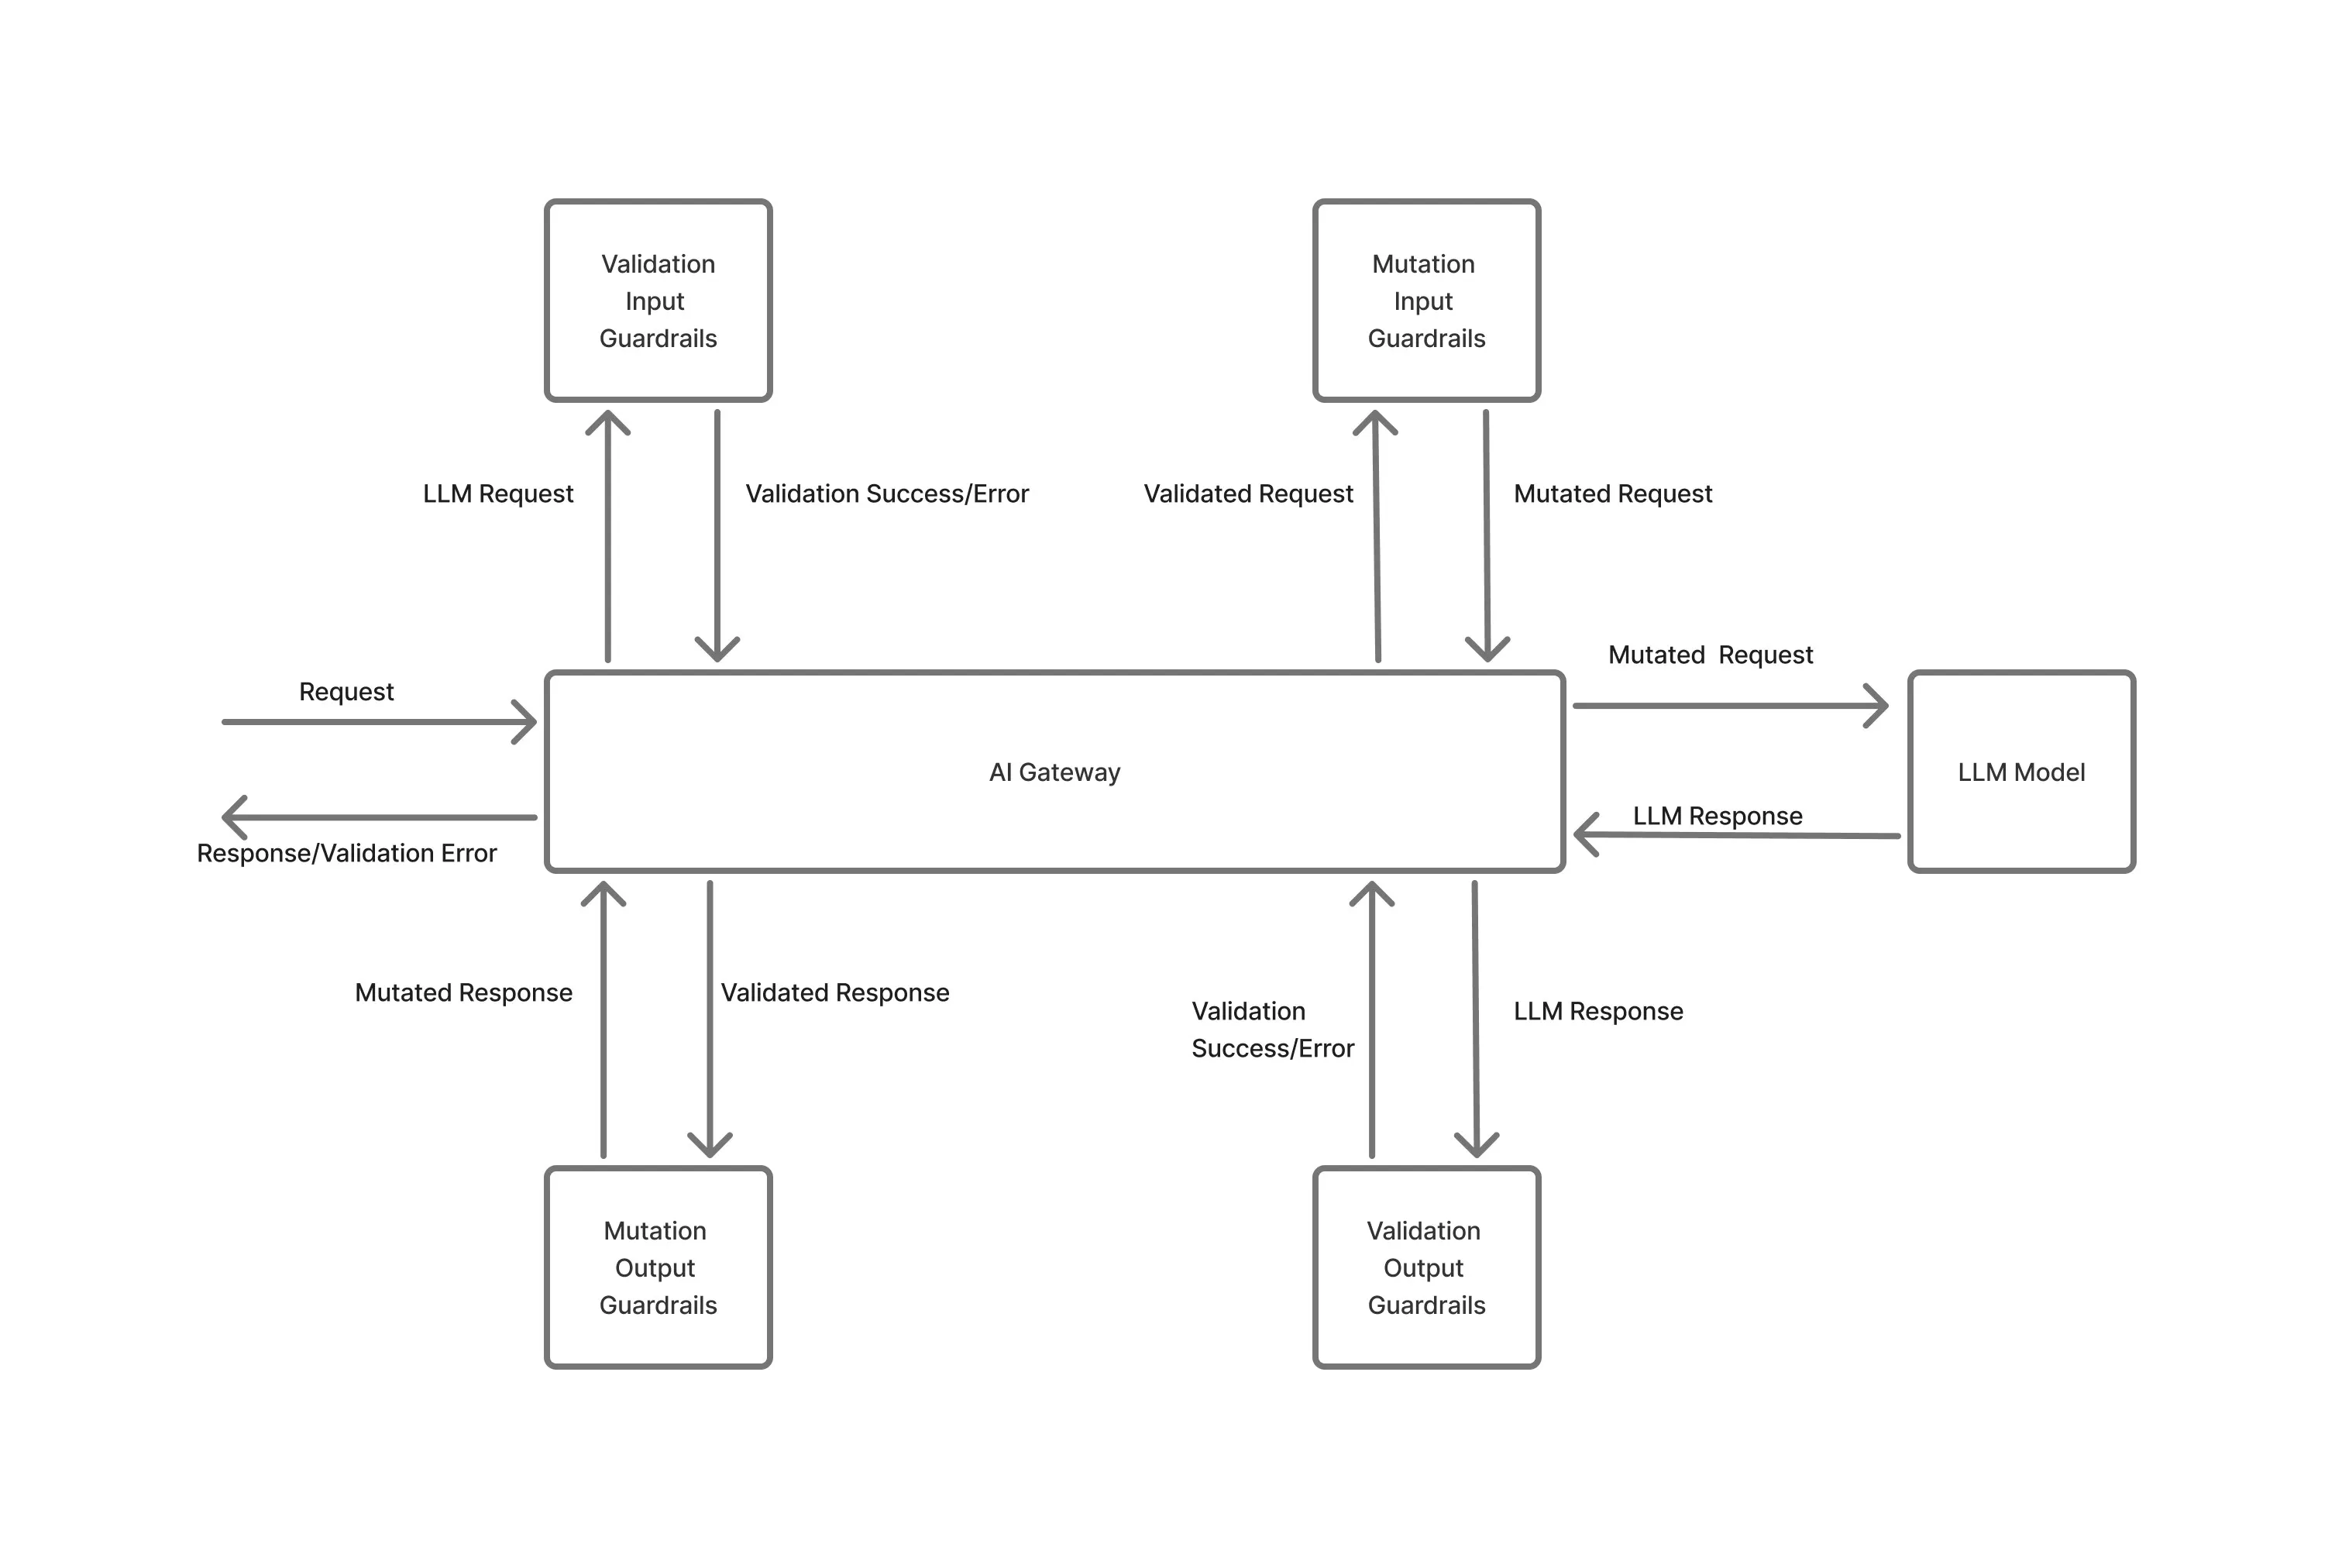
تفشل أنظمة الذكاء الاصطناعي في الإنتاج ليس بسبب طلب واحد غير صالح، بل لأن الاستخدام يتراكم بطرق غير متوقعة من خلال ارتفاعات التزامن، أو عواصف إعادة المحاولة، أو أعباء العمل الخلفية التي تعمل على نطاق واسع.
تفرض TrueFoundry ضوابط الاستخدام الوقائية في وقت التنفيذ، مع إمكانية رؤية كيفية تصرف أعباء العمل في وقت التشغيل. يتم تطبيق حدود التزامن، وقيود الإنتاجية، وسقوف الاستخدام مركزيًا عبر الخدمات والمهام التي تشترك في النماذج أو البنية التحتية الأساسية.
نظرًا لأن هذه القيود تُفرض على مستوى المنصة:
يختلف هذا اختلافًا جوهريًا عن الضوابط على مستوى العميل أو حزمة تطوير البرامج (SDK)، التي تفترض أن التطبيقات تتصرف بشكل صحيح ومستقل.
تفرض TrueFoundry العزل على مستوى النشر والبيئة، وليس فقط عند قبول الطلبات. يتم نشر خدمات الذكاء الاصطناعي والمهام الدفعية وسير عمل الوكلاء كأعباء عمل معزولة ضمن بيئات محددة، مع تحديد نطاق الوصول والسياسات والموارد لكل بيئة.
تعمل أعباء العمل هذه كـ عمليات نشر ومهام منفصلة مع عمليات تشغيل مستقلة ونطاقات فشل، بدلاً من مشاركة سياق تنفيذ مسطح واحد خلف بوابة. ونتيجة لذلك:
بوابات LLM على مستوى التطبيق، والتي تعمل بشكل أساسي في مسار الطلب، لا تتحكم في تنفيذ وقت التشغيل أو حالة البنية التحتية. ونتيجة لذلك، لا يمكنها توفير هذا المستوى من عزل النشر والبيئة - وهي مشكلة تتضح بشكل متزايد مع توسع أعباء عمل الذكاء الاصطناعي عبر الفرق وبيئات الإنتاج.

مقاييس مستوى الرمز المميز مفيدة، لكنها غير كافية بمجرد أن تمتد أعباء عمل الذكاء الاصطناعي لتشمل الخدمات طويلة الأمد والمهام الخلفية وسير عمل الوكلاء. في أنظمة الإنتاج، تنشأ التكلفة والأداء من التفاعل بين:
تربط TrueFoundry هذه الإشارات على مستوى المنصة، مما يسمح للفرق بفهم سلوك الذكاء الاصطناعي بنفس الطريقة التي يفهمون بها أنظمة الإنتاج الأخرى—حسب البيئة والخدمة والمالك، وليس حسب استدعاءات واجهة برمجة التطبيقات الفردية.
تعمل العديد من عمليات نشر الذكاء الاصطناعي للمؤسسات في ظل قيود تتجاهلها بوابات مستوى التطبيق ضمنيًا، ومنها:
تم تصميم مستوى التحكم في TrueFoundry للعمل عبر نماذج النشر هذه، مما يضمن بقاء الحوكمة والعزل وقابلية المراقبة متسقة بغض النظر عن مكان تشغيل الاستدلال. ونتيجة لذلك، يتم فرض خصائص الامتثال - مثل حدود البيانات وقابلية التدقيق - كجزء من البنية التحتية نفسها، بدلاً من إضافتها لاحقًا من خلال منطق التطبيق أو ضوابط العمليات.
يحل كل من Kong و Portkey مشكلات مهمة في مراحل مختلفة من تبني الذكاء الاصطناعي. يوسع Kong أنماط بوابات API المألوفة لتشمل حركة مرور الذكاء الاصطناعي، بينما يقدم Portkey تجريدات أصلية لـ LLM مما يسهل بناء وتشغيل التطبيقات المدعومة بالذكاء الاصطناعي.
ومع ذلك، مع تحول الذكاء الاصطناعي إلى قدرة مشتركة وحاسمة للإنتاج، تواجه المؤسسات بسرعة تحديات تتجاوز توجيه الطلبات أو إدارة المطالبات. تتطلب الحوكمة، وتحديد التكاليف، وعزل البيئة، والامتثال جميعها ضوابط على مستوى البنية التحتية وليس فقط على مستوى البوابة.
لهذا السبب تتجاوز العديد من المؤسسات بوابات تطبيقات API و LLM نحو منصات البنية التحتية الأصلية للذكاء الاصطناعي مثل TrueFoundry، والتي تم تصميمها لتشغيل أنظمة الذكاء الاصطناعي وحوكمتها وتوسيع نطاقها بشكل موثوق عبر الفرق والبيئات.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد