October 14, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 12, 2026
Blazingly fast way to build, track and deploy your models!
Executamos testes de concorrência com o GuideLLM em três modelos de 8 bilhões de parâmetros em uma única GPU NVIDIA A10 (24 GB): Qwen3-8B, Llama 3.1 8B Instruct e Ministral 8B. Este benchmark do vLLM variou a concorrência de 4 a 256 usuários simultâneos em duas cargas de trabalho: chat conversacional curto e classificação de intenção. Um modelo se manteve estável em toda a faixa. Os outros dois, não.
Todos os três modelos rodaram em FP16 no vLLM, servidos pelo endpoint de streaming padrão /v1/chat/completions. O GuideLLM manteve exatamente N requisições em processamento por 90 segundos em cada nível de concorrência (4, 8, 16, 32, 64, 128, 256), com 30 segundos de intervalo entre os níveis.
Duas cargas de trabalho:
Mesma versão do vLLM, mesma configuração de gateway, mesma GPU para todos os três. Os resultados abaixo refletem essas condições.
A tabela de resumo utiliza 64 usuários simultâneos para a comparação de chat curto. Esse é o último nível de concorrência em que o Llama rodou sem falhas (0% de erros), sendo, portanto, a base de comparação mais justa entre os três modelos.
O Qwen3 apresenta o menor tempo de espera típico (p50 de 524 ms) e a cauda mais estável (p95 de 2.840 ms). O Llama processa 11% mais tokens por segundo, mas o usuário mediano espera 2.569 ms pelo primeiro token, em comparação aos 524 ms do Qwen3. Um ponto chamou a atenção nos dados: o p95 de ponta a ponta do Llama (10,4 s) é menor que o do Qwen3 (11,4 s), mesmo com um TTFT muito pior. O Llama começa devagar, mas decodifica rápido. Uma vez que os tokens começam a fluir, eles fluem mais rápido do que no Qwen3. Para interfaces de streaming, no entanto, é esse atraso do primeiro token que os usuários realmente sentem.
As análises completas de percentis em cada nível de concorrência, resultados de tráfego de rajada Poisson e arquivos CSV para download estão no benchmark interativo relatório.
Com baixa concorrência, todos os três modelos começaram com um p50 de TTFT aproximadamente igual, em torno de 350 ms. O Qwen3 manteve esse desempenho. Com 16 usuários simultâneos, o p50 do Qwen3 foi de 388 ms. O do Llama já havia subido para 794 ms.
O Qwen3 completou todas as requisições em todos os níveis de concorrência até 256. Nenhuma requisição foi descartada. O p50 do TTFT com 64 usuários simultâneos foi de 524 ms, com um throughput de 851 tok/s.
Nossa hipótese de trabalho para explicar por que ele se mantém sob carga: o Qwen3 utiliza QK-LayerNorm, que estabiliza as pontuações de atenção sob caches KV longos, e sua pegada de KV ligeiramente menor por camada dá ao vLLM mais margem de agendamento antes que as requisições comecem a formar fila no gateway. O FFN maior do Llama (14.336 contra 12.288 do Qwen3) impulsiona um throughput maior por token, mas preenche o pipeline de decodificação mais rapidamente, deixando menos espaço para novos pré-preenchimentos à medida que a concorrência aumenta. Ainda estamos investigando, mas a diferença de arquitetura parece ser relevante aqui.
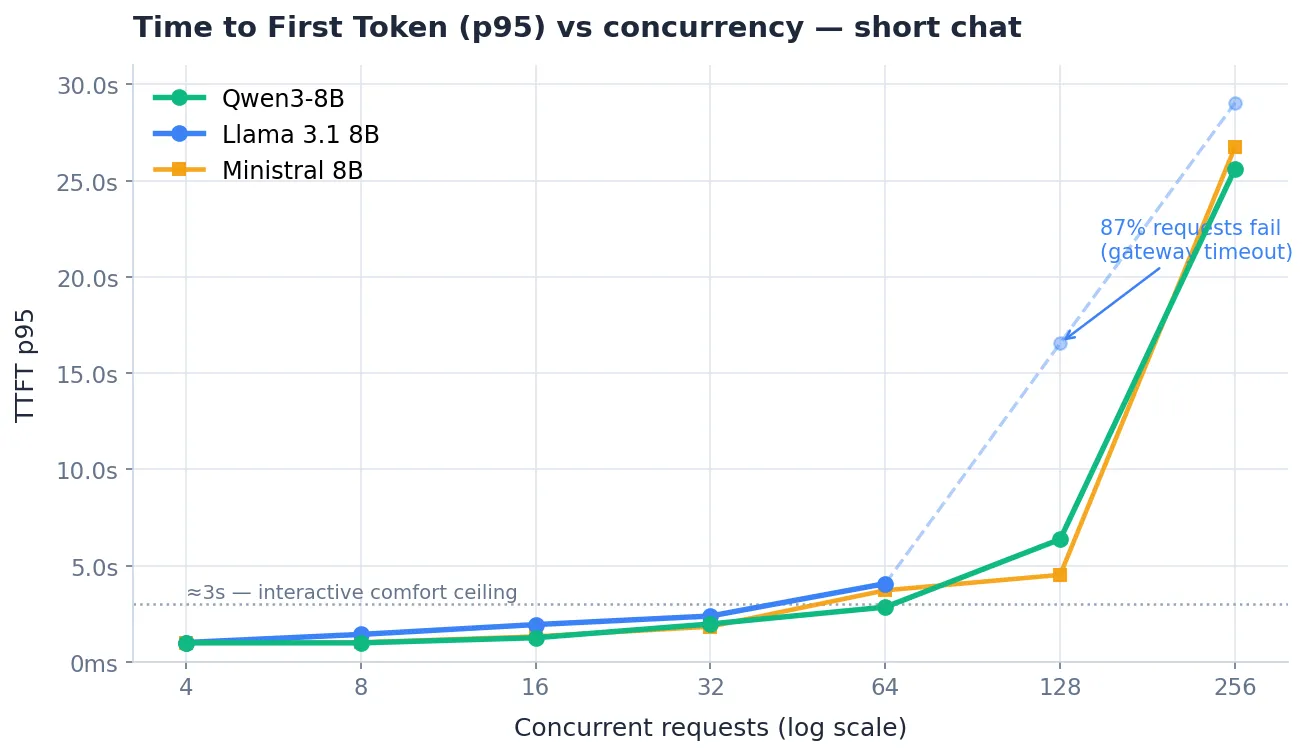
O Llama registrou o maior throughput bruto no pico: 1.181 tok/s com concorrência de 256. Com concorrência de 128, no entanto, 86,9% das solicitações receberam erros 408 (timeout). O valor de 1.181 tok/s vem das poucas solicitações que conseguiram passar depois que o servidor já havia descartado a maior parte de sua fila.
Com 64 de concorrência (o último ponto estável), o Llama entregou 947 tok/s com TTFT p95 de 4.062 ms e 0% de erros. Isso é 11% mais throughput que o Qwen3 sob a mesma carga. Para inferência em lote ou pipelines assíncronos onde novas tentativas são aceitáveis, essa vantagem de throughput é real. Para uso interativo, limite-o entre 32 e 64 de concorrência.
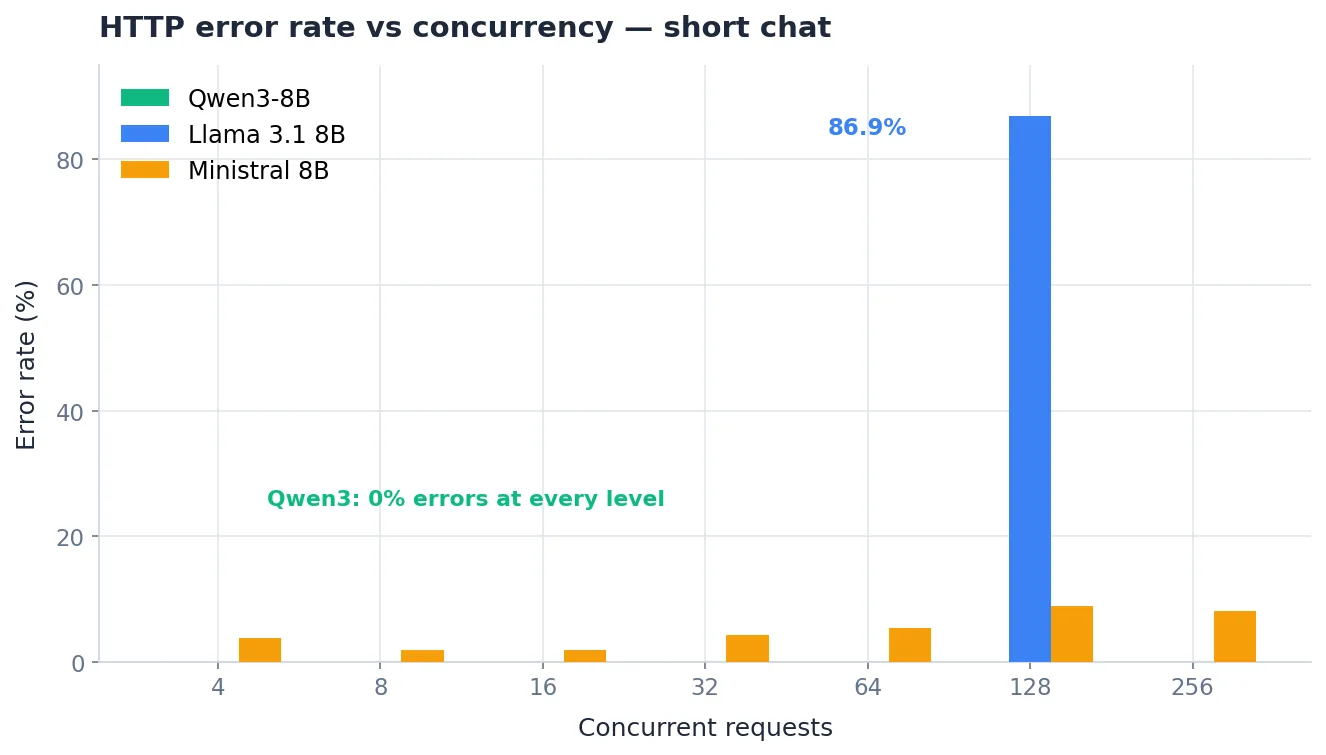
Precisamos ser honestos sobre isso. O Ministral apresentou 3,8% de erros HTTP reais com concorrência de 4, a carga mais leve que testamos. Com 64 de concorrência, foi de 5,3%. Em 128, atingiu 8,9%. Essas foram falhas genuínas 408/503, não artefatos de benchmark. Isso provavelmente reflete a instabilidade da implantação durante nossa janela de teste, em vez de uma limitação fundamental do modelo, mas os dados são os dados.
Onde as solicitações tiveram sucesso, a latência do Ministral foi competitiva: TTFT p50 de 350 ms na linha de base e 512 ms com concorrência de 64, próximo aos 524 ms do Qwen3. No entanto, os números de latência não significam muito se aproximadamente 1 em cada 20 solicitações nunca recebe uma resposta.
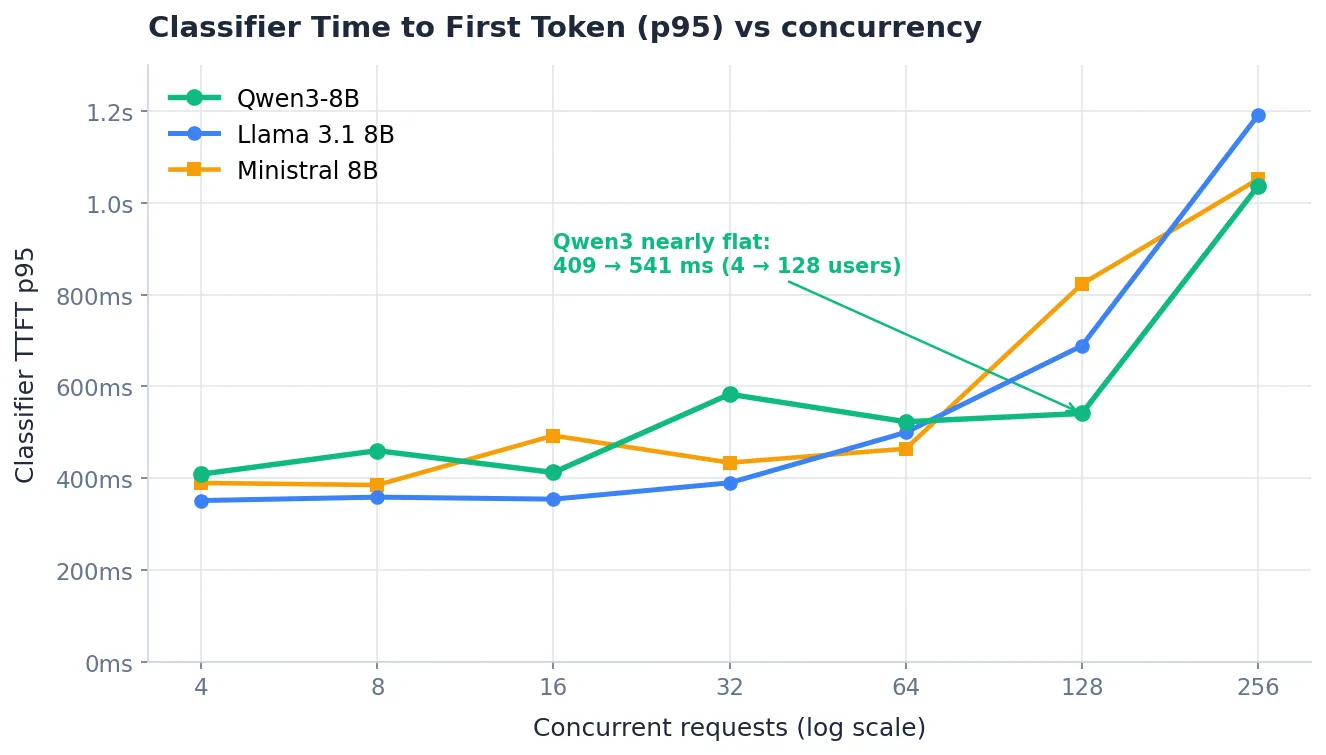
Para a carga de trabalho de classificação, todos os três modelos rodaram de forma estável até 256 usuários simultâneos com zero erros. O Llama liderou em solicitações brutas por segundo (173 RPS), seguido pelo Qwen3 (157 RPS) e pelo Ministral (143 RPS).
O número mais revelador é o quanto a latência variou sob carga. O TTFT p95 do Qwen3 com 128 de concorrência foi de 541 ms, apenas 32% acima de sua linha de base de 409 ms. O p50 mudou de 358 ms para 467 ms. O p95 do Llama quase dobrou (de 351 ms para 689 ms). O do Ministral mais que dobrou (de 390 ms para 823 ms).
Se você precisa de um roteador de intenção ou classificador com latência previsível sob tráfego intenso, a curva plana do Qwen3 merece atenção. A GPU absorve solicitações curtas de classificação em um único lote sem enfileiramento, e isso fica evidente nos números.
Todos os três começam no mesmo ponto e escalam linearmente até 16 usuários simultâneos. A diferença aumenta a partir daí.
Após 64, o throughput do Llama continua subindo no papel (1.181 tok/s em 256), mas a maioria das solicitações está sendo rejeitada. O Qwen3 estabiliza em torno de 830-850 tok/s e atende a todas as solicitações. O Ministral fica cerca de 15% abaixo do Qwen3 com 64 de concorrência, mesmo entre as solicitações que tiveram sucesso.
O número de pico bruto sem uma taxa de erro ao lado é praticamente inútil para o planejamento de capacidade. Todos esses três benchmarks de vLLM ilustram isso.

Executamos este benchmark de vLLM em uma única instância spot A10 implantada via TrueFoundry. A configuração completa do vLLM e os comandos do GuideLLM serão publicados no artigo detalhado.
A camada de serviço de modelos do TrueFoundry implanta backends vLLM em qualquer nível de GPU (A10, A100, H100) diretamente a partir do painel de controle. Você escolhe o modelo, define o max_model_len e o tensor_parallel_size, e o TrueFoundry cuida do container, da alocação da GPU e das verificações de integridade. O modelo é disponibilizado em um endpoint padrão compatível com OpenAI.
À frente do vLLM, o Gateway de IA adiciona cerca de 3-4 ms de sobrecarga enquanto processa mais de 350 RPS em uma única vCPU. Ele oferece limites de taxa por modelo, atribuição de custos, roteamento de fallback entre provedores e um rastreamento completo de requisições. Se você estiver comparando vários modelos (como neste benchmark), pode rotear todos os três pelo mesmo endpoint de gateway e alternar entre eles alterando o campo do modelo na requisição. A URL e as credenciais permanecem as mesmas.
O TrueFoundry suporta mais de 1.000 LLMs por meio de uma única API compatível com OpenAI, portanto, migrar de um modelo de pesos abertos testado para um provedor comercial não exige nenhuma alteração no lado do cliente.
Para equipes que hospedam seus próprios modelos de pesos abertos atrás de um gateway, essa arquitetura mantém a camada de serviço separada do roteamento e da governança. Veja As 10 melhores ferramentas de observabilidade de LLM em 2026 para monitorar sua implantação vLLM assim que ela estiver em execução.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



A vLLM benchmark measures how a model served via vLLM performs under concurrent load. The key metrics are time to first token (TTFT), end-to-end latency, token throughput, and error rates at different concurrency levels. The most useful vLLM benchmarks sweep from low to high concurrency to find the point where performance degrades or requests start failing, since peak throughput numbers without error rates are misleading.
In this benchmark, Qwen3-8B was the only model to complete every request at every concurrency level through 256 concurrent users with zero errors. Llama 3.1 8B was clean through 64 concurrent but hit 87% error rates at 128. Ministral 8B had persistent errors starting at concurrency 4.
Based on this vLLM performance benchmark, 64 concurrent users is the last clean operating point for Llama 3.1 8B on a 24 GB A10. At 128 concurrent, 87% of requests fail with gateway timeouts. For interactive workloads, stay at or below 64. For batch jobs with retry logic, you can push higher.
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada