



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Resumo rápido A TrueFoundry e a Seldon estão se unindo em uma única plataforma. A solução de serving de ML em tempo real da Seldon junta-se ao AI Deploy e ao AI Gateway da TrueFoundry, oferecendo às empresas um plano de controle único tanto para ML clássico quanto para agentes. Seus modelos em produção continuam rodando no mesmo Kubernetes que você usa hoje, com um caminho claro para LLMs e agentes de IA sobre eles.
A maioria das equipes de IA empresarial agora atua em ambos os lados de uma mesma linha. Elas executam modelos clássicos de ML em produção para tarefas como pontuação de fraude, previsão de churn e recomendações. Ao mesmo tempo, estão construindo aplicações baseadas em agentes que raciocinam, chamam ferramentas e agem de forma autônoma. Esses dois mundos costumavam se mover em velocidades diferentes. Não mais. Ambos estão se tornando críticos para o negócio simultaneamente, e operá-los como duas pilhas separadas, com dois fornecedores e dois modelos de governança, torna-se caro e frágil rapidamente.
Essa é a lacuna que TrueFoundry e Seldon estão fechando juntas. A Seldon passou mais de uma década aperfeiçoando o serving de ML em tempo real para algumas das empresas mais exigentes do mundo. A TrueFoundry construiu o plano de controle para a IA moderna, com implantação, um AI Gateway e governança para LLMs e agentes. Estamos fundindo ambas em uma única plataforma, para que as equipes tenham um único local para executar modelos preditivos e agentes na infraestrutura de Kubernetes em que já confiam.
Esta fusão funciona porque nenhum dos lados precisa abrir mão de seu design. Seldon e TrueFoundry fizeram a mesma escolha arquitetônica anos atrás. Ambas rodam como um plano de controle no próprio Kubernetes do cliente, dentro de sua VPC, on-premise ou air-gapped. Ambas são agnósticas em relação à nuvem. Ambas utilizam os mesmos componentes padrão para tráfego, escalonamento automático e telemetria, e ambas fornecem a uma equipe seu próprio namespace, em vez de exigir privilégios de administrador em todo o cluster.
A Seldon aproveitou essa base compartilhada e se aprofundou em uma camada: o serving de ML clássico em tempo real em grande escala. Nós aproveitamos a mesma base e expandimos em amplitude, desde a implantação até um gateway que governa modelos, agentes e ferramentas. Portanto, as duas plataformas nunca estiveram em rota de colisão. Elas estavam resolvendo partes vizinhas do mesmo problema, da mesma maneira. Uni-las apenas conecta duas camadas que já falam a mesma língua.
A Seldon tem sido a espinha dorsal para inferência de ML em tempo real em bancos, empresas de telecomunicações, seguradoras, varejistas e empresas de saúde há mais de uma década. Essa reputação vem do aprofundamento nas partes mais difíceis do serving de ML em produção:
Juntos, eles formam uma camada madura de serving e monitoramento com raízes profundas em ambientes regulados e de baixa latência, do tipo em que uma previsão ruim se transforma em um problema para o cliente em questão de minutos.
A TrueFoundry construiu o plano de controle em torno do modelo, as camadas que transformam um modelo servido em uma aplicação governada, consciente dos custos e pronta para agentes:
Nossos clientes já executam IA crítica para os negócios por meio do Gateway em uma escala de mais de um trilhão de tokens por dia.
Aqui está a parte que importa. Quando a camada de serving da Seldon e as camadas de implantação e gateway da TrueFoundry se unificam, uma empresa obtém um único plano de controle que cobre ambas as metades de sua IA.
O Deploy executa as cargas de trabalho. O Gateway as governa e roteia. Seus modelos clássicos de ML e seus agentes ficam no mesmo Kubernetes, sob um único conjunto de controles de acesso, uma pilha de observabilidade e uma visão única de custos. Uma única requisição pode acionar um modelo de fraude, um LLM e um agente que chama uma ferramenta, sendo que cada etapa é registrada e governada da mesma forma.
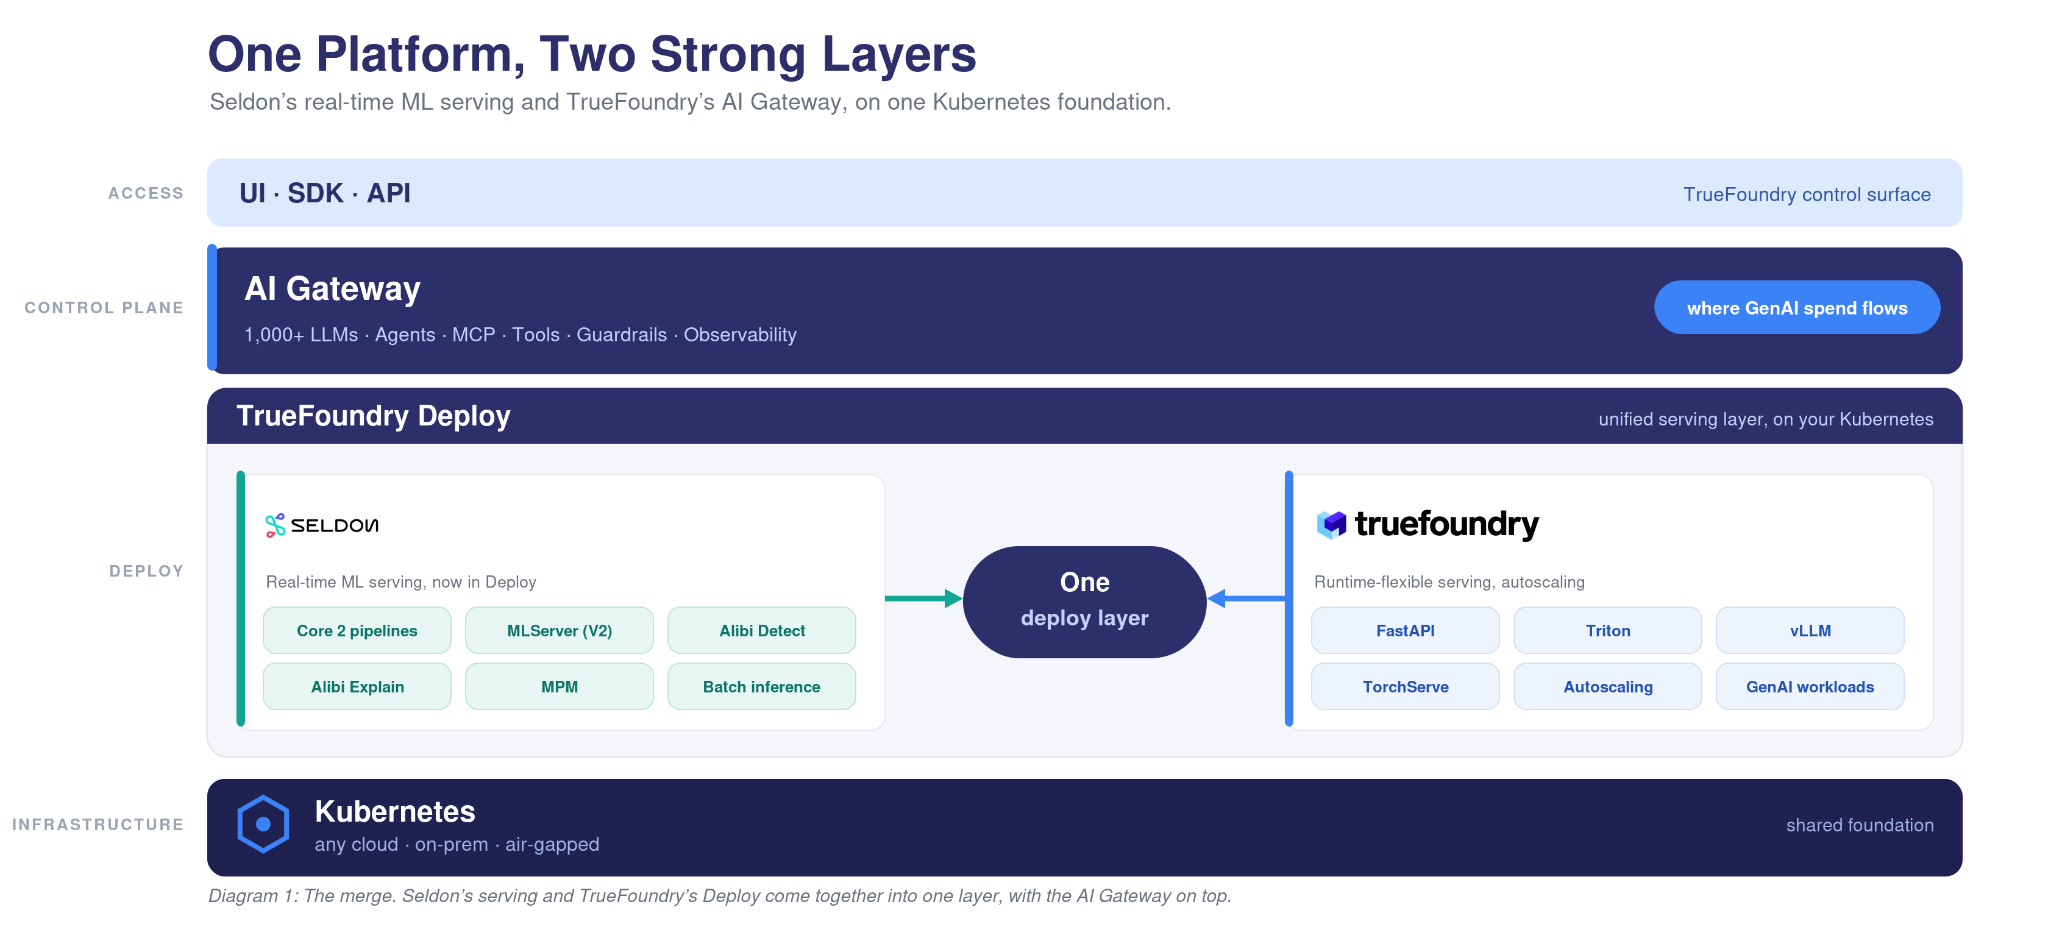
Vale a pena observar para onde o dinheiro está se movendo. O ML preditivo está em grande parte construído e roda de forma estável. Os novos investimentos em IA empresarial estão indo para LLMs e agentes, e esse gasto flui através do Gateway. Cada chamada de modelo, cada etapa de agente, cada invocação de ferramenta passa por ele — e é por isso que nossos clientes já transacionam mais de um trilhão de tokens por dia através dele.
Portanto, a plataforma combinada realiza duas coisas úteis ao mesmo tempo. Ela mantém o ML que você já construiu rodando, sem interrupções. E coloca você na interface onde a próxima onda de investimentos em IA chega, sem a necessidade de criar uma plataforma separada para isso.
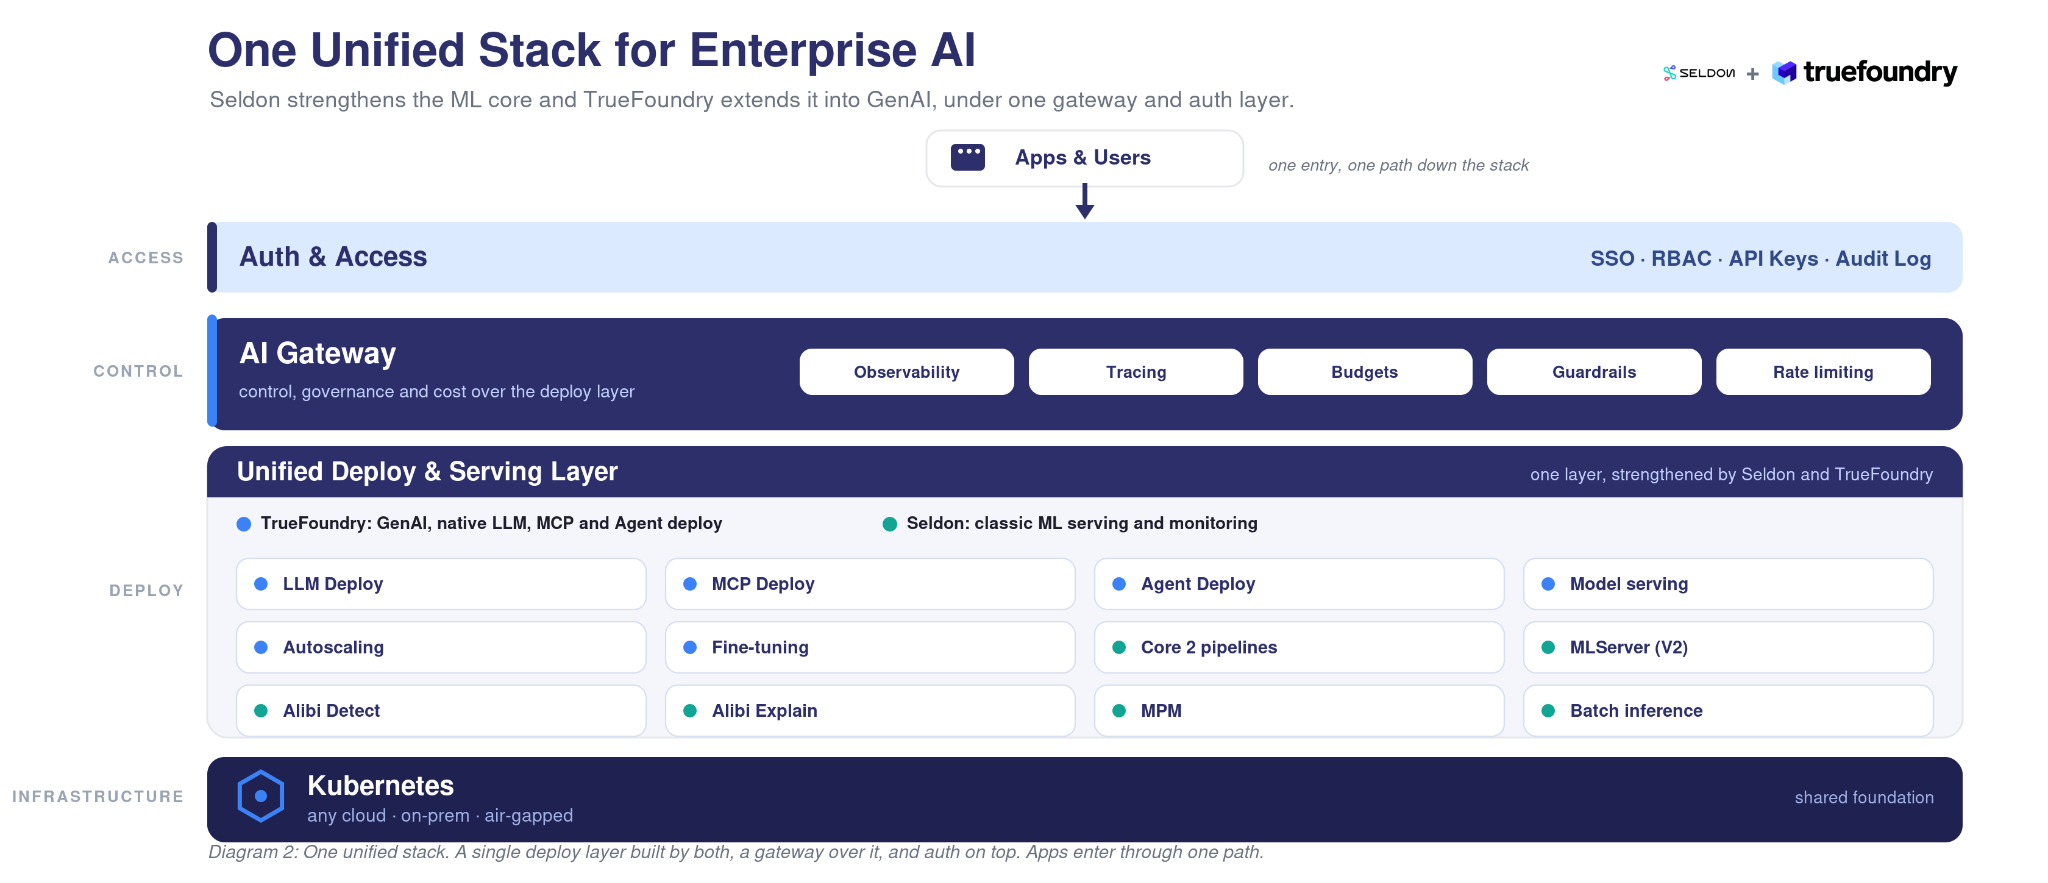
Se você já usa a Seldon hoje, seu ML em tempo real continua rodando no Kubernetes que você já opera. Os modelos servidos sobre o protocolo V2 permanecem portáveis, e os pipelines Core 2 são mapeados para os próprios primitivos do Deploy em vez de serem reescritos. Além disso, você ganha o AI Gateway e a camada de agentes sem precisar implantar nada do zero.
Se você já usa a TrueFoundry hoje, nada na sua pilha altera, e o Deploy se torna ainda mais robusto. Ele herda a linhagem de serving e monitoramento da Seldon, incluindo detecção de drift e outliers, explicações de modelos e monitoramento de desempenho, alimentando diretamente a plataforma que você já utiliza.
Para ambos, trata-se de uma única pilha em vez de duas. Um único lugar para implantar um modelo, rotear uma chamada, monitorar drifts, governar um agente e contabilizar custos, abrangendo ML clássico e GenAI, na infraestrutura que você já executa.
As empresas não deveriam ter que operar uma plataforma para seus modelos e outra para seus agentes. Com a união de TrueFoundry e Seldon, elas não precisam mais. O serving de ML em tempo real da Seldon e o AI Gateway da TrueFoundry agora residem em um único plano de controle para IA empresarial, no Kubernetes que você já opera. Seu ML em produção continua funcionando, e o caminho para agentes e LLMs está disponível logo acima dele.
Veja como o AI Gateway da TrueFoundry unifica ML e agentes → Explore o AI Gateway
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















