



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
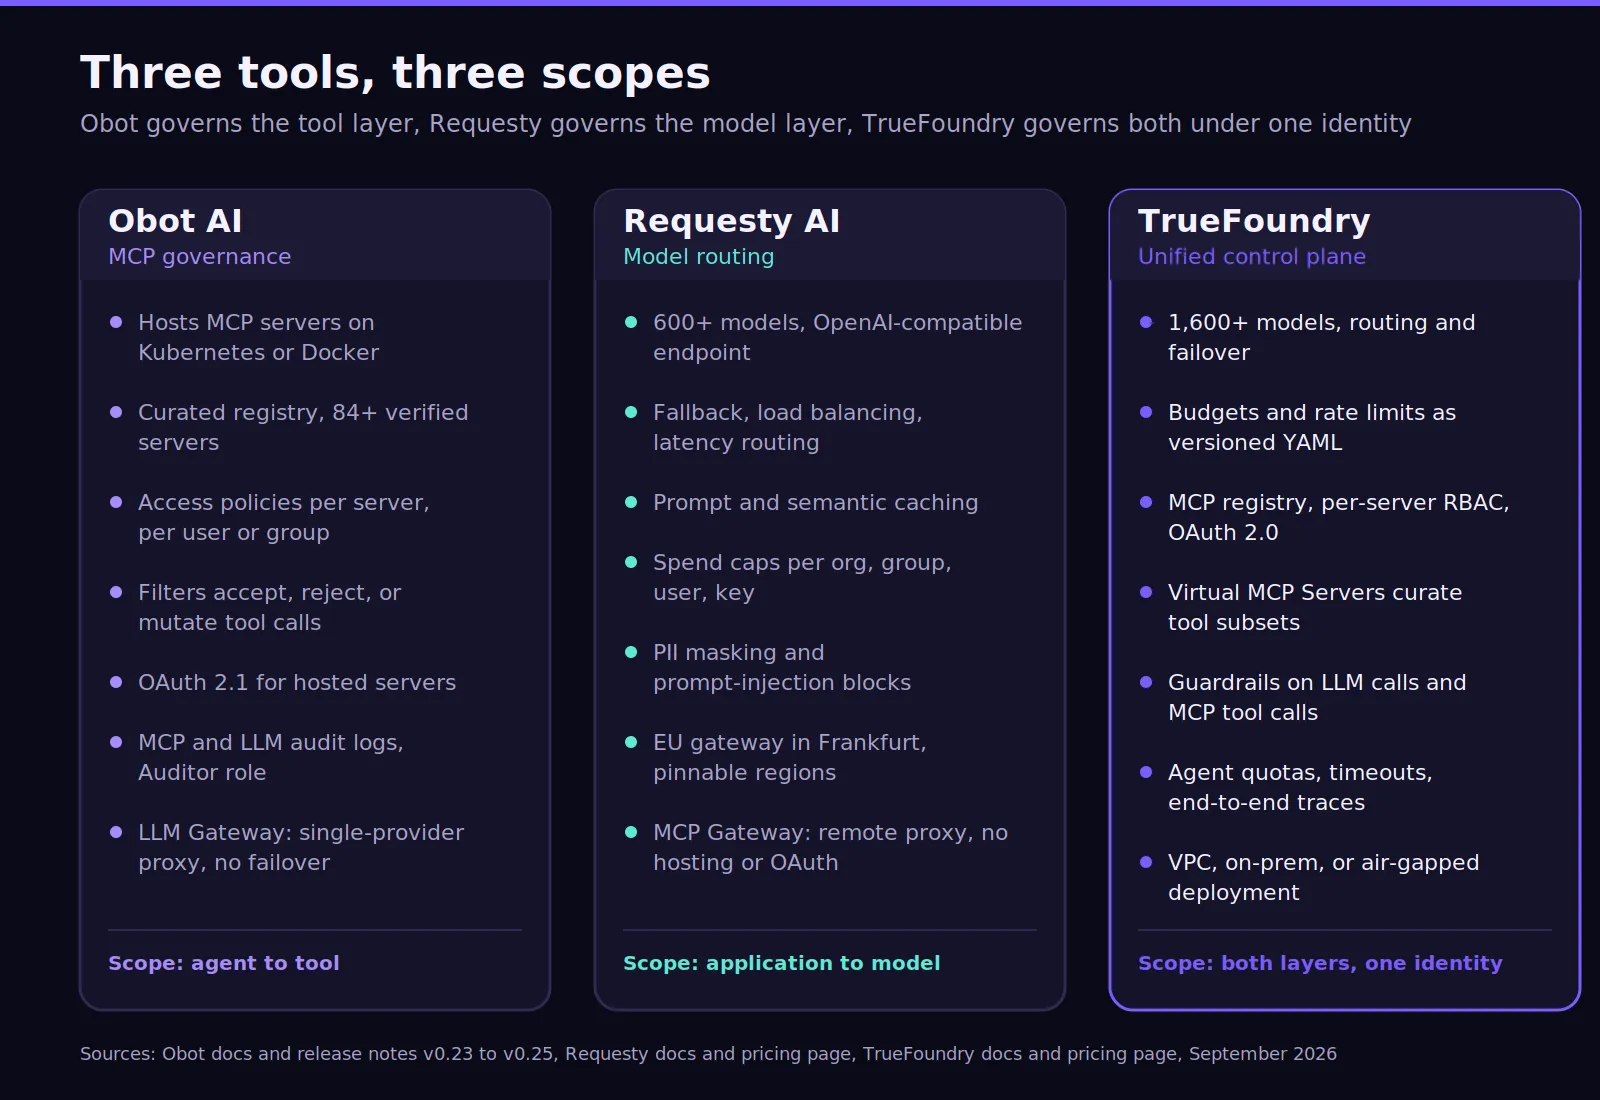
A comparação entre Requesty AI e Obot AI começa pelo reconhecimento de que seus papéis principais são distintos. A Obot situa-se na interseção entre agentes, modelos e ferramentas. A Requesty situa-se principalmente entre aplicações e provedores de LLM.
A Obot AI centraliza sua plataforma no Obot MCP Gateway. Ela pode hospedar ou atuar como proxy de servidores MCP, gerenciar credenciais, aplicar políticas de acesso e registrar requisições. Seu plano de controle também inclui um LLM Gateway, políticas de modelos, registros e serviços de agentes.
A Requesty foca mais fortemente no acesso a modelos. As aplicações alteram a URL base para a Requesty e acessam mais de 600 modelos por meio de um endpoint compatível com a OpenAI. As políticas de roteamento oferecem suporte a fallback, balanceamento de carga, seleção orientada a custos e roteamento baseado em latência entre diferentes provedores.
A distinção prática permanece bastante útil. A Obot ajuda as equipes de TI a governar quais identidades acessam quais ferramentas e modelos. A Requesty ajuda as aplicações a selecionar um provedor de modelos de forma confiável, controlando custos e disponibilidade.
Equipes que estão analisando a arquitetura de gateways de modelos também podem consultar a análise da TrueFoundry sobre LLM Gateway para entender o papel do acesso centralizado a provedores.
Tabelas de recursos podem esconder diferenças arquitetônicas, por isso as notas abaixo desta tabela são fundamentais. A Obot gerencia mais da infraestrutura MCP e pode rodar dentro de ambientes controlados pelo cliente. A Requesty opera como um serviço em nuvem gerenciado, removendo a maior parte das operações de gateway do lado do cliente.
As capacidades essenciais da Obot agora vão além do MCP. Seu LLM Gateway suporta OpenAI, Anthropic, Amazon Bedrock, Azure e endpoints compatíveis. Os administradores definem políticas de acesso aos modelos, enquanto a Obot armazena as credenciais de origem em vez de expô-las aos usuários.
O Obot Gateway também gerencia a hospedagem de MCP em Docker ou Kubernetes. Ele oferece suporte a servidores remotos quando as organizações já operam seus próprios servidores MCP. Filtros podem aceitar, rejeitar ou modificar o tráfego antes de encaminhar uma chamada de ferramenta aprovada.
A Requesty resolve um problema de roteamento diferente. Seu roteamento inteligente pode distribuir o tráfego com base em custo, latência, qualidade ou uma ordem de fallback definida. Isso a torna mais forte para confiabilidade entre múltiplos provedores e otimização de custos quando as aplicações usam diversos modelos comerciais.
O gerenciamento de agentes cria outra diferença clara. A Obot trata um agente de IA como uma identidade governada na plataforma, com acesso a modelos e ferramentas. A Requesty governa principalmente as políticas de roteamento de modelos que um agente utiliza.
O Obot Agent suporta conversas e fluxos de trabalho agendados, enquanto os Agent Authorization Scopes fornecem credenciais para máquinas. Um administrador pode restringir uma chave de API a servidores MCP selecionados, acesso ao proxy de LLM ou a outras capacidades. Isso permite o acesso seguro sem a necessidade do login interativo de uma pessoa.
Em vez de desenvolvedores inserirem credenciais diretamente em ferramentas de IA locais, a Obot oferece gerenciamento centralizado de credenciais e acesso aos servidores. Filtros garantem a aplicação de políticas antes que requisições aprovadas alcancem os sistemas downstream. O gateway também lida com fluxos OAuth de origem e renova o token OAuth necessário em nome do usuário.
O Device Management estende a visibilidade para clientes de desenvolvimento suportados, como Claude Code, Codex e Cursor. A imposição de políticas em chamadas de ferramentas permanece experimental, embora a atividade local ainda possa ser auditada. Isso garante às equipes de engenharia visibilidade sobre a atividade de IA fora de cargas de trabalho de agentes hospedadas centralmente.
A Requesty não oferece o mesmo modelo de execução de agentes hospedados. Em vez disso, ela permite que as organizações apliquem uma política de roteamento e um limite de gastos a agentes específicos. Isso é útil quando o requisito principal continua sendo a confiabilidade do modelo, e não a execução completa do fluxo de trabalho.
Equipes que estão avaliando alternativas para governança de agentes e MCP também podem consultar as alternativas ao Obot AI.
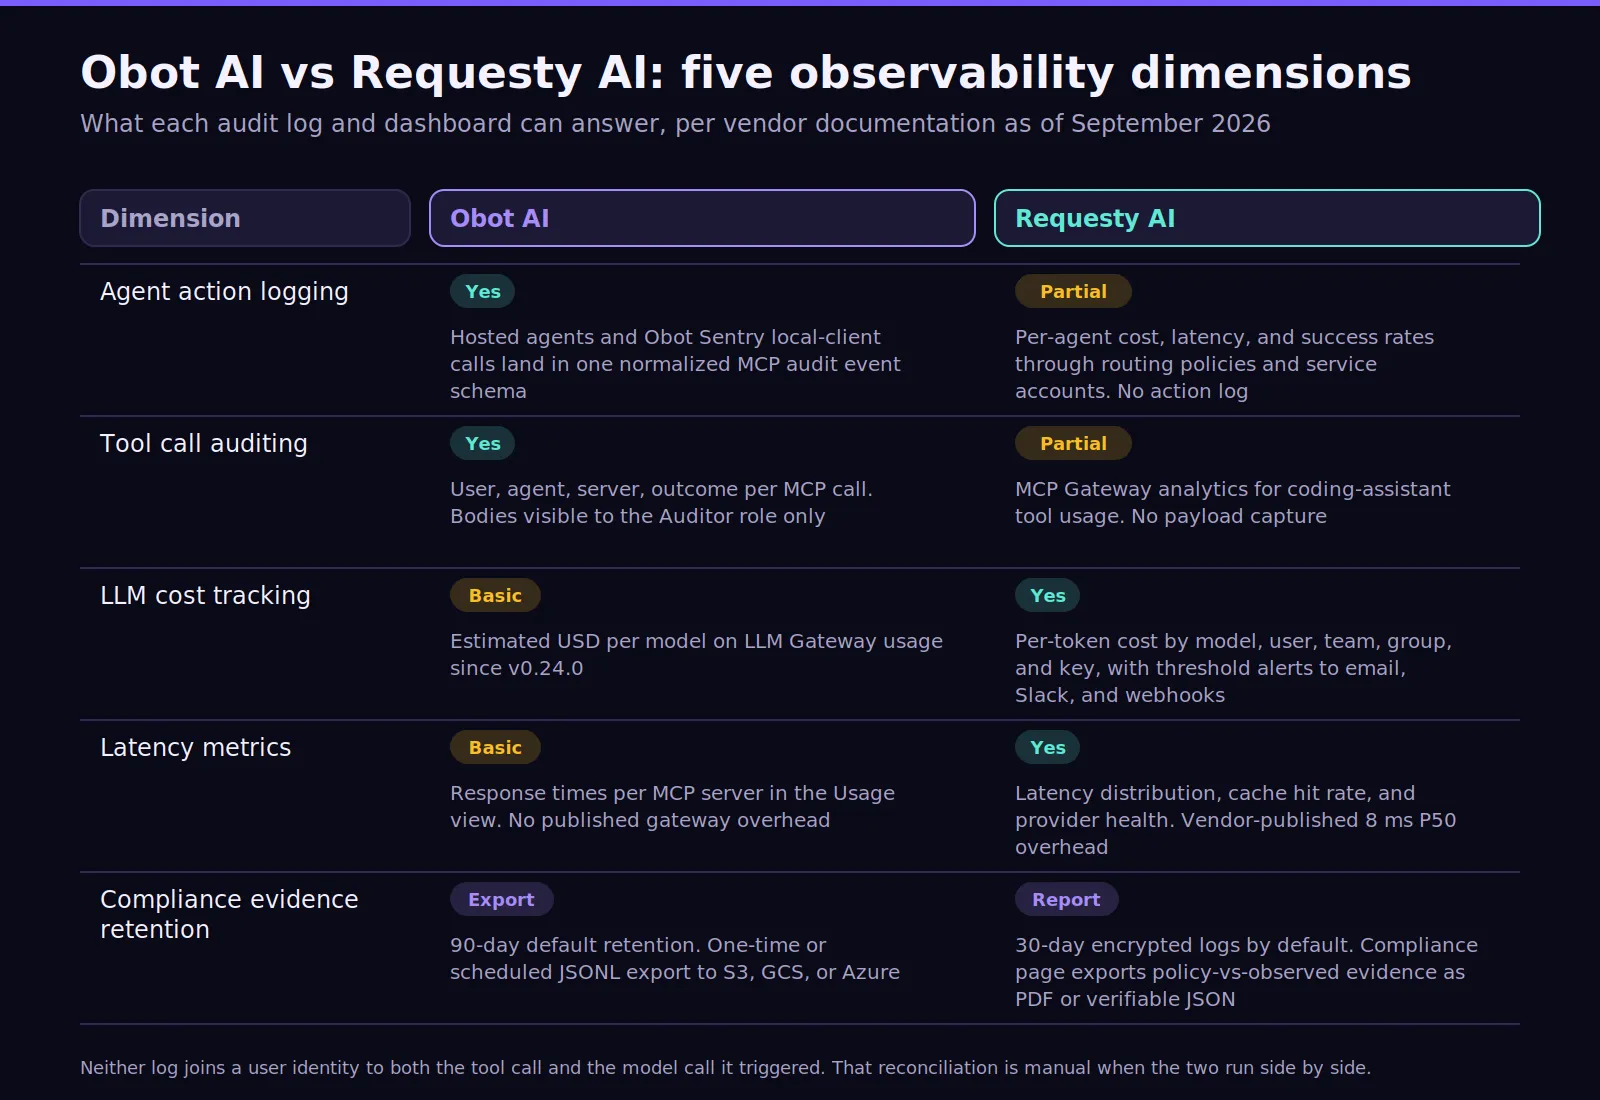
Ambas as plataformas oferecem recursos de observabilidade, embora respondam a perguntas operacionais diferentes. A Obot foca na atividade de agentes, modelos e ferramentas. A Requesty foca mais fortemente no comportamento de provedores, custos, roteamento e desempenho do gateway.
A Obot registra requisições MCP, usuários, carimbos de data/hora, resultados, informações do modelo e uso de tokens. Seus registros de auditoria de LLM também incluem provedor, modelo solicitado, detalhes do cliente e duração. O acesso a dados sensíveis de requisição ou resposta exige a função de Auditor.
As exportações de auditoria podem ser enviadas para o Amazon S3, Google Cloud Storage, Azure Blob Storage ou armazenamento de objetos compatível. Com isso, as organizações mantêm controle total sobre as evidências de longo prazo e podem alinhar o armazenamento aos seus requisitos de privacidade de dados.
A Requesty enfatiza latência de requisição, desempenho de cache, custo de modelo, falhas e roteamento de provedores. Seu painel oferece visibilidade em tempo real de custos e uso entre chaves, equipes e modelos. O gateway também oferece suporte ao roteamento regional baseado em políticas e endpoints com retenção zero de dados.
Essa distinção é importante para requisitos de conformidade. A Obot oferece uma trilha de auditoria detalhada sobre as ações de agentes e MCP. A Requesty oferece às equipes maior visibilidade sobre resultados de roteamento de modelos, aplicação de políticas e custos em todo o tráfego de modelos em produção.
Os modelos de preços e implantação refletem filosofias de gestão distintas. A Obot concede aos clientes maior controle da infraestrutura. A Requesty cobra por um gateway totalmente gerenciado e elimina a maior parte do trabalho operacional.
A Obot atualmente oferece três edições a partir da mesma imagem de contêiner. A edição padrão suporta até 100 usuários e 100 dispositivos. A edição Community permanece gratuita e adiciona suporte a Entra, Okta, JumpCloud e Auth0. A edição Enterprise remove esses limites e inclui suporte empresarial.
Uma implantação em Kubernetes ou Docker mantém a Obot dentro da infraestrutura do cliente. As cargas de trabalho MCP hospedadas rodam em contêineres separados ou em workloads do Kubernetes. Essa estrutura é adequada para organizações com requisitos rígidos de nuvem privada, credenciais internas ou armazenamento local de auditoria.
A Requesty oferece um ponto de entrada gratuito e um modelo de preços baseado no uso (pay-as-you-go). A precificação atual adiciona uma margem de 5% sobre os custos dos modelos de origem, enquanto chaves de provedores pertencentes ao cliente não possuem taxa adicional (0% de margem). O plano gratuito suporta 200 requisições diárias em modelos gratuitos disponíveis.
Os preços enterprise da Requesty são customizados. O plano Enterprise adiciona SSO, RBAC, suporte a conformidade, SLAs personalizados e controles organizacionais mais aprofundados. Seu período de observação SOC 2 Tipo II está em andamento, e a residência de dados na UE está disponível em Frankfurt.
Para cargas de trabalho em grande escala, as equipes devem comparar o licenciamento com a responsabilidade operacional. Escolher a auto-hospedagem significa que aplicação de patches, escalonamento, armazenamento e suporte continuam sendo responsabilidades internas. O modelo SaaS elimina grande parte desse trabalho, mas o cliente aceita as opções de implantação e os limites de segurança do fornecedor.
Leia também: Guia de custos de gateways de IA
O Obot AI é ideal para equipes que precisam de uma camada dedicada de governança de MCP. Ele é útil quando agentes internos, assistentes de código e clientes de IA precisam de acesso aprovado a servidores MCP locais, remotos ou hospedados. Ele também atende a organizações que preferem infraestrutura de código aberto e controle auto-hospedado.
Cabe uma ressalva aqui. O limite de 100 usuários e 100 dispositivos abaixo do plano Obot Enterprise foi introduzido na versão v0.25.0 e agora se aplica a implantações com autenticação via GitHub e Google, que antes eram ilimitadas. Os usuários existentes continuam funcionando além do limite, mas não é possível adicionar novos. Dimensione seu projeto piloto considerando esse número.
O Requesty AI é ideal para equipes que precisam de acesso rápido a diversos modelos por meio de um gateway gerenciado. Seu maior valor vem da entrega confiável de provedores de LLM, políticas de roteamento, armazenamento em cache, análises e controles de gastos sem a necessidade de uma infraestrutura auto-hospedada.
A plataforma também funciona muito bem para protótipos em que as equipes desejam realizar experimentos rápidos com modelos. Assim que o uso atingir picos moderados de RPS ou mais elevados, as equipes devem testar a confiabilidade do provedor e cenários de alta latência usando tráfego real de produção em vez de requisições isoladas.
O gateway da Requesty consegue contornar provedores instáveis e aplicar restrições de modelos de forma centralizada. Isso melhora a experiência do desenvolvedor quando, do contrário, as equipes teriam que manter credenciais e integrações separadas. Sua interface compatível com a OpenAI também minimiza modificações na aplicação.
Escolher o Obot AI ou o Requesty AI com base apenas em uma demonstração pode levar a conclusões erradas. Uma plataforma pode demonstrar o bloqueio de acesso a ferramentas, enquanto a outra demonstra um failover bem-sucedido. Ambos os cenários são importantes, embora cada um meça uma camada diferente do ambiente de produção.
A comparação entre Obot AI e Requesty AI revela uma limitação compartilhada quando um único fluxo de trabalho cruza ambas as camadas. O Obot governa modelos, agentes e acesso a MCP dentro da sua plataforma. O Requesty oferece um roteamento mais profundo entre provedores. Nenhum dos dois combina todos os controles empresariais com a mesma profundidade.
Um fluxo de trabalho de suporte pode chamar um modelo, consultar um CRM via MCP, atualizar um chamado e disparar outro agente. Isso cria um risco potencial de exposição de dados quando identidade, permissões, orçamentos e logs estão distribuídos em sistemas independentes.
O Requesty também expandiu suas próprias integrações MCP. Seu MCP Gateway oferece suporte a autenticação centralizada, listas de permissão de ferramentas, análises de uso e credenciais compartilhadas ou por usuário para servidores MCP remotos. No entanto, ele não substitui a hospedagem completa de MCP nem a governança total da execução de agentes.
As lacunas ficam mais evidentes quando as equipes precisam de uma única política cobrindo modelos e ferramentas:
Uma camada dedicada para agentes torna-se relevante quando essas ações se transformam em fluxos de trabalho de várias etapas. O Agent Gateway da TrueFoundry oferece retentativas, tempos limite, controles de política, rastreabilidade e execução governada de ferramentas em todos esses fluxos de trabalho.
A TrueFoundry é a escolha ideal quando empresas buscam uma única plataforma para conectar a governança de modelos, ferramentas e agentes. Seu plano de controle de IA reúne roteamento de modelos, identidade, políticas, orçamentos, guardrails e observabilidade em uma mesma arquitetura de produção.
A camada de modelos suporta roteamento entre múltiplos provedores e serviço de modelos em endpoints hospedados ou auto-hospedados. As políticas de orçamento podem ser aplicadas a usuários, equipes, modelos ou metadados antes que requisições adicionais sejam executadas.
Uma regra de orçamento é um objeto YAML versionado, portanto ela reside no Git junto com o restante da configuração da plataforma:
Quando o pipeline de RAG da equipe de suporte ultrapassa US$ 5.000 em um mês, o gateway retorna um código 429 com `error_origin_level: rate_limit_budget` no corpo e o ID da regra violada no cabeçalho `x-tfy-applied-rules`, evitando surpresas na fatura. Isso cobre o caso de uso de acesso a múltiplos provedores e governança de custos oferecido pelo Requesty AI, com o benefício arquitetônico adicional da implantação nativa em VPC.
O TrueFoundry MCP gateway oferece RBAC por servidor, abstrações de Virtual MCP Server, gerenciamento de tokens OAuth 2.0 com renovação automática e trilhas de auditoria vinculadas à identidade do usuário para cada invocação de ferramenta.
Um Virtual MCP Server seleciona um subconjunto de ferramentas de vários servidores registrados (por exemplo, GitHub sem `delete_pr` e Slack sem `delete_message`) e os expõe como um endpoint único que não exige implantação. Os guardrails são vinculados na mesma camada de políticas, e um único arquivo YAML governa chamadas de LLM e chamadas de ferramentas MCP:
Essa arquitetura é extremamente útil quando produtos de gateway separados criariam políticas sobrepostas. Ela também simplifica a governança quando várias equipes compartilham modelos, agentes e ferramentas MCP entre diferentes ambientes.
Escolha a TrueFoundry quando:
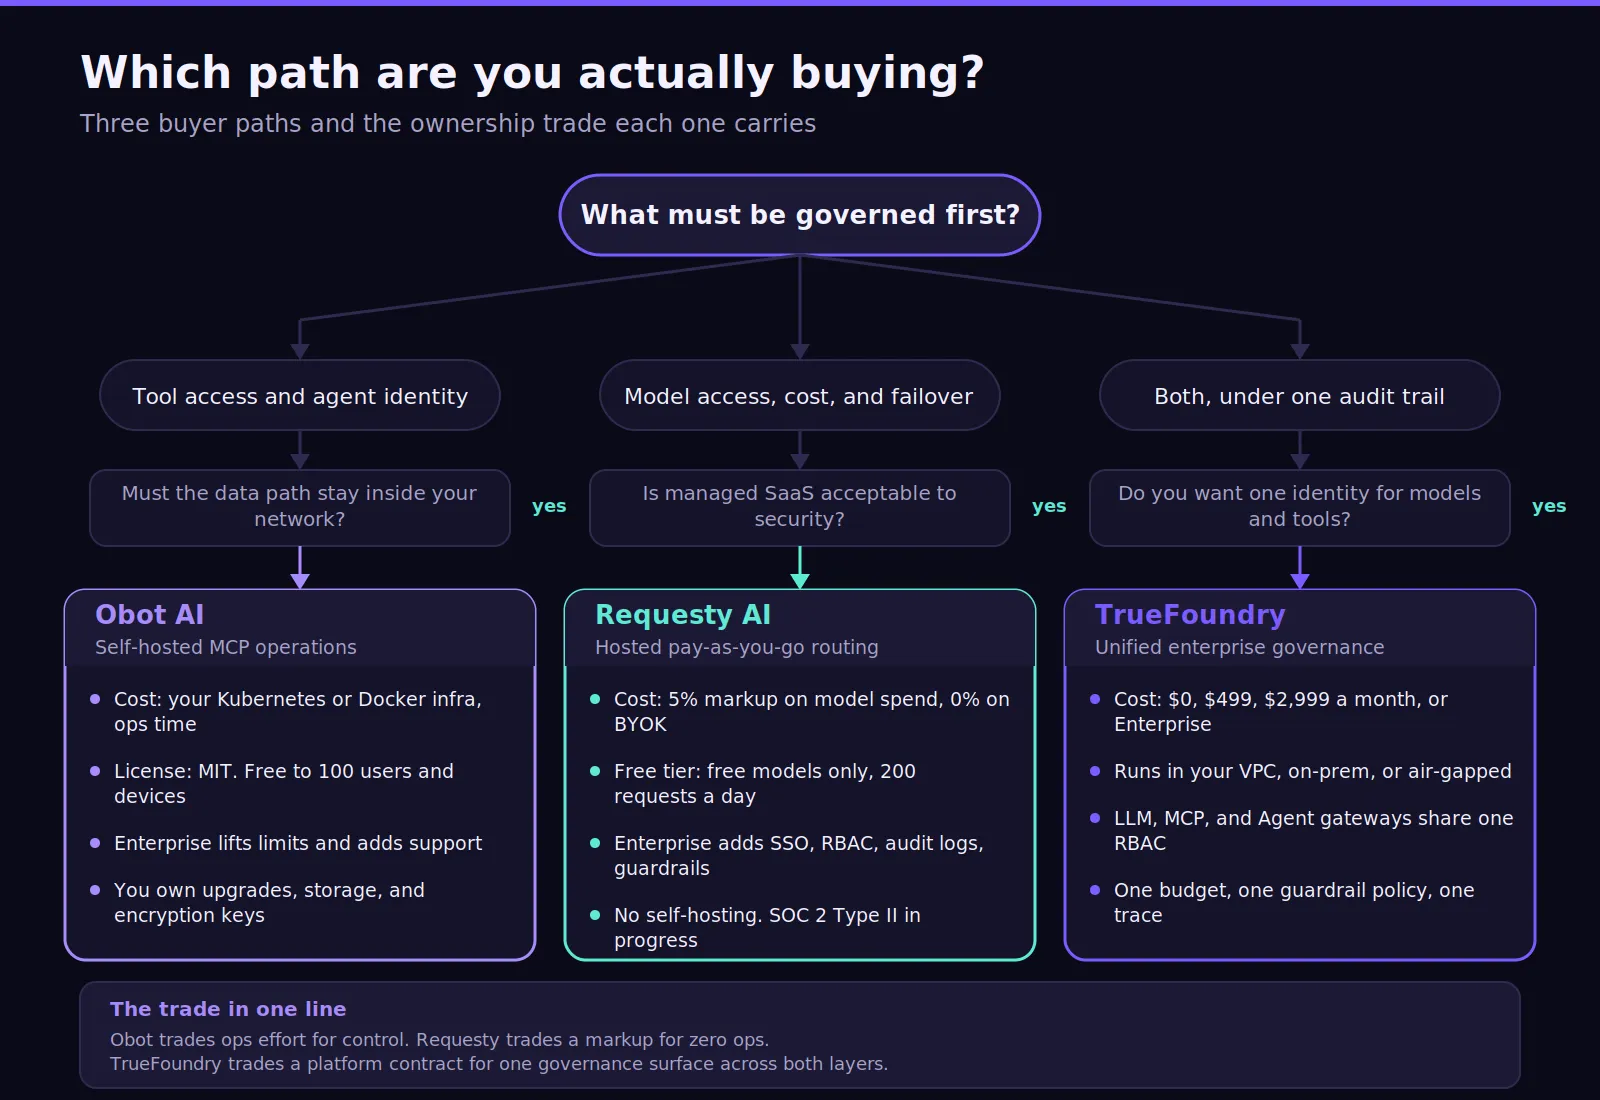
A TrueFoundry oferece atualmente o plano Developer a $0, Pro a $499 mensais, Pro Plus a $2,999 e planos Enterprise com valores personalizados. O plano Enterprise oferece suporte a planos de controle e gateways em VPC e em ambientes isolados (air-gapped).
Para equipes que estão comparando arquiteturas de produção mais amplas, a TrueFoundry oferece uma camada única de controle para modelos, ferramentas, agentes e execução empresarial governada.
Agende uma Demonstração com a TrueFoundry para ver como um plano de controle empresarial único pode governar com segurança modelos, ferramentas MCP, agentes, orçamentos, políticas e evidências de auditoria no seu ambiente de IA em produção hoje mesmo.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















