


November 13, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Um juiz é um modelo que recebe três coisas: uma saída para avaliar, uma rubrica descrevendo o que significa "bom" e uma instrução para retornar um veredito legível por máquina — aprovação/reprovação, uma pontuação ou uma preferência entre dois candidatos.
Ele existe porque a alternativa não escala. Métricas de correspondência exata funcionam quando há apenas uma resposta certa; são inúteis para uma resposta de suporte onde cinco respostas estão todas corretas. Humanos avaliam isso bem, porém lentamente. Um juiz fica no meio do caminho: pior do que um humano atento, muito melhor do que uma comparação de strings, e rápido o suficiente para milhares de amostras. Trate-o como um proxy barato, ruidoso e correlacionado à avaliação humana.
O erro mais comum aqui é tratar a avaliação offline e o bloqueio online como a mesma coisa com dois alvos de implantação diferentes.
A linha sobre modos de falha é a mais importante para assimilar. Offline, uma pontuação errada custa uma decisão que você revisita na próxima sprint; online, é um usuário olhando para um erro. Por isso, ajuste um juiz online para ter alta precisão, mesmo que custe a revocação (recall). Copiar uma rubrica entre esses modos é o motivo pelo qual as equipes terminam bloqueando uma porcentagem de tráfego legítimo.
Os juízes são bons em critérios que são descritíveis, mas não computáveis — por exemplo, se a resposta está embasada no contexto recuperado ou se o tom é adequado para um ambiente clínico. Você pode escrever a regra em um parágrafo, mas não como uma regex. Eles falham de três maneiras principais.
Viés de posição. Dados dois candidatos, os juízes favorecem uma determinada posição; ao inverter a ordem, uma parcela significativa dos vereditos muda. A mitigação é avaliar cada par duas vezes com as posições invertidas e considerar apenas as concordâncias, o que dobra o seu custo.
Viés de verbosidade. Respostas mais longas recebem pontuações mais altas, quase independentemente de as palavras extras adicionarem valor. Isso silenciosamente empurra os prompts de produção para o preenchimento de linguiça: você otimiza para o juiz, o juiz recompensa a extensão, a conta de tokens sobe e ninguém conecta as duas coisas.
Autopreferência. Um modelo pontua mais alto textos que se assemelham às suas próprias gerações. Se o GPT julgar a saída do GPT, a pontuação será inflada — o argumento mais forte para usar um juiz de uma família diferente do modelo sob teste.
Os juízes também são mal calibrados em escalas contínuas: peça uma nota de 1 a 10 e tudo se concentra em 7 e 8. Um aprovação/reprovação binário com base em um critério rigoroso é muito mais confiável. Além disso, um juiz não pode verificar um fato que ele não possui — sem material de referência, você obtém apenas suas suposições prévias, e não uma checagem de fatos.
Escolha uma família diferente do modelo sob teste, porque a autopreferência é real e fácil de evitar. Escolha um modelo menor do que você pensa, porque julgar é uma classificação com base em um prompt longo, e não um raciocínio complexo. Escolha uma versão fixada, não flutuante, porque um alias de provedor que se atualiza automaticamente altera seu nível de qualidade sem uma mudança de código. E garanta um p99 menor do que o sistema que ele protege, caso contrário o juiz se tornará o gargalo de latência da sua aplicação.
Depois, faça as contas. Um juiz inline representa uma segunda inferência; se verificar tanto o prompt quanto a resposta, serão duas. Isso não é algo que você possa eliminar via engenharia, então a questão é qual fração do tráfego avaliar:
Se você pode expressar a regra como código, expresse-a como código.
Elas aplicam a rubrica offline diretamente no caminho da requisição. Uma rubrica de dez dimensões que funciona em uma execução noturna torna-se um bloqueador lento e de alta variação em produção. As rubricas online devem ter apenas um critério, ser binárias e formuladas de maneira estrita o suficiente para que um modelo pequeno responda com consistência.
Elas nunca medem o desempenho do juiz. Trata-se de um modelo em produção sem avaliação própria. Rotule manualmente algumas centenas de exemplos reais e analise a precisão e a revocação separadamente. Se você não consegue indicar a taxa de falsos positivos, não pode afirmar qual fração de usuários o guardrail está impactando incorretamente.
Elas passam direto para o modo de bloqueio. Um juiz que é 90% preciso bloqueia uma em cada dez respostas boas no dia em que você o impõe. Faça auditorias primeiro, analise uma semana de traces e só então promova para o modo definitivo.
Elas se esquecem das respostas em streaming. Transmita tokens para o navegador e um juiz de saída não terá nada para avaliar até que o streaming termine. A maioria dos gateways, incluindo o TrueFoundry, ignora os guardrails de saída em requisições com streaming.
O TrueFoundry não possui um produto de eval. Não há página de avaliação, datasets, rastreamento de experimentos ou UI de pontuação. A avaliação offline pertence a plataformas construídas para essa finalidade, e o papel do TrueFoundry é exportar traces via OpenTelemetry — traces, não métricas OTEL, a partir dessa tela. Para um conjunto de dados pontuado e um leaderboard, use o Braintrust, o Arize ou um equivalente, e aponte o exportador para ele.
O que o TrueFoundry implementa é a metade online: um juiz executando como guardrail no caminho da requisição, com seu veredito, latência e consumo de tokens registrados no mesmo trace da requisição protegida.

Cada juiz abaixo é um pequeno serviço que você implanta, chamado pelo gateway como um rail por meio do contrato de custom-guardrail. Esse contrato possui uma regra valiosa para memorizar: HTTP 2xx significa que o guardrail foi executado até o fim, e a decisão de política reside exclusivamente no corpo JSON. A documentação alerta que um erro "bloqueado" sinalizado como HTTP 400 pode ser lido como um erro de execução e ser liberado. Retorne 2xx com verdict: false.
O NeMo roda como um wrapper FastAPI implantado no TrueFoundry — sem chamadas nativas do SDK do NeMo a partir do gateway, e sem alterações no SDK do cliente em sua aplicação. Internamente, ele usa um LLM juiz de pequeno porte acompanhado da Colang, uma linguagem de domínio específico, para avaliar prompts e respostas por meio dos rails self_check_input e self_check_output. A rubrica reside no pacote Colang, onde config/prompts.yml armazena exemplos few-shot que na v1 identificam role-play no estilo DAN, instruções para "ignorar instruções anteriores", extração de prompt do sistema e marcadores de desvio de política.
O detalhe operacional fundamental: o LLM juiz faz chamadas de volta através do mesmo gateway do TrueFoundry. O arquivo .env do wrapper contém TFY_BASE_URL, TFY_API_KEY e JUDGE_MODEL — o exemplo da documentação usa openai-main/gpt-4o-mini. Como a inferência do juiz é um tráfego do gateway, seus tokens, custo e latência aparecem nos mesmos painéis que todo o resto, permitindo ver exatamente o custo dos guardrails. A troca de juízes é feita em uma linha: altere JUDGE_MODEL (a documentação mostra openai-main/gpt-4o) e faça a redimplantação.
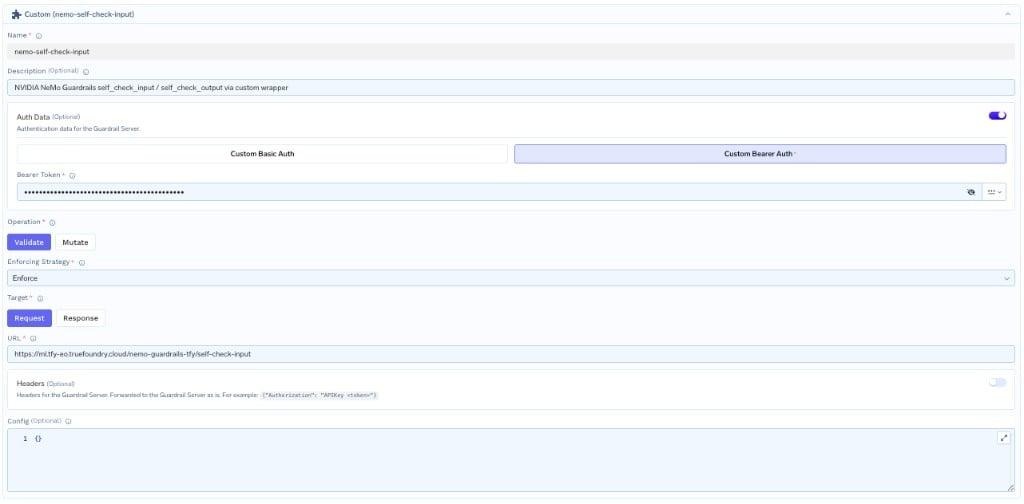
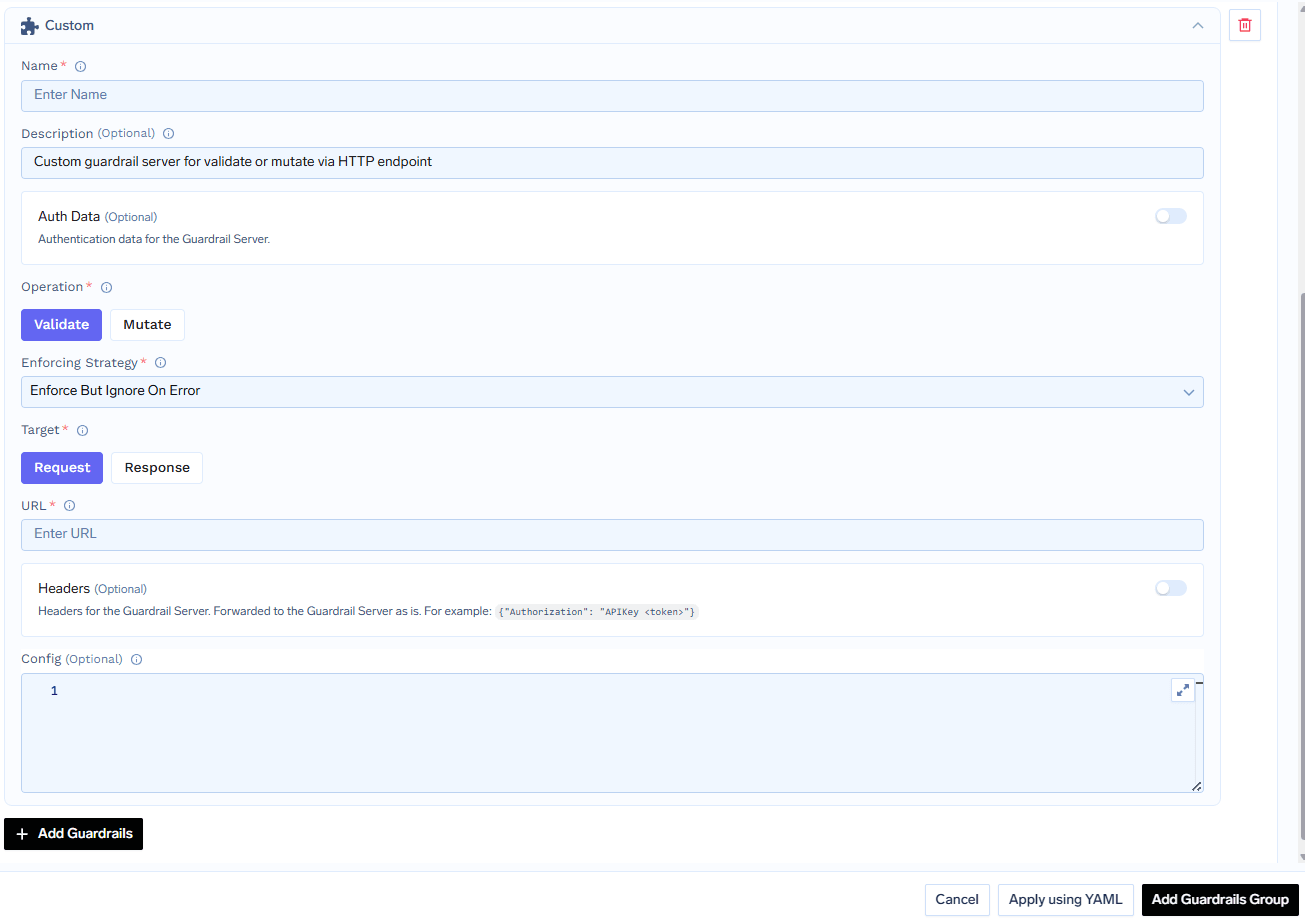
Registre duas configurações de Custom Guardrail, ambas do tipo Validate — seletores nemo-self-check/nemo-self-check-input e .../nemo-self-check-output — recomendando-se a opção Enforce But Ignore On Error. O contrato de veredito é enxuto: HTTP 200 com {"verdict": bool, "message": Optional[str]}; uma falha real chega como 5xx.
O gateway envia a chamada do rail de entrada e a chamada do modelo em paralelo, para que o juiz não adicione latência ao time-to-first-token; em caso de bloqueio, ele cancela a chamada do modelo em andamento. O rail de saída é executado de forma sequencial, por necessidade.
A documentação é transparente em relação aos custos. Sob limitações conhecidas, em suas próprias palavras: cada requisição protegida adiciona uma ou duas chamadas de LLM, uma por direção. Ela também observa que não há guardrails compatíveis com streaming, pois o contrato é em buffer, e que o estado em memória é mantido por réplica.
O Patronus é o mais próximo de um juiz pronto para uso no catálogo, operando exclusivamente no modo Validate-only — a operação é literalmente "validate", e a documentação afirma que ele não pode aplicar mutações.
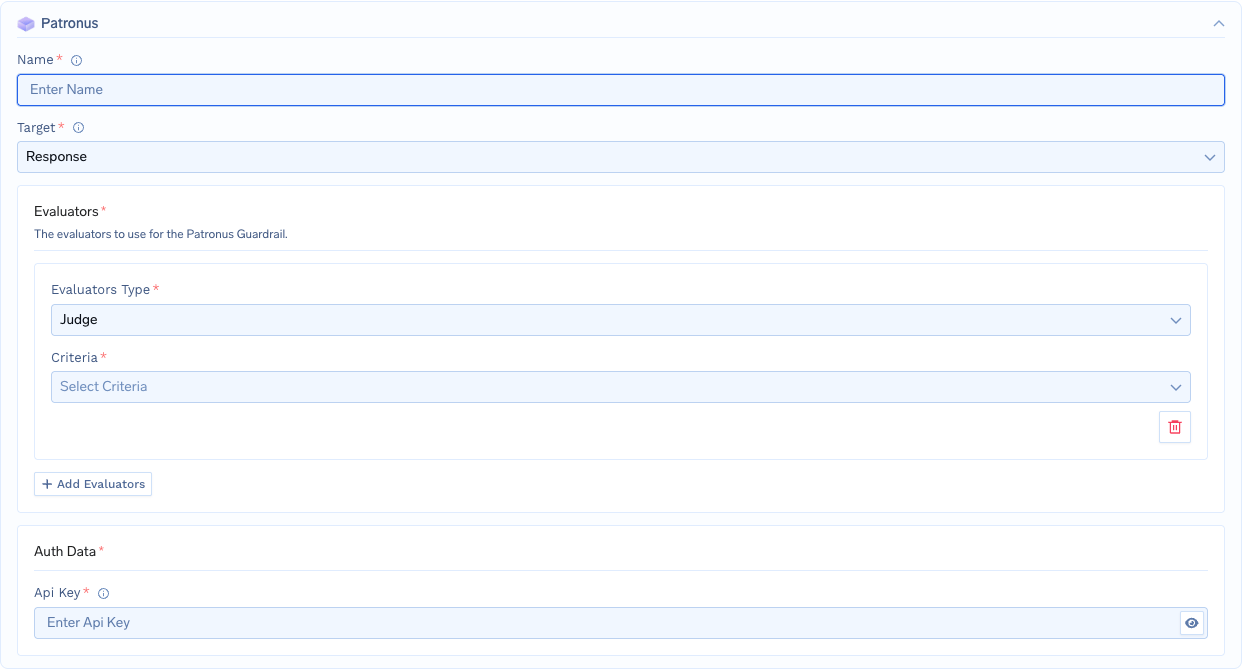
O tipo de configuração é integration/guardrail-config/patronus. Defina target como request ou response e liste os avaliadores; existem seis tipos — answer-relevance, glider, judge, pii, phi, toxicity. O tipo judge é o baseado em LLM como juiz, e seu campo criteria é obrigatório. Todos os quinze valores documentados são:
A família irmã glider adiciona mais cinco: patronus:is-compliant, patronus:is-factually-consistent, patronus:is-good-summary, patronus:is-harmful-advice, patronus:is-informal-tone.
Comparando com a tabela de decisão anterior, a divisão é clara: is-json e is-csv são verificações de formato que um validador faz melhor e mais barato, enquanto no-harmful-therapeutic-guidance e is-good-summary são critérios exclusivos de texto descritivo para os quais o juiz foi feito.
Se data.results[].evaluation_result.pass for falso, a requisição é bloqueada e um código 400 é retornado. A resposta de exemplo da documentação exibe evaluator_id: "judge-large-2024-08-08", evaluator_family: "Judge", profile_name: "patronus:prompt-injection", pass: false, score_raw: 0, evaluation_duration: "PT4.44S", usage_tokens: 687, e evaluation_metadata.highlighted_words. A página cita tempos de resposta de até 100 ms; no entanto, essa duração de exemplo de 4.44 segundos lembra que o percentil mais alto de um juiz pode ser bem distante da sua média.
A maior parte do Guardrails AI deliberadamente não é um juiz. O seu pacote v1 — DetectPII, SecretsPresent, ToxicLanguage, ProfanityFree em sete endpoints — roda localmente no pod do wrapper, sem chamadas extras de LLM por requisição, garantindo latência abaixo de 100 ms em regime permanente.
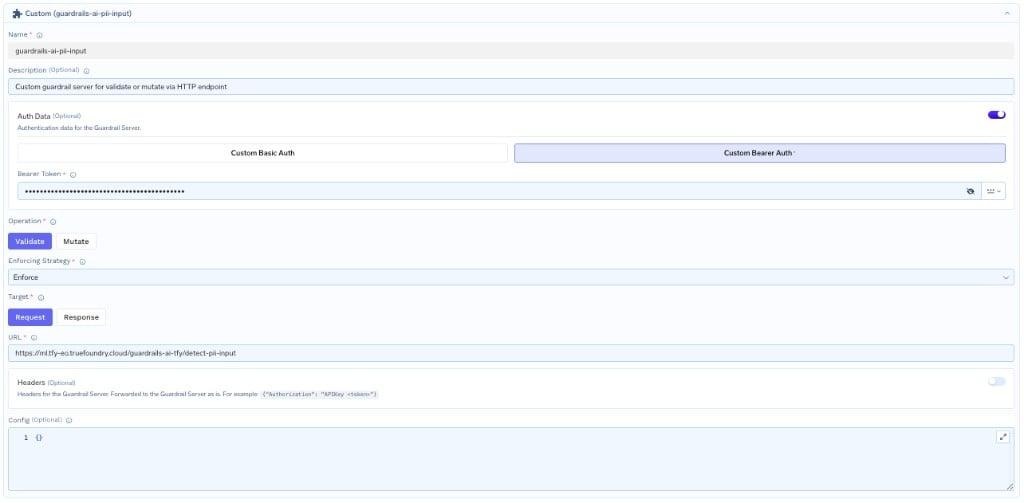
Os validadores baseados em juízes são uma camada opcional do Hub: hub://guardrails/restricttotopic (avaliado por LLM), hub://guardrails/provenance_llm — classificado na documentação como caro — e hallucination_check. Configure-os através de variáveis de ambiente LITELLM_* e roteie-os pelo seu gateway para observabilidade unificada, no mesmo padrão que o NeMo utiliza para o JUDGE_MODEL. Alternativas baratas ficam ao lado deles: competitor_check é baseado em allowlist, e regex_match é, como a documentação diz, muito barato.
A página sobre alucinação do TrueFoundry documenta quatro tipos — factual, contextual, lógica e de fonte — e exatamente duas rotas de implementação: AWS Bedrock Guardrails, onde você ativa Grounding e Relevance, ajusta a Guardrail Action para Block e define um limite; ou um guardrail customizado baseado no repositório de modelos (template repo).
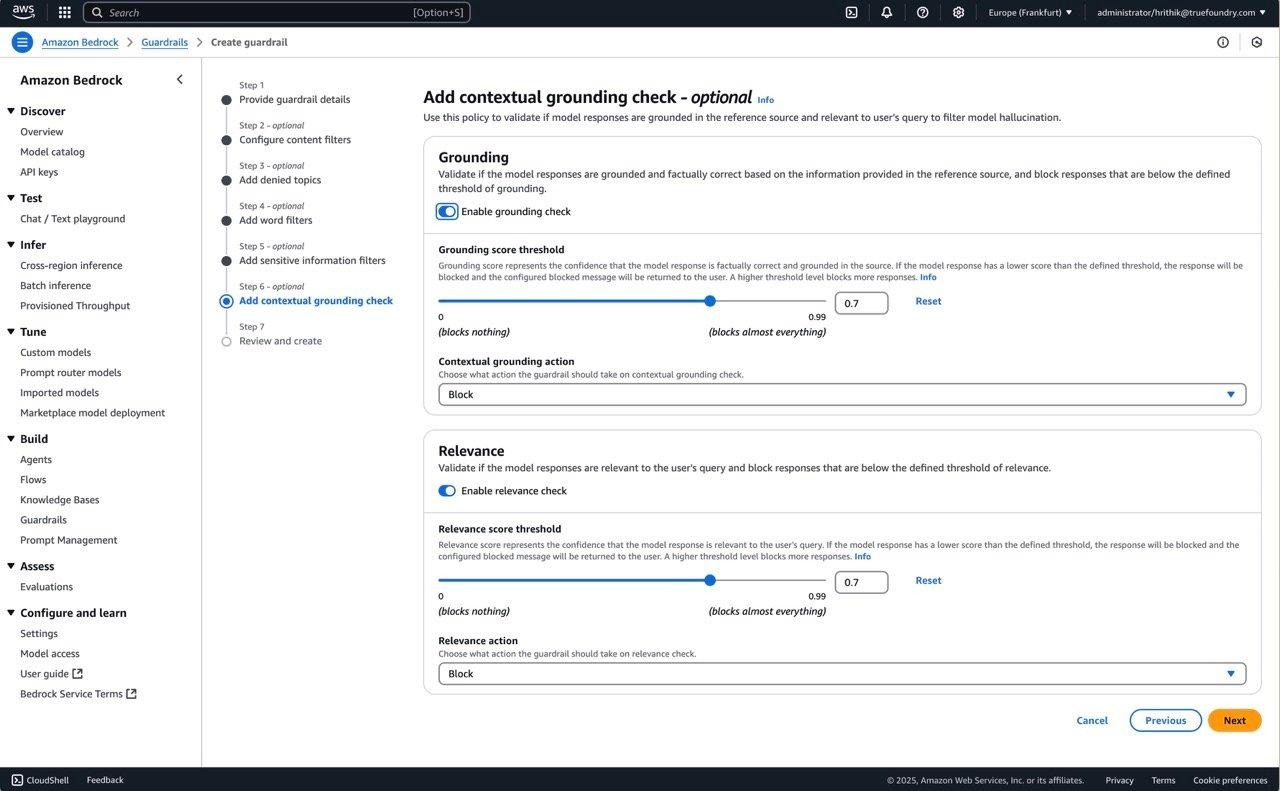
A documentação deixa claro que o repositório de modelos atualmente não inclui um guardrail de alucinação nativo pronto para uso — ele oferece exemplos como redação de PII e filtragem NSFW. O caminho customizado exige desenvolvimento ativo, não sendo apenas uma opção para marcar.
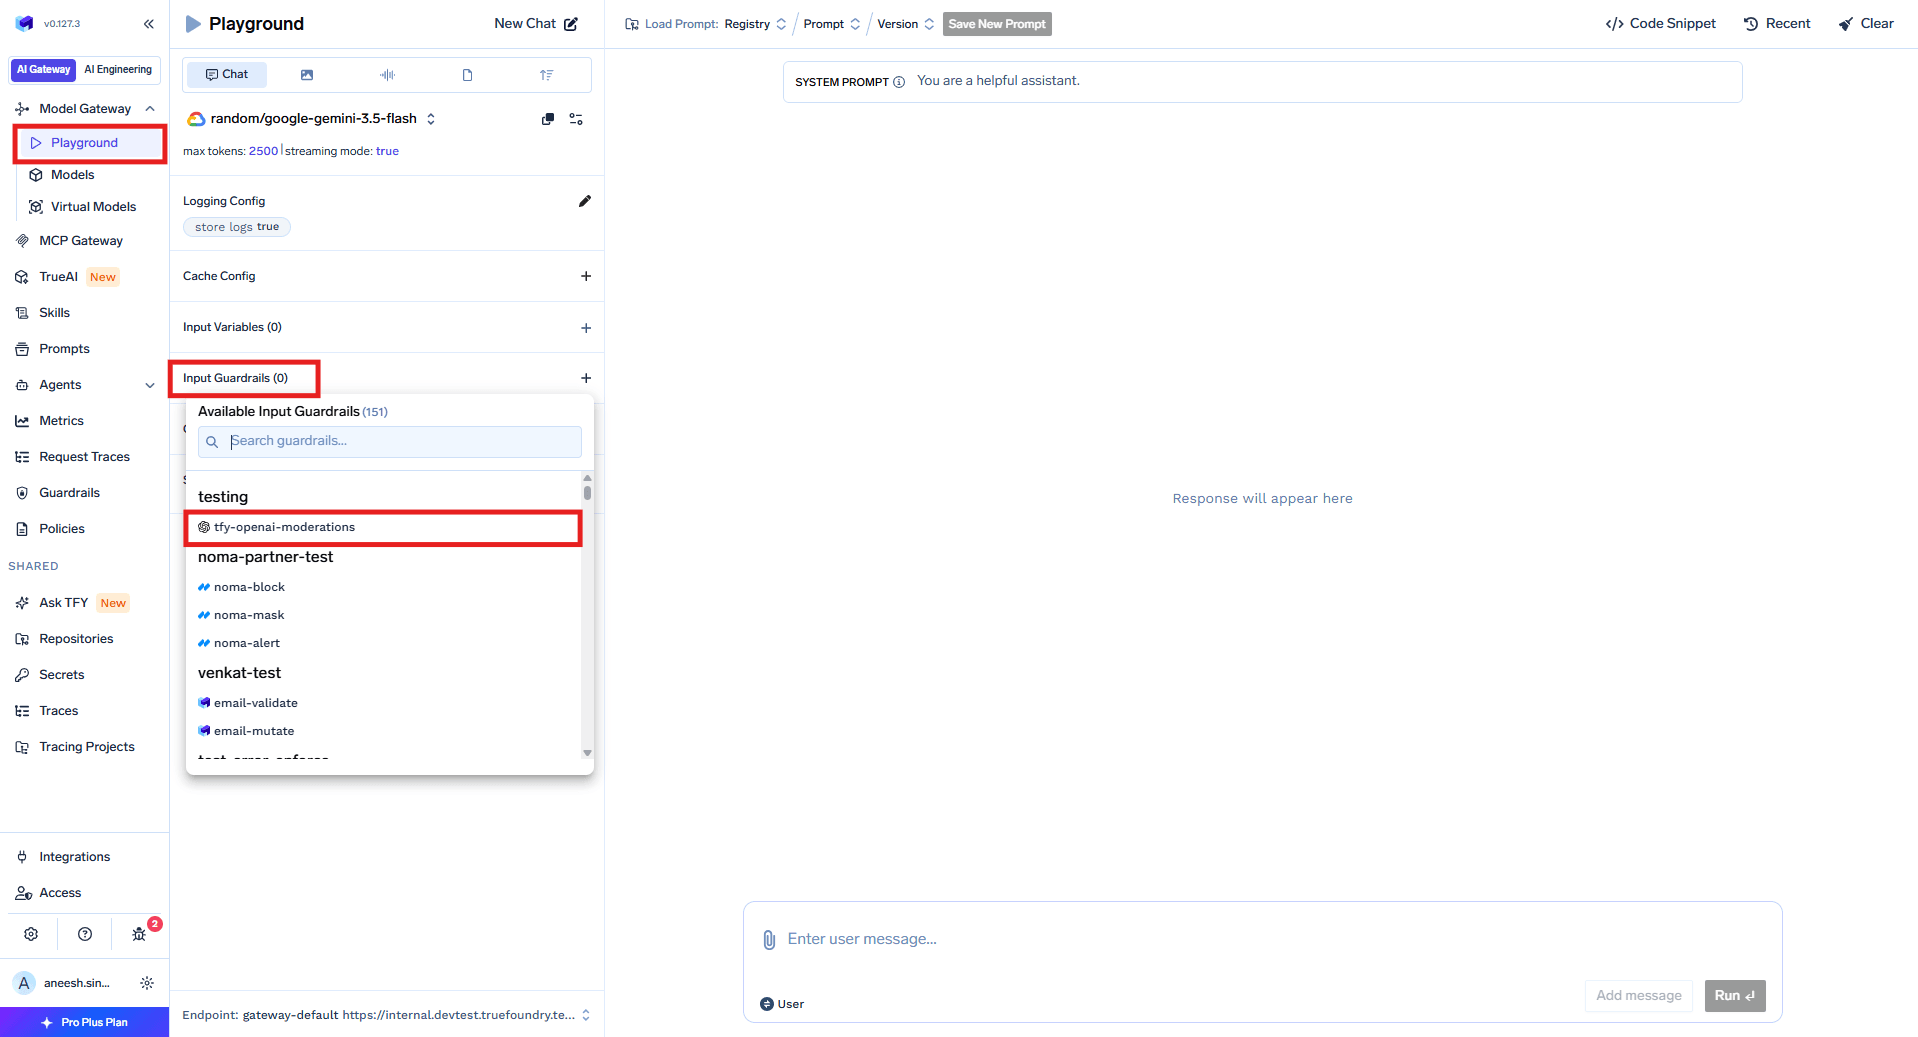
O Playground executa todos os quatro hooks, permitindo testar um prompt adversarial no rail de entrada antes de aplicar qualquer política de fato.
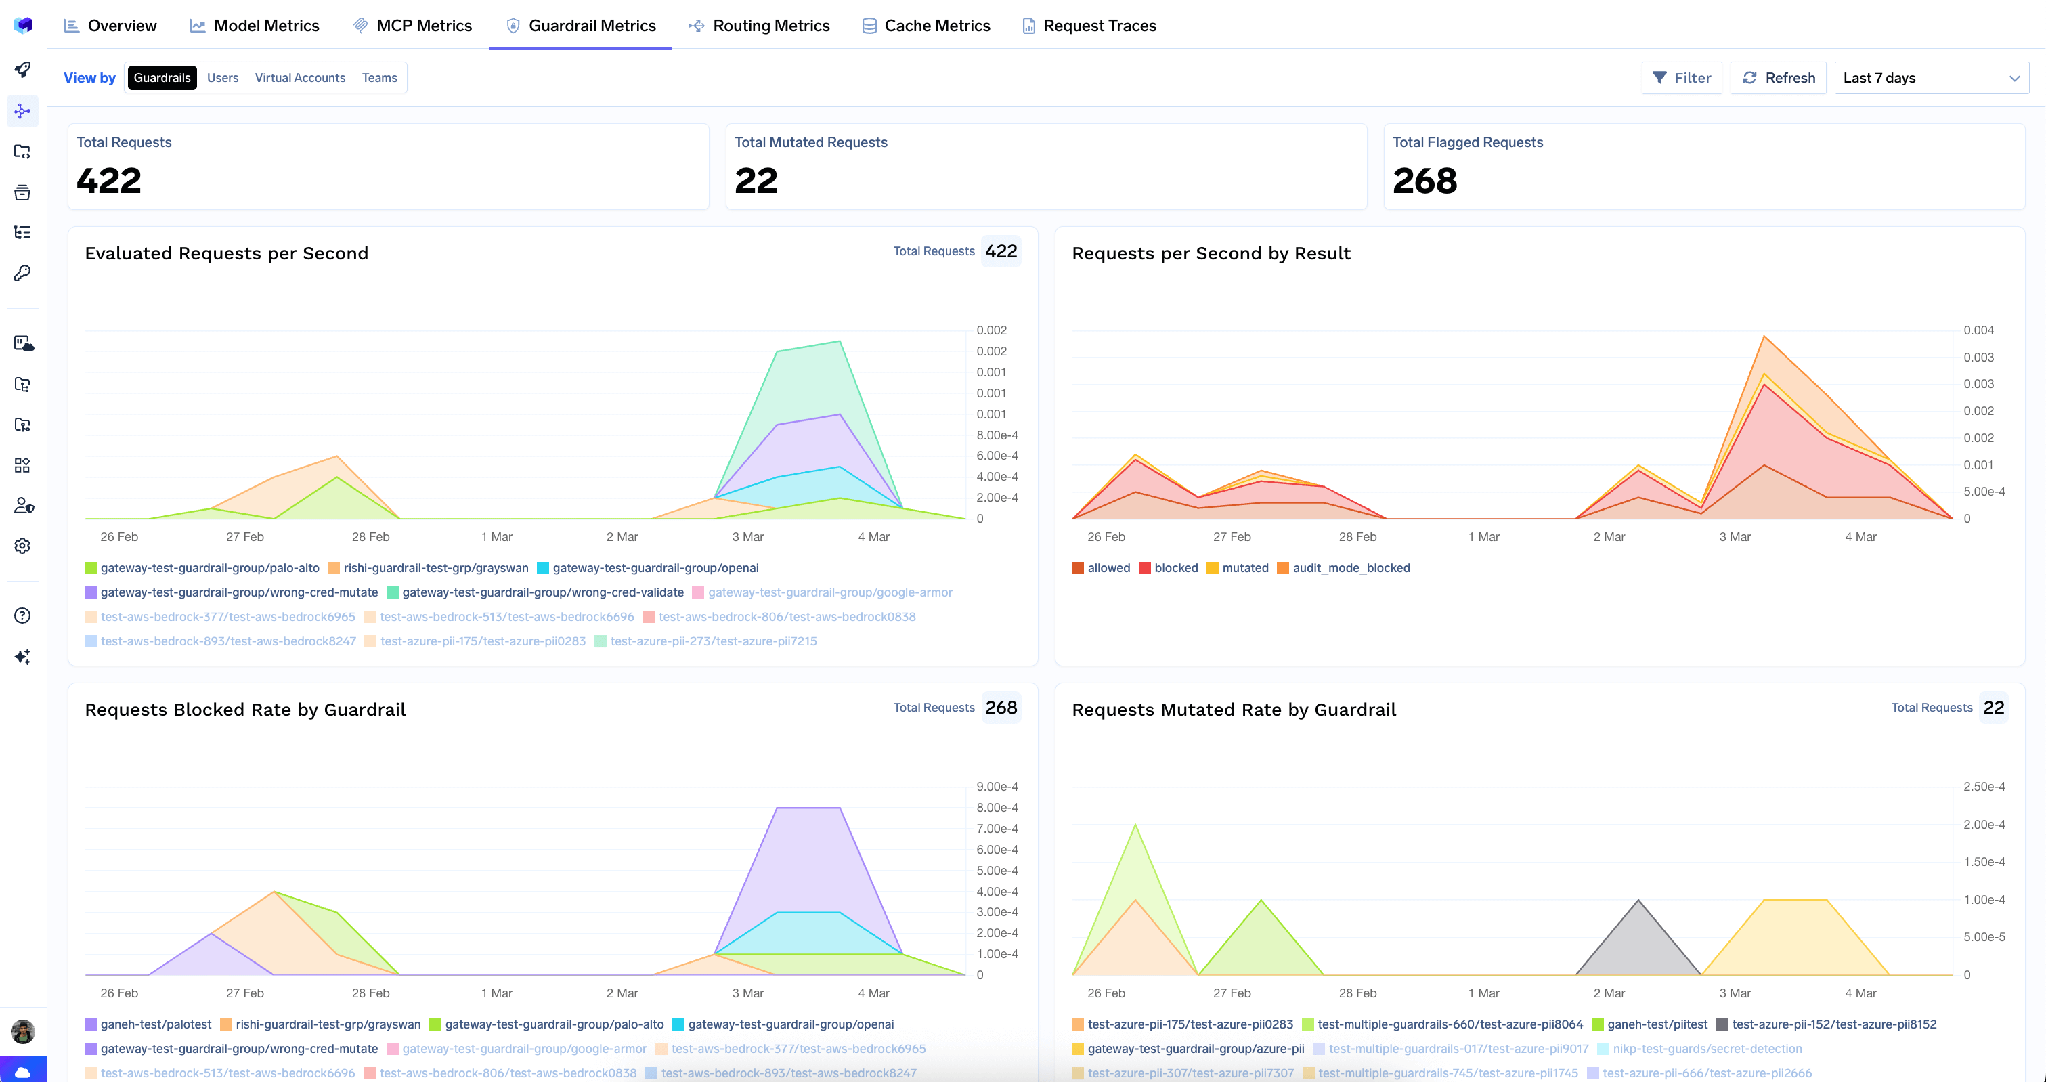
Quando em produção, cada avaliação de guardrail torna-se seu próprio span em Monitor → Request Traces, registrando tempo de execução, resultado, escopo, entrada e saída — inclusive para requisições bloqueadas, garantindo que uma chamada negada sirva como auditoria em vez de lacuna de dados.

De forma agregada, a visualização de guardrails no Metrics Dashboard divide as requisições por segundo entre allowed, blocked, mutated e audit_mode_blocked, exibindo taxas de bloqueio e mutação por guardrail e latência nos percentis P50, P75, P90 e P99. Este último gráfico é essencial para identificar quando o atraso de um juiz está afetando a latência geral do seu sistema.
O veredito de um juiz é uma estimativa de qualidade, e a única maneira de testá-lo é comparando-o com o veredito humano para a mesma requisição. Cada resposta do AI Gateway traz um cabeçalho x-tfy-feedback-target-id. Envie uma requisição POST para https://{control_plane_url}/api/svc/v1/gateway-feedback contendo {"target": {"feedbackTargetId": "<base64>"}, "rating": 4, "comment": "...", "metadata": {...}} — onde a avaliação varia de 1 (mais baixa) a 5 (mais alta) — e você receberá {"data": {"id": "..."}}. Correções utilizam PUT .../gateway-feedback/{feedback_id}, e remoções utilizam DELETE. O feedback aparece ao lado do span, e a lista completa pode ser consultada em Raw Data sob tfyGatewayFeedbacks.
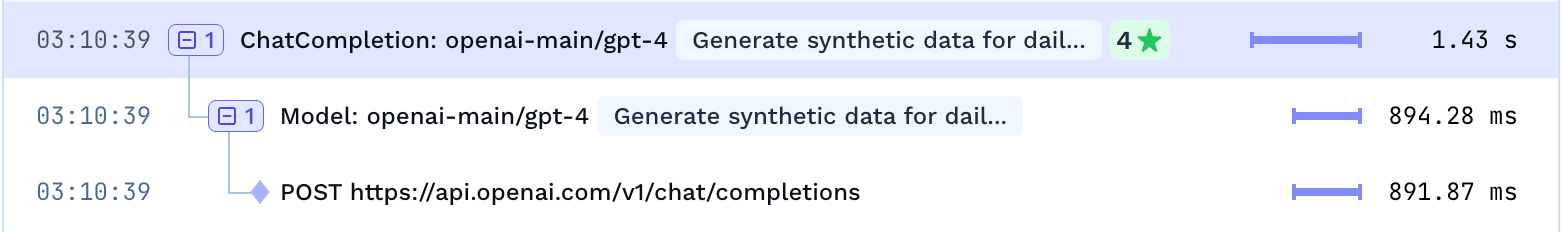
Uma limitação importante: o target ID se refere apenas ao span raiz (root span). O feedback é registrado na requisição como um todo, e não em uma subetapa específica.
Um assistente interno responde a dúvidas de coordenadores de atendimento. O setor de compliance exige duas coisas: nenhuma orientação terapêutica prejudicial e um tom clinicamente apropriado. Como nenhuma dessas regras pode ser expressa via regex, este é o cenário ideal para um juiz.
1. Escolha a rubrica mais objetiva possível. Use dois critérios de juiz do Patronus, em vez de dez — patronus:no-harmful-therapeutic-guidance e patronus:clinically-inappropriate-tone, com target: response. Transfira o restante das exigências de compliance para detectores mais baratos.
2. Comece no modo Audit. Crie uma regra em AI Gateway → Policies → Guardrails direcionada aos modelos do assistente e à equipe de atendimento, definindo a estratégia para Audit: registre o veredito sem bloquear nada.
3. Analise uma semana de traces. A métrica audit_mode_blocked mostra quantas requisições reais essa regra teria bloqueado; o campo evaluation_metadata.highlighted_words indica os motivos. Frequentemente, o critério de tom é acionado em respostas corretas que foram apenas diretas ou sucintas.
4. Compare com a avaliação humana. O controle de feedback (thumbs up/down) do assistente deve estar conectado à API de feedback via x-tfy-feedback-target-id. Se as requisições sinalizadas coincidirem com aquelas que receberam nota 1 ou 2 dos usuários, o juiz está trazendo valor real. Caso contrário, ajuste a rubrica, e não o limite de tolerância.
5. Promova para produção e monitore os custos. Mude para a opção Enforce But Ignore On Error para que uma indisponibilidade do Patronus resulte no bypass da verificação, em vez de derrubar a sua aplicação. Como o Patronus reporta usage_tokens por avaliação e as inferências do juiz passam pelo gateway, o custo de julgamento fica visível nos painéis — e esse número ajudará a definir a sua taxa de amostragem.
Guardrails de saída são ignorados em respostas via streaming. Com "stream": true, os rails de saída não são executados; os rails de entrada sempre rodam. Se seu produto utiliza streaming, o juiz avaliará apenas o prompt de entrada.
Prompts do sistema nunca são visíveis para os guardrails. O gateway os remove antes de enviar o conteúdo para qualquer guardrail, sendo o CrowdStrike AIDR a única exceção de leitura documentada. Um juiz não consegue avaliar se as instruções de sistema foram seguidas.
A validação de saída não evita o custo da chamada do modelo. Se um rail de entrada falhar durante a execução, o gateway pode cancelar a requisição. Já o rail de saída roda somente após a resposta ter sido gerada — momento em que os custos de inferência do modelo já foram consumidos.
LLM como juiz é uma excelente técnica com um escopo de uso específico e restrito. É a única forma prática de classificar textos subjetivos em escala, mas apresenta vieses para respostas longas, para saídas da sua própria família de modelos e para a opção posicionada em primeiro lugar. Uma equipe que entende apenas a primeira parte corre o risco de implementar um guardrail que bloqueia silenciosamente seus próprios usuários.
A separação que torna essa abordagem viável é a mesma apresentada no início deste artigo. A pontuação offline é um problema de conjuntos de dados que pertence a uma plataforma de avaliação, com o TrueFoundry exportando os traces via OTEL. Já o bloqueio online é um desafio do caminho da requisição: exige um critério bem definido, um juiz pequeno e fixado de uma família diferente, início em modo de auditoria, foco em precisão em vez de revocação, e visibilidade total sobre os custos.
Escreva as regras em código sempre que possível. Quando a regra só puder ser expressa como uma frase, utilize um juiz — e meça seu desempenho como o modelo que ele é.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



É usar um modelo de linguagem para avaliar a saída de outro com base em uma rubrica escrita, devolvendo um veredito legível por máquina — aprovado/reprovado, uma nota ou uma preferência entre candidatos. Ele existe porque texto aberto não tem uma métrica de correção computável, e é melhor tratá-lo como um substituto barato e ruidoso de um avaliador humano.
Para critérios restritos, binários e redigidos com precisão, muitas vezes sim; para rubricas amplas de qualidade, geralmente não. Meça primeiro precisão e recall separadamente em exemplos rotulados manualmente — um juiz com 90% de acerto bloqueia cerca de uma em cada dez respostas legítimas no dia em que você passa a aplicá-lo.
Pelo menos uma chamada extra ao modelo por requisição protegida, e duas se você avaliar tanto o prompt quanto a resposta — a documentação do NeMo do TrueFoundry declara essa conta explicitamente. A única alavanca é a cobertura: use amostragem para telemetria e reserve a cobertura total para as verificações que nunca podem falhar.
Sim. O TrueFoundry é executado na sua VPC, on-prem, em ambiente air-gapped ou híbrido, de modo que os prompts e as respostas nunca saem do seu domínio, mesmo quando você roteia entre muitos provedores.
Cerca de 3 a 4 ms, sustentando mais de 350 RPS em uma única vCPU, com mais de 1.000 LLMs. O tempo dos guardrails é medido à parte e reportado em P50, P75, P90 e P99.
Sim. O gateway é compatível com OpenTelemetry e exporta traces para backends externos, e é assim que os dados do gateway chegam a plataformas como Braintrust, Langfuse ou Arize. O TrueFoundry em si não executa jobs de pontuação offline.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















