October 24, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Equipes de engenharia comparam o LiteLLM e o Vercel AI quando as integrações diretas com provedores se tornam difíceis de gerenciar. Ambos simplificam o acesso a múltiplos provedores de LLM e reduzem o trabalho de integração específico para cada modelo. Eles também fornecem uma interface padronizada para que aplicações de IA possam alternar entre modelos sem a necessidade de alterações repetidas no código.
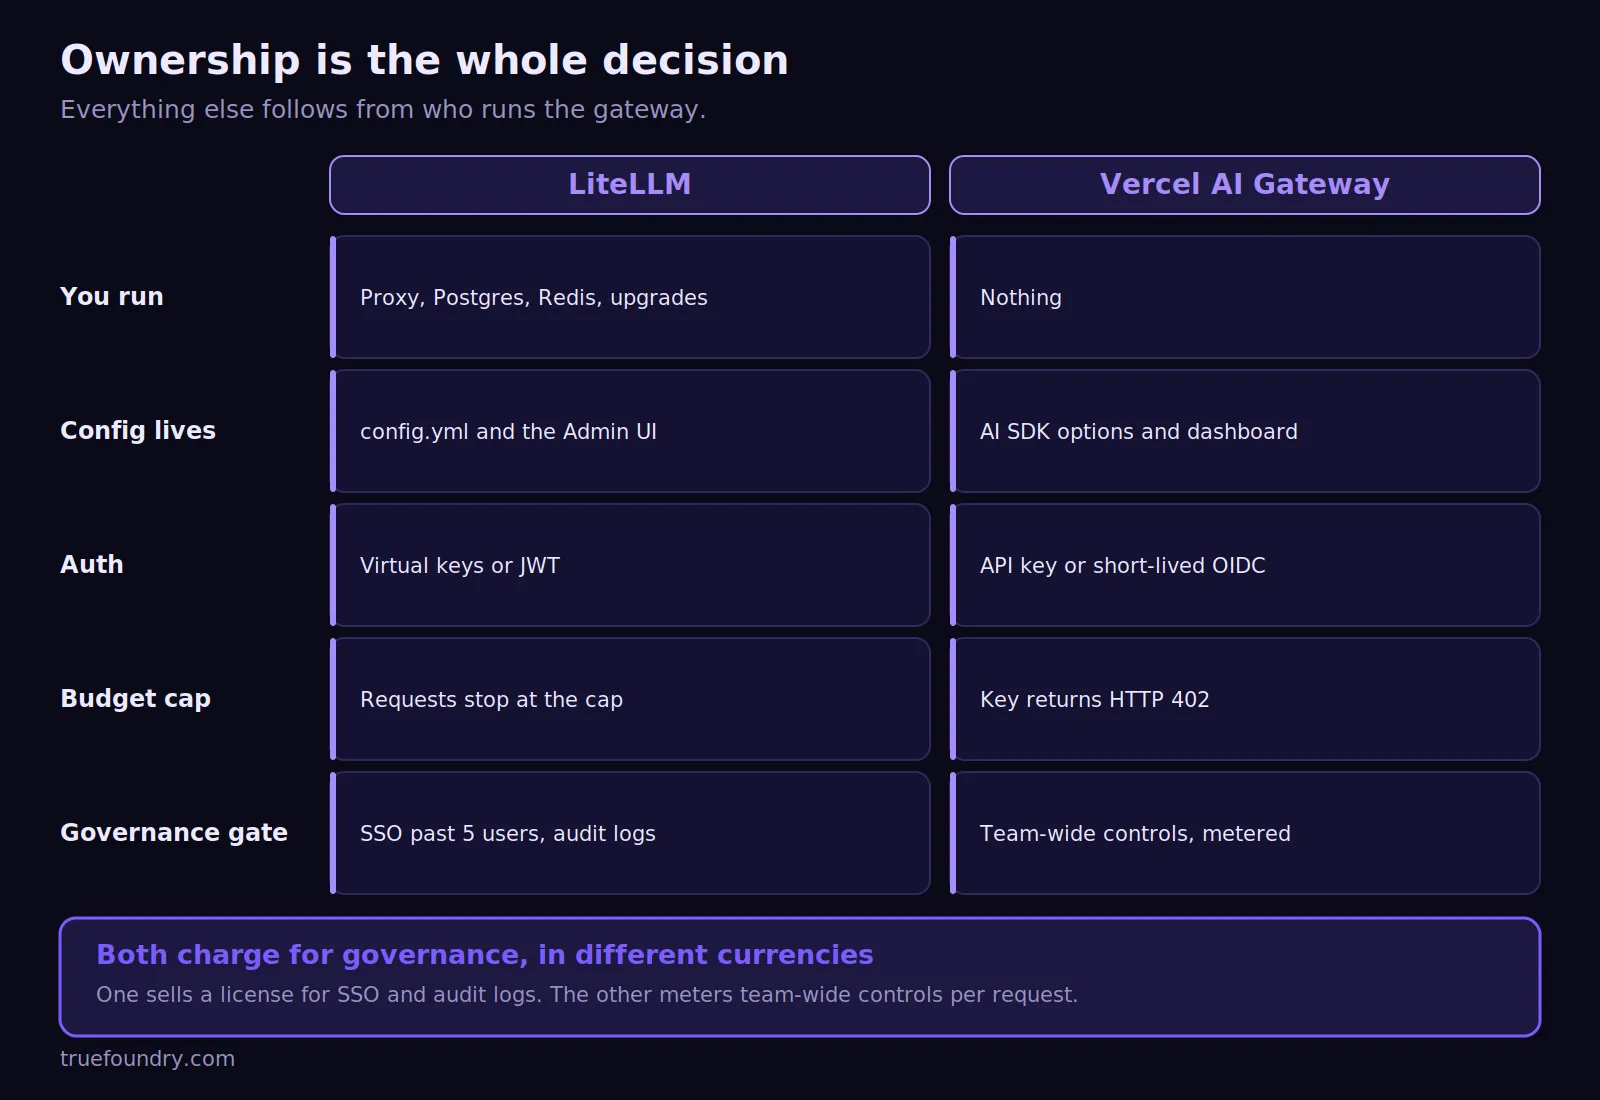
A principal diferença diz respeito à responsabilidade operacional em ambas as plataformas. O LiteLLM é um gateway de IA e servidor proxy de código aberto e auto-hospedado. O Vercel AI Gateway é um serviço gerenciado e hospedado, focado na experiência do desenvolvedor. O LiteLLM roda em sua própria infraestrutura, enquanto a Vercel opera o gateway.
A TrueFoundry torna-se relevante quando as empresas precisam de uma governança mais ampla sobre modelos, ferramentas, agentes e orçamentos.
A maneira mais útil de comparar o LiteLLM e o Vercel AI é pela propriedade. O LiteLLM oferece às equipes um proxy que elas mesmas executam e personalizam. As equipes de plataforma controlam o roteamento, limites de taxa, orçamentos, credenciais de provedores e a implantação. O servidor proxy LiteLLM também suporta um SDK em Python. As chamadas de API podem transportar metadados através de cabeçalhos HTTP.
O Vercel AI Gateway adota a abordagem hospedada. As equipes de produto recebem uma chave de API, suporte a BYOK, tokens OIDC, roteamento e observabilidade. Integrações compatíveis com OpenAI podem ser migradas através da troca da URL base. O SDK do Vercel AI também se conecta sem a necessidade de manutenção do gateway.
A propriedade gera custos operacionais diferentes. O LiteLLM utiliza Postgres para gerenciamento de equipes, chaves virtuais, orçamentos e controle de acesso. A Vercel opera o serviço enquanto as equipes configuram o roteamento e os provedores.
O LiteLLM é adequado para equipes que desejam roteamento auto-hospedado e controle de custos. Seu núcleo MIT suporta mais de 140 provedores por meio de uma interface unificada. As equipes podem conectar modelos internos, Google Vertex, Amazon Bedrock, AWS Bedrock e outros provedores upstream.
O nível gratuito inclui chaves virtuais, orçamentos, limitação de taxa, fallbacks e métricas Prometheus. O LiteLLM suporta balanceamento de carga entre provedores, regiões e chaves. O roteamento de menor custo e o roteamento automático podem escolher provedores de modelo com base no custo ou na complexidade. O guia de balanceamento de carga de LLM da TrueFoundry guia de balanceamento de carga de LLM explica essas rotas de tráfego em cargas de trabalho de produção.
O LiteLLM agora vai além de um proxy básico, com capacidades de LLM, MCP e agentes. O uso rastreia chaves, usuários, equipes, ferramentas, agentes e servidores MCP em casos de uso mais amplos.
O compromisso continua sendo a responsabilidade operacional exigida das equipes de engenharia. As equipes gerenciam a implantação, atualizações, armazenamento, segurança e confiabilidade. A versão Enterprise adiciona SSO, SCIM, logs de auditoria, gerenciamento de segredos, controles multirregionais e suporte. O preço é baseado em cotação e depende da capacidade anual do gateway e dos requisitos de implantação.
Escolha o LiteLLM quando:
O Vercel AI Gateway é mais indicado para pequenas equipes que já desenvolvem na Vercel. Um único endpoint atende a vários modelos com uma única credencial e sem margem sobre os tokens. As equipes podem usar credenciais do sistema ou suas próprias chaves, enquanto integrações existentes com a OpenAI podem ser migradas apenas alterando a URL base.
A vantagem prática vem da configuração mais rápida e da redução do trabalho operacional. Os desenvolvedores podem alternar entre provedores, analisar métricas de uso e definir orçamentos sem precisar gerenciar um gateway. A documentação do AI Gateway da Vercel abrange o AI SDK, OpenAI Chat Completions, Responses e Anthropic Messages por meio de uma interface unificada.
A Vercel oferece failover automático entre provedores que utilizam o mesmo modelo de IA. As equipes podem realizar testes A/B de prompts por meio de roteamento controlado e classificar cada provedor suportado por custo, tempo para o primeiro token ou throughput. O BYOK (traga sua própria chave) permite definir tempos limite do provedor, enquanto a lógica de fallback redireciona o tráfego em caso de falha.
A retenção zero de dados para toda a equipe restringe as solicitações aos provedores cobertos pelos acordos da Vercel. Listas de permissões de provedores limitam o tráfego da equipe. A retenção de dados no nível do provedor ainda precisa ser revisada para cargas de trabalho regulamentadas.
Escolha o Vercel AI Gateway quando:
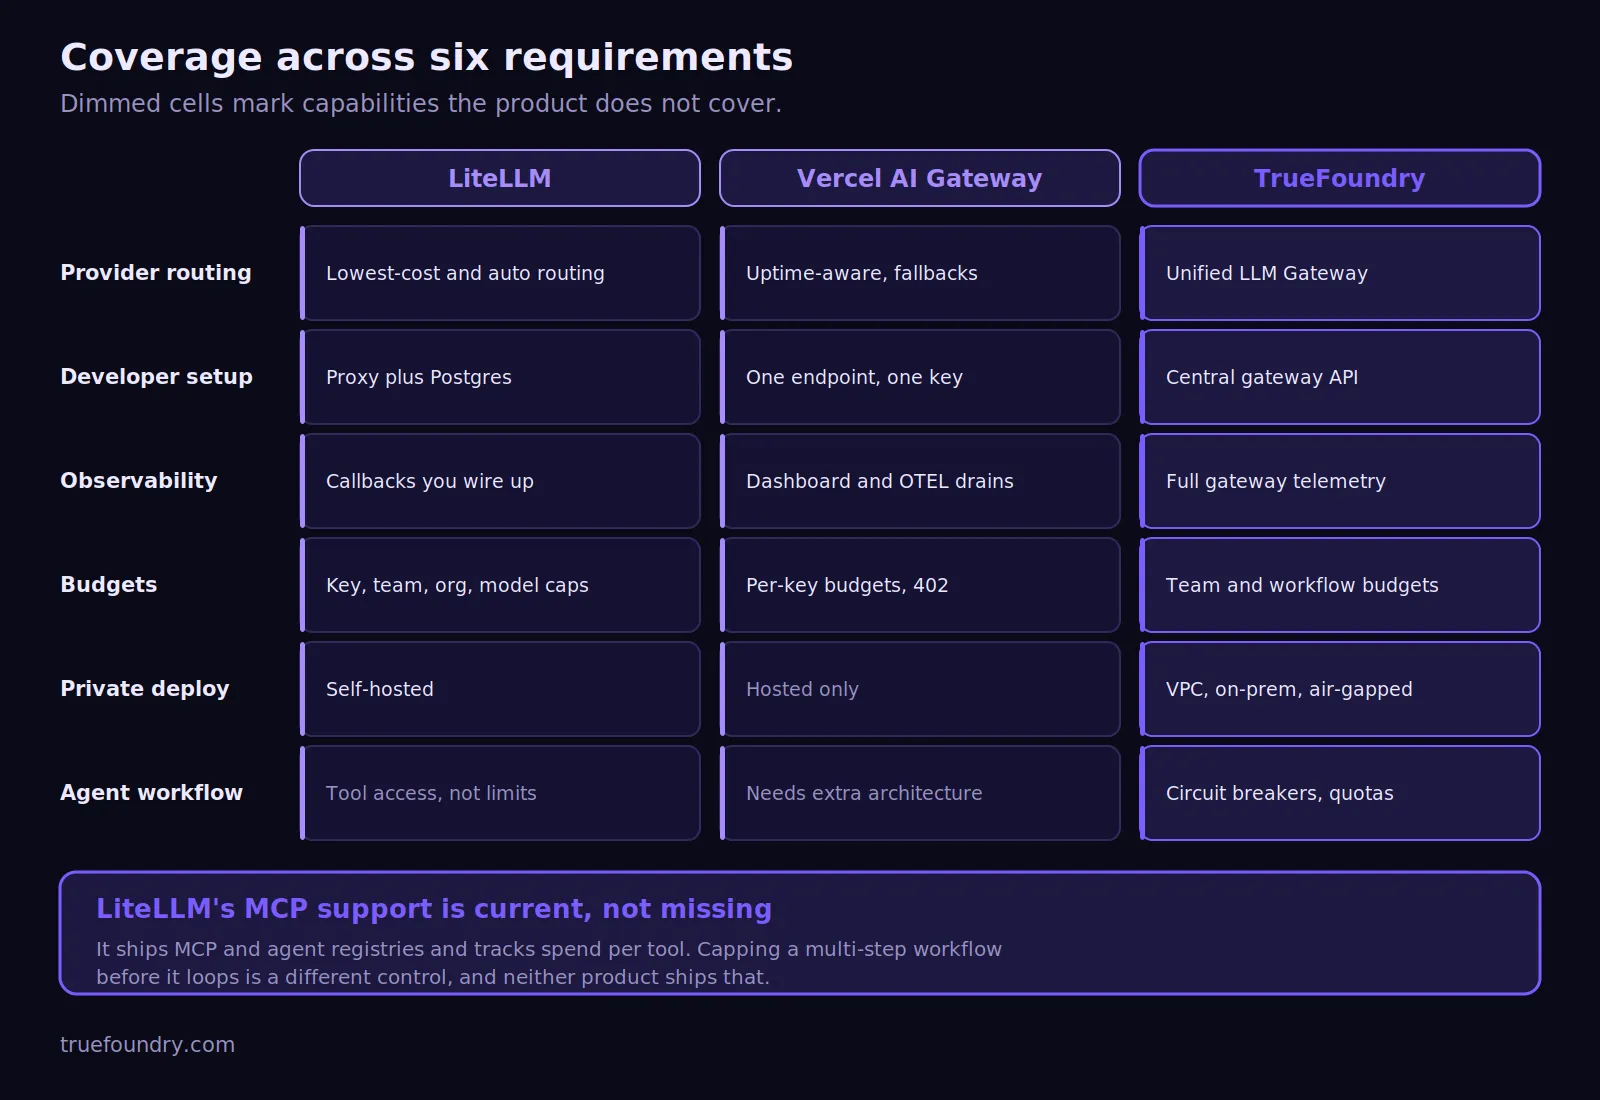
A decisão entre Vercel AI e LiteLLM torna-se mais clara ao analisar roteamento e monitoramento. O LiteLLM controla limites de taxa, fallbacks, roteamento de provedores e logs. O proxy expõe uma única API para todas as implantações.
A Vercel oferece monitoramento integrado por meio do seu dashboard. As equipes podem revisar solicitações, custos, latência, uso de tokens e o comportamento dos provedores. O roteamento pode priorizar custo, throughput ou baixa latência sem a necessidade de operar o plano de dados. A latência de cauda ainda depende dos provedores upstream e dos modelos selecionados.
Para empresas, observabilidade de gateway de IA deve conectar o roteamento a falhas, custos e atividades de política. Um Gateway de LLM dedicado pode centralizar o acesso aos provedores em todo o tráfego de produção.
O LiteLLM agora cobre MCP e agentes de forma mais profunda do que comparações antigas sugerem. Os compradores ainda devem separar o acesso a ferramentas dos limites de fluxo de trabalho. Governar uma chamada de ferramenta é diferente de controlar uma sequência completa de chamadas de agente.
O preço deve refletir o custo total de propriedade exigido por cada modelo operacional. O gateway de código aberto do LiteLLM não possui taxa de licença, enquanto o preço da versão Enterprise é personalizado. A versão Enterprise é dimensionada pela capacidade anual de solicitações, arquitetura de implantação e necessidades de suporte. As equipes ainda financiam a infraestrutura de suporte e as operações contínuas por conta própria.
A versão Enterprise adiciona SSO, SCIM, logs de auditoria, gerenciamento de segredos, recursos multirregião e suporte. Isso substitui a antiga premissa de preço público do rascunho. A TrueFoundry Análise de preços corporativos do LiteLLM fornece informações detalhadas sobre os fatores de custo operacional.
A Vercel utiliza créditos pré-pagos e cobra o preço de lista do provedor sem margem sobre os tokens. Seu plano gratuito inclui US$ 5 a cada 30 dias até que o pagamento seja iniciado. Compras com cartão podem incorrer em taxas de processamento de pagamento, enquanto o faturamento está disponível sem essas taxas.
Alguns controles de governança também possuem medidores de uso separados para as equipes. O ZDR para toda a equipe custa US$ 0,10 por 1.000 solicitações. O Relatório Personalizado cobra US$ 0,075 por 1.000 valores gravados e US$ 5 por 1.000 consultas. Esses custos adicionais são relevantes à medida que o tráfego de produção aumenta entre as equipes.
As empresas devem comparar software, infraestrutura, operações e controle de custos em conjunto assim que a implantação privada e uma governança mais ampla se tornarem requisitos.
A comparação entre LiteLLM e Vercel AI não é mais uma simples escolha entre proxy e serviço hospedado. O LiteLLM abrange modelos, MCP, agentes e governança. A Vercel possui orçamentos e controles de provedores mais robustos. As lacunas restantes dizem respeito a fluxos de trabalho completos de agentes.
A IA em produção pode começar como uma chamada de LLM, continuar através de ferramentas do Protocolo de Contexto de Modelo (MCP) e acionar mais ações. As empresas podem precisar de identidade, orçamentos e evidências de auditoria em toda essa cadeia. A TrueFoundry MCP Gateway governa o acesso às ferramentas, enquanto o Gateway de Agentes governa a execução dos agentes.
Áreas comuns a serem avaliadas incluem:
A decisão entre Vercel AI ou LiteLLM deve refletir os requisitos atuais de governança. Equipes que comparam outra opção gerenciada, como o Kong AI Gateway, devem aplicar o mesmo teste de propriedade
A TrueFoundry é a escolha ideal quando as empresas buscam uma camada única de governança para modelos, ferramentas e agentes. Sua Gateway de IA centraliza roteamento, orçamentos, proteções (guardrails), observabilidade e acesso a provedores em implementações SaaS e privadas.
O LiteLLM oferece às equipes um gateway que elas mesmas operam, enquanto a Vercel fornece um gateway de modelos hospedado. A TrueFoundry reúne governança de modelos, MCP e agentes com opções de implementação privada.
A aplicação é declarativa e reside no controle de versão. As regras são avaliadas em ordem, e a primeira correspondência vence:
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  # Cap one contractor account on a specific model
  - id: "contractor-gpt4-daily"
    when:
      subjects: ["user:contractor@example.com"]
      models: ["openai-main/gpt4"]
    limit_to: 1000
    unit: requests_per_day

  # Give every user an independent daily token budget
  - id: "user-daily-limit"
    when: {}
    limit_to: 1000000
    unit: tokens_per_day
    rate_limit_applies_per: ['user']
O campo `rate_limit_applies_per` cria um contador separado por entidade, de modo que uma única regra cubra todos os usuários sem gerar uma regra por identidade. Uma solicitação que exceda seu limite retorna HTTP 429, nomeando a regra que foi acionada, juntamente com um cabeçalho `x-tfy-applied-rules`:
{
  "status": "failure",
  "message": "Rate limit exceeded for model: openai-main/gpt4 with rule: contractor-gpt4-daily",
  "error": {
    "type": "RateLimitError",
    "code": "429"
  },
  "error_origin_level": "rate_limit_budget"
}
A TrueFoundry é mais relevante quando:
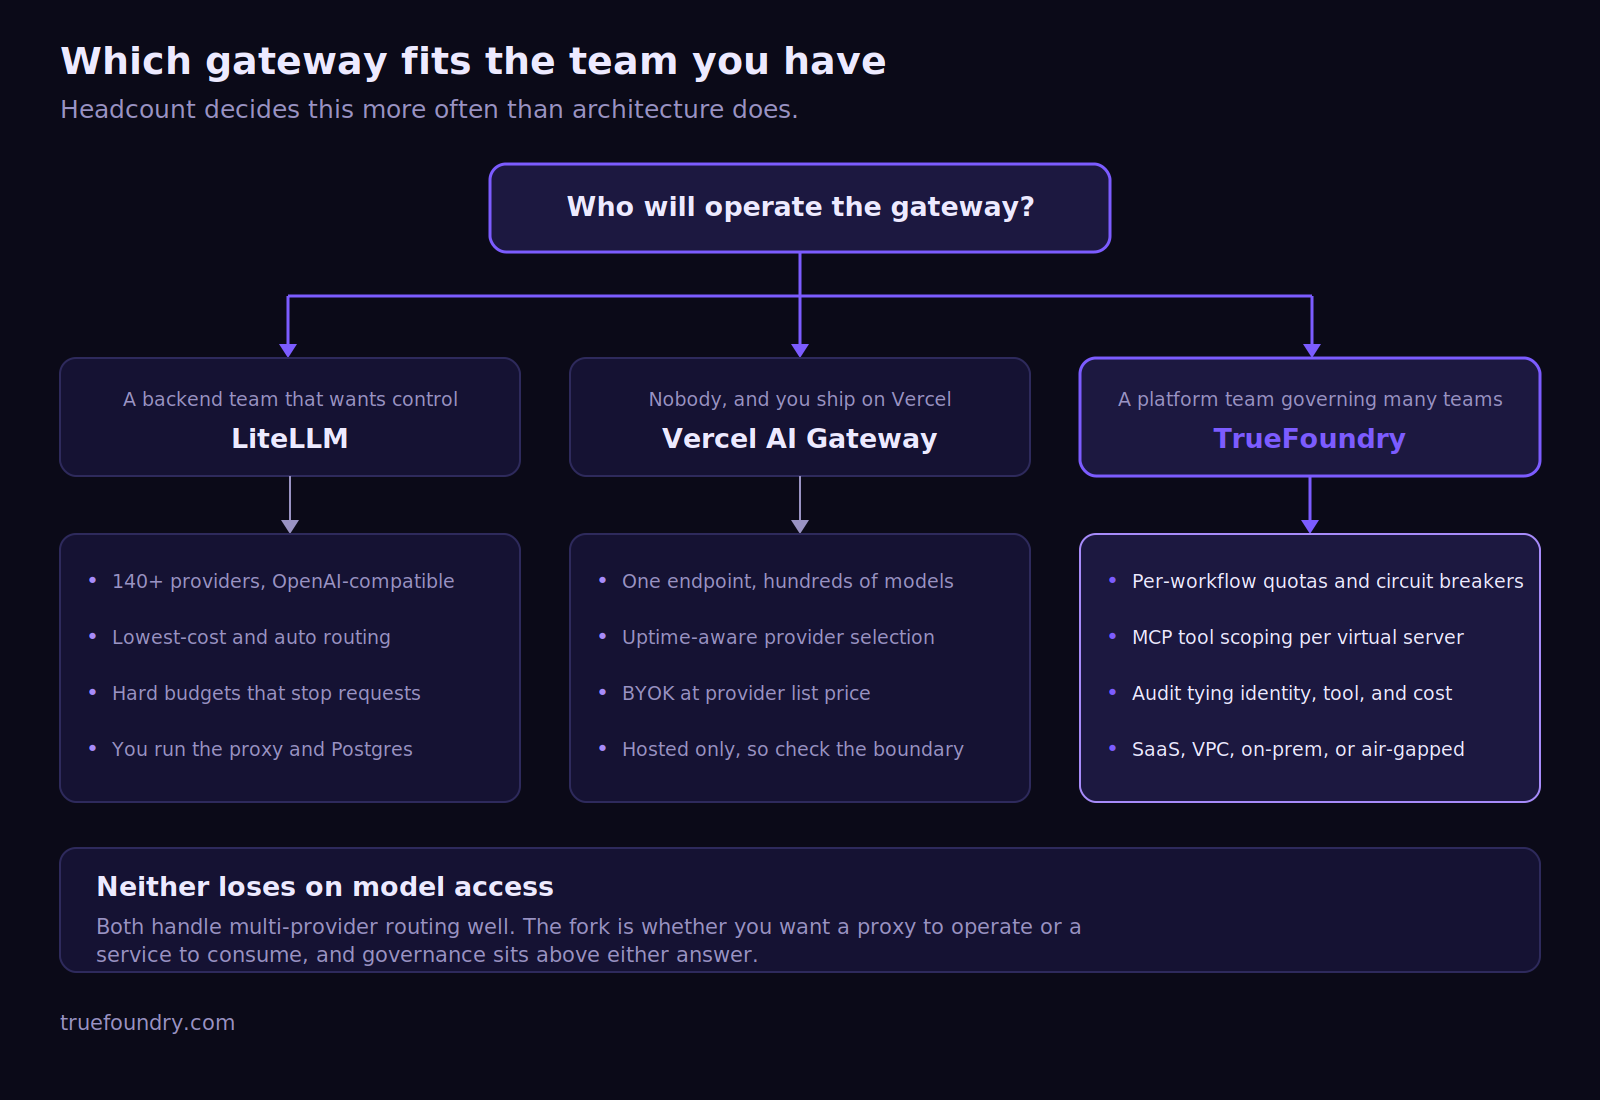
Escolha o LiteLLM quando sua equipe deseja controle auto-hospedado, flexibilidade de código aberto, chaves virtuais, orçamentos e operações personalizadas. Sua plataforma agora abrange modelos, MCP e agentes, sendo mais forte quando as equipes de plataforma podem assumir a responsabilidade pelas operações.
Escolha o Vercel AI Gateway quando sua equipe utiliza a Vercel e deseja acesso rápido a modelos, BYOK (traga sua própria chave) e confiabilidade de um serviço hospedado. É a melhor opção quando a velocidade de entrega é mais importante do que a propriedade privada do gateway.
Escolha a TrueFoundry quando a execução governada precisar abranger modelos, ferramentas MCP, agentes e orçamentos. Também é adequada para ambientes de produção privados ou gerenciados que exigem evidências para auditoria.
A decisão entre LiteLLM ou Vercel AI depende, primeiramente, da questão de propriedade. O LiteLLM oferece controle de infraestrutura, enquanto a Vercel fornece um serviço hospedado. A TrueFoundry se encaixa quando o foco principal passa a ser uma governança de IA mais ampla.
Agende uma demonstração com a TrueFoundry para avaliar seus requisitos de gateway, MCP, agentes, implementação e governança.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada