



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
O GPT-6 Astra chegou em 3 de setembro de 2026. A string da API é gpt-6-astra — sem snapshot datado, sem alias separado; a página do modelo lista gpt-6-astra como o snapshot e o alias.
As especificações, conforme a documentação do modelo da OpenAI:
Três pontos nas letras miúdas importam mais do que a manchete.
Primeiro,reasoning.effort não aceita mais none. O GPT-5.6 Sol aceitava. Se você tem um caminho rápido e barato definido como none, ele não será portado.
Segundo,temperature, top_p e logprobs foram removidos. O changelog afirma que o Astra “não oferece suporte a valores personalizados de temperature ou top_p, nem a probabilidades de log”. Qualquer item em sua stack que defina parâmetros de amostragem precisa ser auditado antes da migração.
Terceiro, a chamada de ferramentas requer a API de Respostas. Se você chama ferramentas por meio de Chat Completions hoje, isso é uma migração, não uma troca de modelo.
[CAPTURA DE TELA: Plataforma OpenAI — a página do modelo gpt-6-astra mostrando a janela de contexto, saída máxima e preços por token]
A janela de contexto e o limite de saída não mudaram. O preço, sim.
Fontes: Documentação do modelo GPT-6 Astra, documentação do modelo GPT-5.6 Sol, setembro de 2026. Observe que a OpenAI descreve as taxas do GPT-5.6 Sol como preços promocionais disponíveis pelo menos até 21 de novembro de 2026, portanto, a proporção pode não se manter após essa data.
Todas as taxas mudaram pelo mesmo fator. Isso acaba sendo importante para a questão do cache abaixo.
Batch e Flex permanecem em 50% do Standard. O modo Fast, que a OpenAI afirma oferecer até 2x a velocidade do processamento Standard, é precificado em 2x as taxas aplicáveis — portanto, o Astra no modo Fast custa US$ 20 de entrada e US$ 100 de saída.
A OpenAI publicou uma grande tabela comparativa no post de lançamento. Aqui está a parte que vale a pena reproduzir, e depois a parte que a maioria das coberturas ignora.
Fonte: post de lançamento do GPT-6 Astra, setembro de 2026. As pontuações representam o máximo em qualquer esforço de raciocínio.
Onde o Astra lidera claramente. Trabalho de agentes de longo prazo. O Terminal-Bench 4.0 está mais de vinte pontos acima do Sol. O Terminal-Bench Science quase triplica. O AutomationBench mais do que dobra. A recuperação de contexto longo em 512K-1M vai de 73,8% para 96,3%. Estas são as cargas de trabalho para as quais o modelo foi construído e a diferença não é sutil.
Onde a diferença se torna irrelevante. Conhecimento e raciocínio de tentativa única. O GPQA Diamond vai de 94,6% para 96,0%. O DeepSWE vai de 72,7% para 74,1%. Se o seu tráfego consiste em perguntas com respostas em vez de tarefas com etapas, você está pagando 2,5 vezes mais por aproximadamente um ponto de diferença.
Onde o Astra não vence. Nos dois índices compostos de terceiros que a OpenAI escolheu incluir, o Astra não é o primeiro. O Artificial Analysis Intelligence Index coloca o Claude Fable 5.1 com 65,7 contra 61,2 do Astra. O Coding Agent Index coloca o Claude Opus 5 com 68,1 contra 67,0 do Astra. A OpenAI publicou ambos os números, o que é um ponto positivo, e eles servem como um contrapeso honesto à superioridade em agentes mencionada acima.
Algo que complica a questão do preço. As estimativas de custo por tarefa da OpenAI às vezes são menores do que as do Sol, apesar das taxas serem 2,5 vezes maiores, porque o Astra finaliza a tarefa com menos tokens. O post de lançamento afirma que o custo estimado da API por tarefa no Terminal-Bench 4.0 é cerca de 9% menor em comparação ao Sol, cerca de 27% menor no Terminal-Bench Science em uma configuração de custo mais baixo, e cerca de 43% menor no BenchCAD. Estas são as estimativas da própria OpenAI em configurações específicas, não reproduções independentes, e não se aplicarão necessariamente ao seu tráfego. Mas elas significam que "2,5 vezes mais caro" é o resumo errado para o trabalho de agentes. Meça tokens por tarefa concluída, não preço por token.
A TrueFoundry fez os cálculos de ponto de equilíbrio do cache no GPT-5.6 quando as gravações em cache se tornaram cobráveis pela primeira vez. A mesma pergunta se aplica aqui, e a resposta é mais interessante do que parece.
Os multiplicadores de cache do Astra são idênticos aos do GPT-5.6. A documentação do modelo afirma que as gravações em cache são cobradas a 1,25x a taxa de entrada sem cache, e a taxa publicada de entrada em cache de US$ 1,00 contra uma taxa de entrada de US$ 10,00 é exatamente 0,10x. Portanto:
Seja w a parcela de solicitações em um prefixo compartilhado que são gravações em cache em vez de leituras. O cache atinge o ponto de equilíbrio quando:
1.25w + 0.10(1 - w) = 1
1.15w = 0.90
w = 78,3%
O ponto de equilíbrio é 78,3%, inalterado em relação ao GPT-5.6. O P é cancelado, e é por isso que o aumento de preço de 2,5x não altera nada. O cache só deixa de valer a pena quando mais de aproximadamente 78% das suas solicitações para um determinado prefixo são gravações — ou seja, quando seu contexto compartilhado sobrevive a menos de 1,3 solicitações em média antes de ser alterado ou expirar. Quase nenhuma carga de trabalho de agente real chega a esse ponto.
O que o aumento de preço muda é o tamanho da recompensa. Considere um prefixo compartilhado de 32 mil tokens reutilizado em uma sessão de 25 solicitações — uma gravação, vinte e quatro leituras:
A porcentagem é idêntica. Os valores em dólares são 2,5 vezes maiores. Sempre valeu a pena usar cache; no Astra, não usar custa duas vezes e meia mais caro.
O modo de falha também permanece inalterado: contexto que muda rapidamente. Se o seu agente reconstrói seu prompt de sistema ou esquema de ferramentas a cada poucas rodadas, você paga US$ 12,50 por milhão para gravar um cache que mal lê. Isso agora é um erro de US$ 12,50 em vez de um de US$ 5,00.
A janela de contexto anunciada do GPT-6 é de 1.050.000 tokens. A cobrança não escala de forma linear ao longo dela.
Da documentação do modelo: “Prompts com mais de 272 mil tokens de entrada são precificados com 2x as taxas de entrada e cache, e 1,5x a de saída para toda a solicitação.”
Leia isso com atenção. É para toda a solicitação, não para o excedente acima de 272 mil. Ultrapassar esse limite não faz você pagar o dobro apenas nos tokens extras; você paga o dobro em todos eles.
Um aumento de 0,7% no tamanho do prompt gera um aumento de 101% na fatura de entrada. As leituras em cache também dobram, de US$ 1,00 para US$ 2,00 por milhão, e a saída vai de US$ 50,00 para US$ 75,00. O GPT-5.6 Sol tem a mesma regra, então isso não é novidade — mas, com as taxas do Astra, o salto é 2,5 vezes maior.
A consequência prática: se seus prompts estiverem próximos de 272 mil, a otimização de custo de maior impacto disponível para você é mantê-los abaixo desse valor. Cortar 5 mil tokens de um prompt de 275 mil vale mais do que qualquer mudança de roteamento que você possa fazer.
[CAPTURA DE TELA: Plataforma OpenAI — painel de uso mostrando gastos com tokens de entrada, entrada em cache e saída por modelo]
Quatro modos de falha surgem repetidamente nas primeiras semanas após o lançamento de um modelo de fronteira, e o Astra apresenta todos os quatro.
Tudo é direcionado para o novo modelo. A coisa mais cara que uma equipe faz após um lançamento é definir o padrão para ele. Com entrada a US$ 10 e saída a US$ 50, uma chamada de classificação que um modelo barato resolve corretamente agora custa 2,5 vezes mais do que no mês passado, sem nenhum ganho de qualidade. A variação de benchmark acima é um argumento a favor de uma frota mista, não de uma migração.
A migração não é uma simples troca de strings. Sem esforço de raciocínio, sem temperature, sem top_p, sem logprobs e com chamadas de ferramentas que exigem a Responses API. Códigos que funcionavam com o gpt-5.6-sol podem falhar com o gpt-6-astra de maneiras que não são óbvias até chegarem à produção.
O monitoramento de desalinhamento pode interromper sua solicitação. A OpenAI executa verificações assíncronas no trabalho de agentes em solicitações compatíveis da Responses API. O post de lançamento é explícito sobre a consequência: no ChatGPT ou no Codex, você pode ser solicitado a revisar uma ação, mas "na API, a tarefa será interrompida". A OpenAI reconhece que essas verificações "podem, às vezes, interromper um trabalho legítimo". Essa é uma nova característica de confiabilidade para se projetar em torno, não uma nota de rodapé.
Ninguém sabe quanto realmente custa até que a fatura chegue. O preço por token diz muito pouco quando o modelo usa um número diferente de tokens por tarefa. Sem uma atribuição de custos por solicitação e por equipe, a pergunta "o Astra é mais barato ou mais caro para nós" é impossível de responder.
Um modelo de fronteira mais caro não enfraquece o argumento a favor de um gateway. Ele o fortalece, porque cada decisão de roteamento agora vale 2,5 vezes mais.
Roteie pela complexidade, não pelo hábito.OGateway de IA classifica as solicitações recebidas e envia cada uma para o nível apropriado, para que o trabalho de agente complexo chegue ao Astra, enquanto extração, classificação e sumarização não. No benchmark de Roteamento Automático da própria TrueFoundry, em 550 prompts, a estratificação reduziu o custo em 69% mantendo 98% da qualidade de referência, com a latência média caindo de 7,6s para 4,0s. Em tráfego com perfil de produção, a redução chegou a 80%. Essas porcentagens aplicadas às taxas de US$ 10/US$ 50 valem consideravelmente mais do que valiam a US$ 4/US$ 20.
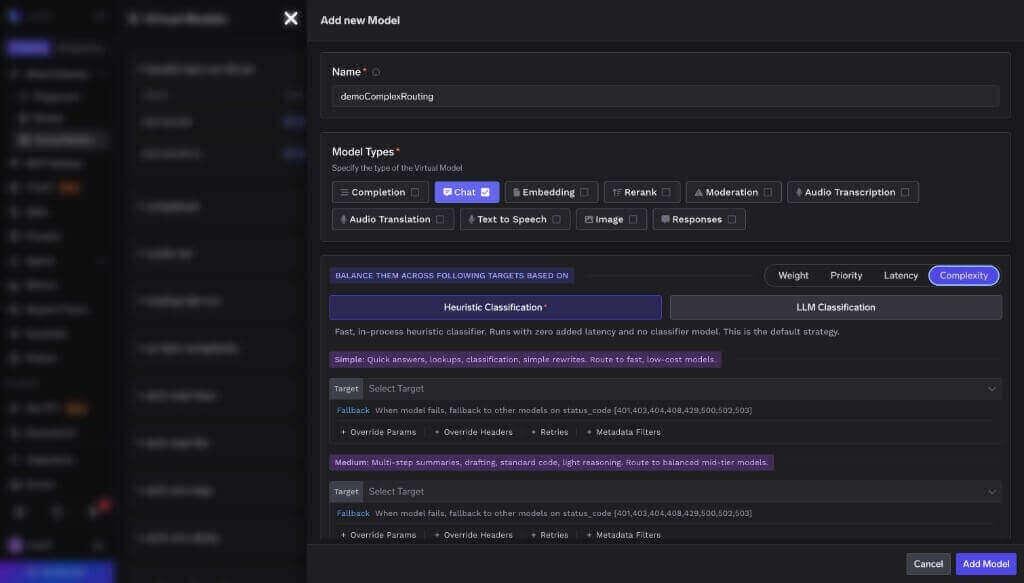
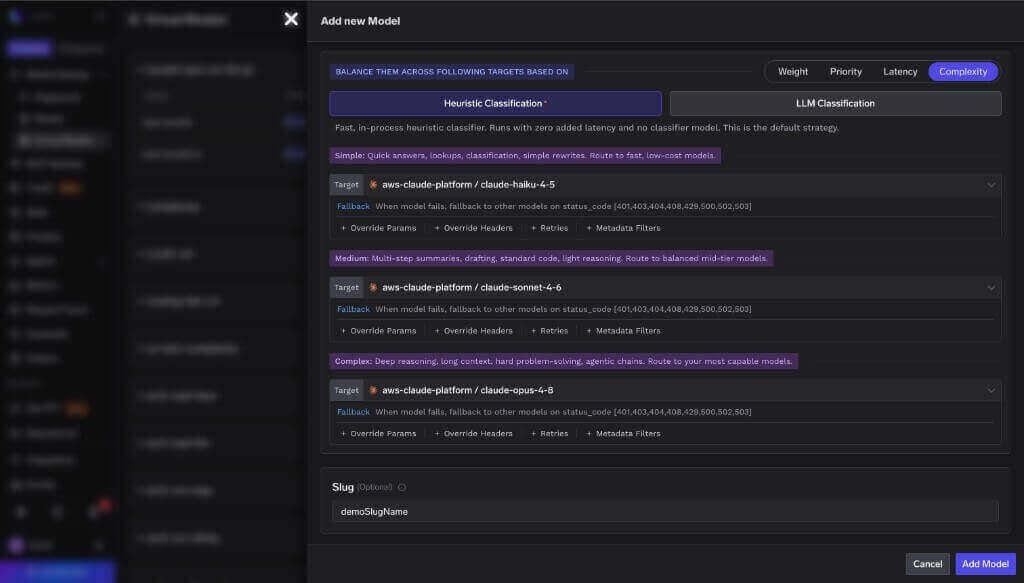
Padronize o cache entre provedores. A semântica de cache do Astra é a da OpenAI. A da Anthropic é diferente, e a do Bedrock é diferente novamente. Cache de prompt agnóstico ao provedor no gateway significa que você escreve o prefixo uma vez e a regra de 78,3% acima permanece verdadeira, independentemente de qual modelo o roteador escolher.
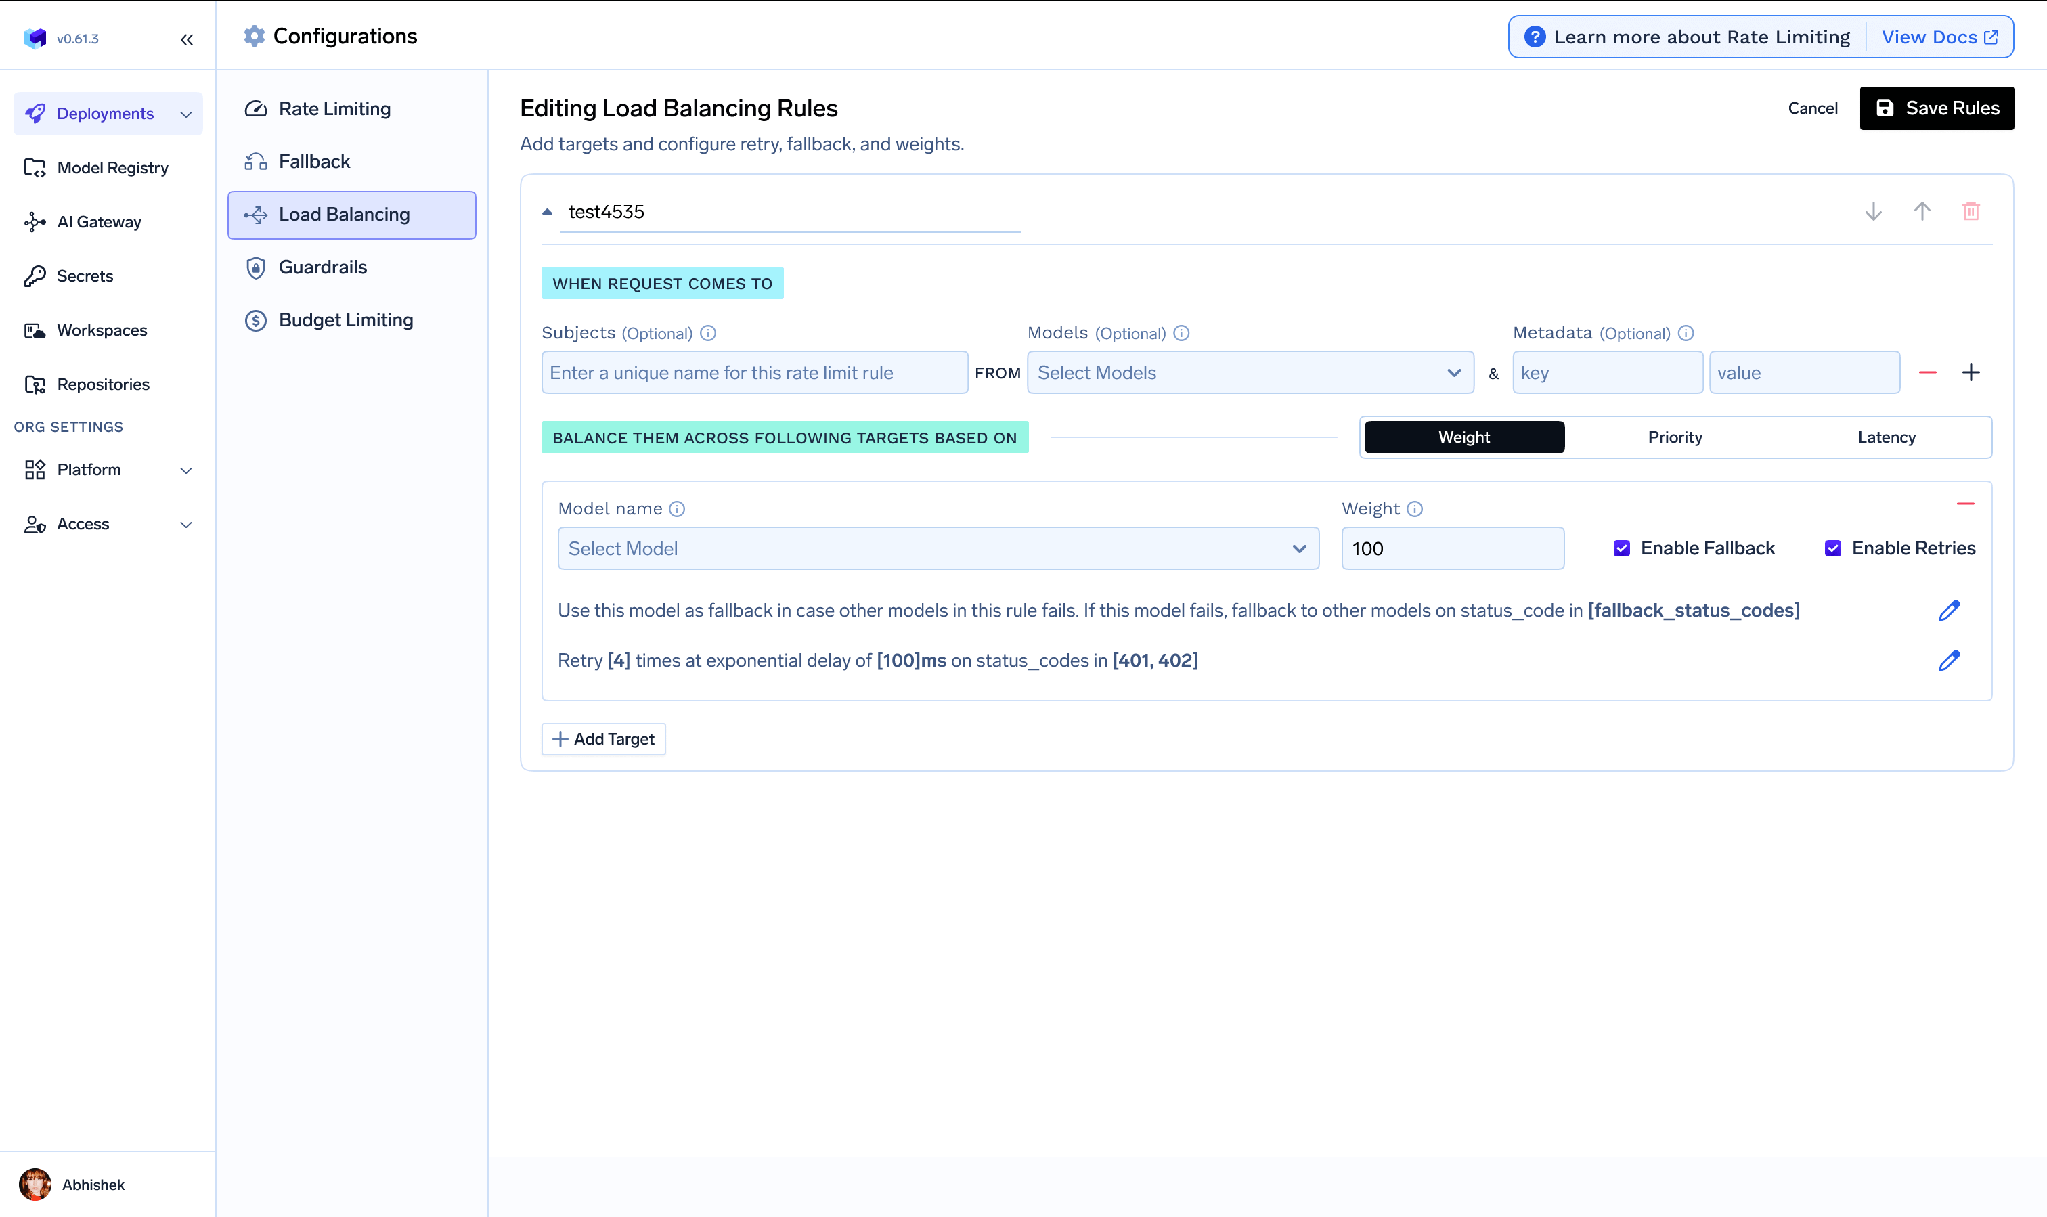
Meça o custo por tarefa, não o custo por token. Toda a discussão sobre o preço do Astra gira em torno da eficiência de tokens, e você não consegue resolvê-la apenas com uma tabela de preços. O custo por solicitação, a contagem de tokens e a latência detalhados por equipe e modelo são a forma de descobrir se a promessa do Astra de menos tokens por tarefa se sustenta na sua carga de trabalho.

Mantenha um caminho de guardrail único entre os modelos. Os guardrails no nível do gateway são executados no caminho de solicitação e resposta, independentemente de qual modelo responda, para que uma alteração no roteamento não modifique silenciosamente sua postura de segurança.

A versão resumida, em setembro de 2026:

O GPT-6 Astra é um verdadeiro avanço no trabalho para o qual foi criado. O Terminal-Bench 4.0 subiu vinte pontos, a recuperação de contexto longo subiu vinte e dois, o AutomationBench mais que dobrou — esses não são resultados incrementais. Nos índices compostos de terceiros publicados pela própria OpenAI, ele não é o líder, e em perguntas de conhecimento de tentativa única, a diferença em relação ao GPT-5.6 Sol é quase um erro de arredondamento.
O preço conta a mesma história dividida. Todas as taxas subiram 2,5 vezes, o que parece um aumento direto até você notar que as estimativas de custo por tarefa da própria OpenAI são menores do que as do Sol em vários benchmarks de agentes, porque o Astra termina com menos tokens. Ambas as coisas podem ser verdadeiras. Qual delas se aplica a você é uma questão empírica sobre o seu tráfego, e a única maneira de responder é executar ambos e medir o custo por tarefa concluída.
Duas coisas não exigem medição. O cache ainda compensa exatamente no mesmo ponto de equilíbrio de 78,3% que no GPT-5.6, então, se você usa cache hoje, continue usando. E o limite de cobrança de 272 mil tokens é uma função degrau que dobrará silenciosamente uma fatura de entrada para um prompt que cresceu apenas alguns milhares de tokens.
Portanto, tudo se resume ao que você deseja controlar. Se você quer um único modelo e uma fatura simples, direcione tudo para o Astra e aceite que está pagando a mais pela metade mais fácil do seu tráfego. Se você prefere enviar o trabalho pesado para a fronteira e todo o resto para algo mais barato, você precisará de uma camada de roteamento — e, a US$ 10 de entrada e US$ 50 de saída, a matemática para construir uma ficou duas vezes e meia mais convincente.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



O GPT-6 Astra é o modelo de fronteira da OpenAI, lançado em 3 de setembro de 2026 e disponível na API como gpt-6-astra. Ele está disponível pela API da OpenAI, pelo Microsoft Azure e pelo AWS Bedrock, e para usuários do ChatGPT Plus, Pro, Business e Enterprise.
Em setembro de 2026, por 1 milhão de tokens: US$ 10,00 de entrada, US$ 1,00 de entrada em cache, US$ 12,50 de gravações em cache e US$ 50,00 de saída. Batch e Flex custam 50% dessas tarifas; o modo Fast custa 2x. Requisições com mais de 272K tokens de entrada são cobradas a 2x as tarifas de entrada e de cache e a 1,5x a de saída para toda a requisição.
1.050.000 tokens, com saída máxima de 128.000 tokens. Ambos são idênticos aos do GPT-5.6 Sol. O limite prático é comercial, e não técnico: acima de 272K tokens de entrada, toda a requisição é cobrada pelo dobro da tarifa de entrada.
Depende inteiramente do tipo de tarefa. Em trabalho agêntico de longo horizonte, os ganhos são grandes — o Terminal-Bench 4.0 vai de 37,3% para 57,9%. Em perguntas de conhecimento de resposta única, eles são marginais, e você paga 2,5x por token por eles. Faça o roteamento de acordo, em vez de migrar tudo de uma vez.
Sim, e na mesma proporção. As gravações em cache custam 1,25x o preço de entrada e as leituras 0,10x, exatamente como no GPT-5.6, então o ponto de equilíbrio fica em uma participação de gravações de 78,3% nos dois casos. Preços de tabela mais altos aumentam a economia absoluta, não o limite.
O AI Gateway do TrueFoundry adiciona cerca de 3 a 4 ms e sustenta mais de 350 RPS em 1 vCPU, o que é irrelevante diante de tempos de geração de vários segundos.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















