October 7, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
Um HTTP 200 indica apenas que o provedor respondeu. Ele não diz nada sobre se a resposta foi fundamentada, se o agente escolheu a ferramenta certa ou se uma alteração no prompt reduziu silenciosamente a qualidade. A falha silenciosa de qualidade é um dos problemas operacionais mais difíceis na produção de sistemas de Grandes Modelos de Linguagem (LLM).
A avaliação também não é um problema único. Um pipeline de Geração Aumentada por Recuperação (RAG) pode falhar na recuperação. Um chatbot de suporte pode falhar em várias interações com o usuário. Um agente pode falhar após três etapas, escolher a ferramenta errada e raciocinar com confiança sobre esse erro. A maioria das ferramentas de avaliação de IA cobre bem um ou dois desses modos de falha.
Este comparativo analisa as sete melhores ferramentas de avaliação de IA para equipes de engenharia em 2026. Ele explica o que cada ferramenta mede, onde termina o escopo de cada uma e por que as equipes corporativas ainda precisam de uma camada de governança de caminho de solicitação por baixo da avaliação.
Uma boa avaliação de IA não se limita a pontuar prompts individuais. As equipes de produção precisam de testes que cubram mudanças antes do lançamento, tráfego em tempo real, comportamento do agente, riscos de segurança e colaboração entre equipes técnicas e de negócios.
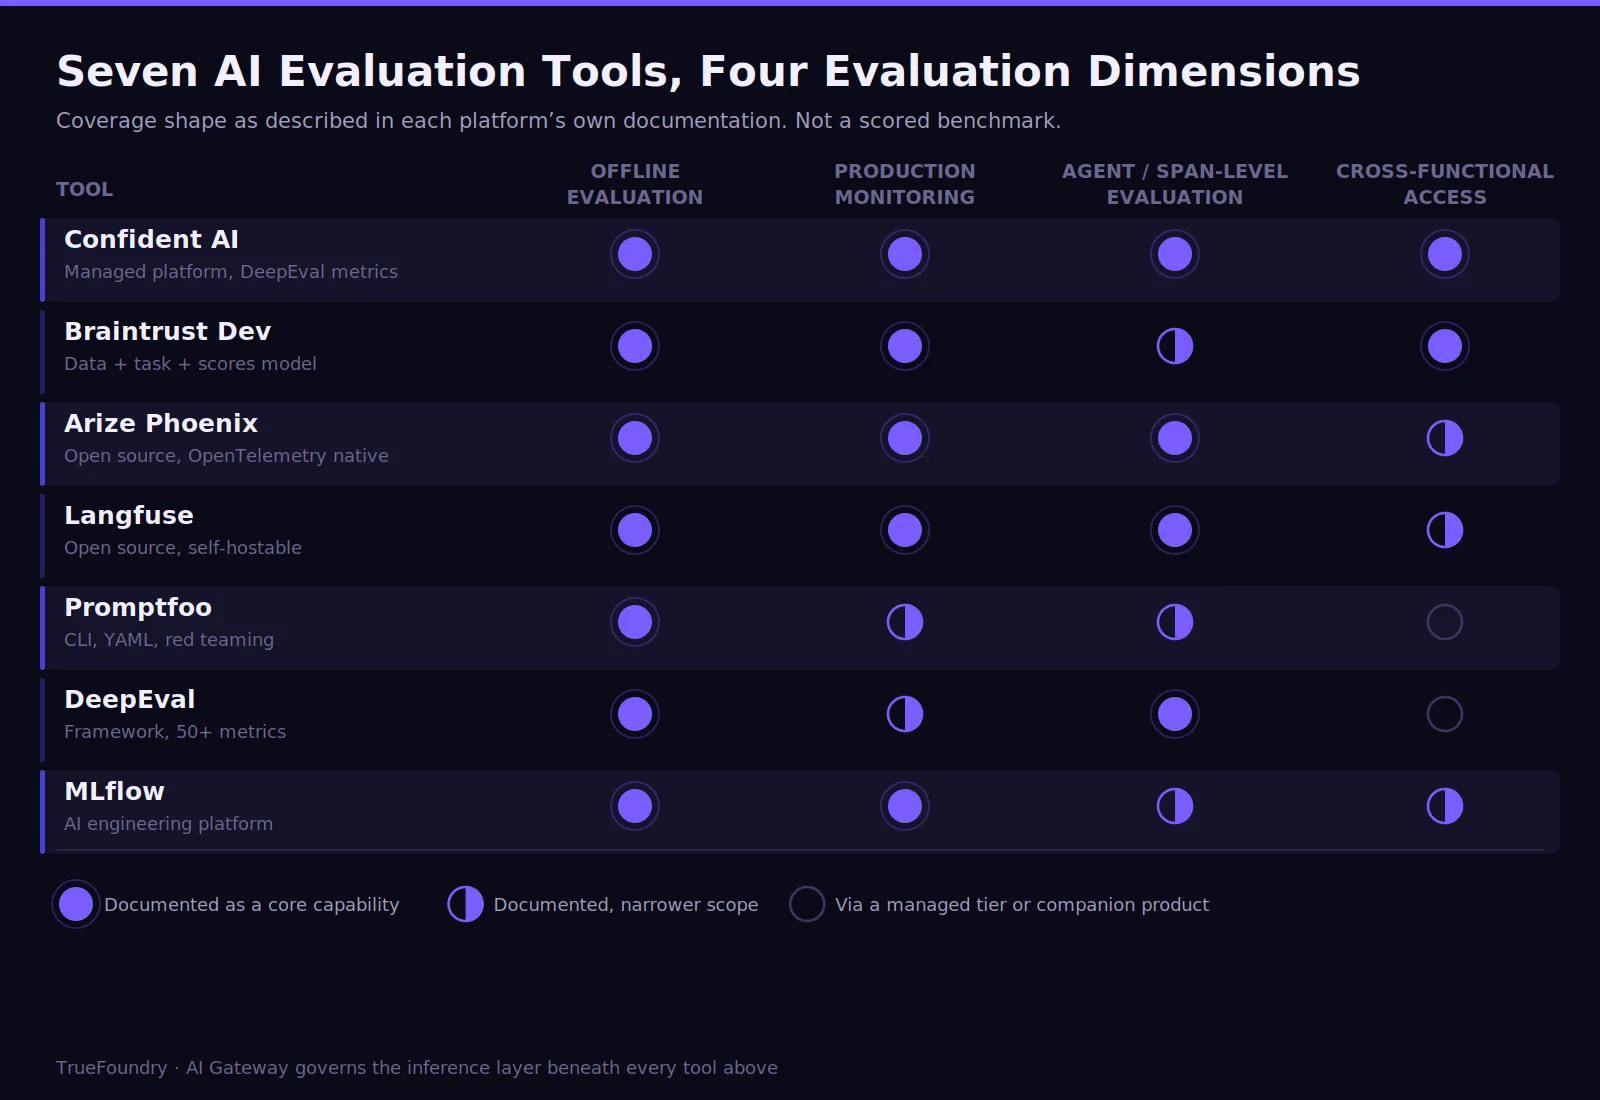
Avaliamos essas ferramentas com base na profundidade da avaliação, cobertura de agentes, monitoramento de produção, flexibilidade de implantação, colaboração e opções de integração. A lista começa com plataformas de avaliação mais abrangentes e, em seguida, aborda estruturas de código aberto e ferramentas adequadas para fluxos de trabalho de engenharia específicos.
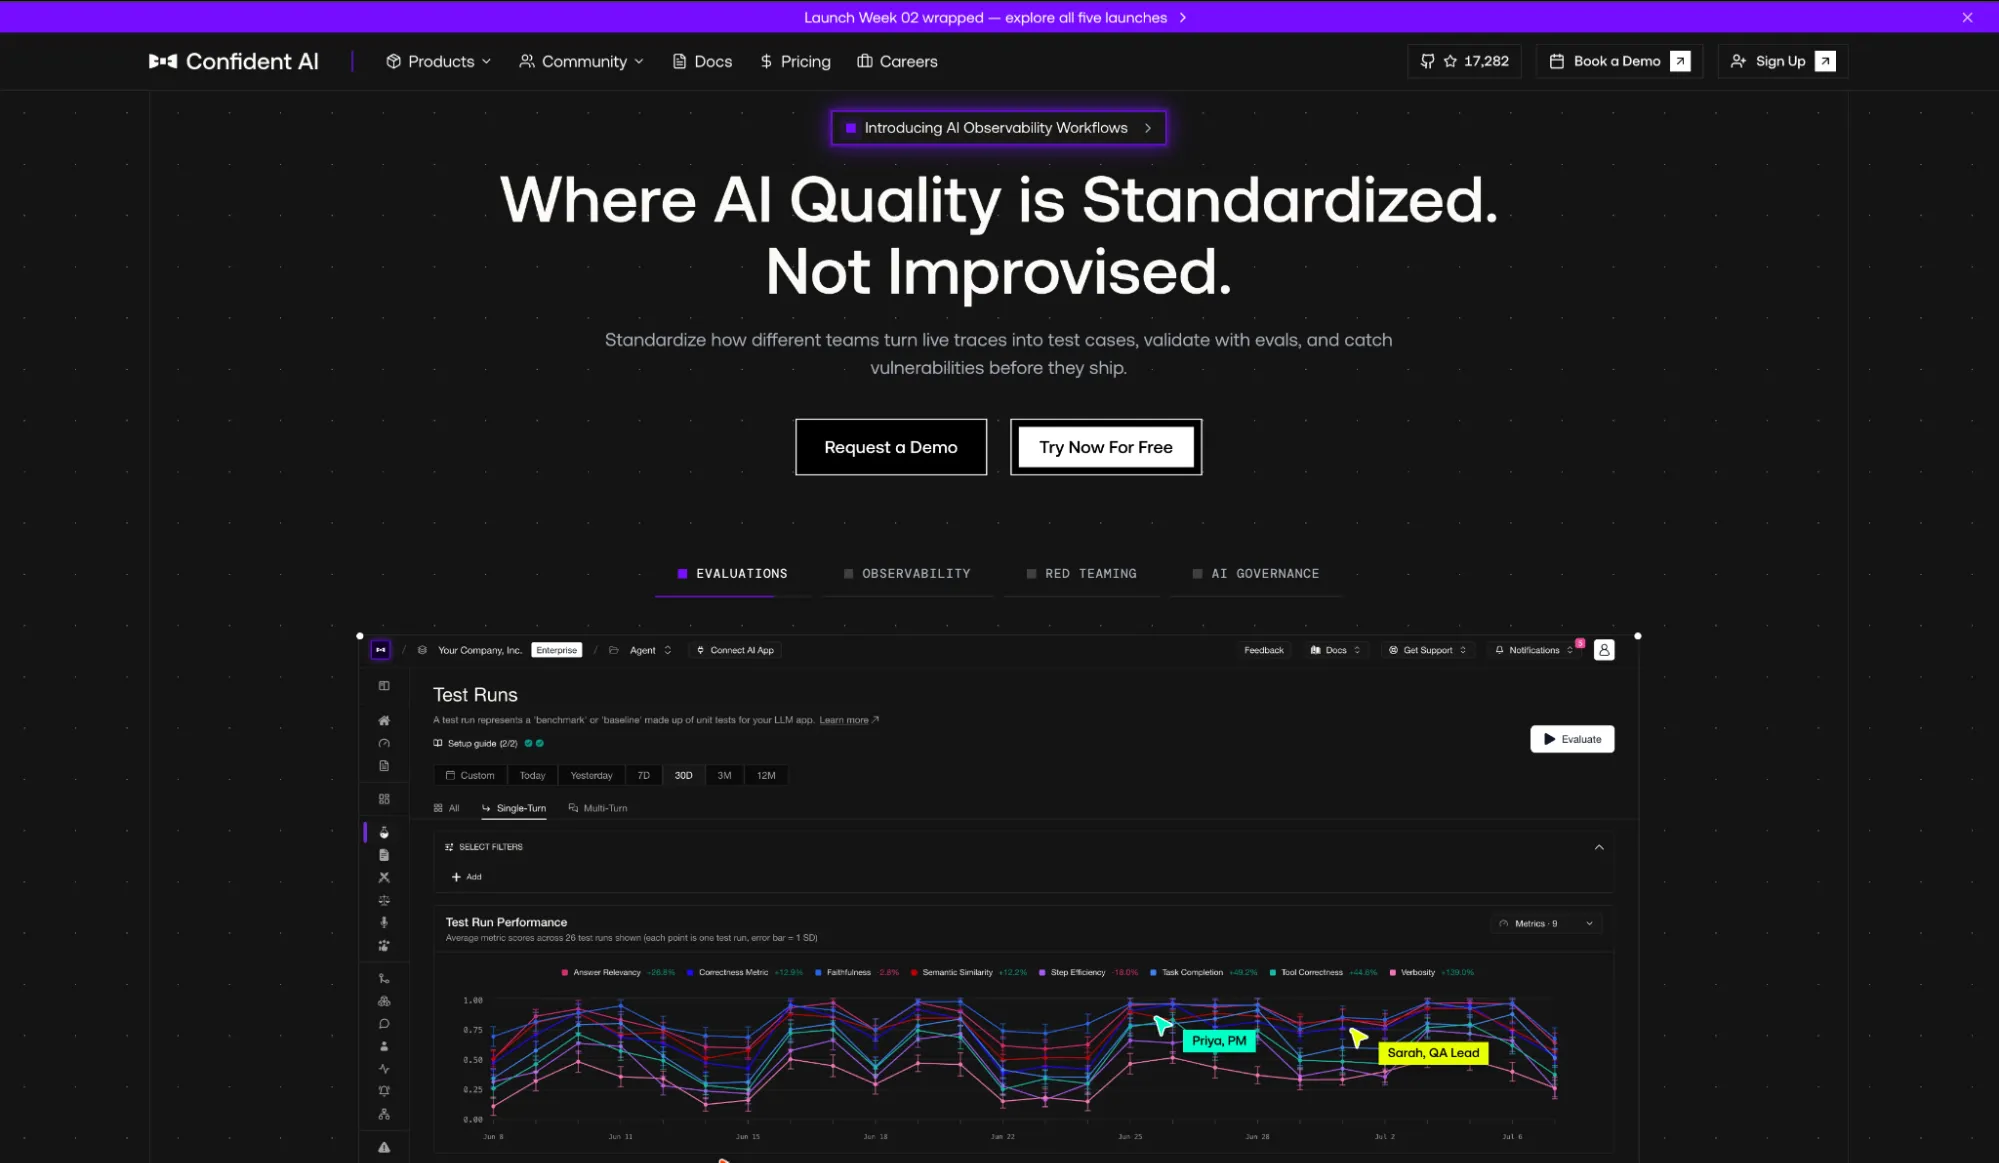
O Confident AI oferece uma ampla cobertura de avaliação em aplicações de LLM. Ele suporta avaliação em nível de resposta, de conversação, de ponta a ponta e de componentes. As equipes também podem executar experimentos de arena e fluxos de trabalho de avaliação de Integração Contínua e Entrega Contínua (CI/CD). Essa abrangência ajuda você a testar prompts, recuperação, conversas, agentes e o comportamento completo da aplicação.
A cobertura de métricas é específica. As métricas de turno único incluem relevância da resposta, fidelidade, alucinação, precisão contextual, recall contextual, conclusão de tarefas, correção de ferramentas, viés e toxicidade.
As métricas de múltiplos turnos cobrem a completude da conversação, retenção de conhecimento, adesão a papéis e relevância do turno. Se você precisar de uma métrica personalizada, pode criar avaliações sob medida por meio do G-Eval ou pontuação baseada em código.
O Braintrust estrutura a avaliação em torno de três elementos centrais: dados, tarefa e pontuações. O conjunto de dados contém casos de teste com entradas e saídas esperadas. A tarefa é a função de IA sob teste. As pontuações medem a qualidade da saída por meio de funções de avaliação repetíveis.
A pontuação é o ponto mais forte da plataforma. Os Autoevals fornecem avaliadores pré-construídos. Juízes de LLM lidam com critérios subjetivos. Avaliadores de código personalizado suportam verificações determinísticas. Além disso, o Braintrust suporta experimentos, playgrounds, avaliações remotas, pontuação online, rótulos, correções e revisão humana.
O Loop, seu agente de IA, pode iterar em prompts e executar avaliações sem que um membro da equipe precise conduzir cada ciclo. A plataforma também suporta grupos de permissão, logs de auditoria e opções de auto-hospedagem para equipes com requisitos de implantação mais rigorosos.
O Arize Phoenix é uma plataforma de observabilidade e avaliação de IA de código aberto criada pela Arize AI em conjunto com a comunidade. Ele utiliza instrumentação OpenTelemetry e OpenInference. Isso se adapta a ambientes que já coletam rastreamentos padronizados de frameworks, modelos, agentes e chamadas de provedores.
O Phoenix mapeia bem um ciclo de depuração. O rastreamento mostra o que aconteceu dentro de uma execução. A avaliação pontua a execução usando LLM-como-juiz, avaliações do lado do cliente e avaliações do lado do servidor. Ferramentas de prompt suportam a iteração usando interações reais, enquanto conjuntos de dados e experimentos comparam mudanças em relação a entradas idênticas.
O Phoenix também suporta Controle de Acesso Baseado em Função (RBAC), chaves de Interface de Programação de Aplicação (API), configurações de retenção e auto-hospedagem. Ele pode instrumentar LangChain, LlamaIndex, OpenAI, Bedrock, Anthropic e o Vercel AI Software Development Kit.
O Langfuse é uma plataforma de engenharia de LLM de código aberto para rastrear chamadas de modelos e capturar prompts, saídas, uso de tokens, latência e custo. O gerenciamento de prompts e os fluxos de trabalho de avaliação automatizada são construídos sobre esses dados de rastreamento, oferecendo às equipes um único local para investigar o comportamento da aplicação e avaliar as interações em produção.
A auto-hospedagem é o motivo pelo qual a maioria das equipes em setores regulamentados a seleciona. O Langfuse depende apenas de componentes de código aberto e pode ser implantado localmente, em infraestrutura de nuvem ou on-premises. O Docker Compose cobre trabalhos de pequena escala. Implantações em produção rodam via Kubernetes com Helm, ou Terraform na AWS, Azure ou GCP. A auto-hospedagem executa a mesma infraestrutura que alimenta o Langfuse Cloud.
from langfuse.openai import OpenAI
import os

# Initialize OpenAI client with TrueFoundry AI Gateway
client = OpenAI(
    api_key=os.environ["TRUEFOUNDRY_API_KEY"],
    base_url=os.environ["TRUEFOUNDRY_BASE_URL"]  # Base URL from unified code snippet
)
O Promptfoo é uma ferramenta de interface de linha de comando (CLI) e biblioteca de código aberto para avaliar e realizar testes de estresse (red-teaming) em aplicações de LLM. Ele utiliza arquivos de configuração, é executado a partir de um terminal e gera visualizações comparativas entre prompts, modelos e asserções. É ideal para equipes de desenvolvimento que desejam integrar a avaliação aos seus fluxos de trabalho de teste existentes.
O red-teaming é o seu diferencial. O Promptfoo pode gerar entradas adversárias para uma arquitetura específica, uma vez que sistemas RAG, chatbots e agentes de IA falham de maneiras diferentes. As equipes podem testar injeção de prompt, saídas inseguras, vazamento de dados e uso indevido de ferramentas conectadas.
Você pode adicionar um arquivo de configuração, definir asserções e executar testes localmente ou dentro de pipelines de CI/CD. Isso torna o Promptfoo útil para uma cobertura repetível em cenários de falha e casos extremos, sem a necessidade de um ambiente de avaliação gerenciado separado.
O DeepEval é um framework de avaliação de código aberto que trata a avaliação de LLM como teste unitário. Ele suporta métricas para RAG, conversas de múltiplos turnos, segurança, Protocolo de Contexto de Modelo (MCP), saídas de imagem e fluxos de trabalho de agentes. Foi projetado para engenheiros que desejam avaliações baseadas em código.
A avaliação de agentes é uma de suas áreas mais fortes. Suas métricas agentivas cobrem conclusão de tarefas, correção de argumentos, correção de ferramentas, eficiência de etapas, adesão ao plano e qualidade do plano. A conclusão da tarefa pode ler um rastreamento (trace) de LLM em vez de depender apenas da saída final.
O DeepEval pode ser executado localmente ou em CI, e a Confident AI fornece a camada de plataforma gerenciada para relatórios, painéis, alertas, fluxos de trabalho de produção e colaboração. Ele também se integra a frameworks como LangChain, LlamaIndex, CrewAI, LangGraph, Pydantic AI e OpenAI Agents.
O MLflow é uma plataforma de engenharia de IA de código aberto com recursos de avaliação para aprendizado de máquina e sistemas de IA generativa. Suas capacidades de IA generativa abrangem rastreamento, avaliações, detecção automática de problemas, juízes, pontuadores, conjuntos de dados de avaliação, anotações e testes de regressão.
A principal vantagem do MLflow é a consolidação. Equipes que já rastreiam experimentos, versionam artefatos, gerenciam prompts e executam pipelines de aprendizado de máquina podem adicionar a avaliação de IA generativa sem introduzir outro conjunto de credenciais ou políticas de retenção.
O MLflow também suporta gerenciamento de conjuntos de dados e pontuadores LLM-as-a-judge para ajudar as equipes a melhorar as aplicações de IA ao longo do tempo. Rastreamentos de produção podem se tornar casos de teste, criando um ciclo de feedback mais estreito entre falhas reais e futuras verificações de lançamento.
A escolha entre as melhores plataformas de avaliação de IA começa pela falha que você precisa detectar. Em seguida, considere onde a avaliação será executada, quem precisa de acesso e quão profundamente a plataforma consegue inspecionar agentes ou fluxos de trabalho de recuperação. Os requisitos de implantação e a infraestrutura de engenharia existente também devem influenciar a decisão.
Um processo de seleção prático inclui:
Muitas pilhas de produção utilizam vários avaliadores, pois os testes offline e a pontuação em tempo real podem exigir fluxos de trabalho diferentes. A tabela abaixo mapeia os requisitos comuns às opções mais adequadas dentro desta lista.
Cada plataforma acima é uma camada de observabilidade e garantia de qualidade. Nenhuma delas é uma camada completa de governança de inferência. A distinção é importante porque a avaliação analisa o que já aconteceu, enquanto a governança determina o que é permitido antes da execução.
A aplicação de orçamento demonstra essa distinção claramente. Uma regra no nível do gateway pode interromper solicitações adicionais quando um limite de custo configurado é atingido. O gateway pode retornar uma resposta 429 do Hypertext Transfer Protocol (HTTP) em vez de relatar gastos excessivos após a execução.
name: layered-budget-config
type: gateway-budget-config
rules:
  # Priority 1: Power users get a higher per-user limit
  - id: 'power-user-daily'
    when:
      subjects: ['team:ml-engineering']
    limit_to: 100
    unit: cost_per_day
    budget_applies_per: ['user']

  # Priority 2: Default per-user limit for everyone else
  - id: 'default-user-daily'
    when: {}
    limit_to: 10
    unit: cost_per_day
    budget_applies_per: ['user']
A ordem das regras carrega a semântica. O custo é rastreado para cada regra correspondente, enquanto a primeira regra correspondente determina se a solicitação é permitida ou bloqueada. As regras também podem ser executadas primeiro em modo de auditoria, ajudando as equipes a calibrar os limites antes da aplicação.
O AI Gateway da TrueFoundry opera uma camada abaixo da avaliação, no próprio caminho da solicitação. As equipes podem executá-lo junto com qualquer plataforma de avaliação desta lista. As integrações documentadas tornam isso prático, pois o gateway pode exportar rastreamentos OpenTelemetry para sistemas de observabilidade externos.
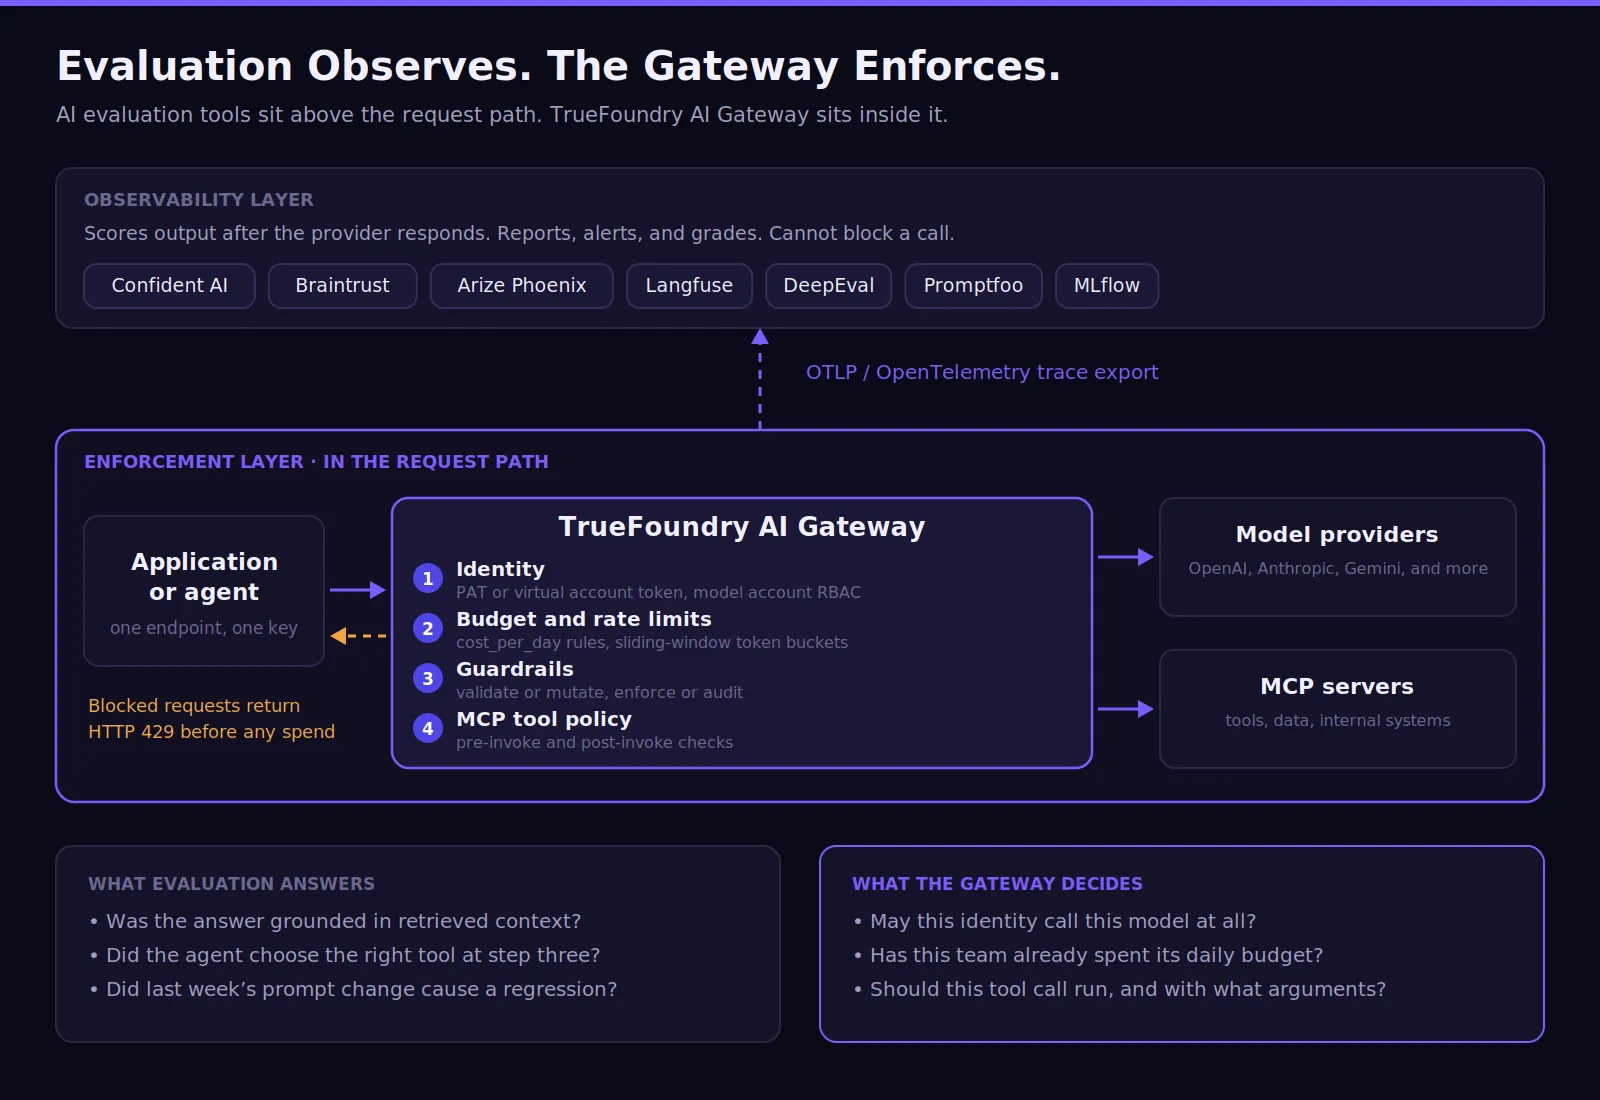
O controle de acesso é resolvido antes que uma solicitação chegue a um provedor. As aplicações autenticam-se no gateway com tokens da TrueFoundry em vez de chaves brutas do provedor. As permissões da conta do modelo determinam quais equipes e usuários podem acessar modelos específicos.
Os guardrails funcionam como ganchos em torno da chamada. Cada guardrail pode validar conteúdo, bloquear entradas de risco ou modificar o conteúdo antes do encaminhamento. Isso é importante quando sistemas de IA em produção precisam filtrar informações confidenciais, prompts inseguros ou violações de política.
A mesma configuração pode reger chamadas de ferramentas MCP através do MCP Gateway. É aqui que as falhas de acesso de agentes geralmente se originam, porque os agentes chamam ferramentas que podem acessar sistemas corporativos ativos.
name: guardrails-control
type: gateway-guardrails-config
rules:
  - id: mcp-tool-rule
    when:
      target:
        operator: or
        conditions:
          mcpServers:
            values:
              - kubernetes-mcp
            condition: in
      subjects:
        operator: and
        conditions:
          in:
            - team:test-team
    llm_input_guardrails: []
    llm_output_guardrails: []
    mcp_tool_pre_invoke_guardrails:
      - pii/pii-detection
    mcp_tool_post_invoke_guardrails:
      - prisma-airs/prisma-airs-dev-profile
Os guardrails de pré-invocação inspecionam os argumentos da ferramenta antes que ela seja executada. Os guardrails de pós-invocação inspecionam o resultado da ferramenta antes que o agente o receba. Isso transforma a governança de ferramentas em uma aplicação no caminho da solicitação.
OGateway de Agentes aplica o mesmo padrão de governança em fluxos de trabalho multiagentes. O Gateway de LLM centraliza o acesso ao modelo, roteamento, visibilidade de uso, limites de taxa e flexibilidade do provedor.
A atribuição é outra vantagem. Os metadados podem segmentar custo, latência e uso de tokens por projeto, ambiente ou cliente. Isso torna a governança de IA mensurável entre as equipes de produção.
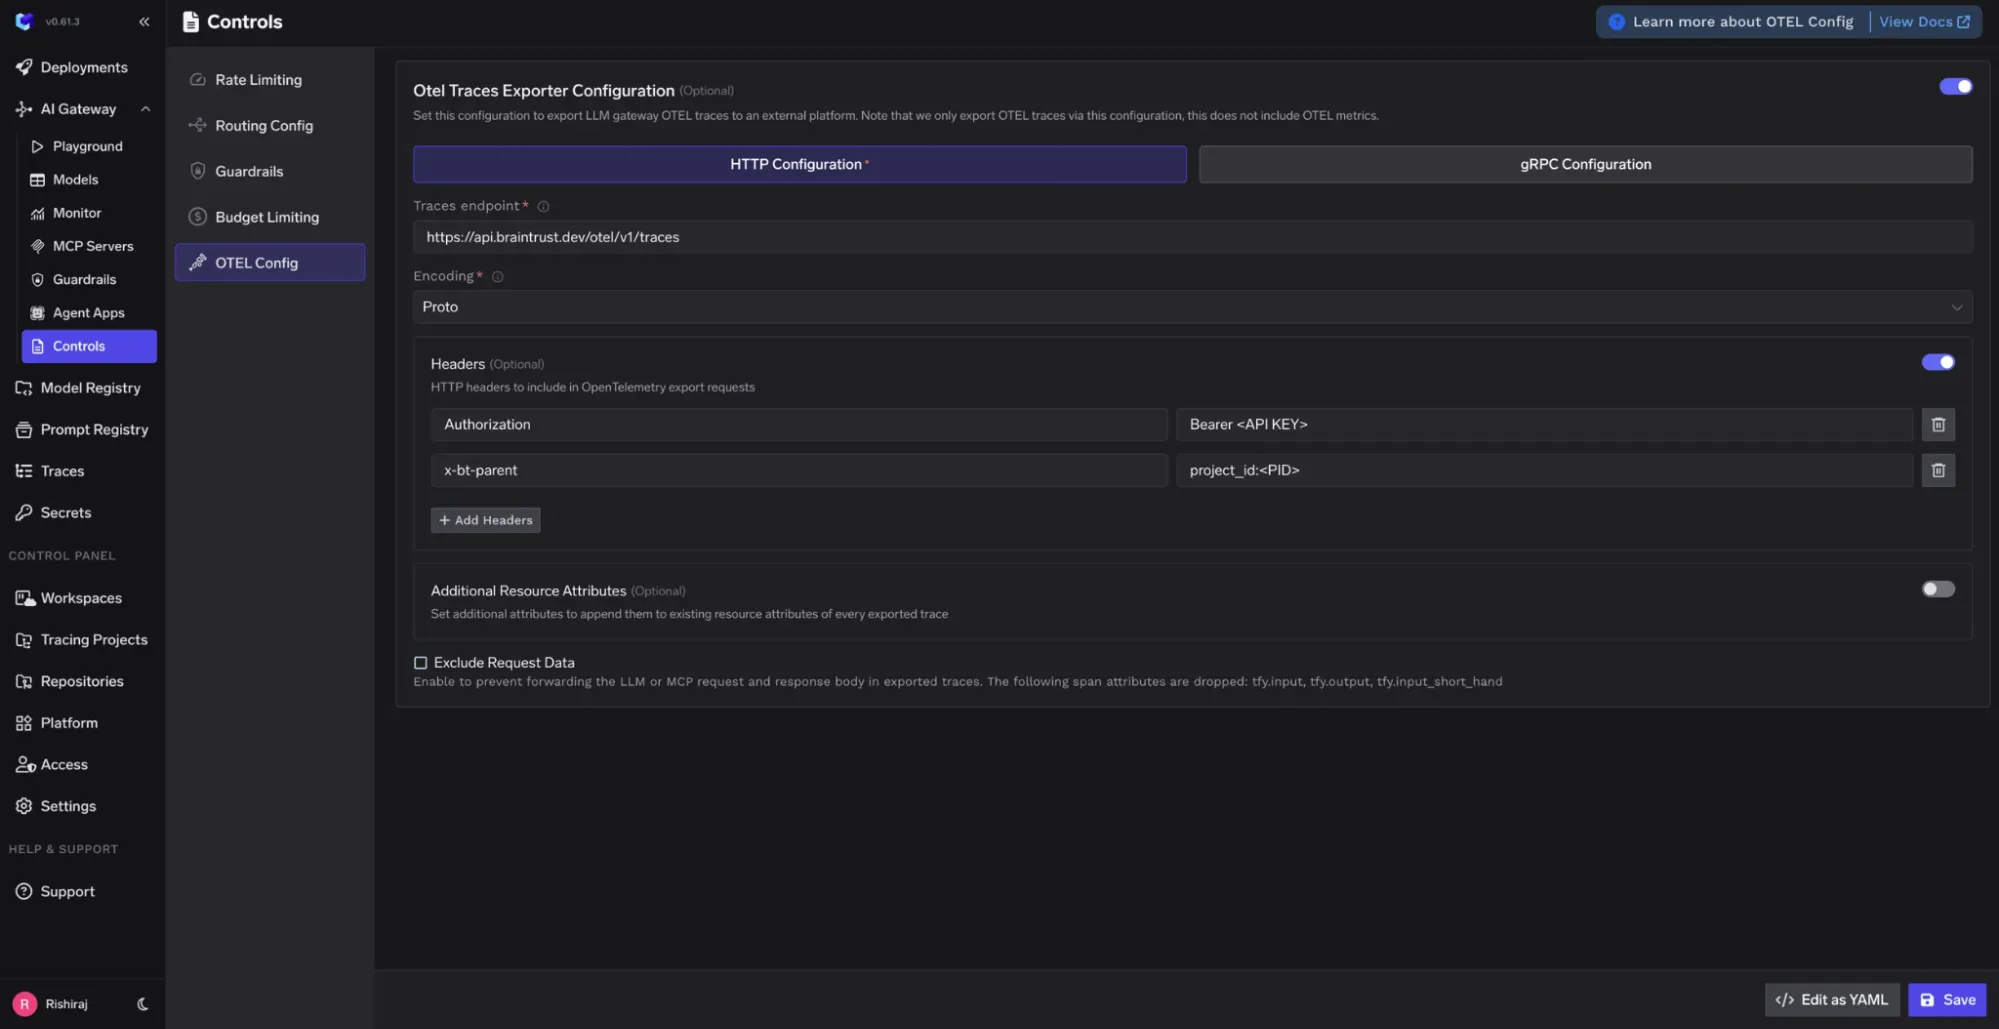
As mesmas dimensões orientam os limites. A limitação de taxa é executada em uma janela deslizante, com `rate_limit_applies_per` definindo contadores separados por usuário, modelo, conta virtual ou valor de metadado.
Para equipes que comparam custos, o planejamento de custos do gateway de IA ajuda a esclarecer onde a aplicação de orçamento, roteamento, cache e controles de solicitação se encaixam. Para equipes que protegem ferramentas, os padrões de gateway MCP corporativo ajudam a definir um acesso mais seguro às ferramentas.
A TrueFoundry não substitui uma plataforma de pontuação. Ela não avalia a fidelidade, a adesão ao plano ou a utilidade das respostas. Ela decide quem chama o quê, sob qual orçamento, através de quais ferramentas e sob quais políticas de conteúdo.
Escolha a plataforma de avaliação que corresponda aos seus modos de falha e, em seguida, adicione a governança de tempo de execução abaixo dela. Agende uma demonstração para ver como a TrueFoundry pode aplicar esses controles em todo o seu tráfego de produção.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada