



novembro 19, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.




Blazingly fast way to build, track and deploy your models!
O AWS Bedrock funciona como uma camada gerenciada para acessar modelos de fundação dentro do limite da VPC da AWS. Para equipes de engenharia, ele elimina a sobrecarga operacional de provisionar instâncias de GPU ou gerenciar clusters de Kubernetes para inferência. O serviço oferece acesso imediato a modelos como Claude 3.5 Sonnet, Llama 3 e Amazon Titan por meio de uma API unificada.
No entanto, a estrutura de preços do AWS Bedrock não é uma taxa fixa. Ela funciona como um menu complexo em que o custo final é uma função da variação de modelos, distribuição de tokens, capacidades de tráfego regional e da sobrecarga operacional de serviços de suporte como CloudWatch e OpenSearch. Este relatório analisa a economia unitária do AWS Bedrock, identifica onde os custos aumentam em escala e analisa as compensações arquitetônicas entre a inferência gerenciada e alternativas auto-hospedadas usando plataformas como TrueFoundry.
Antes de examinar os custos detalhados, é importante entender o modelo de preços geral do AWS Bedrock. O AWS Bedrock segue uma abordagem de preços puramente baseada no uso, sem taxas iniciais de plataforma ou assinatura.
Você não paga para ativar o serviço. Em vez disso, é cobrado principalmente pela inferência do modelo, medida por tokens ou respostas geradas. No entanto, o preço por unidade varia significativamente dependendo do provedor do modelo de fundação; um modelo da Anthropic custa significativamente mais do que um modelo da Meta ou Mistral, mesmo que a contagem de tokens seja idêntica.
A precificação do AWS Bedrock é impulsionada pela forma como os modelos consomem recursos durante a inferência. Embora a maioria dos modelos de texto cobre por token, os modelos multimodais diferem.
Você deve distinguir entre Tokens de entrada e Tokens de saída. Os tokens de entrada consistem na carga útil do prompt, incluindo instruções do sistema, consultas do usuário e — fundamentalmente — contexto recuperado de pipelines de RAG. Os tokens de saída são a resposta gerada.
A realidade operacional dita que os tokens de saída são significativamente mais caros porque o custo computacional da geração (predição do próximo token) é maior do que o processamento do contexto de entrada. Por exemplo, com o Claude Sonnet 4.5 em us-east-1, você paga US$ 3,00 por milhão de tokens de entrada, mas US$ 15,00 por milhão de tokens de saída — um multiplicador de 5x. Para modelos multimodais como o Amazon Titan Image Generator, a cobrança passa a ser por imagem, calculada com base na resolução e na contagem de etapas.
Fig 1: O efeito multiplicador de custo
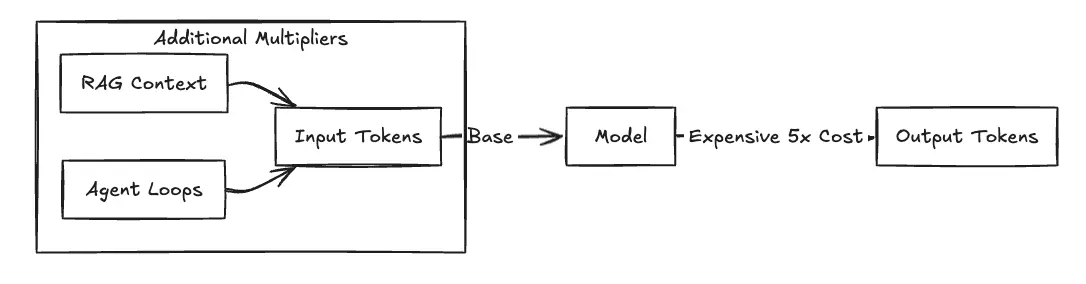
A precificação do AWS Bedrock não é apenas "pagamento por token". As equipes devem escolher entre dois modelos de preços que trocam flexibilidade por capacidade garantida.
Fig 2: Decomposição da fatura total
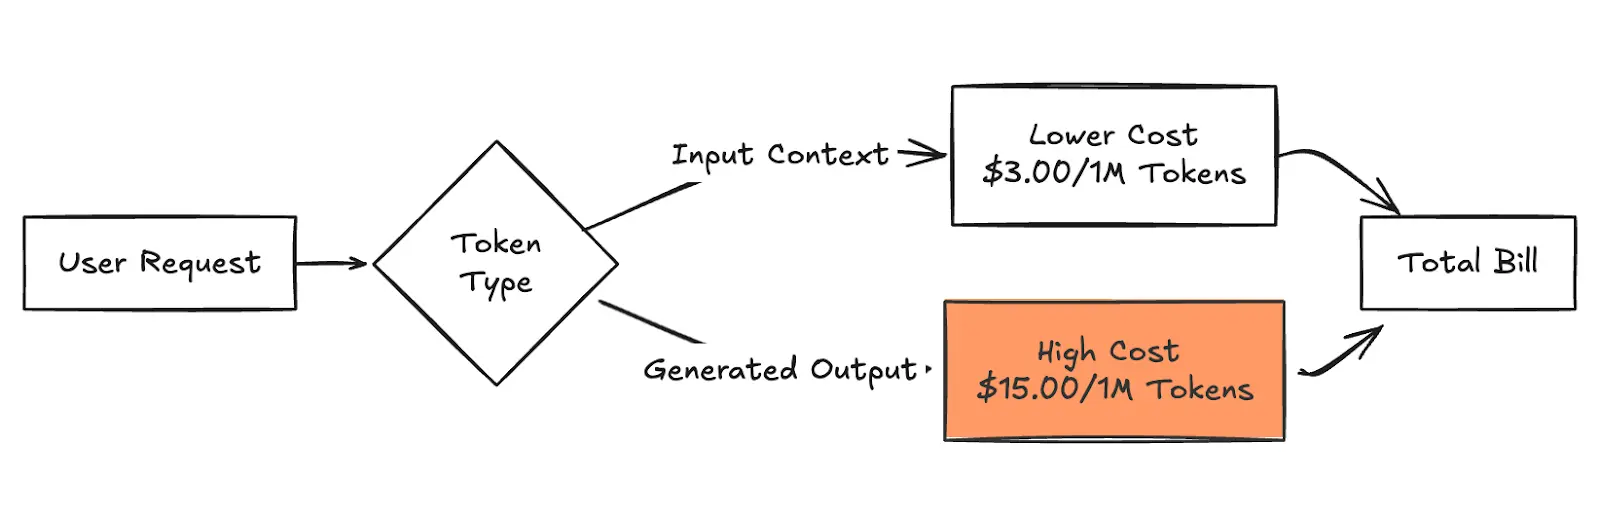
Os preços refletem as tarifas On-Demand do AWS Bedrock para o Anthropic Claude 3.5 Sonnet na região us-east-1 até janeiro de 2026. Os preços podem variar de acordo com a região ou versão do modelo.
Os preços On-Demand são a opção padrão para a maioria dos usuários do AWS Bedrock. Eles oferecem flexibilidade, mas vêm com riscos operacionais. Você é cobrado estritamente por 1.000 tokens processados, o que é perfeito para padrões de tráfego variáveis ou experimentações iniciais em que os padrões de uso são irregulares. No entanto, a desvantagem é a confiabilidade. A AWS impõe limites de limite de taxa (throttling), o que significa que, durante picos de demanda, suas solicitações podem ser limitadas.
Os preços de Provisioned Throughput são projetados para equipes que precisam de disponibilidade garantida de modelos em escala. Isso traz previsibilidade, mas exige um compromisso financeiro. Em vez de pagar por token, você compra uma unidade de modelo dedicada para reservar capacidade de inferência e garantir um nível específico de preço por taxa de transferência.
A pegadinha é que você é cobrado a uma taxa fixa por hora, independentemente de enviar zero solicitações ou usar a capacidade máxima da unidade. Esse modelo funciona como uma instância reservada; ele normalmente exige um compromisso de 1 a 6 meses, reduzindo sua capacidade de mudar de modelo rapidamente se um melhor for lançado na semana seguinte.
Ao contrário da OpenAI, onde você paga a um único fornecedor, o Bedrock é um marketplace. As estratégias de preços diferem por fornecedor.
Os modelos Amazon Titan são modelos de fundação nativos da AWS projetados para cargas de trabalho de AI de uso geral. Por serem modelos de terceiros internos (first-party), eles costumam ser precificados abaixo das alternativas de terceiros externos. Isso os torna adequados para casos de uso de produção sensíveis ao custo, como geração de embeddings ou classificação simples, onde o objetivo é um desempenho "suficientemente bom" a um preço baixo.
O AWS Bedrock também oferece acesso a modelos de provedores externos como Anthropic, Cohere e AI21 Labs. A precificação aqui é geralmente mais alta devido às capacidades avançadas e ao licenciamento externo envolvido. Fique atento ao prêmio de custo em modelos de alto raciocínio como o Claude 4.5 Sonnet, onde os tokens de saída são significativamente mais caros. Os custos aqui podem subir rapidamente para aplicações focadas em chat onde o modelo "pensa" ou gera respostas longas e verbosas.
A arquitetura da sua aplicação afeta sua fatura tanto quanto o preço do modelo.
O preço base do token é frequentemente apenas a ponta do iceberg. Aplicações de AI do mundo real usam "Knowledge Bases" e "Agents", que possuem suas próprias medições separadas.
Fig 3: A pilha de custos adicionais
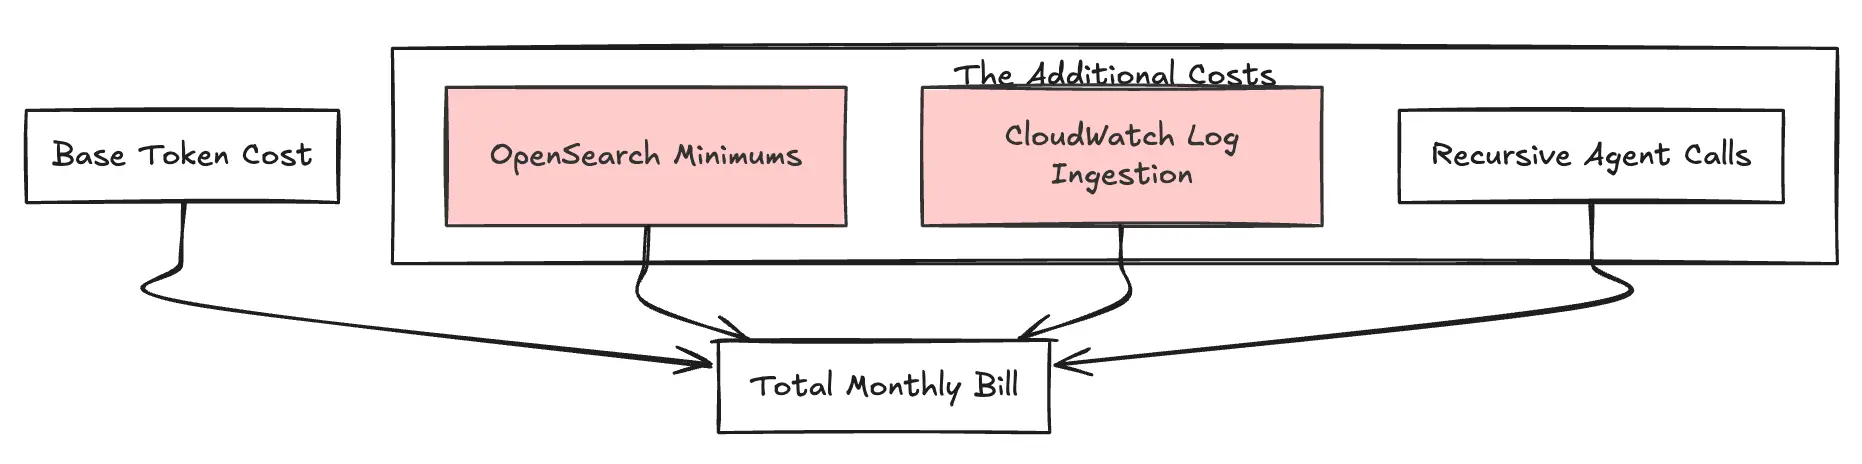
As Knowledge Bases do Bedrock abstraem o pipeline de RAG, mas provisionam infraestrutura em segundo plano. Normalmente, isso inicializa um banco de dados vetorial OpenSearch Serverless. As equipes de engenharia frequentemente ignoram o custo mínimo de entrada: o OpenSearch Serverless requer no mínimo 2 OCUs (OpenSearch Compute Units) para redundância em produção. A ~US$ 0,24 por OCU/hora (em us-east-1), isso resulta em um custo base de aproximadamente US$ 350/mês (para uma configuração padrão redundante) apenas para o índice existir, mesmo com zero tráfego de consulta.
Os "Agents" executam várias etapas para responder a uma consulta do usuário (Pensar → Buscar → Resumir). O impacto é que uma única pergunta do usuário pode disparar 10x os tokens que você esperava devido a esse ciclo interno e traço de raciocínio. Você paga pela entrada e saída de cada pensamento intermediário, o que cria um efeito multiplicador em sua fatura.
A auditabilidade é obrigatória para AI enterprise, mas a integração do Bedrock com o CloudWatch Logs é prolixa. Ele registra payloads completos de prompts e respostas. A ingestão do CloudWatch em regiões como us-east-1 custa US$ 0,50 por GB, e o armazenamento adiciona mais US$ 0,03 por GB. Aplicações de geração de texto de alto volume podem facilmente gerar centenas de gigabytes de dados de log, adicionando discretamente uma sobrecarga significativa à fatura mensal.
Muitas equipes subestimam os preços do AWS Bedrock durante a experimentação inicial porque as variáveis são difíceis de isolar. O uso de tokens varia amplamente com base no comportamento do usuário; um usuário pode fazer uma pergunta simples enquanto outro cola um PDF de 50 páginas para resumo. Além disso, desenvolvedores adoram experimentar, e mudar do Claude Haiku para o Claude Sonnet altera seu nível de preço instantaneamente, muitas vezes sem que o departamento financeiro perceba até o final do mês. Por fim, os orçamentos da AWS funcionam no nível da conta, tornando muito difícil ver "Quanto o Bot de Marketing gastou versus o Bot de Engenharia?" sem estratégias complexas de marcação (tagging).
Apesar de sua complexidade, os preços do AWS Bedrock funcionam bem para certos cenários. Se você já padronizou sua infraestrutura na AWS, a taxa de "integração nativa" vale a pena pelos benefícios de segurança e conformidade, como IAM e PrivateLink. Para aplicações com tráfego irregular que são usadas de forma infrequente ou imprevisível, o modelo On-Demand é perfeito porque você não paga nada enquanto a aplicação está ociosa. Isso permite que projetos em estágio inicial sejam lançados rapidamente sem gerenciar GPUs ou clusters de Kubernetes, validando o fit de produto no mercado antes de otimizar os custos.
À medida que as cargas de trabalho de AI amadurecem, as equipes costumam encontrar limitações estruturais. Em altos volumes (milhões de solicitações), a margem de lucro cobrada por token torna-se cara em comparação a possuir a computação. O ajuste fino (fine-tuning) no Bedrock frequentemente exige a compra de Provisioned Throughput, o que aumenta drasticamente a barreira de entrada em comparação ao fine-tuning do Llama 3 em sua própria GPU. Além disso, ambientes com várias equipes carecem de controle orçamentário detalhado no nível da aplicação, levando a um uso desordenado em que uma equipe esgota o orçamento compartilhado.
O TrueFoundry oferece um padrão arquitetônico alternativo para equipes que atingem o limite da economia unitária do Bedrock. Em vez de alugar a API do modelo com uma margem de lucro, o TrueFoundry orquestra a implantação de modelos open-source (Llama 3, Mistral, Qwen) diretamente em seus próprios clusters AWS EC2 ou EKS.
Isso desbloqueia a capacidade de utilizar Instâncias Spot da AWS. Ao executar a inferência em capacidade Spot — computação ociosa da AWS disponível com grandes descontos —, você pode reduzir os custos brutos de inferência em 60-70% em comparação às tarifas On-Demand do Bedrock. O TrueFoundry gerencia o risco operacional de interrupções Spot automatizando o fallback para instâncias On-Demand se a capacidade Spot for interrompida, garantindo confiabilidade sem a fidelidade de 6 meses do Provisioned Throughput.
Esta é uma comparação objetiva focada na economia da disponibilização de modelos.
À medida que a adoção de AI cresce, a clareza nos preços torna-se crítica para um dimensionamento sustentável. A precificação do AWS Bedrock não deveria obrigar você a escolher entre inovação e falência.
O TrueFoundry dá a você o poder de controlar seus gastos com AI, oferecendo visibilidade granular sobre cada modelo e a flexibilidade para executar cargas de trabalho na infraestrutura mais econômica disponível.
O preço do AWS Bedrock varia de acordo com o modelo de fundação e o uso de tokens. Embora a inferência de modelos em baixo volume seja acessível, a inferência em grande escala torna-se dispendiosa devido às margens de lucro do serviço gerenciado. O TrueFoundry permite uma melhor otimização de custos executando modelos em instâncias AWS Spot, reduzindo significativamente seu custo mensal total em comparação às tarifas do Bedrock.
Sim, o custo do AWS Bedrock segue um modelo de preços pay-as-you-go. Você é cobrado por cada número de tokens processados tanto para tokens de entrada quanto para tokens de saída. Para aplicações de AI generativa intensivas, essas taxas se acumulam rapidamente. O TrueFoundry oferece uma abordagem mais econômica utilizando tarifas brutas de computação em sua própria infraestrutura.
A precificação do Amazon Bedrock não inclui um modo gratuito permanente. Embora uma nova conta AWS possa oferecer créditos gerais, o Bedrock cobra pela inferência do modelo imediatamente. O TrueFoundry ajuda a minimizar os custos do Bedrock ao permitir o uso de instâncias spot mais baratas para seus casos de uso específicos e tarefas em lote.
Não existe um nível gratuito dedicado para o AWS Bedrock. Os usuários pagam por todo o uso de geração de texto e geração de imagens. Para evitar custos imprevisíveis no AWS Bedrock, as equipes migram para o TrueFoundry, que aproveita o escalonamento automático e a inferência em lote para gerenciar despesas de AI generativa de forma mais eficaz do que o serviço gerenciado.
O TrueFoundry é um equivalente superior a esse serviço totalmente gerenciado. Ele permite implantar qualquer modelo customizado (como o Mistral AI) ou um modelo Amazon Titan em sua própria nuvem. Ao contrário do Bedrock, ele simplifica a gestão de custos usando instâncias spot e automação de dados, evitando o aprisionamento pelo fornecedor (vendor lock-in) para importação de modelos customizados.
Não há versão gratuita do Amazon Bedrock; você paga para acessar cada modelo de fundação. Para um melhor valor a longo prazo, o TrueFoundry permite executar modelos open-source com prompt caching e destilação de modelos em seu próprio hardware, reduzindo drasticamente a barreira de entrada para a adoção de AI generativa.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada

















