



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
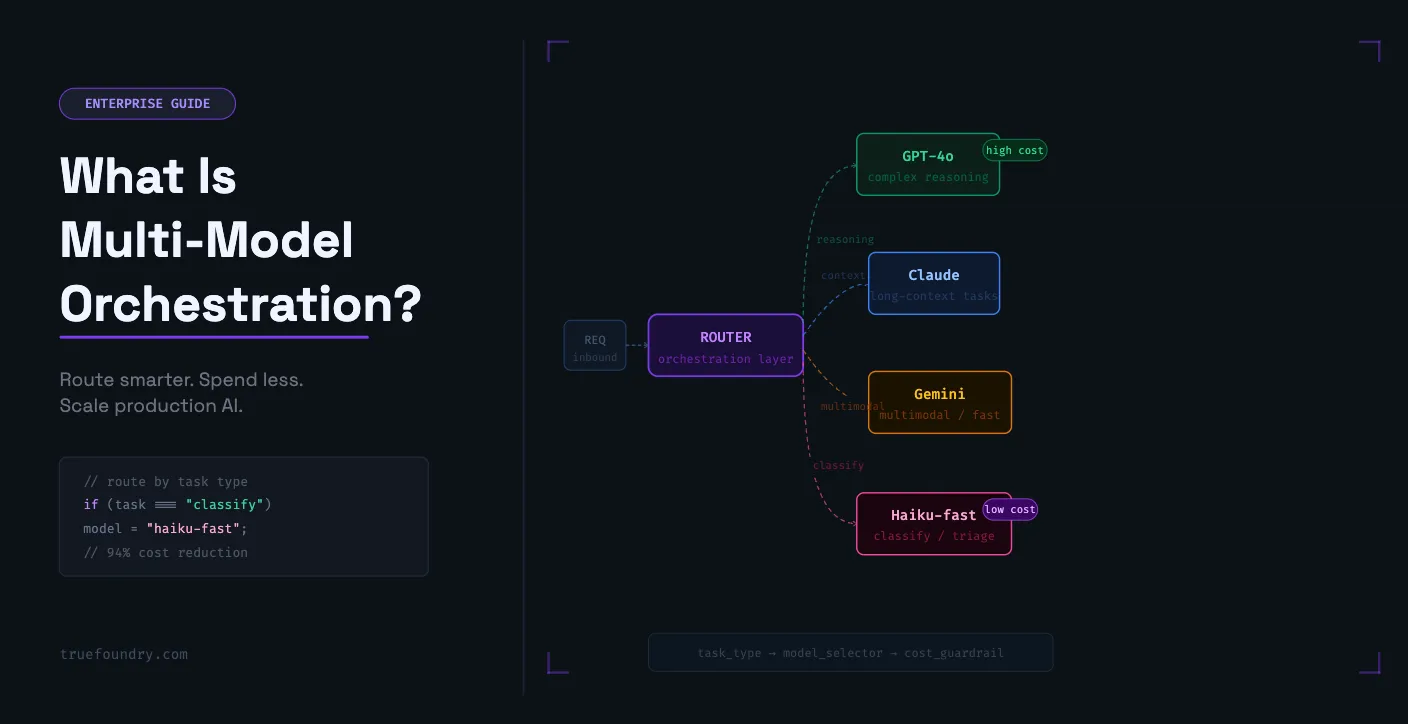
Geen enkel model is het beste in elke taak. GPT-4o kan goed overweg met complexe redeneringen, terwijl kleinere taalmodellen vaak classificatie, routing en extractie uitvoeren tegen lagere kosten. Het routen van elke request naar het duurste model leidt tot onnodige uitgaven en verslechtert de toewijzing van middelen over AI-productieteams.
Multi-Model orchestration maakt dit onderscheid operationeel. In plaats van elke workload vast te pinnen op één provider, routeert het requests over verschillende modellen op basis van het type taak, kosten, latency en kwaliteitseisen. Voor productieteams is dit geen kleine optimalisatie meer. Het wordt de operationele laag voor enterprise AI.
Enterprises draaien AI-applicaties nu over OpenAI, Anthropic, Google, Azure, AWS Bedrock en zelfgehoste modellen. Multi-LLM orchestration is verschoven van een handig routingpatroon naar een vereiste voor de kerninfrastructuur. Deze gids legt uit hoe het werkt, wat het niet uit zichzelf oplost en hoe TrueFoundry governance toevoegt via een enterprise gateway-laag.
Multi-Model orchestration is het verbinden van een applicatie, een enkele AI-agent of een workflow met meerdere AI-modellen. De LLM orchestration-laag routeert vervolgens elke request naar het model dat het beste past bij de specifieke taak, de kostendoelstelling, de latency-vereiste of de kwaliteitsdrempel.
De term omvat zowel statische als dynamische routing. Statische routing wijst verschillende taken toe aan vooraf gedefinieerde modellen. Samenvattingen kunnen naar een kostenefficiënt model gaan, code-aanvullingen naar een coderingsmodel en diepgaand onderzoek naar een sterker redeneermodel.
Dynamische routing evalueert de invoer van de gebruiker tijdens runtime. De orchestration engine kan de complexiteit, de status van de provider, latency, kosten en beschikbare routingregels inspecteren vóór de verzending. De meeste realtime systemen gebruiken beide benaderingen om snelheid, kwaliteit, veerkracht en kosten in balans te brengen.
In beide gevallen bevindt de centrale orchestrator zich tussen de applicatie en de onderliggende modellen. Het abstraheert provider-specifieke API's, verwerkt routing, normaliseert antwoorden en beheert failover. Je applicatie heeft één enkel ingangspunt, terwijl de gateway de modelselectie en het gedrag van de provider beheert.
Multi-Model orchestration is essentieel geworden omdat AI-workloads nu sterk verschillen qua kosten, risico, complexiteit en latency. Een chatbot die eenvoudige vragen van klanten beantwoordt, heeft niet hetzelfde model nodig als een agent die gereguleerde beslissingen of complexe codegeneratie verwerkt.
Frontier-modellen zijn geoptimaliseerd voor de kwaliteit en breedte van het redeneren. Kleinere taalmodellen zijn geoptimaliseerd voor snelheid en kosten bij goed gedefinieerde taken. Het vastpinnen van elke workload op één niveau laat aan beide kanten echte waarde onbenut.
Het standaard routen van al het verkeer naar vlaggenschip grote taalmodellen betekent dat je te veel betaalt voor een groot deel van de requests. Een kleiner model kan veel routineuze prompts beantwoorden met dezelfde nauwkeurigheid en snellere responstijden. Het omgekeerde veroorzaakt een ander probleem, omdat standaardiseren op een goedkoper model kan leiden tot oppervlakkige of onjuiste antwoorden op echt moeilijke prompts.
Als je ooit een uitgavengrafiek hebt zien stijgen zonder duidelijke oorzaak, is de reden vaak simpel. Eén standaardmodel, één routingregel en geen manier om eenvoudiger werk naar iets goedkopers te sturen. Multi-Model orchestration is de structurele oplossing omdat het elke specifieke taak koppelt aan het juiste model.
LLM API-providers kampen met storingen, rate limits en prestatievermindering die direct van invloed zijn op productie-applicaties. De eigen gateway-documentatie van TrueFoundry haalt de statuspagina's van OpenAI en Anthropic van februari tot en met mei 2025 aan, waaruit herhaalde incidenten over een periode van vier maanden blijken.
Dat is geen randgeval. Het is de operationele omgeving voor generatieve AI-productiesystemen.
Multi-Model orchestration met automatische failover routeert productieworkloads naar een beschikbare provider wanneer het primaire eindpunt verminderd presteert. De applicatie blijft beschikbaar zonder dat menselijke tussenkomst of dringende wijzigingen van de dienstdoende engineer nodig zijn. Het patroon is hetzelfde als bij elke kritieke afhankelijkheid: redundantie, health checks en automatische fallback.
Gereguleerde enterprises kunnen niet elke request naar elk model sturen. Sommige workloads bevatten gevoelige data, vertrouwelijke informatie, klantedatasets of regionale databeperkingen. In deze gevallen moeten routingbeslissingen gebaseerd zijn op beleidsregels, en niet alleen op kosten of latency.
Een beheerde governance-laag kan requests routen op basis van metadata, geografie, team, omgeving of dataklasse. Dit is van belang wanneer externe data, private datasets of beperkte workflows binnen goedgekeurde grenzen moeten blijven.
In het geval van TrueFoundry kun je metadata_match-regels toevoegen aan een target, zodat deze alleen verkeer ontvangt wanneer de request-metadata (of de eigen tfy_gateway_region-tag van de gateway) overeenkomt met een geconfigureerde waarde, met een catch-all target voor elke regio die niet expliciet is toegewezen.
Multi-Model orchestration vertrouwt doorgaans op vier kerncomponenten: een uniforme API-laag, routinglogica, failover-ketens en responsnormalisatie. Samen helpen ze teams om meerdere providers te gebruiken zonder elke integratie hardcoded in de applicatiecode op te nemen.
Elke provider gebruikt verschillende request-indelingen, parameternamen, foutcodes en responsstructuren. Het AI-orchestration framework normaliseert deze verschillen achter één API. Dit geeft applicaties een consistente interface voor gehoste, open-source en zelfgehoste modellen.
De LLM Gateway van TrueFoundry biedt een OpenAI-compatibel schema voor meer dan 1.000 modellen. Hiermee kunnen teams providers toevoegen of wisselen zonder elke downstream service te wijzigen. Het vereenvoudigt ook prompt engineering, testen en uitrolbeheer over teams heen.
Deze uniforme API-laag verbetert ook het gebruiksgemak voor ontwikkelaars en platformteams. Het vereenvoudigt prompt engineering, integratietesten en uitrolbeheer over verschillende applicaties. In plaats van gescheiden provider-specifieke logica over services te bouwen, gebruiken teams één consistent ingangspunt voor toegang tot modellen.
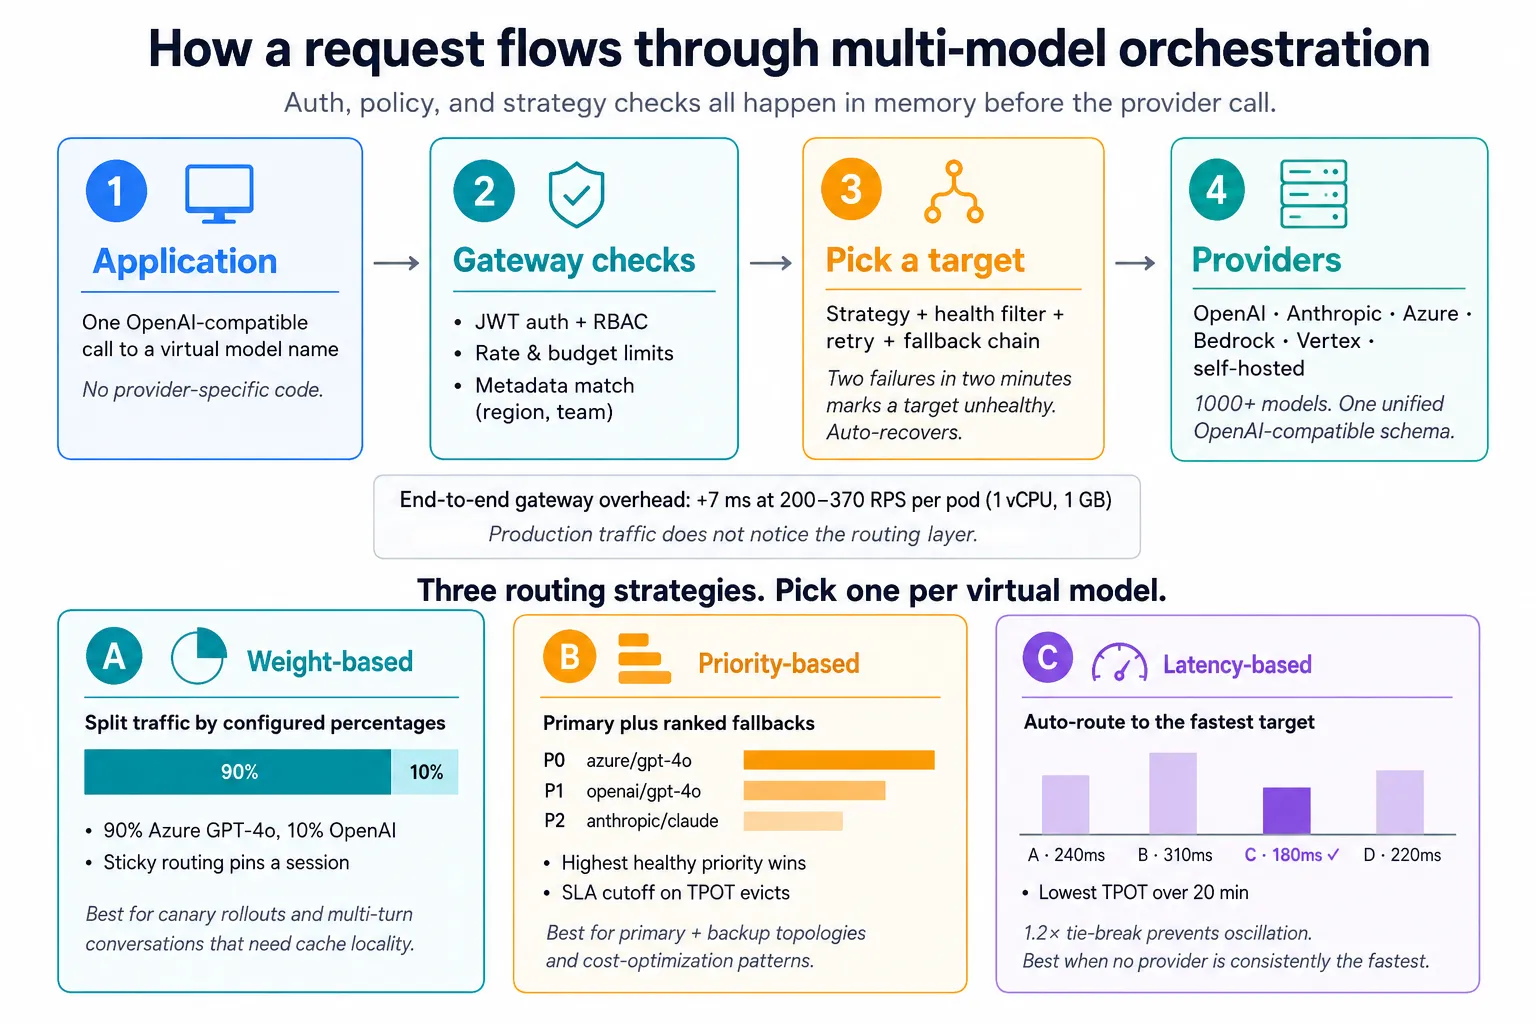
Dit is waar multi-model orchestration zijn naam eer aandoet. De virtuele modellen van TrueFoundry ondersteunen drie routingstrategieën, waarvan je er één per virtueel model kiest:
In TrueFoundry ziet de configuratie voor een typisch primair-plus-fallback virtueel model er zo uit:
In die configuratie gaan requests eerst naar azure/gpt-4o. Volgens het retry_config-blok probeert de gateway het tot 3 keer opnieuw met een vertraging van 200 ms bij rate-limit-fouten voordat hij uitvalt naar openai/gpt-4o. De Anthropic-target draait alleen als het de gezonde target met de hoogste prioriteit is, nooit als fallback voor de andere twee.
Dit gebeurt allemaal in-memory.
Geen externe calls in het request-pad.
Deze routingpatronen ondersteunen verschillende applicaties, waaronder klantenservice, ondersteuning, conflictresolutie, coderingsassistenten, compliance-workflows en interne enterprise copilots.
Failover-ketens definiëren een op prioriteit gesorteerde lijst van providers voor elke routingregel. Wanneer de primaire provider een fallback-statuscode retourneert (de standaarden van TrueFoundry: 401, 403, 404, 429, 500, 502, 503), probeert de gateway de volgende in aanmerking komende target in plaats van de fout door te geven aan de applicatie.
Dit patroon is met name handig voor complexe workflows en autonome agents. Wanneer een agent afhankelijk is van meerdere model-calls, kan een enkele storing bij een provider de workflow onderbreken. Automatische failover beschermt de gebruikerservaring zonder dat menselijke tussenkomst nodig is.
Er is ook retry-logica op dezelfde target voordat een fallback in werking treedt. De standaarden van de gateway zijn 2 pogingen met een vertraging van 100 ms bij 429, 500, 502, 503. Elke target kan die standaarden overschrijven in het eigen retry_config-blok. In de YAML hierboven overschrijft azure/gpt-4o die standaarden naar 3 pogingen bij 200 ms, terwijl openai/gpt-4o ze expliciet instelt op 2 pogingen bij 100 ms (wat overeenkomt met de standaarden). anthropic/claude-sonnet heeft geen retry_config-blok, dus het erft de standaarden. En de gateway volgt fouten continu. Als een target binnen een voortschrijdend venster van 2 minuten 2 of meer fouten veroorzaakt, wordt deze als ongezond gemarkeerd en overgeslagen totdat de fouten verlopen, met automatisch herstel. Geen menselijke tussenkomst en geen handmatige configuratiewijzigingen als een storing voorbij is.
Verschillende modellen retourneren antwoorden in verschillende formats, met verschillende metadata, finish reasons en indelingen voor het aantal tokens. De orchestration-laag normaliseert dat allemaal. Je code leest dezelfde responsstructuur, ongeacht of de request naar OpenAI, Anthropic of een zelfgehoste Llama is gegaan.
Voor debugging retourneert TrueFoundry de werkelijke target die de request heeft afgehandeld in de x-tfy-resolved-model respons-header, zodat je kunt achterhalen welk model een specifieke output heeft gegenereerd, zelfs wanneer de virtuele modelnaam tien mogelijke targets afdekt. Zichtbaarheid is van belang wanneer je een kwaliteitsvermindering onderzoekt en moet weten of je sticky-routing-configuratie de gebruiker bij dezelfde provider heeft gehouden of halverwege een sessie is overgeschakeld.
Multi-Model orchestration creëert waarde wanneer teams routingbeslissingen koppelen aan zakelijke resultaten. Het doel is niet om meer modellen te gebruiken. Het doel is om het juiste model toe te passen op elke request, terwijl de kosten, kwaliteit, beschikbaarheid, compliance en governance worden verbeterd.
Een ondersteuningsworkflow kan bijvoorbeeld routineuze klantvragen routen naar een kleiner model. Het kan complexe facturatiegeschillen of technische ondersteuningszaken sturen naar een sterker model. Dit verbetert de kostenbeheersing zonder de kwaliteit van de antwoorden aan te tasten.
In een andere use-case kan een enterprise onderzoeksassistent het ene model gebruiken voor het begrijpen van natuurlijke taal, een ander voor het ophalen van data en nog een ander voor het genereren van natuurlijke taal. De orchestration-logica bepaalt welk model of welke agent bijdraagt aan het uiteindelijke antwoord.
Deze architectuur geeft enterprises een concurrentievoordeel omdat de keuze voor modellen operationeel wordt. Teams kunnen routingregels aanpassen, providers testen, kosten verlagen en de responskwaliteit verbeteren zonder elke AI-applicatie opnieuw te bouwen.
Routing alleen is geen governance.
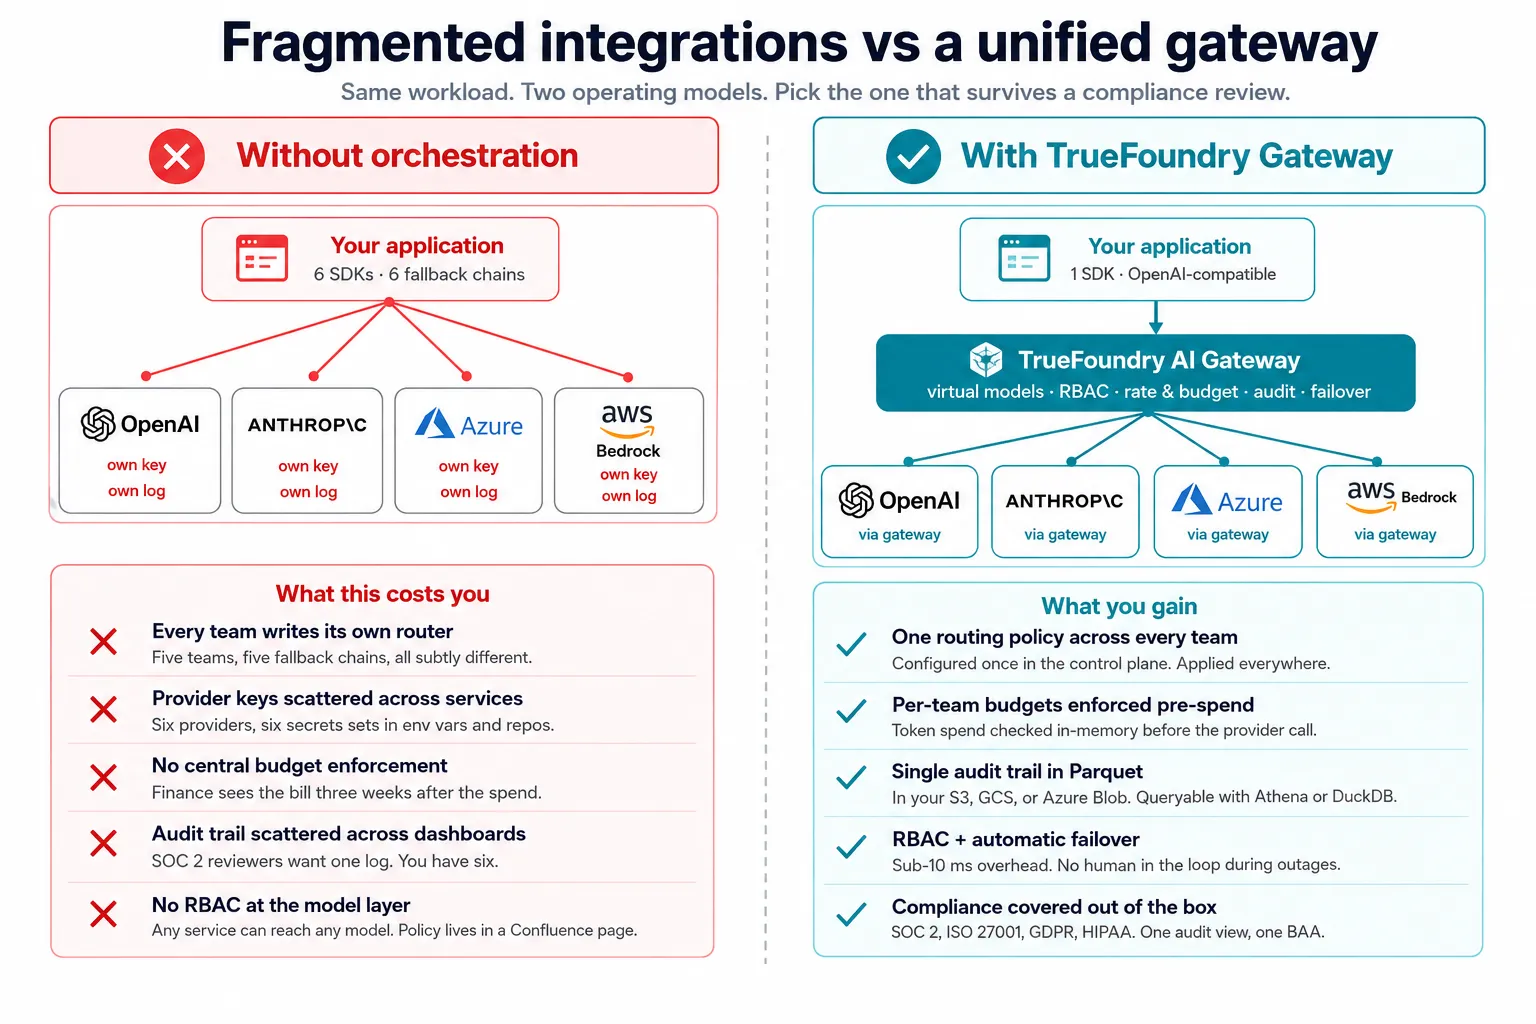
Veel teams bouwen hun eigen router, krijgen de berekeningen voor load balancing kloppend en worden alsnog wakker met vier problemen waar ze geen rekening mee hadden gehouden.
Routing per applicatie betekent dat elk team zijn eigen versie van dezelfde logica schrijft. Vijf teams, vijf subtiel verschillende fallback-ketens, vijf sets provider-sleutels die rondzweven in omgevingsvariabelen. Die inconsistentie stapelt zich op op organisatieniveau en verandert "we hebben multi-model orchestration" in "elk team heeft multi-model orchestration".
Geen enkel routing framework dwingt budgetlimieten per team af voordat requests worden uitgevoerd. De uitgaven aan tokens hopen zich op over elke gerouteerde provider. Tegen de tijd dat finance vraagt waarom de OpenAI-factuur is verdrievoudigd, heeft de budgetdiscussie al plaatsgevonden, drie weken te laat.
Routing over meerdere providers creëert een audit-probleem voor meerdere providers. Logs in het dashboard van OpenAI, logs in de console van Anthropic, logs in de portal van Azure. Geen van allen vormen ze samen de uniforme, aan gebruikers toegewezen audit trail die SOC 2- en HIPAA-beoordelingen daadwerkelijk willen zien.
Beschikbaarheid is niet hetzelfde als toegangsbeheer. Failover betekent dat elke gezonde provider een request kan afhandelen. Zonder RBAC op de gateway kan elke gezonde provider ook bereikbaar worden voor engineers of AI-agents die er geen toegang toe zouden moeten hebben. Als een marketing-prompt nooit een model mag bereiken dat alleen is goedgekeurd voor klinische workflows, moet het beleid op de gateway aanwezig zijn, niet op een Confluence-pagina.
Dit is waar context engineering en statusbeheer ook operationele aandachtspunten worden. Een systeem kan relevante informatie ophalen uit databronnen, kennisbanksystemen, vector-databases en externe databronnen. Zonder een beheerde governance-laag kan het gehele systeem informatie blootstellen of requests verkeerd routen.
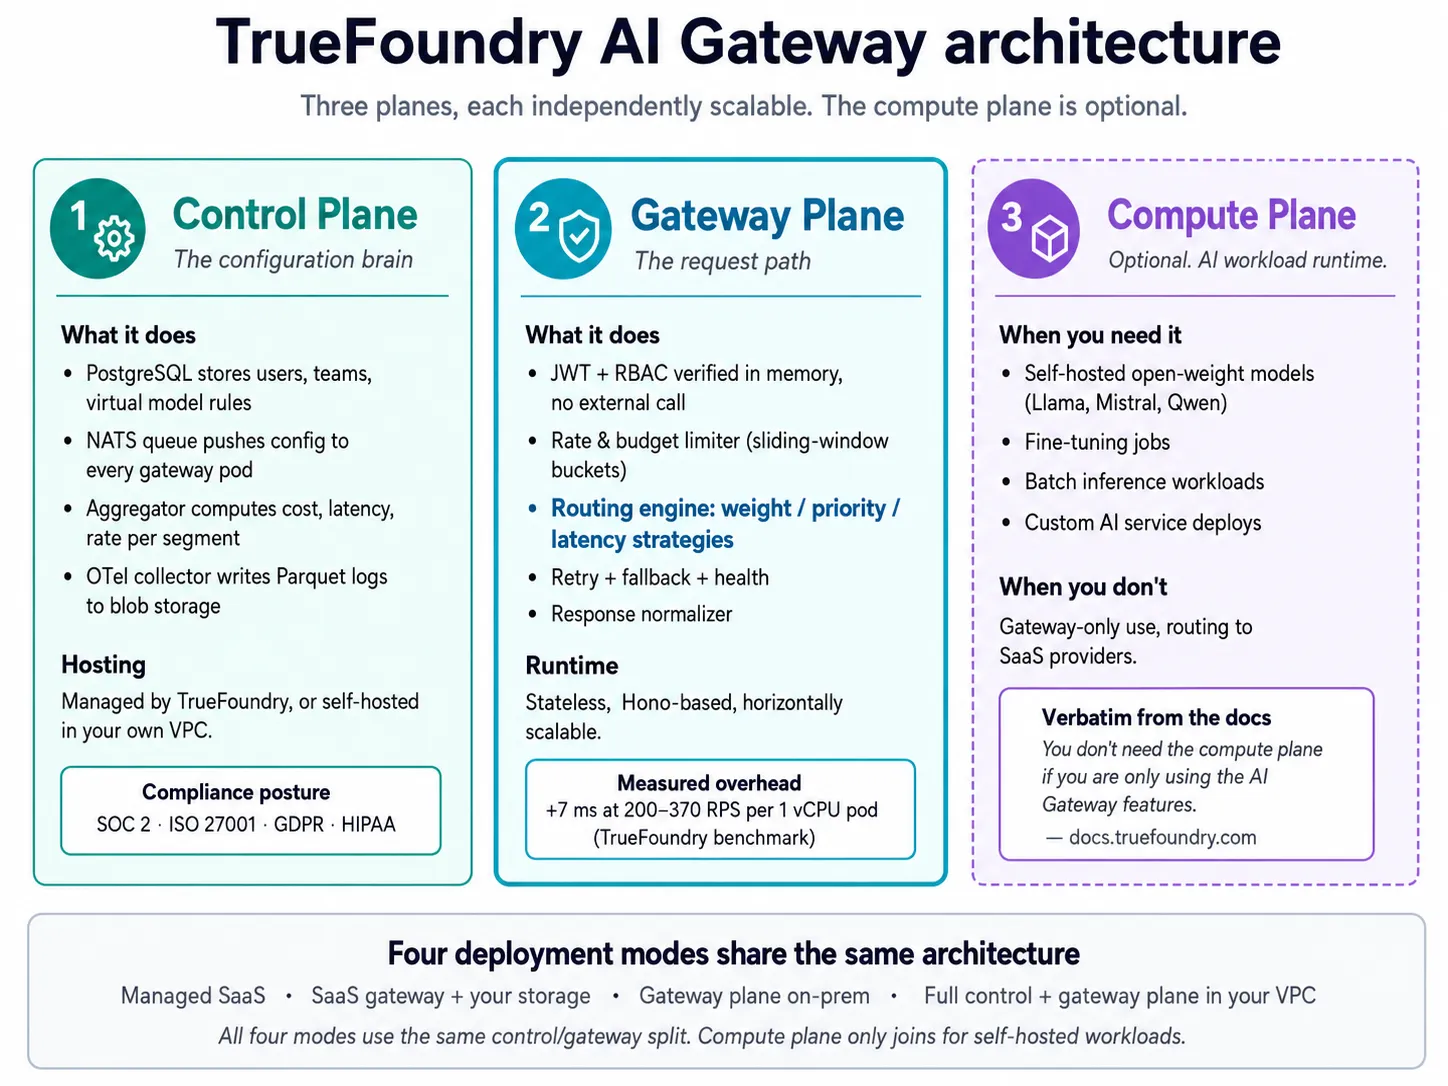
De LLM Gateway van TrueFoundry biedt multi-model orchestration als een door de control-plane beheerde routinglaag die kan draaien als beheerde SaaS, hybride of volledig binnen je eigen VPC. Vier eigenschappen zijn van belang voor productie-implementaties.
De AI Gateway voegt bredere governance, rate limiting, budgetten, guardrails en observability toe aan AI-productieworkloads. De MCP Gateway beheert toegang tot tools, authenticatie en zichtbaarheid van MCP-servers voor door modellen aangedreven applicaties. De Agent Gateway beheert autonome agents, gespecialiseerde agents en complexe workflows waarin een enkele AI-agent meerdere model- of tool-calls kan uitvoeren.
Boek een demo om te zien hoe TrueFoundry multi-model routing, agents, MCP-tools en audit trails beheert binnen je VPC.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Multi-model orchestration is the architectural pattern of connecting an application to multiple AI models and dynamically routing each request to the model best suited for it, based on factors like task type, latency, cost, or provider availability. The orchestration layer abstracts the underlying providers behind a single API, handles failover when a model is unavailable, and normalizes responses so applications don’t need provider-specific code. In production, it’s how teams keep AI features running through provider outages and keep costs predictable as usage grows.
Multi LLM orchestration is the same pattern applied specifically to large language models. An orchestration layer sits between applications and several LLM providers (OpenAI, Anthropic, Google, Bedrock, self-hosted), routes each request to the appropriate model, manages failover and retries, and gives the application a consistent interface no matter which provider serves the response. The term is often used interchangeably with multi-model orchestration when the underlying models are all LLMs rather than a mix of model types.
The purpose is to match every workload to the right model on three axes: capability, cost, and reliability. Frontier models cost more but handle hard tasks better. Smaller models are cheap and fast for routine work. Multi-model orchestration routes intelligently between them, fails over when providers degrade, and gives operations teams one place to enforce cost, rate, and access policies. It’s the difference between running AI as a collection of provider integrations and running AI as a governed platform.
De orkestratielaag normaliseert ze. Elke provider heeft zijn eigen responsestructuur, tokentellingsformaat, foutcodes, en conventies voor de reden van afronding. De gateway vertaalt alles naar één consistent formaat (doorgaans het OpenAI-compatibele schema) voordat het terugkeert naar de applicatie. Providerspecifieke afhandeling blijft binnen de gateway, niet in de applicatiecode. Bij TrueFoundry wordt het opgeloste doelmodel ook geretourneerd in de responseheader x-tfy-resolved-model, zodat u kunt traceren welke provider een bepaald verzoek heeft bediend.
In een systeem zoals de gateway van TrueFoundry definiëert u een virtueel model dat verwijst naar een lijst van echte doelen, en kiest u een routeringsstrategie: op gewicht (verkeer splitsen in percentages), op prioriteit (primair plus gerangschikte fallbacks), of op latentie (automatisch het snelste gezonde doel kiezen). U kunt retry-beleid, fallback-statuscodes, SLA-grenzen op tijd-per-outputtoken, sticky routing voor sessies met meerdere beurten, en metadatagebaseerde filters per doel toevoegen. Regels leven in de gatewayconfiguratie en gelden voor elk team dat de naam van het virtuele model gebruikt, met wijzigingen die binnen seconden doorwerken.



Het laatste nieuws, artikelen en bronnen in je inbox



















