



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Caching klinkt eenvoudig totdat taal een rol gaat spelen. Traditionele caches vragen zich af of twee verzoeken identiek zijn. AI-toepassingen geven er vaak om of twee verzoeken hetzelfde betekenen. "Hoe stel ik mijn wachtwoord opnieuw in?" en "Ik ben mijn wachtwoord vergeten — wat nu?" zijn verschillende strings, maar verdienen mogelijk hetzelfde ondersteuningsantwoord.
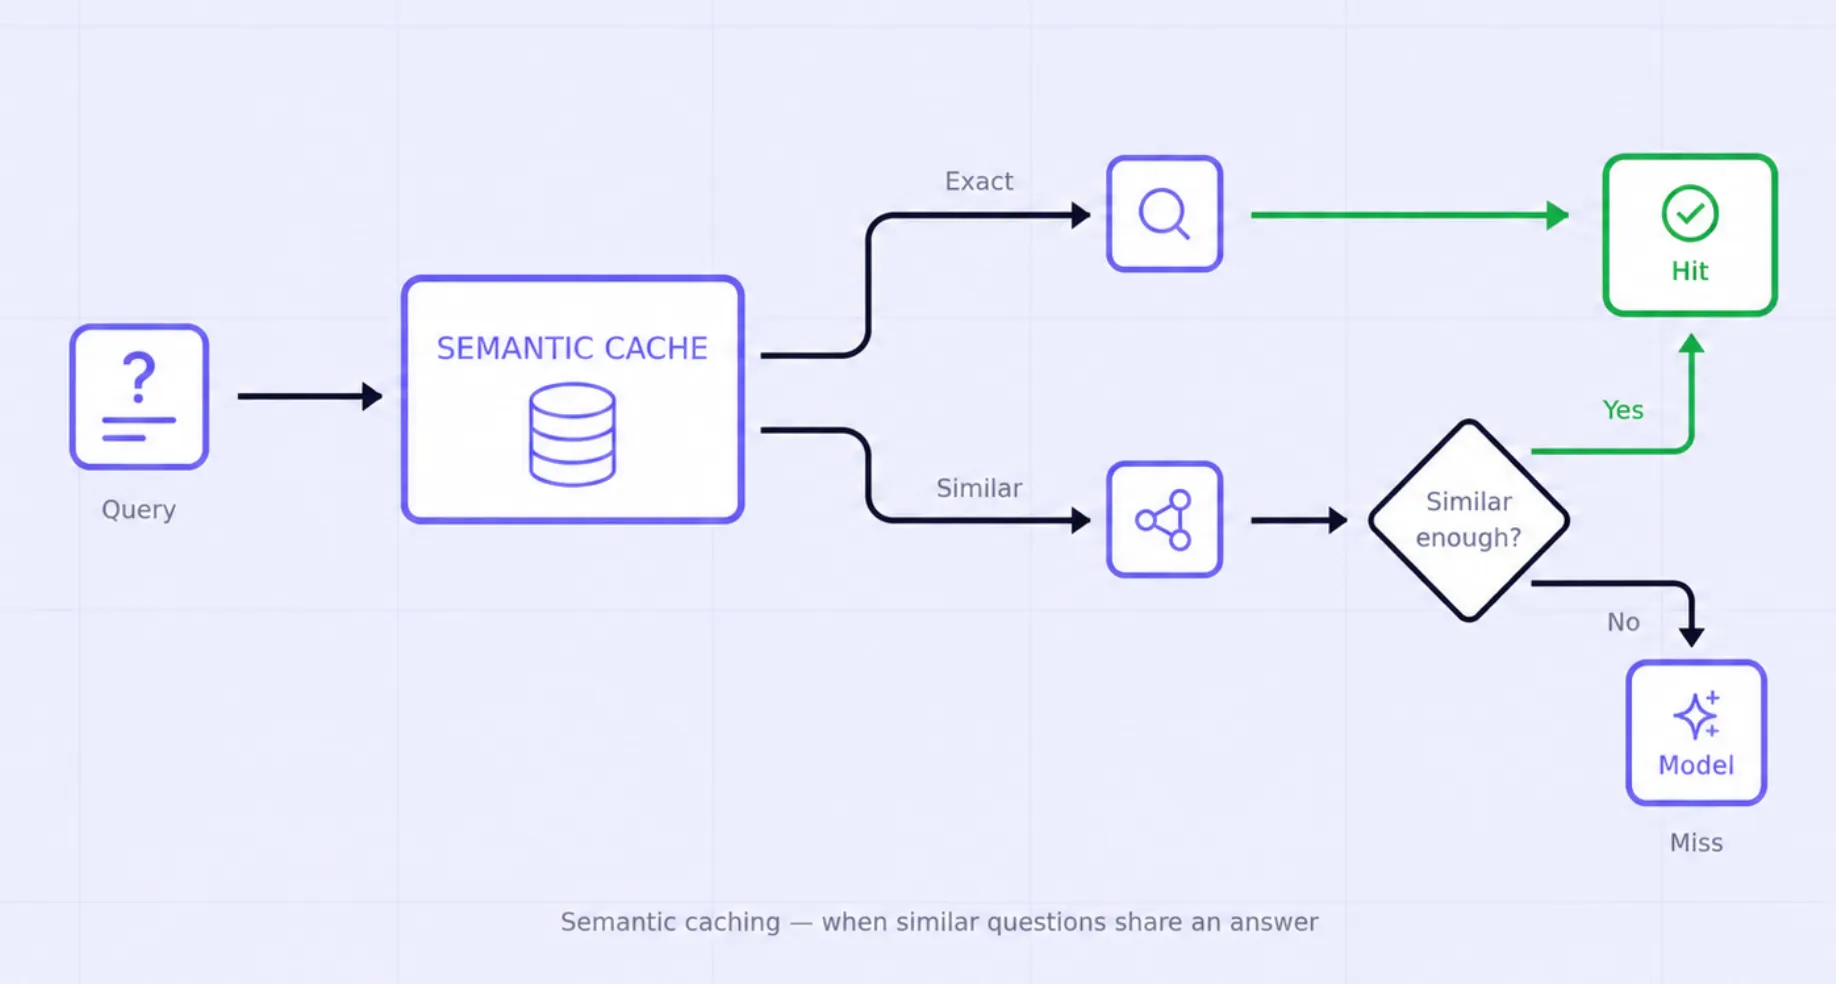
Dat is het idee achter semantische caching: embed een query, vergelijk deze met eerder gecachte query's en retourneer een eerder antwoord wanneer de overeenkomst hoog genoeg is. De winst kan spectaculair zijn omdat een cache hit de modelaanroep volledig elimineert. Het gevaar is even duidelijk: een nabije match kan semantisch dichtbij zijn, maar toch een ander antwoord vereisen.
Dit zijn drie conceptuele caching-taken, niet noodzakelijk drie afzonderlijk geïmplementeerde caches. In TrueFoundry is semantische caching een superset van exact-match caching: de semantische modus kan ook exact-match hits retourneren, dus u hoeft niet beide gateway-modi tegelijk uit te voeren. Kies exact-match wanneer alleen hergebruik van identieke verzoeken acceptabel is; kies semantisch wanneer u hergebruik op basis van overeenkomst expliciet accepteert. Provider prompt caching kan met beide worden gecombineerd bij gateway misses, waarbij de model provider het verzoek alsnog ontvangt.
De cruciale stap is de stap die men overslaat in diagrammen: verifieer de volledige equivalentiegrens. In TrueFoundry geldt semantische overeenkomst alleen voor het laatste bericht; de rest van de verzoekparameters moet via een hash exact overeenkomen, en cache-items worden automatisch afgebakend voor de aanroepende gebruiker of virtual account. Maar applicatiestatus die het verzoek nooit binnenkomt — bijvoorbeeld een downstream tenant achter één gedeeld virtual account, een entitlement-lookup, een evidence-revisie of een externe accountstatus — kan de cache niet beïnvloeden, tenzij u deze codeert in het verzoek, de namespace, de versiegrens of het beleid voor cache-geschiktheid.
Partitioneer caches overal waar het juiste antwoord kan verschillen over een grens heen. In TrueFoundry zijn er twee lagen: isolatie van gebruiker/virtual-account is automatisch, en een optionele namespace partitioneert verder binnen die scope. De tweede laag is van belang wanneer één virtual account meerdere downstream tenants, eindgebruikers, omgevingen, promptversies of andere contexten bedient die nooit gecachte antwoorden mogen delen. Een gedeelde cache is alleen gepast wanneer het onderliggende antwoord daadwerkelijk gedeeld wordt.
Een gecacht antwoord over "hoe SSO te configureren" kan dagenlang correct blijven. "Is dienst X momenteel gedegradeerd?" kan binnen enkele minuten onjuist worden. Gebruik domeinversheid om TTL's in te stellen en invalideer agressief wanneer het onderliggende beleid of de inhoud wijzigt.
Meet de hit rate, vermeden kosten, end-to-end latency, cache-lookup-overhead, rapporten van valse hits en cache-fouten. Een hoge hit rate is niet automatisch goed; een te brede drempelwaarde kan een indrukwekkende metriek opleveren terwijl de correctheid van antwoorden verslechtert.
De centrale vraag bij semantische caching is niet "welke cosinusdrempel moeten we gebruiken?" Het is "welke verzoeken mogen een antwoord delen?" Die equivalentieklasse kan nauwer zijn dan semantische overeenkomst. Twee ondersteuningsvragen kunnen hetzelfde betekenen, maar verschillende antwoorden vereisen omdat de gebruikers tot verschillende abonnementen, regio's, tenants of productversies behoren. De cache moet die grenzen coderen voordat overeenkomst überhaupt in overweging wordt genomen.
Een praktisch ontwerp is het scheiden van semantische identiteit en statusidentiteit. Semantische identiteit is het deel dat mag variëren in verwoording. Statusidentiteit is alles wat equivalent moet zijn voordat hergebruik veilig is. TrueFoundry implementeert hiervan een concrete versie: het embedt het laatste bericht, terwijl het model, eerdere berichten, temperatuur en de rest van de verzoekparameters gehashed worden en exact moeten overeenkomen. Het isoleert items ook automatisch per gebruiker of virtual account. Wat het niet kan afleiden, is applicatiestatus die afwezig is in het verzoek; als taalregio, downstream tenant, entitlement, evidence-revisie, beschikbaarheid van tools of beleidsversie het antwoord verandert, representeer die status dan in het verzoek of de namespace, voorzie de cache van versies, of markeer de route als ongeschikt voor hergebruik.
Er is geen universeel "goede" similarity score. TrueFoundry documenteert 0.9 als uitgangspunt, met strengere drempels voor use-cases met hoge precisie, maar dat is een operationele standaard in plaats van een garantie voor correctheid. Een klantenservice-FAQ kan een bredere semantische matching tolereren dan een workflow voor prijzen, entitlements of beleid. Belangrijker nog: geen enkele drempelwaarde kan een ontbrekende statusgrens herstellen: twee vragen kunnen qua embedding dicht bij elkaar liggen terwijl ze verschillen op het gebied van een entiteit, datum, tenant, machtiging of beleidsversie die het antwoord verandert. Tune de drempelwaarde pas op een gelabelde set paren — hetzelfde-antwoord versus verschillend-antwoord — nadat die structurele grenzen zijn gecodeerd.
Houd valse positieven gescheiden van misses. Een miss kost latency en tokens; een valse positieve kan het verkeerde antwoord retourneren zonder het model überhaupt aan te roepen. Die asymmetrie betekent meestal dat productiedrempels eerst moeten neigen naar precisie, en pas verbreed mogen worden wanneer evaluatiegegevens aantonen dat de extra hits daadwerkelijk uitwisselbaar zijn.
Als een antwoord afhangt van veranderende documenten of tools, koppel de cache-geldigheid dan aan de evidence-versie. Een knowledge-base deployment-ID, beleidsrevisie, catalogusversie of dataversheidsepoch kan worden gerepresenteerd in het verzoek, een expliciete namespace of een andere invalidatie-/versiegrens. Dit voorkomt een subtiele foutmodus waarbij een perfect gematchte vraag een antwoord retourneert dat is gegenereerd op basis van de evidence van gisteren nadat de onderliggende bron is gewijzigd.
Wees bij agentic systemen extra voorzichtig met gecachte tussenliggende beslissingen. Het hergebruiken van "roep tool X aan met argumenten Y" heeft meer consequenties dan het hergebruiken van een FAQ-antwoord in lopende tekst. In de meeste gevallen hoort semantische response caching thuis op stabiele informatieve stappen, terwijl acties doorgaan via live beleid en autorisatie.
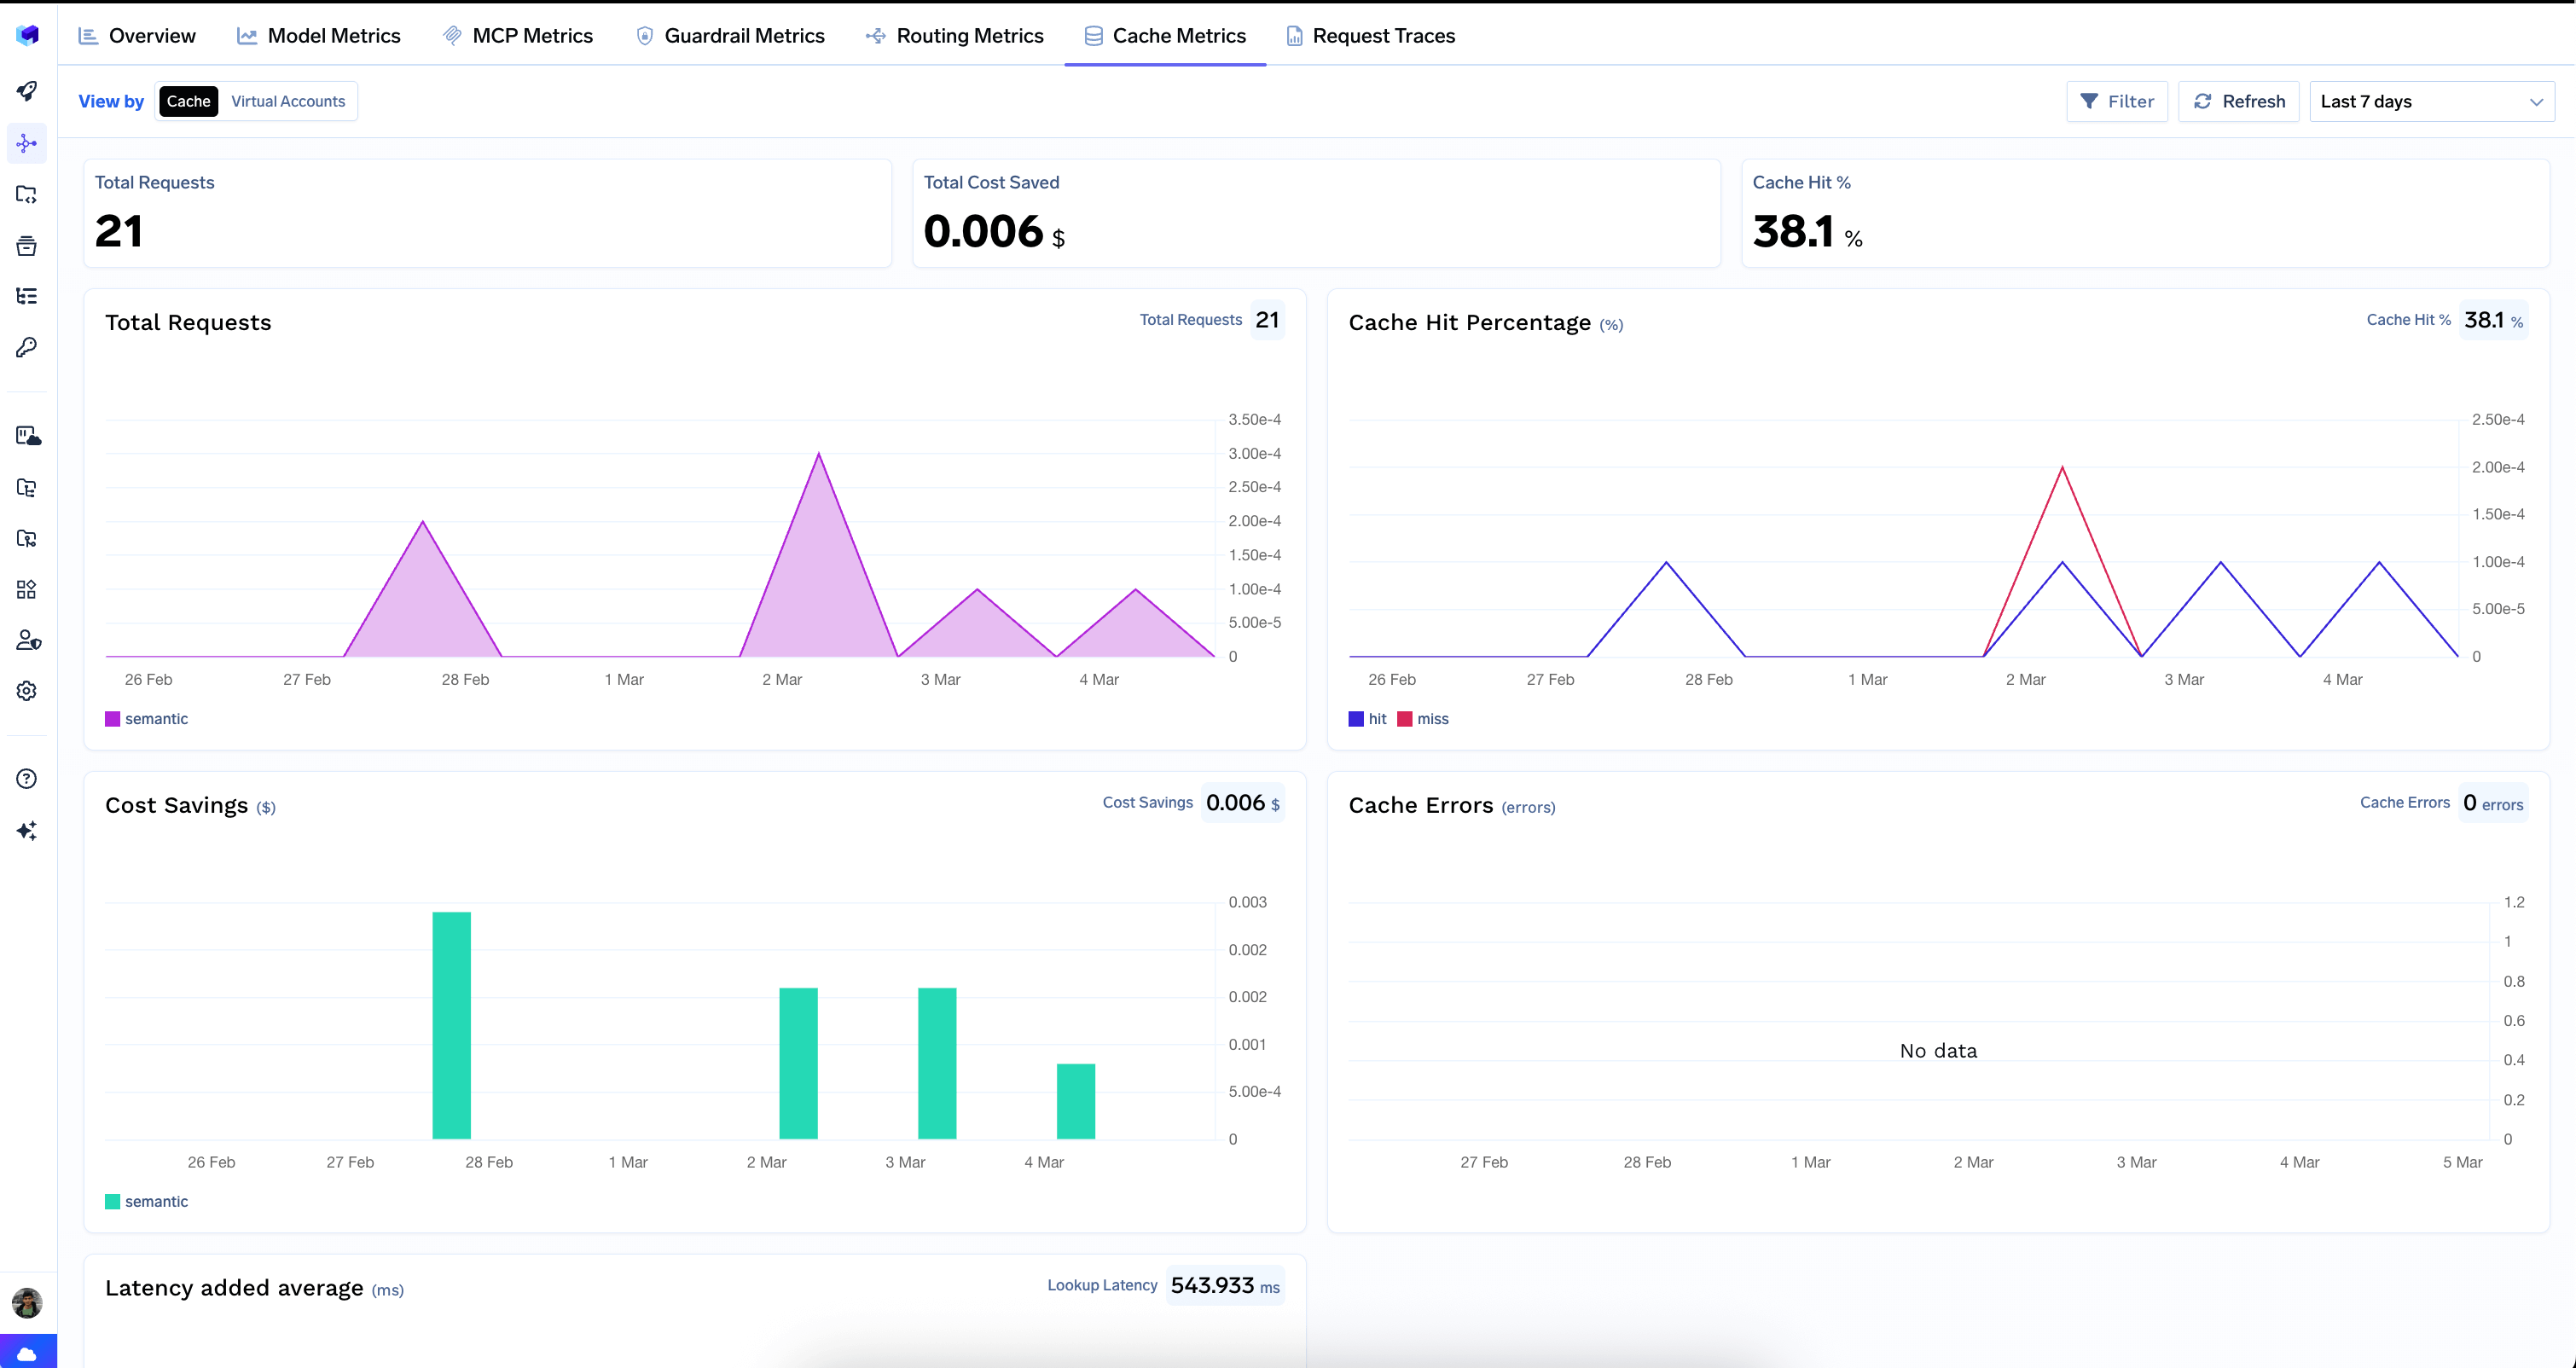
Semantische caching voegt embedding-generatie plus cache-/vector-lookup toe, ongeacht of dat werk lokaal wordt gehost of voor u wordt beheerd. Die overhead is vaak klein ten opzichte van een kostbare generatie, maar is niet gratis. Meet het end-to-end resultaat: cache-lookup-latency, infrastructuur- of providerkosten voor embeddings waar van toepassing, hit rate, vermeden generatiekosten en de impact op de correctheid. TrueFoundry toont de gemiddelde latency die wordt toegevoegd door cache-lookups in de Cache Metrics-weergave; gebruik gemeten overhead in plaats van aan te nemen dat de cache automatisch sneller is voor elke route. Een goedkoop model met korte antwoorden rechtvaardigt semantische caching mogelijk niet, zelfs niet als de hit rate er aantrekkelijk uitziet.
TrueFoundry's AI Gateway caching ondersteunt exact-match en semantische response caching. Huidige documentatie onderscheidt dat van provider prompt caching: gateway hits retourneren de opgeslagen response zonder het model aan te roepen, terwijl provider prompt caching nog steeds een completion genereert.
Voor semantische caching documenteert TrueFoundry op embedding gebaseerde overeenkomst op het laatste bericht, terwijl de rest van de verzoekparameters wordt gehashed; die niet-semantische parameters moeten exact overeenkomen. Cache-isolatie vindt ook plaats op twee niveaus: items worden automatisch afgebakend voor de aanroepende gebruiker of virtual account, en een optionele aangepaste namespace kan verder partitioneren binnen die scope — bijvoorbeeld wanneer één virtual account meerdere downstream tenants of omgevingen vertegenwoordigt. Response-headers tonen de cachestatus, de oorspronkelijke gecachte trace-ID en, voor semantische hits, de similarity score. Die details zijn van belang omdat ze cachegedrag inspecteerbaar maken in plaats van een onzichtbare optimalisatie.
Het Metrics Dashboard documenteert een Cache Metrics-weergave met totale cacheverzoeken, cache-hitpercentage, totale kostenbesparing, cache-fouten en gemiddelde latency toegevoegd door cache-lookups. Dat is de juiste operationele feedback-loop om te beslissen of caching economisch nuttig is. Correctheid heeft nog steeds een signaal aan de applicatiezijde nodig - bijvoorbeeld beoordeelde valse hits of route-specifieke antwoordkwaliteitsevaluatie — omdat hit rate en kostenbesparingen alleen u niet kunnen vertellen of twee verzoeken een antwoord hadden moeten delen.
Eén implementatiedetail is afhankelijk van de deployment. TrueFoundry SaaS beheert de caching-infrastructuur en documenteert momenteel OpenAI text-embedding-3-small als het standaard embedding-model voor semantische cache. Self-hosted deployments kunnen het embedding-model configureren, en de gedocumenteerde on-prem cache-store is Redis of een met Redis compatibele store zoals Valkey. Dit is van belang voor prestaties en datagrens-beoordelingen: het pad van de semantische cache omvat zowel de store als het embedding-model, dus evalueer waar elk draait in de deployment die u daadwerkelijk beheert.
Semantische caching is ongeschikt voor sterk gepersonaliseerde antwoorden, snel veranderende gegevens, stochastisch creatief werk of ingrijpende beslissingen waarbij een nabije match onacceptabel is. Exact-match caching voorkomt semantische valse hits, maar is alleen geschikt wanneer het volledige verzoek identiek is en het gecachte antwoord geldig blijft onder de huidige grens van versheid, autorisatie, evidence en beleid.
Caching moet een expliciet productcontract zijn: deze verzoekklassen zijn herbruikbaar onder deze statusgrenzen voor deze tijdsduur. Al het andere is per ontwerp een miss.
Semantische overeenkomst is geen garantie voor correctheid. Exact-match is geen garantie voor versheid. TrueFoundry isoleert cache-items automatisch per gebruiker of virtual account; aangepaste namespaces partitioneren verder binnen die scope. Cache-geschiktheid, applicatiestatusgrenzen, invalidatie-/versieregels en de evaluatie van valse hits blijven beslissingen van de applicatie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















